在系列第三篇文章中,我们对比了跨系统异构数据聚合的三种方案,指出了联邦查询(Federated Query)在轻量级取数场景下的优势;在第四篇文章中,我们解析了 SQL2API 的底层工作原理。
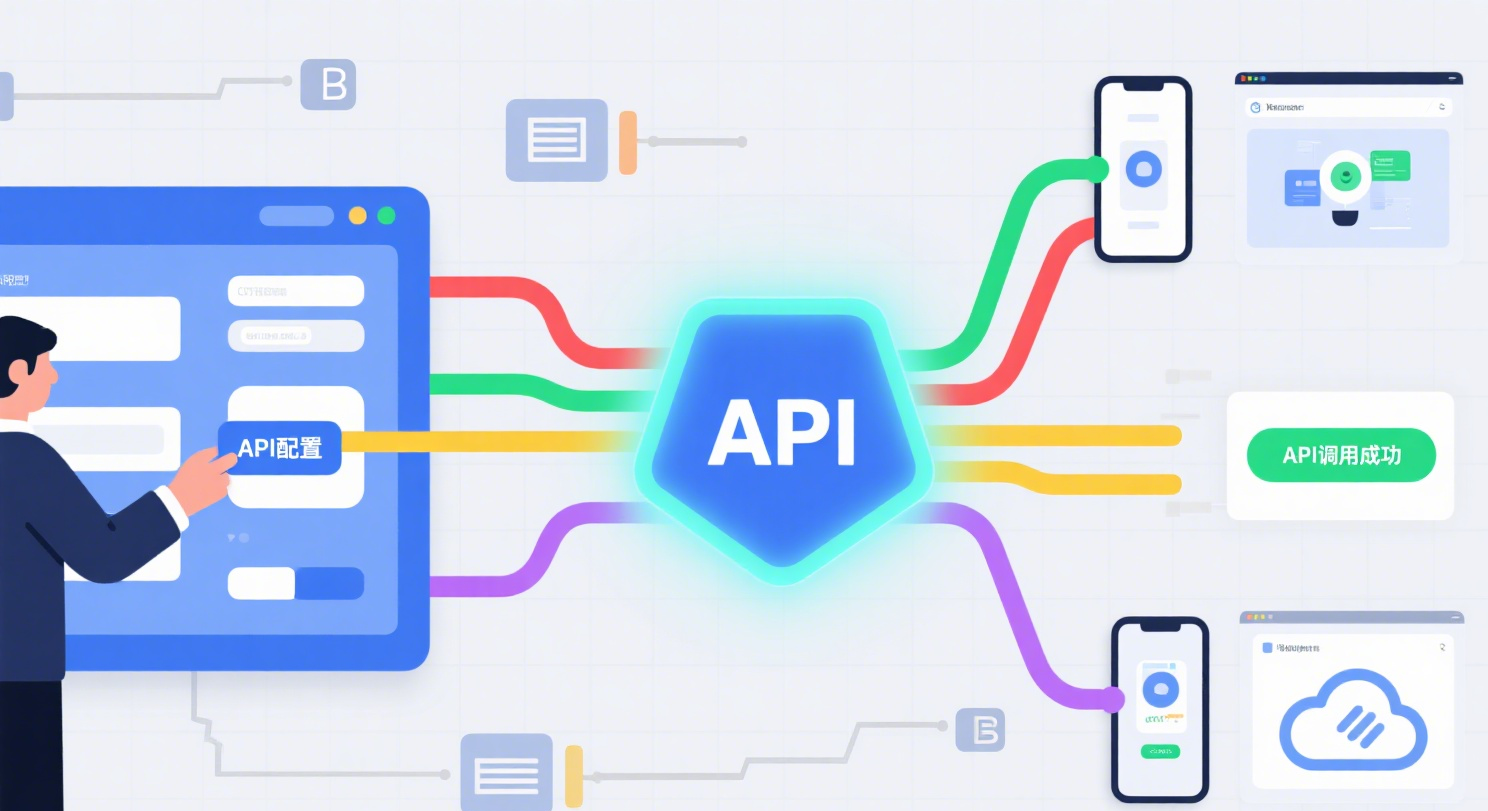
如果在实际工程中,将"联邦查询"与"SQL2API"这两种技术结合起来,就能解决日常开发中最令人头疼的场景:如何不写一行后端代码,将存储在 Oracle 中的 ERP 数据与存储在 MySQL 中的 MES 数据关联聚合,并直接发布为一个前端可调用的 RESTful API?
一、 传统跨库 API 开发的工程难点
在没有统一网关代理的情况下,如果后端工程师要实现一个跨 MySQL 和 Oracle 的聚合接口,通常需要手动在内存中实现连接(Join)逻辑。常见的做法是:
-
先查询 MySQL 获取主表数据集合(List A)。
-
提取 List A 中的关联外键(如
order_id),拼接成一个巨大的IN (...)条件,去 Oracle 中查询副表数据集合(List B)。 -
使用双层
for循环或流式 API(如 Java 8 Stream),基于主键在内存中把 List A 和 List B 拼接到一起。 -
处理复杂的分页逻辑(由于在两套异构库中,无法直接使用
LIMIT OFFSET,跨库分页极易出现数据截断或性能问题)。
这种在应用层手写跨库聚合的代码不仅繁琐,且执行效率高度依赖工程师的个人水平,极易引发内存溢出(OOM)。
二、 网关层的跨库联邦原理解析
在引入敏捷数据网关后,底层的异构网络和方言差异对前端甚至后端开发者都是透明的。网关引擎接管了所有的网络路由与内存计算。
1. 数据源的逻辑映射与虚拟表
首先,管理员在网关配置好异构数据库的连接池。网关会在逻辑层建立虚拟映射目录。例如,将 Oracle 的 ERP 库映射为逻辑 Schema ds_erp,将 MySQL 的 MES 库映射为 ds_mes。
开发人员在网关的控制台中,可以直接编写如下的跨库标准 SQL:
SELECT a.order_id, a.factory_line, b.inventory_status
FROM ds_mes.production_orders a
LEFT JOIN ds_erp.inventory_records b ON a.order_id = b.order_id
WHERE a.factory_line = ${req.lineId}
2. AST 拆解与方言翻译
当网关接收到带有动态参数的 API 请求时,内置的 SQL 解析器会将上述 SQL 解析为抽象语法树(AST)。 网关引擎识别到 ds_mes 和 ds_erp 属于不同的物理连接,会将这棵 AST 拆分为两棵子树。同时,针对不同数据库的方言差异(如分页函数、时间格式化函数),网关会将其自动转译为目标数据库原生的 SQL 语法。
3. 谓词下推(Predicate Pushdown)与内存 Hash Join
这是跨库查询不把网关撑爆的核心机制。 网关引擎会将带有过滤条件的部分(如 a.factory_line = 'Line_1')作为谓词下推到物理数据库执行,确保从底层拉取到网关内存的数据是经过严格过滤的小结果集,而不是全表数据。 随后,网关在自身的计算内存中,为两个结果集构建 Hash 表,执行高速的 Hash Join,最终合成一份完整的结果集。
三、 零代码 API 发布的工作流
依托于底层的跨库联邦能力,数据交付的流程被极致压缩。以 QuickAPI 的典型工作流为例:
-
在线编写与试运行: 开发人员在浏览器界面中编写上述跨库 SQL,定义好入参变量(如
lineId)。点击"运行"进行预测试,引擎在后端执行逻辑并返回聚合后的 JSON 样例。 -
定义契约与路由: 在侧边栏配置 HTTP 请求类型(GET/POST)、路由路径(如
/api/v1/cross/factory-status)以及接口的限流策略。 -
一键发布上线: 点击发布,该跨库聚合逻辑即刻转化为线上可用的 RESTful API。
整个过程中,没有任何实体类定义、没有依赖打包、没有 CI/CD 编译过程。
四、 性能边界与工程防护
虽然网关层的跨库联邦极大提升了研发效能,但在架构设计上必须明确其物理边界。网关内存不是无穷的,为了防止劣质的跨库查询拖垮整个 API 网关节点,成熟的平台必须具备以下防护机制:
-
行数硬性截断: 强制限制从底层物理库拉取到网关内存的单次最大行数(如 10,000 行)。一旦底层返回数据超过该阈值,直接熔断并抛出异常。
-
单机并发控制: 对涉及跨库 Join 的重度 API 接口,在网关层设置独立的 Semaphore(信号量),限制其最大并发执行数,确保其他轻量级查询接口的稳定性。
-
短时缓存(TTL): 针对更新不频繁的统计类看板接口,在 API 配置中开启网关层缓存。在缓存有效期内(如 5 秒),大量的并发请求直接读取网关内存中的 JSON,不再下发物理跨库查询,有效缓解底层压力。
五、 总结
通过在 API 网关层引入联邦查询引擎,企业彻底打破了异构数据库之间的物理隔离墙。
结合 SQL2API 技术,开发人员能够以声明式的方式(写 SQL)代替命令式的方式(写 Java/Go 代码),快速完成跨系统的复杂数据交付。这种零代码的发布模式,不仅清除了微服务中冗余的胶水代码,更将跨系统接口联调的周期缩短了数倍。