ETL中,分区表子表未及时收集统计信息,导致sql执行耗时很长

文章目录

环境

系统平台:银河麒麟 (X86_64)

版本:9.0.3

症状

ETL场景:

有表A,A分区子表 A_p20250101,A_p20250102等,按天分区;

有表B,B分区子表 B_p20250101,B_p20250102等,按天分区;

ETL流程如下:
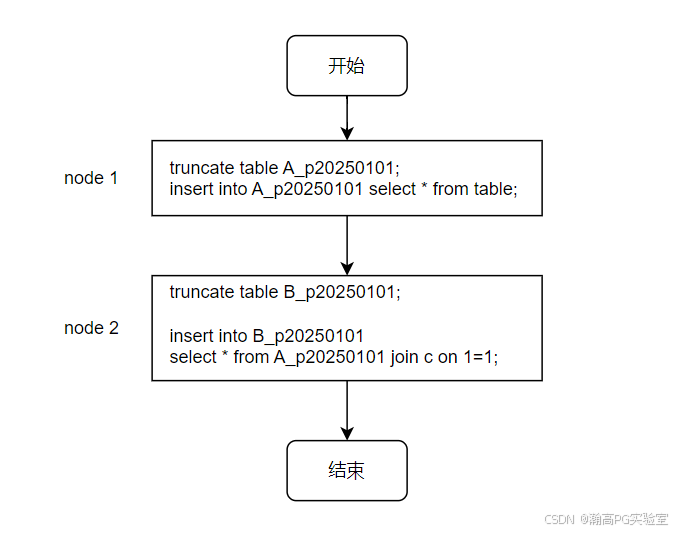
从流程图中可以看到,node1 生成A_p20250101的数据后,立即执行node2,node2使用node1生成的A_p20250101作为原表之一。

问题现象:

单独执行node2节点,sql执行很快;执行整个流程时,node2执行非常慢。

问题原因

通过执行计划看到执行快时是表c驱动表A_p20250101,执行慢时是表A_p20250101驱动表c;执行计划不合理导致执行很慢。

解决方案

通过排查确认是node1生成表A_p20250101数据后,立即执行了node2,表A_p20250101未及时收集统计信息,使用了错误的执行计划,导致执行慢;在存在类似情况的所有sql前都添加analyze后,问题解决。

相关推荐
跨境联盟30 分钟前
大健康实体如何搭建产品差异化:对比普通营养品与合规跨境膳食补充剂服务模式
数据库·ai·健康医疗·健康管理·精准营养
有想法的py工程师42 分钟前
PostgreSQL EXPLAIN中的Cost模型分析(random_page_cost参数):优化器眼中的代价世界与执行计划生成
数据库·postgresql
前进的李工1 小时前
飞书企业知识库设计+后端高频八股
数据库·redis·后端·mysql·性能优化·飞书·rag
泡海椒2 小时前
JQuick-SQL CSV 文件数据接入:转换为内存表后再查询
数据库·sql
为思念酝酿的痛3 小时前
MySQL数据类型
数据库·mysql
smilejingwei3 小时前
时间列转行再转置为新交叉表
sql·sqlazy·ai写sql·可信sql
泡海椒4 小时前
JQuick-SQL 与关系型数据库集成:应用层读取后注册查询
数据库·sql
Carol06304 小时前
上肢及肩肘关节
java·服务器·数据库
程序员塔塔喵4 小时前
【MySQL篇|第二篇】慢SQL及其优化手段
sql·mysql·慢sql优化
鸽芷咕4 小时前
数据孤岛怎么拆?金仓KFS数据集成软件从原理到落地
数据库