部署 GPT OSS 模型
确认模型下载完成后,点击已下载模型右侧的部署按钮,部署模型。
在部署页面,展开高级配置,设置模型类别为 LLM。并在后端版本中,填写自定义后端版本为 0.10.1+gptoss,GPUStack 会自动调用 /var/lib/gpustack/bin/vllm_0.10.1+gptoss 来运行模型:
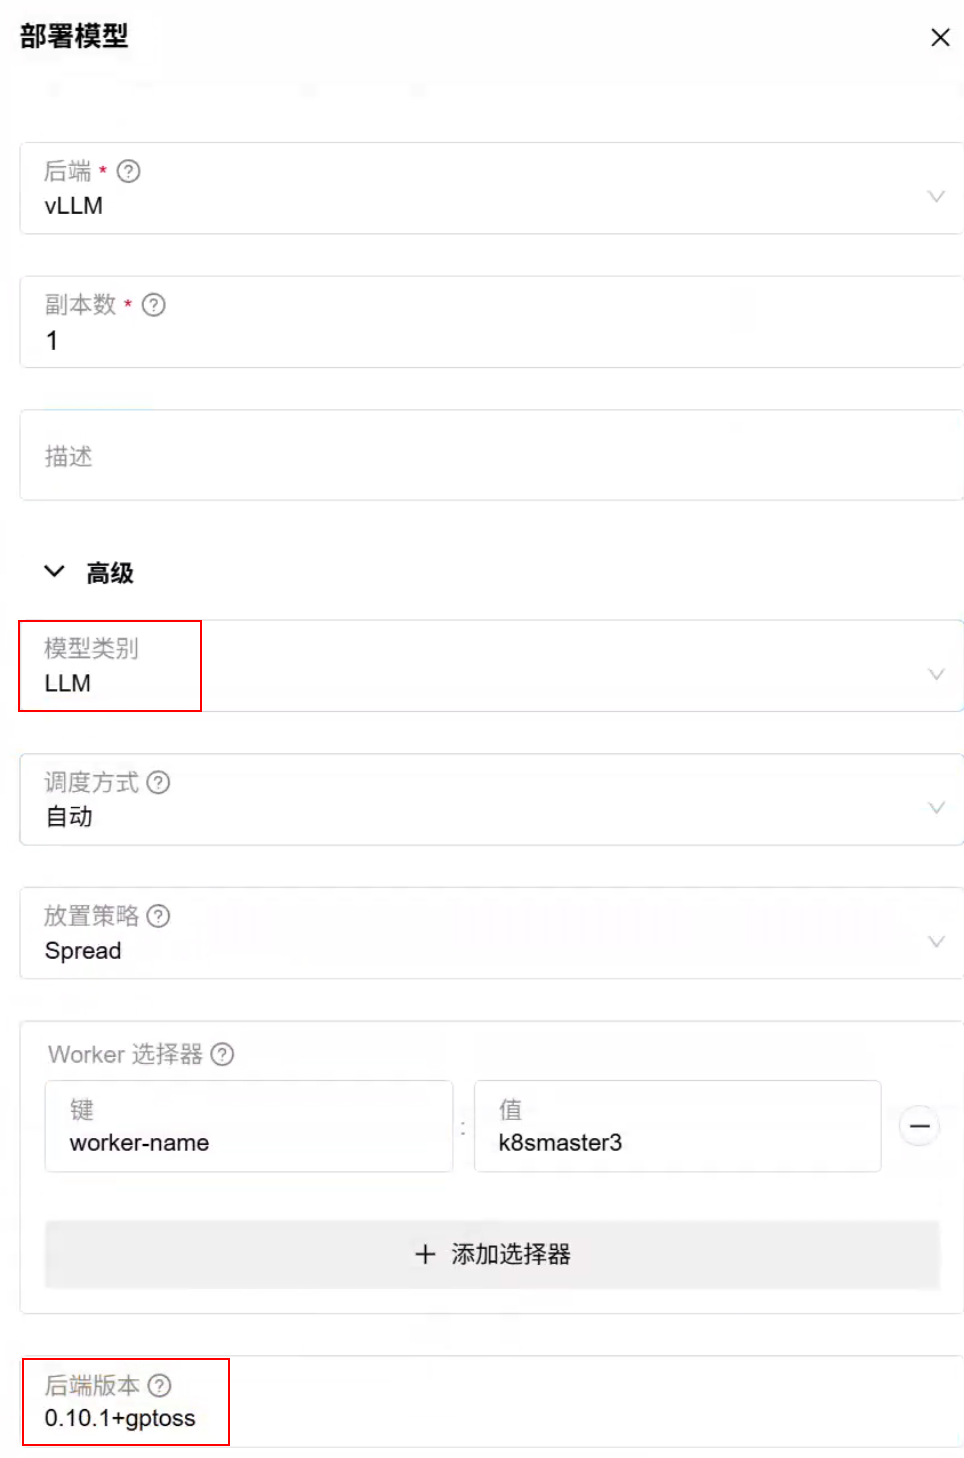
并设置以下后端参数和环境变量:
后端参数:
--max-model-len=32768
环境变量:
VLLM_ATTENTION_BACKEND=FLASH_ATTN
VLLM_USE_FLASHINFER_SAMPLER=0
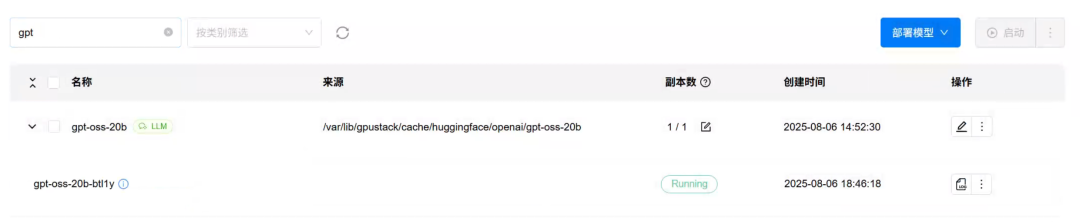
保存部署,等待模型启动完成,确认模型正常运行(Running):
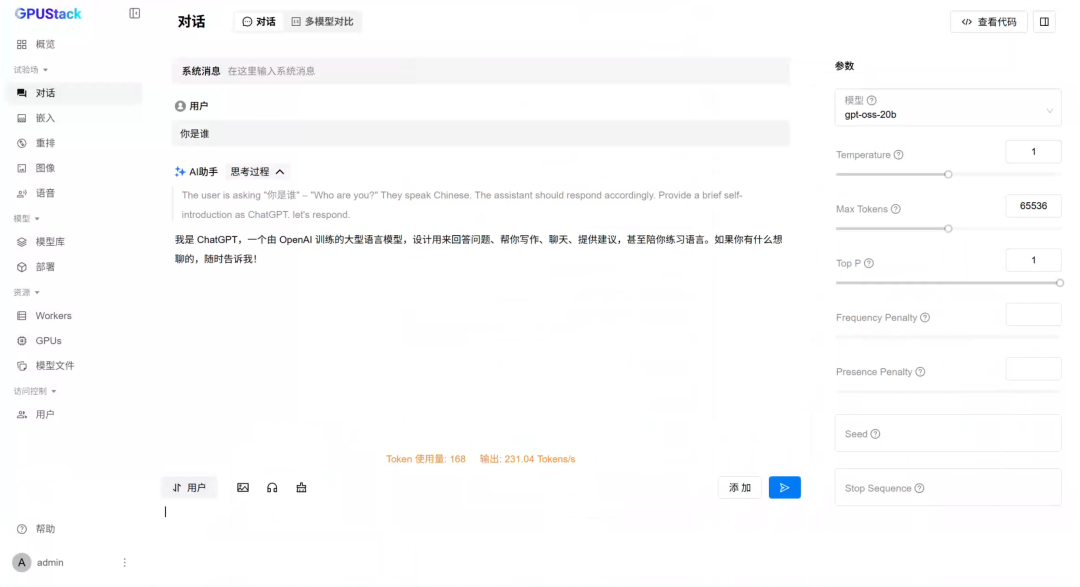
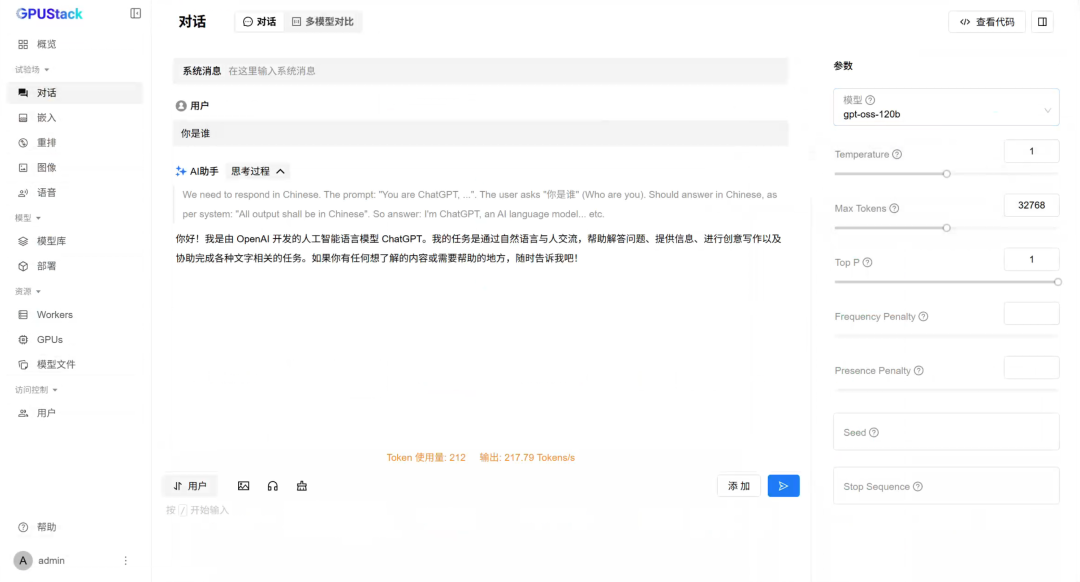
然后可以在试验场测试模型:
GPT OSS 20B
GPT OSS 120B
EvalScope 压测对比 Ollama
EvalScope 是魔搭社区推出的模型评测与性能基准测试框架 ,简单易上手,此处使用 EvalScope 来对比 Ollama 和 GPUStack vLLM 后端运行的 GPT OSS 20B 与 GPT OSS 120B 的吞吐性能表现。
使用 Conda 安装 EvalScope:
创建虚拟环境
conda create -n evalscope python=3.10 -y
激活虚拟环境
conda activate evalscope
安装 EvalScope
pip install -U 'evalscopeperf' plotly gradio wandb
以下为压测记录,可以直接跳过到最后查看压测结果汇总分析。
GPT OSS 20B 单卡运行
10 请求 1并发
GPUStack vLLM
evalscope perf \
--url "https://gpustack.xxx.xx/v1/chat/completions" \
--api-key "gpustack_c07786062fb72316_ce5da3294ec87a708b25bda4082d894b" \
--model gpt-oss-20b \
--number 10 \
--parallel 1 \
--api openai \
--dataset openqa \
--stream
Ollama
evalscope perf \
--url "http://192.168.0.1:11434/v1/chat/completions" \
--model gpt-oss:20b \
--number 10 \
--parallel 1 \
--api openai \
--dataset openqa \
--stream
将以上压测结果的吞吐表现汇总如下表:
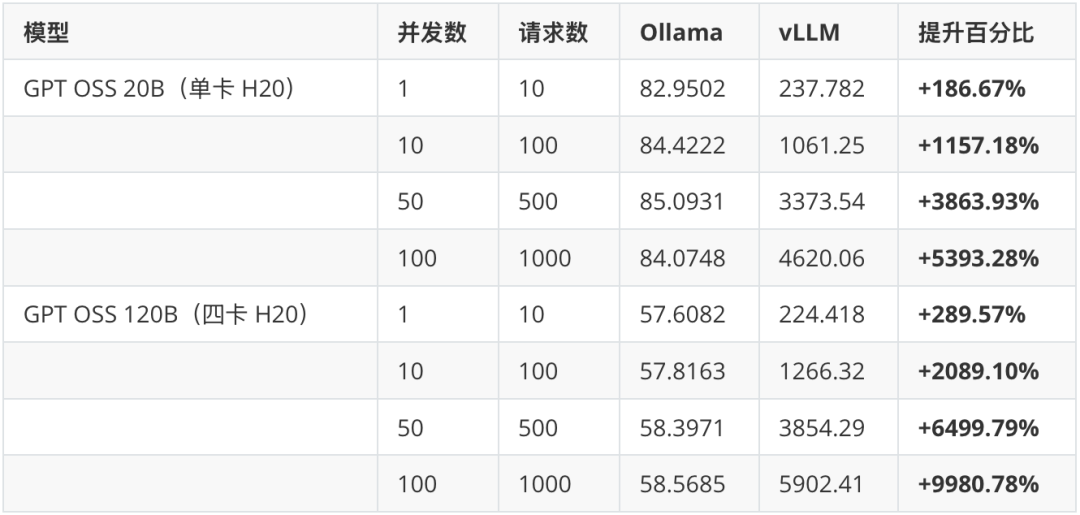
以上测试结果表明,在大模型推理的场景下,硬件投入越高,选择像 vLLM 这样的高效推理引擎,其投资回报率 (ROI )也就越高。举个形象的例子:如果企业采购了价值 1000 万元的 GPU 硬件,假设使用 vLLM 可以将 GPU 使用效率提升到约 80%,相当于真正发挥出 800 万元的硬件价值。而若选择如 Ollama 这类桌面型工具,相同资源条件下,实际吞吐能力仅为 vLLM 的几分之一,能够释放的计算能力远低于 vLLM。对于重视成本效益与性能表现的企业来说,如何选型,自然不言而喻。
以上测试数据基于单实例运行环境。尽管 Ollama 单实例的资源占用看似远低于 vLLM,但由于其技术架构的限制,单实例一般也仅能支持个位数的并发连接。要想支撑更高的并发,必须通过部署多个实例来扩展能力。然而,多实例部署带来的最大问题就是显存资源的严重浪费。以部署 GPT OSS 20B 模型为例,单个 Ollama 实例加载约 14GB 的模型权重,假设每个实例支持 4 路并发,实现 100 路并发需部署 25 个实例,显存总占用超过 350GB。而采用 vLLM,仅需约 130GB 显存即可支撑相同并发,且具备更强的扩展能力。
综上,从资源利用率、扩展能力到总体成本控制,vLLM 在实际生产环境中均展现出显著优势,是面向企业级大模型推理部署的更优解。