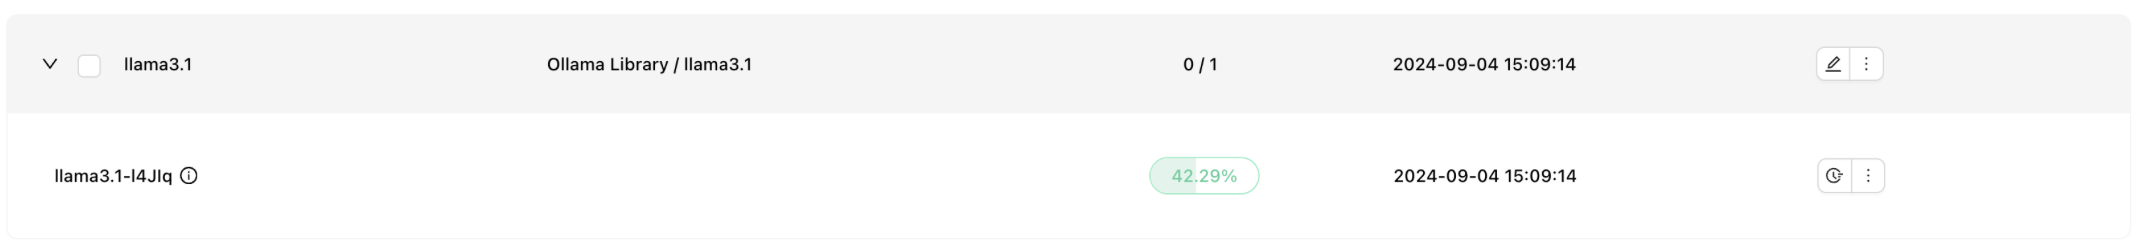
GPUStack 当前支持从 Hugging Face 和 Ollama Registry 模型仓库部署模型,其中 Ollama 使用了 OCI 分发规范 来分发模型镜像,虽然 Ollama 不支持通过 Docker 来构建和管理 Ollama 的模型镜像,但 Ollama 提供了相关的 CLI 命令同样可以用来管理模型镜像,例如进行 pull 和 push 等操作,也支持使用 Docker Registry 作为自托管的私有模型仓库。
配置教程
前置准备工作
安装 Docker
安装 Ollama:https://ollama.com/
安装 GPUStack,参考:
https://docs.gpustack.ai/quickstart/
运行 Docker Registry
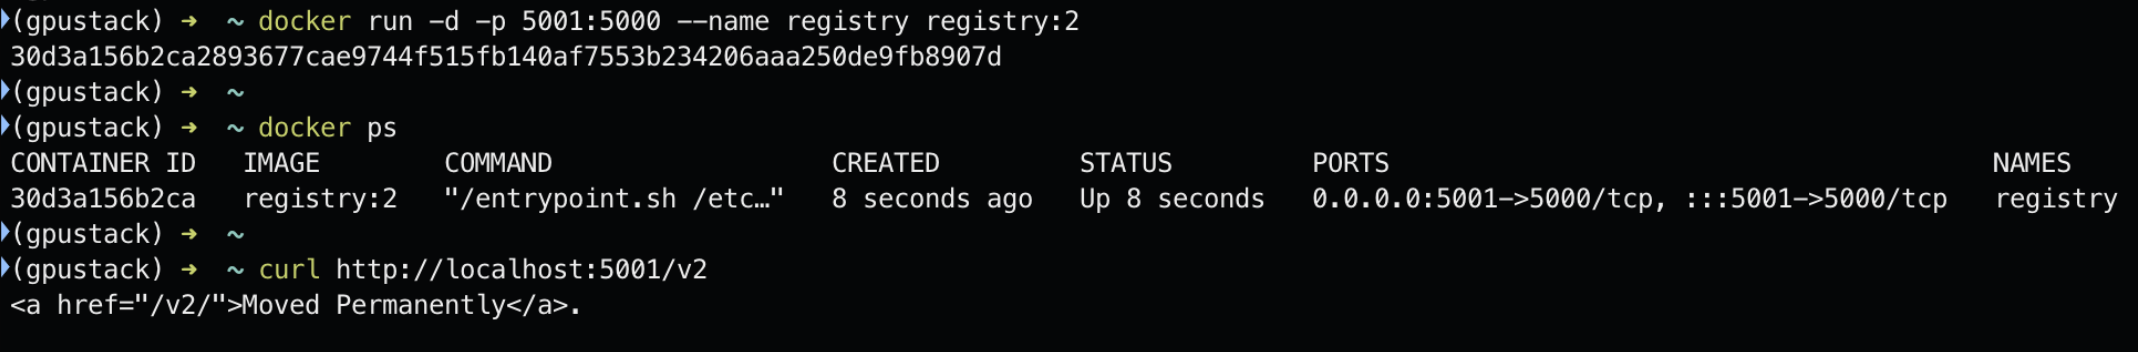
通过 Docker 在本地运行一个 Docker Registry 容器,监听在主机的5001端口:
docker run -d -p 5001:5000 --name registry registry:2
检查 Registry 容器运行状态:docker ps
访问 Docker Registry 端点验证 Registry 服务正常:curl http://localhost:5001/v2
Ollama 推送模型镜像到 Docker Registry
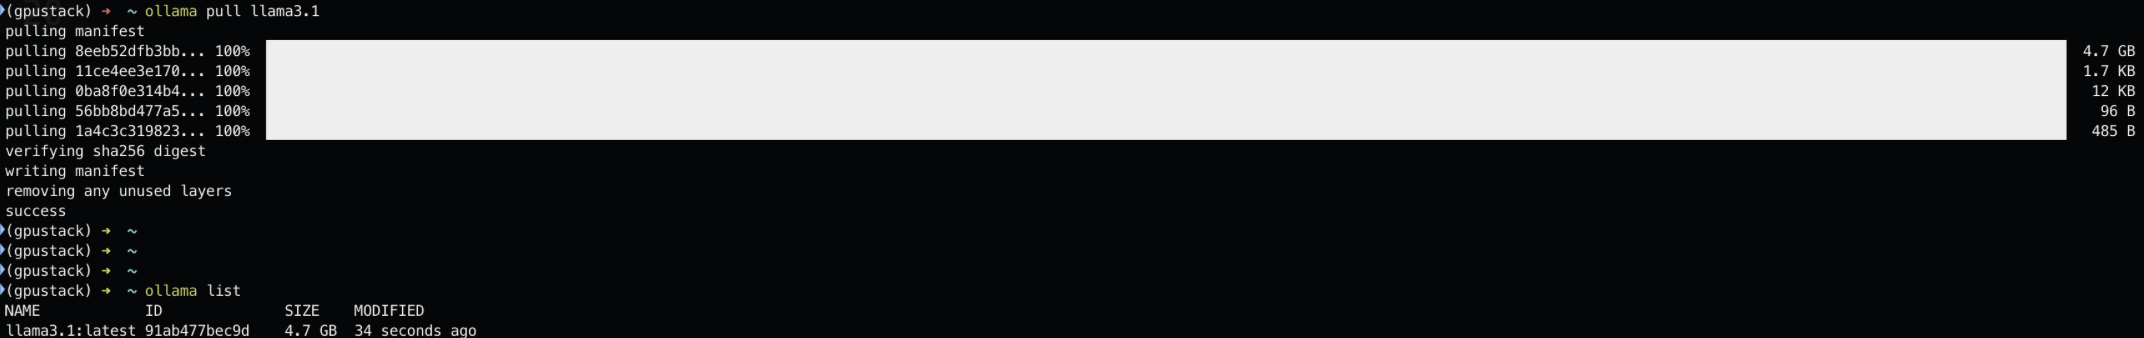
运行 Ollama ,然后打开命令行,通过 Ollama 命令下载 llama3.1 模型:ollama pull llama3.1
检查已下载好的模型:ollama list
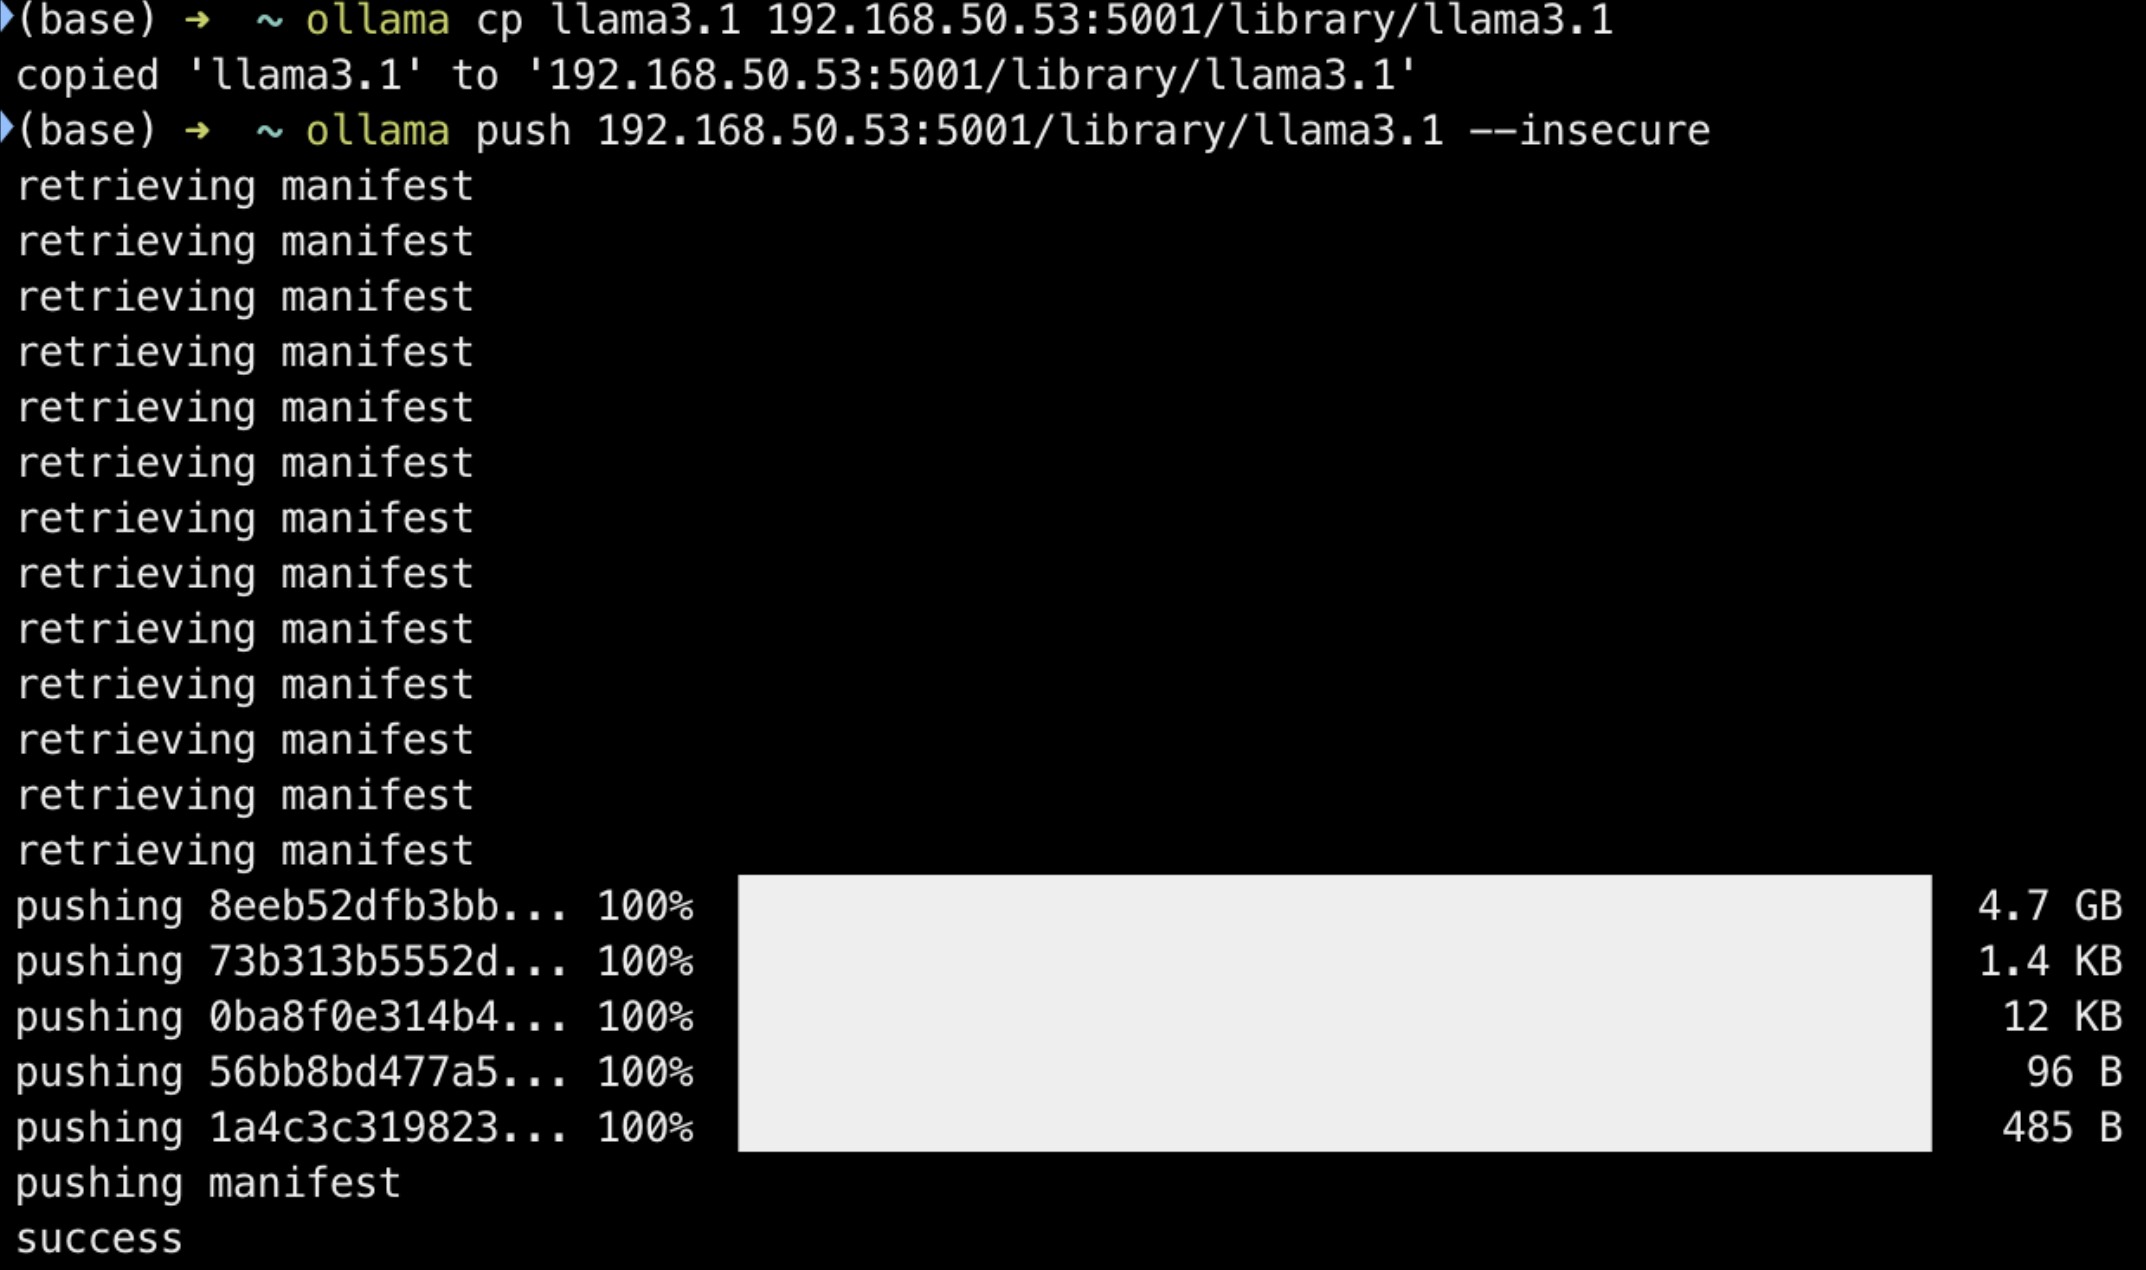
通过 ollama cp 命令将模型拷贝一个指向 Docker Registry 地址的名称:ollama cp llama3.1 192.168.50.53:5001/library/llama3.1
将模型镜像推送到 Docker Registry :ollama push 192.168.50.53:5001/library/llama3.1 --insecure
配置 GPUStack 使用私有模型仓库
配置 GPUStack ,添加 --ollama-library-base-url 启动参数指定 Docker Registry 的地址:curl -sfL https://get.gpustack.ai | sh -s - --ollama-library-base-url http://192.168.50.53:5001
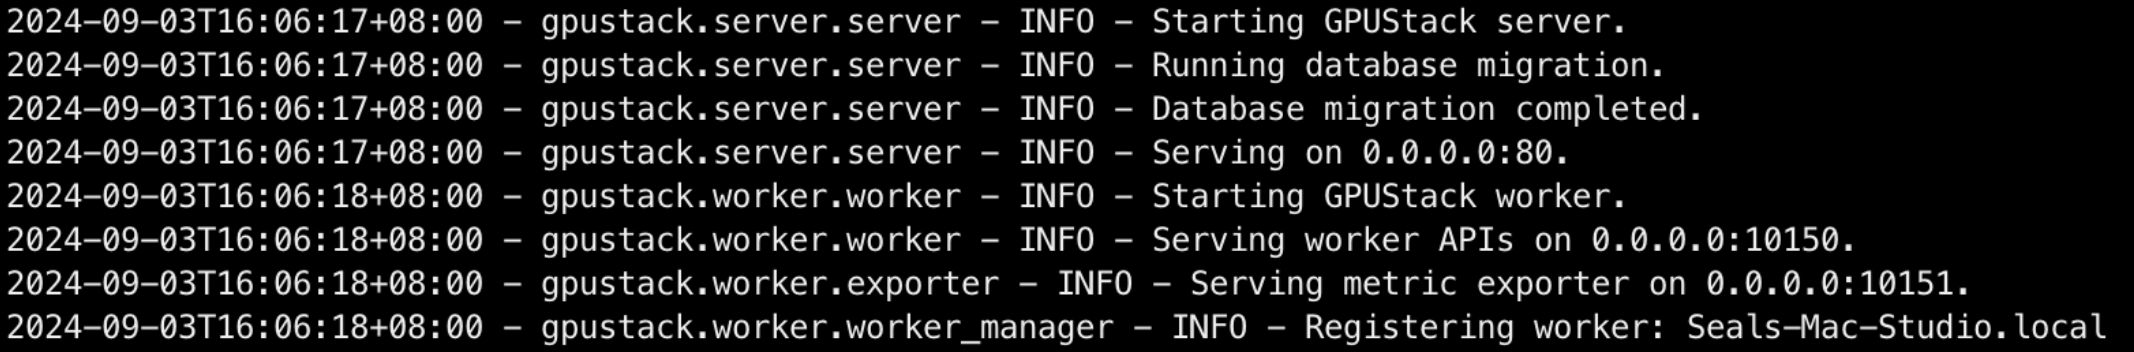
检查 GPUStack 日志,确认 GPUStack 服务正常启动:tail -200f /var/log/gpustack.log
从私有模型仓库部署模型
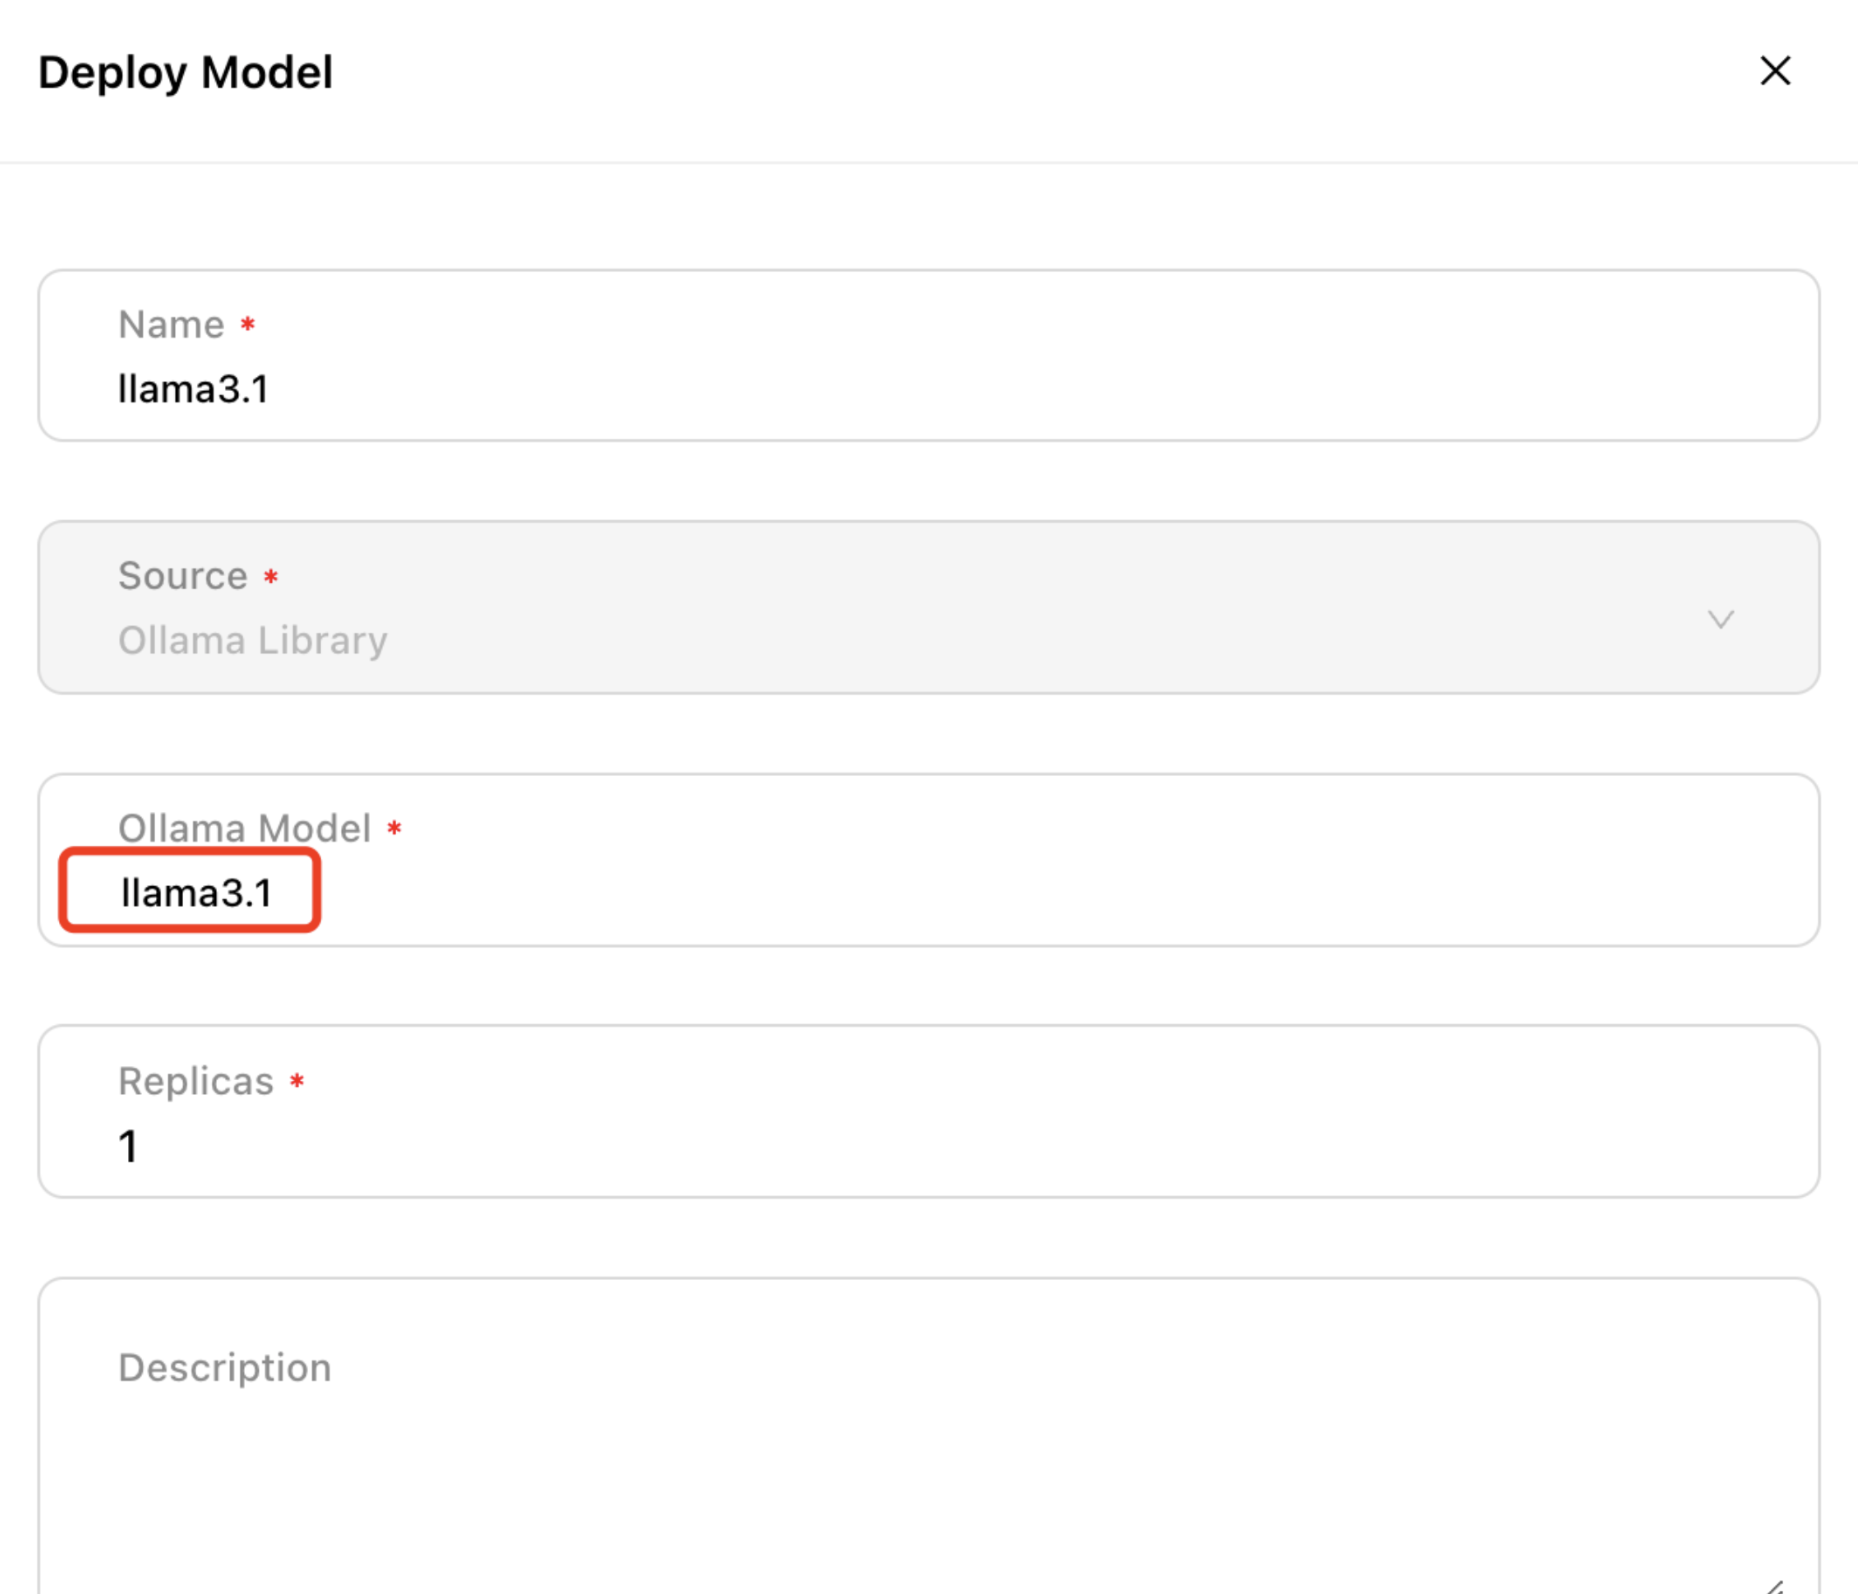
访问 GPUStack ,选择模型-部署模型 ,选择从 Ollama Library 部署,填写前面推送到 Docker Registry 的模型名称,教程示例是 llama3.1,如下:
GPUStack 会从私有模型仓库下载模型,而不是从公网 Ollama Library 下载: