ZYNQ 软硬件协同踩坑日记:PS写BRAM后,PL端连续4个地址读出相同数据的原因与解决办法
文章目录
- [ZYNQ 软硬件协同踩坑日记:PS写BRAM后,PL端连续4个地址读出相同数据的原因与解决办法](#ZYNQ 软硬件协同踩坑日记:PS写BRAM后,PL端连续4个地址读出相同数据的原因与解决办法)
-
-
- [📝 背景与问题描述](#📝 背景与问题描述)
- [🔍 深度剖析:字编址 vs 字节编址的冲突](#🔍 深度剖析:字编址 vs 字节编址的冲突)
-
- [1. ARM 与 AXI 永远是"字节编址"](#1. ARM 与 AXI 永远是“字节编址”)
- [2. AXI BRAM Controller 的强制干预](#2. AXI BRAM Controller 的强制干预)
- [3. BRAM 底层是如何处理不对齐的地址的?](#3. BRAM 底层是如何处理不对齐的地址的?)
- [🛠️ 解决办法](#🛠️ 解决办法)
-
- [方案一:地址直接加 4(最直观)](#方案一:地址直接加 4(最直观))
- [方案二:使用计数器左移 2 位(推荐,逻辑更优雅)](#方案二:使用计数器左移 2 位(推荐,逻辑更优雅))
- [💡 总结](#💡 总结)
-
📝 背景与问题描述
在 ZYNQ 开发中,PS(ARM处理器)与 PL(FPGA逻辑)之间的数据交互是最核心的环节之一。最近在做一个项目,架构很简单:PS 端通过 AXI BRAM Controller 将数据写入双端口 BRAM(Port A),然后 PL 端自定义逻辑从 BRAM(Port B)将数据读出。
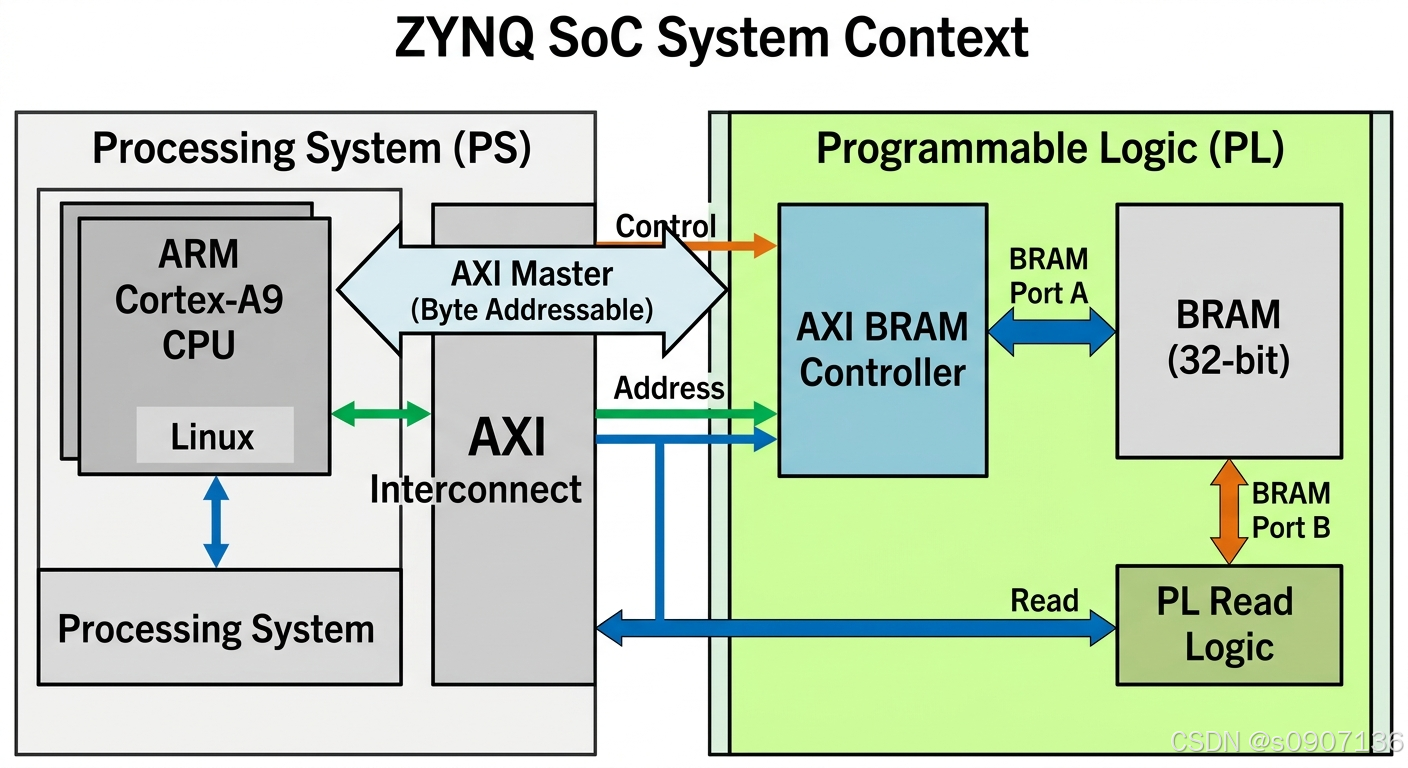
为了方便测试,我在运行 Linux 的 PS 端编写了如下 Shell 脚本,通过 devmem 命令直接向 BRAM 的物理地址写入 10 个递增的数据:
bash
#!/bin/sh
BRAM_BASE=0x40000000
DATA_COUNT=10

echo "向 BRAM 基地址 $BRAM_BASE 写入 $DATA_COUNT 个 32 位数据..."

i=0
while [ $i -lt $DATA_COUNT ]; do
    # 计算当前地址:每次加 4 字节
    addr=$(printf "0x%X" $((BRAM_BASE + i*4)))
    data=$i
    devmem "$addr" 32 $data
    echo "BRAM[$addr] = $data"
    i=$((i+1))
done
脚本运行非常成功,PS 端正确地以 0x40000000, 0x40000004, 0x40000008 的地址步长写下了数据 0, 1, 2...。
🚨 奇怪的现象出现了:
当我在 PL 端用 Verilog 编写状态机去读 BRAM(设置 BRAM 读出位宽为 32-bit),并且让读取地址每次 +1 时,读出来的数据却变成了这样:
- 读地址
0-> 读出数据0 - 读地址
1-> 读出数据0 - 读地址
2-> 读出数据0 - 读地址
3-> 读出数据0 - 读地址
4-> 读出数据1 - 读地址
5-> 读出数据1
...
为什么每 4 个连续地址读出的值是一样的?既然我的 BRAM 位宽是 32 位的,按理说地址递增 1,不就应该读出下一个 32-bit 的数吗?
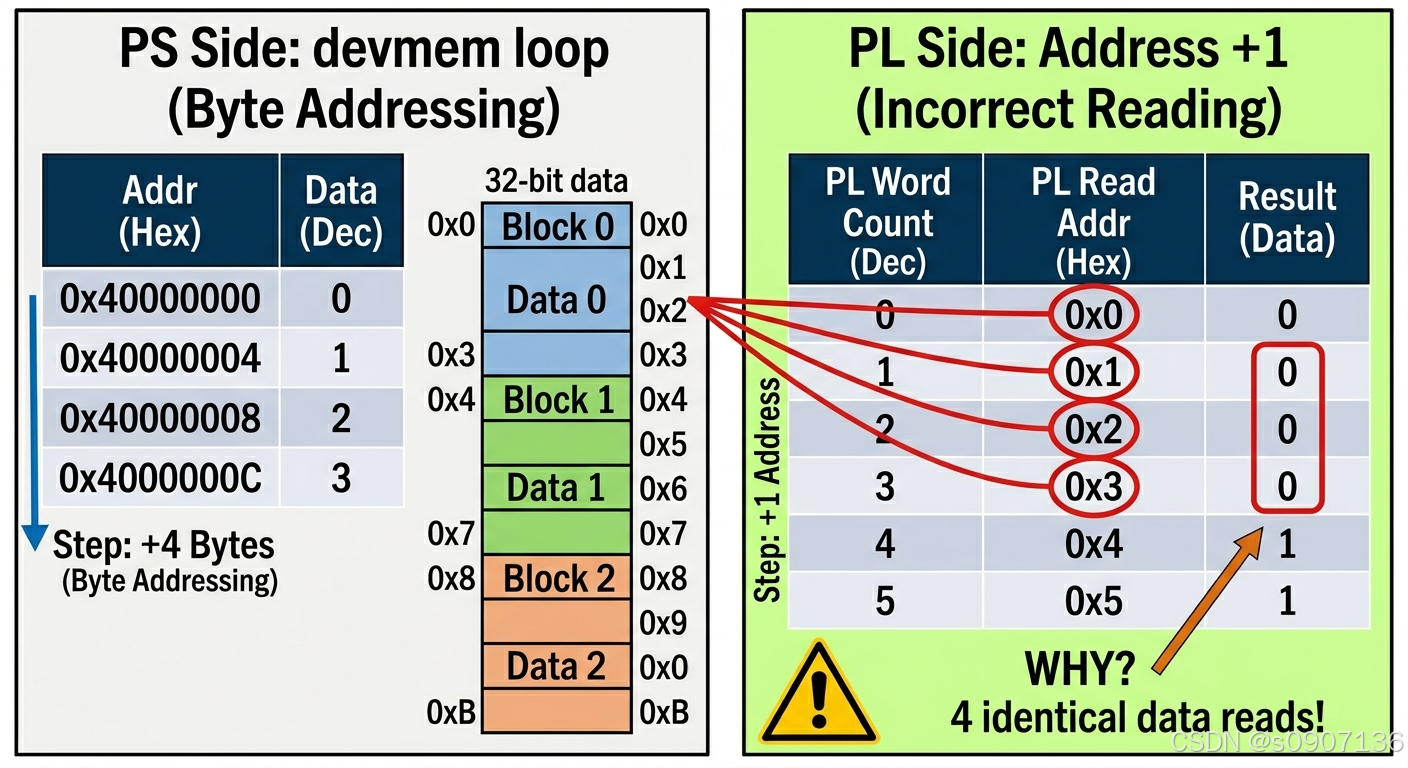
🔍 深度剖析:字编址 vs 字节编址的冲突
产生这个疑问非常合乎逻辑。如果是纯粹的 FPGA 设计(没有 ARM 和 AXI 总线),你例化一个 32-bit 位宽的 BRAM,确实是"地址0对应第0个数据,地址1对应第1个数据",这叫做字编址(Word Addressing)。
但在 ZYNQ 系统中,规则被 AXI 总线 改变了。
1. ARM 与 AXI 永远是"字节编址"
ARM 处理器和 AXI 总线是严格按照字节(Byte,8-bit) 来统一编址的。因为你要存一个 32-bit(4字节)的数据,它就必须占据 0x00、0x01、0x02、0x03 这 4 个连续的地址。下一个 32 位数据,只能从 0x04 开始存。你的 Shell 脚本非常正确地遵循了这一点。
2. AXI BRAM Controller 的强制干预
为了让 ARM 能够通过 AXI 总线顺利访问 PL 端的 BRAM,我们在 Block Design 中加入了 AXI BRAM Controller。这个 IP 核为了兼容 ARM 的规则,会强制把 BRAM 的编址方式统一修改为"字节编址" 。
这意味着,即使你的 BRAM B端口(PL端)设置成了 32 位宽,它外露的地址线接收的不再是"数据索引",而是"物理字节地址"。
3. BRAM 底层是如何处理不对齐的地址的?
当你的 PL 端想读 32 位数据,给出地址 0, 1, 2, 3, 4 时,BRAM 的硬件逻辑是这么处理的:
硬件是 32位对齐的,它不支持错位读取(Unaligned Read)。当你输入一个地址时,BRAM 会直接忽略地址线的最低 2 位(bit 1 和 bit 0)!
我们来看一下真值表就一目了然了:
| PL 端给出的地址 (十进制) | 二进制表示 | BRAM 实际响应的字节地址(忽略低2位) | 读出的 32 位数据来源 |
|---|---|---|---|
| 0 | ...0000 |
0 | PS 写入的第 0 个数据 (0x40000000) |
| 1 | ...0001 |
0 | PS 写入的第 0 个数据 (0x40000000) |
| 2 | ...0010 |
0 | PS 写入的第 0 个数据 (0x40000000) |
| 3 | ...0011 |
0 | PS 写入的第 0 个数据 (0x40000000) |
| 4 | ...0100 |
4 | PS 写入的第 1 个数据 (0x40000004) |
| 5 | ...0101 |
4 | PS 写入的第 1 个数据 (0x40000004) |
这就是为什么地址给 1、2、3 时,读出的全是地址 0 的数据!
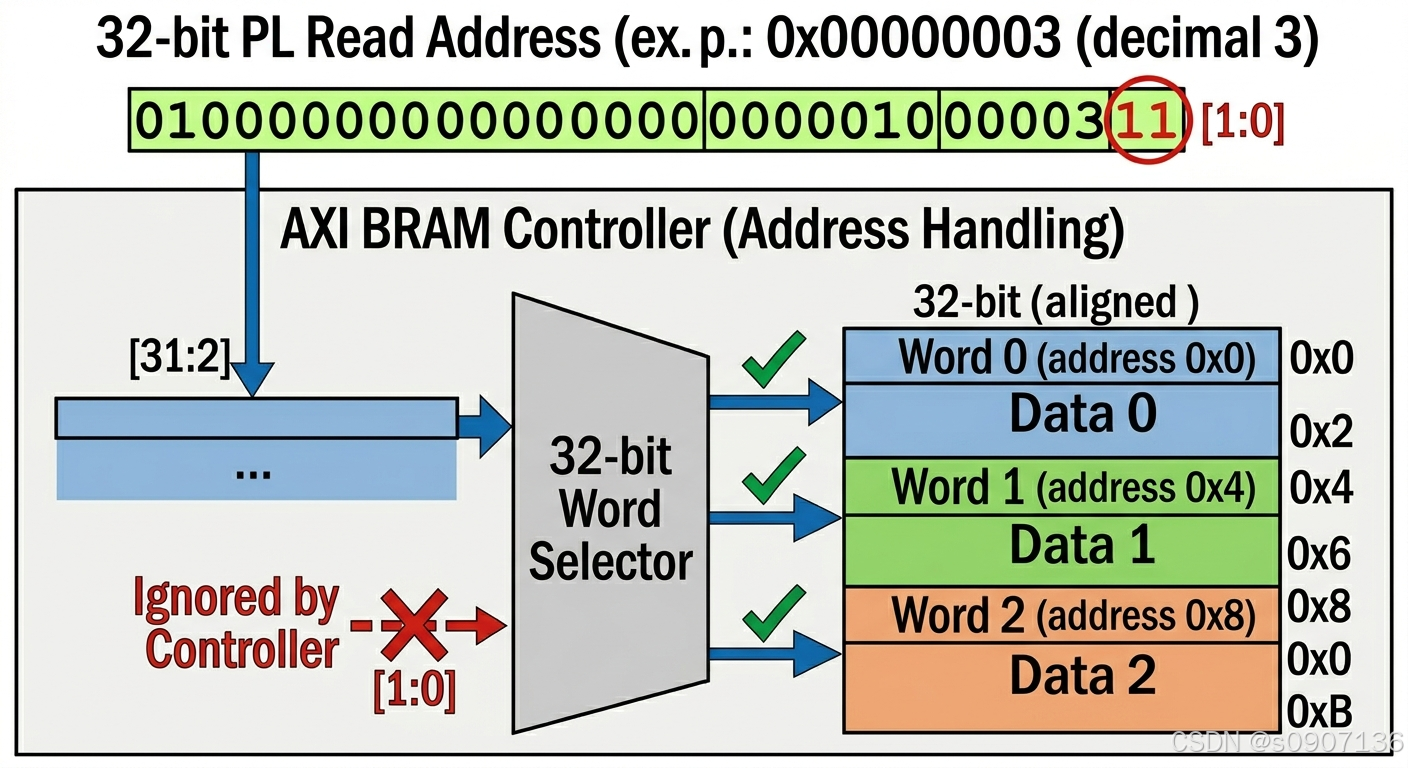
🛠️ 解决办法
搞懂了原理,解决起来就非常简单了。既然地址是按字节计算的,我们每次读取一个 32位(4字节)数据时,PL 端的读地址步长必须是 4。
这里提供两种常用的 Verilog 修改方案:
方案一:地址直接加 4(最直观)
将你原来状态机里地址 +1 的地方,直接改为 +4。
verilog
reg [31:0] bram_read_addr;

always @(posedge clk) begin
    if (rst) begin
        bram_read_addr <= 32'd0;
    end else if (read_enable) begin
        // 每次读取一个 32-bit 数据,地址需要加 4
        bram_read_addr <= bram_read_addr + 32'd4;
    end
end
方案二:使用计数器左移 2 位(推荐,逻辑更优雅)
在硬件设计中,我们往往习惯维护一个步长为 1 的"字计数器(Word Counter)"。我们可以保留计数器 +1 的逻辑,只需要在将其连给 BRAM 地址线时,左移 2 位(末尾补两个0,等效于乘以4) 即可。
verilog
reg [29:0] word_counter; // 字计数器(0, 1, 2, 3...)

always @(posedge clk) begin
    if (rst) begin
        word_counter <= 0;
    end else if (read_enable) begin
        word_counter <= word_counter + 1;
    end
end

// 给到 BRAM 的地址:计数器拼接 2'b00
assign bram_read_addr = {word_counter, 2'b00}; 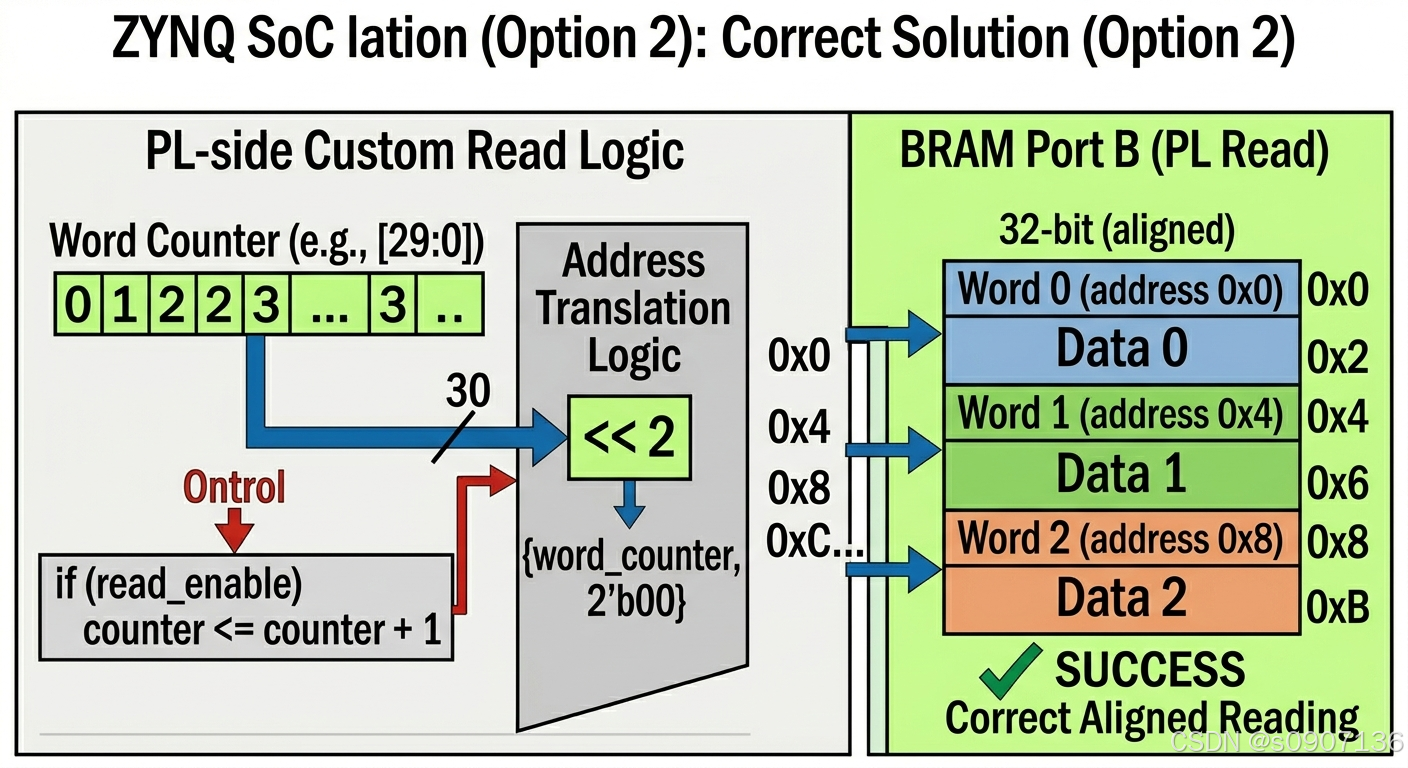
💡 总结
在 ZYNQ 软硬件协同开发中:
只要数据是挂载在 AXI 总线上的,地址计算就必须遵循"字节编址"的物理法则。
对于 32-bit 数据,地址步长为 4;对于 64-bit 数据,地址步长则为 8。改变以往纯 FPGA 开发中"地址每次加 1"的惯性思维,就能完美避开这个坑。