一、最佳实践
1. 优雅的key结构
(1) Redis 最佳实践约定
-
遵循基本格式:业务名称:数据名:id
-
长度不超过44字节
-
不包含特殊字符
例如:我们的登录业务,保存用户信息,其key可以设计成如下格式:
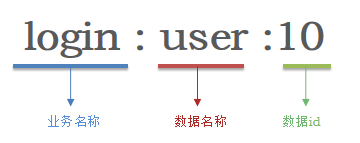
(2) 好处:
-
可读性强
-
避免key冲突
-
方便管理
-
更节省内存: key是string类型,底层编码包含int、embstr和raw三种。embstr在小于44字节使用,采用连续内存空间,内存占用更小。当字节数大于44字节时,会转为raw模式存储,在raw模式下,内存空间不是连续的,而是采用一个指针指向了另外一段内存空间,在这段空间里存储SDS内容,这样空间不连续,访问的时候性能也就会收到影响,还有可能产生内存碎片
2. 拒绝BigKey
(1) 什么是BigKey
BigKey通常以Key的大小和Key中成员的数量来综合判定,例如:
① Key本身的数据量过大:一个String类型的Key,它的值为5 MB
② Key中的成员数过多:一个ZSET类型的Key,它的成员数量为10,000个
③ Key中成员的数据量过大:一个Hash类型的Key,它的成员数量虽然只有1,000个但这些成员的Value(值)总大小为100 MB
(2) BigKey的危害
① 网络阻塞:
Redis 是基于网络的服务,客户端每次请求都要通过网络传输数据。如果是 BigKey,一次请求就要传几 MB 甚至几十 MB 的数据,哪怕只有少量请求,就能直接占满服务器带宽,导致 Redis 和整个物理机的网络都瘫痪。
② 数据倾斜:
Redis 集群是按「哈希槽(hash slot)」分片的,每个 key 会被分配到不同的 Redis 节点上。如果有一个超大的 BigKey,会直接把它所在的节点内存占满,而其他节点还很空闲,集群资源完全失衡,这个节点成为整个集群的瓶颈。
③ Redis阻塞:
对元素较多的hash、list、zset等做运算会耗时较旧,使主线程被阻塞
④ CPU压力:
对BigKey的数据序列化和反序列化会导致CPU的使用率飙升,影响Redis实例和本机其它应用
(3) 如何发现BigKey
| 方法 | 核心方式 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 1. redis-cli --bigkeys | 一键遍历所有 key,统计各类型 Top1 BigKey + 整体 key 分布 | 操作简单、无需编程、快速出结果 | 全量遍历易阻塞 Redis 主线程 | 测试环境、临时快速排查 |
| 2. scan 渐进式扫描 | 编程(如 Java/Jedis)调用 scan 分批遍历 key,结合 strlen/hlen 等命令判断大小 | 渐进式遍历,无阻塞,可自定义判断规则 | 需要编写代码,实现成本稍高 | 生产环境、精准排查 / 批量处理 BigKey |
| 3. Redis-Rdb-Tools | 离线分析 Redis 的 RDB 快照文件,全面统计内存使用 | 离线操作不影响 Redis,分析维度全 | 需等待 RDB 生成,结果非实时 | 全面审计内存、定位历史 BigKey 问题 |
| 4. 网络监控 | 监控 Redis 网络进出流量,超阈值告警 | 提前预警 BigKey(如大流量请求),被动发现问题 | 仅能告警异常流量,无法定位具体 BigKey | 生产环境常态化监控、提前发现风险 |
(4) 如何删除BigKey
BigKey内存占用较多,即便时删除这样的key也需要耗费很长时间,导致Redis主线程阻塞,引发一系列问题。
① Redis 3.0 及以下版本
- 如果是集合类型,则遍历BigKey的元素,先逐个删除子元素,最后删除BigKey
② Redis 4.0以后
- Redis在4.0后提供了异步删除的命令:unlink
3. 恰当的数据类型
(1) 比如存储一个User对象,我们有三种存储方式
① 方式一:json字符串
| user:1 | {"name": "Jack", "age": 21} |
|---|
优点:实现简单粗暴
缺点:数据耦合,不够灵活
② 方式二:字段打散
| user:1:name | Jack |
|---|---|
| user:1:age | 21 |
优点:可以灵活访问对象任意字段
缺点:占用空间大、没办法做统一控制
③ 方式三:hash(推荐)
|--------|------|------|
| user:1 | name | jack |
| user:1 | age | 21 |
优点:底层使用ziplist,空间占用小,可以灵活访问对象的任意字段
缺点:代码相对复杂
(2) 假如有hash类型的key,其中有100万对field和value,field是自增id,这个key存在什么问题?如何优化?
|---------|-----------|-------------|
| key | field | value |
| someKey | id:0 | value0 |
| someKey | ..... | ..... |
| someKey | id:999999 | value999999 |
① 存在的问题
- hash的entry数量超过500时,会使用哈希表而不是ZipList,内存占用较多
- 可以通过hash-max-ziplist-entries配置entry上限。但是如果entry过多就会导致BigKey问题
② 解决方案
拆分为小的hash,将 id / 100 作为key, 将id % 100 作为field,这样每100个元素为一个Hash
|----------|-------|-------------|
| key | field | value |
| key:0 | id:00 | value0 |
| key:0 | ..... | ..... |
| key:0 | id:99 | value99 |
| key:1 | id:00 | value100 |
| key:1 | ..... | ..... |
| key:1 | id:99 | value199 |
| .... |||
| key:9999 | id:00 | value999900 |
| key:9999 | ..... | ..... |
| key:9999 | id:99 | value999999 |
二、批处理优化
1. Pipeline
(1) MSet
Redis提供了很多Mxxx这样的命令,可以实现批量插入数据,例如:
-
mset
-
hmset
利用mset批量插入10万条数据
java
@Test
void testMxx() {
    String[] arr = new String[2000];
    int j;
    long b = System.currentTimeMillis();
    for (int i = 1; i <= 100000; i++) {
        j = (i % 1000) << 1;
        arr[j] = "test:key_" + i;
        arr[j + 1] = "value_" + i;
        if (j == 0) {
            jedis.mset(arr);
        }
    }
    long e = System.currentTimeMillis();
    System.out.println("time: " + (e - b));
}
说明:
① 数组长度设为 2000 是为了控制每次批量大小,避免数组过大。
② 每 1000 次循环就执行一次 mset,减少单次网络传输量。
③ j = (i % 1000) << 1;
<< 1是位运算,等价于 ×2- 所以公式简化为:
j = (i % 1000) * 2
(2) Pipeline
MSET虽然可以批处理,但是却只能操作部分数据类型,因此如果有对复杂数据类型的批处理需要,建议使用Pipeline
java
@Test
void testPipeline() {
    // 创建管道
    Pipeline pipeline = jedis.pipelined();
    long b = System.currentTimeMillis();
    for (int i = 1; i <= 100000; i++) {
        // 放入命令到管道
        pipeline.set("test:key_" + i, "value_" + i);
        if (i % 1000 == 0) {
            // 每放入1000条命令,批量执行
            pipeline.sync();
        }
    }
    long e = System.currentTimeMillis();
    System.out.println("time: " + (e - b));
}
2. 集群下的批处理
(1) 存在的问题
Redis 集群中,MSET/Pipeline 这类批量操作有强制限制:
一次请求携带的所有 key,必须分配到同一个哈希槽(slot),否则命令执行失败。但实际业务中,批量操作的 key 往往分散在不同 slot(对应不同集群节点),因此需要解决方案。
(2) 解决方案
| 方案 | 核心思路 | 耗时 | 优点 | 缺点 |
|---|---|---|---|---|
| 串行命令 | 放弃批量,for 循环逐个执行每个命令 | N 次网络 + N 次命令耗时(N 为命令数) | 实现最简单 | 耗时极长,完全失去批量意义,不推荐 |
| 串行 slot | 客户端按 slot 分组同 slot 的 key,每组用 Pipeline串行执行 | m 次网络 + N 次命令耗时(m 为 slot 分组数,m<N) | 耗时远低于串行命令 | 实现稍复杂,slot 越多耗时越长 |
| 并行 slot | 按 slot 分组后,各组 Pipeline并行执行(多线程 / 异步) | 1 次网络(并行) + N 次命令耗时 | 耗时极短,性能最优 | 实现最复杂,需处理并发 |
| hash_tag(哈希标签) | 给所有 key 加相同哈希标签(如{tag}key),强制所有 key 同 slot |
1 次网络 + N 次命令耗时 | 耗时极短、实现最简单 | 强制所有 key 落同一节点,极易造成数据倾斜,不推荐大规模使用 |
(3) Spring集群环境下批处理代码
java
   @Test
    void testMSetInCluster() {
        Map<String, String> map = new HashMap<>(3);
        map.put("name", "Rose");
        map.put("age", "21");
        map.put("sex", "Female");
        stringRedisTemplate.opsForValue().multiSet(map);


        List<String> strings = stringRedisTemplate.opsForValue().multiGet(Arrays.asList("name", "age", "sex"));
        strings.forEach(System.out::println);

    }
3. 服务器端优化-持久化配置
(1) 用来做缓存的Redis实例尽量不要开启持久化功能
(2) 建议关闭RDB持久化功能,使用AOF持久化
(3) 利用脚本定期在slave节点做RDB,实现数据备份
(4) 设置合理的rewrite阈值,避免频繁的bgrewrite
(5) 配置no-appendfsync-on-rewrite = yes,禁止在rewrite期间做aof,避免因AOF引起的阻塞
4. 服务器端优化-慢查询优化
(1) 什么是慢查询
① 定义:
并非执行逻辑复杂的查询才是慢查询,执行耗时超过设定阈值的 Redis 命令,统一归类为慢查询。
② 危害:
由于Redis是单线程的,所以当客户端发出指令后,他们都会进入到redis底层的queue来执行,如果此时有一些慢查询的数据,就会导致大量请求阻塞,从而引起报错。
③ 核心配置
| 配置项 | 作用 | 默认值 | 建议值 | 操作方式 |
|---|---|---|---|---|
slowlog-log-slower-than |
慢查询阈值(单位:微秒),超过该值的命令会被记录 | 10000 | 1000 | config get 查看、config set 动态修改 |
slowlog-max-len |
慢查询日志队列的最大长度(超出则淘汰最早的旧日志) | 128 | 1000 | config get 查看、config set 动态修改 |
(2) 如何查询慢查询
slowlog len:查询当前慢查询日志的总条数slowlog get [n]:读取 n 条慢查询日志,单条日志包含:日志编号、加入时间戳、执行耗时、执行的命令、客户端 IP + 端口、客户端名称slowlog reset:清空所有慢查询日志
5. 服务器端优化-命令及安全配置
-
Redis一定要设置密码
-
禁止线上使用下面命令:keys、flushall、flushdb、config set等命令。可以利用rename-command禁用。
-
bind:限制网卡,禁止外网网卡访问
-
开启防火墙
-
不要使用Root账户启动Redis
-
尽量不用默认的端口
6. 服务器端优化-Redis内存划分和内存配置
(1) 内存不足的风险
当 Redis 内存使用率超过 90% 时,会引发一系列问题:
- 键(Key)频繁被淘汰删除
- 命令响应时间变长
- QPS(每秒查询率)不稳定,服务可用性下降
(2) Redis 内存三大组成部分
| 内存类型 | 核心说明 | 关键问题 |
|---|---|---|
| 数据内存 | Redis 最核心的内存部分,用于存储所有键值对数据 | BigKey(大键)问题、内存碎片问题 |
| 进程内存 | Redis 主进程运行本身占用的内存(如代码、常量池等) | 仅几兆大小,生产环境中可忽略不计 |
| 缓冲区内存 | 包含客户端缓冲区、AOF 缓冲区、复制缓冲区;客户端缓冲区又分输入 / 输出缓冲区 | 内存占用波动大,BigKey 易引发内存溢出,是重点排查对象 |
(3) 内存碎片问题
Redis 底层按固定策略分配内存(如 8、16、20 字节等),而非按需精准分配:
- 若键实际仅需 10 字节,会分配 16 字节,多出的 6 字节无法被复用,形成内存碎片
- 碎片会浪费内存空间,降低内存整体利用率
(4) 缓冲区内存详解
① 三类缓冲区的特性
-
复制缓冲区:主从复制的repl_backlog_buf,如果太小可能导致频繁的全量复制,影响性能。通过replbacklog-size来设置,默认1mb
-
AOF缓冲区:AOF刷盘之前的缓存区域,AOF执行rewrite的缓冲区。无法设置容量上限
-
客户端缓冲区:分为输入缓冲区和输出缓冲区,输入缓冲区最大1G且不能设置。输出缓冲区可以设置
② 客户端输出缓冲区配置
bash
client-output-buffer-limit <class> <hard limit> <soft limit> <soft seconds><class>:客户端类型normal:普通客户端replica:主从复制客户端pubsub:发布订阅客户端
<hard limit>:硬限制,缓冲区大小超限时直接断开连接<soft limit>+<soft seconds>:软限制,缓冲区大小超限且持续soft seconds秒后断开连接- 0 表示无限制
7. 服务器端集群优化
(1) 集群完整性问题
- 默认配置下,Redis 集群检测到任意哈希槽(slot)不可用,就会停止对外服务。
- 解决方案:修改配置
cluster-require-full-coverage no,实现部分槽可用时集群仍能对外提供服务。
(2) 集群带宽问题
- 节点间通过 Ping 交互状态信息(含槽信息、集群状态),节点越多、状态数据量越大,带宽占用越高。
- 解决途径:控制集群节点数(少于 1000,业务庞大则建多集群);避免单物理机运行过多 Redis 实例;合理配置
cluster-node-timeout超时时间。
(3) 命令的集群兼容性问题
批处理命令要求 Key 必须落在同一个 slot,否则无法完成操作,需客户端额外处理数据。
(4) Lua 和事务问题
Lua 脚本和事务依赖原子性,若 Key 分布在不同节点 ,无法保证原子性,因此 Redis 集群模式不支持 Lua 脚本和事务。