在自动化文档处理流程中,PDF 文件可能因导出错误、内容重复或格式转换问题而包含多余页面。手动删除不仅耗时,而且处理大批量文件时容易导致文件损坏。
通过 C# 调用 .NET 组件实现程序化删除 PDF 页面,可以将功能无缝集成到桌面应用、Web 服务中,实现自动化、批量化处理。本文演示如何使用免费库 Free Spire.PDF for .NET 删除 PDF 文件中的单个或多个页面。
1. 安装
打开 Visual Studio,进入 工具 → NuGet 包管理器 → 程序包管理器控制台,执行:
sh
Install-Package FreeSpire.PDF或者,在 管理 NuGet 程序包 界面中搜索 FreeSpire.PDF 并安装最新版本。
2. 加载 PDF 文档
使用 PdfDocument 类。该库提供了多种加载方式:
csharp
using Spire.Pdf;

// 从文件路径加载
PdfDocument pdf = new PdfDocument();
pdf.LoadFromFile(@"C:\input.pdf");

// 从流加载
using (FileStream fs = new FileStream(@"C:\input.pdf", FileMode.Open))
{
    pdf.LoadFromStream(fs);
}

// 从字节数组加载
byte[] data = File.ReadAllBytes(@"C:\input.pdf");
pdf.LoadFromStream(new MemoryStream(data));
注意:
LoadFromFile内部会检查文件是否存在,若不存在则抛出FileNotFoundException。建议用File.Exists预判。
3. 删除单个 PDF 页面
🔑 关键规则:
Free Spire.PDF 的页面索引为 0 开头(0-based) ,日常使用的页码是 1 开头(1-based),删除前需要转换:
目标页码(1-based) - 1 = 代码索引(0-based)
csharp
// 示例:删除第 3 页,对应索引 2
pdf.Pages.RemoveAt(2);
返回值和影响:
RemoveAt 方法没有返回值。删除后,后续页面的索引会自动减 1。例如原本有 5 页,删除索引 2 后,原索引 3 变成新的索引 2
4. 删除多个 PDF 页面
删除多页时,删除靠前的页面会导致后续页面索引自动前移,直接删除会引发索引错误。
✅ 最佳方案:先将页码转为索引,再按【降序】删除
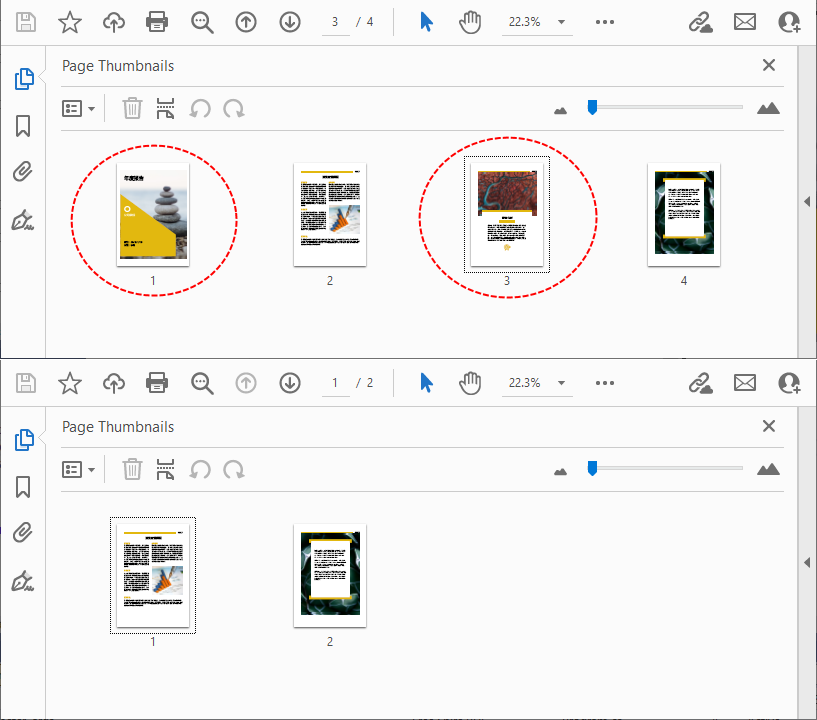
以下示例使用 1‑based 页码删除第 1 页和第 3 页:
csharp
// 定义需要删除的页码(1-based,直接填日常看到的页码即可)
int[] pagesToDelete = new int[] { 1, 3 };

// 转换为 0‑based 索引并降序排列
var deleteIndices = pagesToDelete
   .Select(page => page - 1)
   .Where(index => index >= 0 && index < pdf.Pages.Count) // 过滤无效索引
   .OrderByDescending(index => index);

// 循环删除页面
foreach (int index in deleteIndices)
{
   pdf.Pages.RemoveAt(index);
}
注意: 删除前务必使用
pdf.Pages.Count验证页码的有效性。
效果预览:
5. 保存修改后的 PDF 文件
删除完成后,调用 SaveToFile 保存文件,支持覆盖原文件或生成新文件:
csharp
// 保存到新文件
pdf.SaveToFile("output.pdf");

// 覆盖原文件(谨慎使用)
pdf.SaveToFile(@"C:\input.pdf");

// 保存到流
using (FileStream fs = new FileStream(@"output.pdf", FileMode.Create))
{
    pdf.SaveToStream(fs);
}

pdf.Close();
6. 完整可运行代码(含异常处理)
整合所有功能,加入异常捕获,适配文件损坏、页码无效、权限不足等场景:
csharp
using System;
using System.Linq;
using System.IO;
using Spire.Pdf;

class PdfPageDeleter
{
    static void Main(string[] args)
    {
        string inputPath = @"C:\docs\input.pdf";
        string outputPath = @"C:\docs\output.pdf";
        int[] pagesToDelete = { 2, 4 }; // 1‑based: 删除第 2 页和第 4 页

        try
        {
            using (PdfDocument pdf = new PdfDocument())
            {
                // 检查文件是否存在
                if (!File.Exists(inputPath))
                {
                    Console.WriteLine($"文件不存在: {inputPath}");
                    return;
                }

                pdf.LoadFromFile(inputPath);
                int originalPageCount = pdf.Pages.Count;
                Console.WriteLine($"原始页数: {originalPageCount}");

                // 过滤有效页码
                var indices = pagesToDelete
                    .Select(p => p - 1)
                    .Where(i => i >= 0 && i < originalPageCount)
                    .OrderByDescending(i => i)
                    .ToList();

                if (indices.Count == 0)
                {
                    Console.WriteLine("没有有效的页码需要删除。");
                    return;
                }

                foreach (int index in indices)
                {
                    pdf.Pages.RemoveAt(index);
                }

                Console.WriteLine($"删除后页数: {pdf.Pages.Count}");
                pdf.SaveToFile(outputPath);
                Console.WriteLine($"已保存到: {outputPath}");
            }
        }
        catch (System.IO.IOException)
        {
            Console.WriteLine("错误:PDF 文件被其他程序占用或无文件读写权限!");
        }
        catch (Exception ex)
        {
            Console.WriteLine($"操作失败: {ex.Message}");
        }
    }
}
7. 常见异常处理
开发中常见的异常场景,直接套用以下处理逻辑:
| 场景 | 处理方式 |
|---|---|
| 页码超出范围 | 通过 index < pdf.Pages.Count 过滤无效索引,避免报错 |
| 空 PDF 文件 | 判断 pdf.Pages.Count == 0,直接终止操作 |
| 文件损坏 / 无法读取 | 使用 try-catch 捕获加载异常 |
| 删除全部页面 | 免费库支持该操作,最终会生成一个空白 PDF 文件 |
| 文件权限不足 | 捕获 IOException,提示用户管理员权限运行程序 |
8. 页面集合操作
PdfDocument.Pages 属性返回 PdfPageCollection 对象。其他常用方法:
Count: 获取总页数。Insert(int index):在指定位置插入页面。Add():在末尾追加页面。
📚 更多方法参考该 API 接口文档
📌如果需要条件删除(例如删除包含指定关键词文本的页面) ,可以结合 PdfTextFinder 使用:
csharp
using Spire.Pdf.Texts;

PdfTextFinder finder = new PdfTextFinder(pdf.Pages[0]);
var found = finder.Find("机密"); // 返回文本位置列表
本文介绍了删除单页、多页和条件删除的 PDF 页面管理方案,可轻松集成到自动化工作流中,无需依赖 Adobe Acrobat 等外部软件。