在深度学习开发中,直接
pip install flash-attn容易出现各种问题,将报错输出复制给ai进行解决,总会给出各种各样的解决办法但是无法解决本质问题且极易失败。为此,推荐前往官方 Releases 页面下载适配的.whl文件进行本地安装。
文章目录
- [Flash Attention介绍](#Flash Attention介绍)
- [Flash Attention 编译安装](#Flash Attention 编译安装)
-
- [精准匹配对应 flash-attn 版本](#精准匹配对应 flash-attn 版本)
- [相关GPU 硬件架构限制表](#相关GPU 硬件架构限制表)
- 具体安装步骤
Flash Attention介绍
Flash Attention 的作用是在不牺牲模型精度的前提下,让注意力机制(Attention Mechanism)跑得更快、更省内存。
核心痛点 :传统 Attention 需要生成巨大的 N × N N \times N N×N 矩阵,导致 GPU 显存频繁在"慢速大内存 (HBM)"与"快速小内存 (SRAM)"间搬运数据。GPU 算力极强,但因为忙着搬数据,大部分时间在"空转"。
核心方案:FlashAttention 改变了计算路径:
- 分块 (Tiling): 将矩阵切成小块,在高速 SRAM 中完成计算,无需回写到慢速内存。
- 在线 Softmax: 实时处理数值,省去保存完整中间矩阵的步骤。
- 重计算: 在反向传播时实时重算部分数据,用极小的额外计算换取极大的显存空间。
传统 Attention与FlashAttention的对比
| 特性 | 传统 Attention | FlashAttention |
|---|---|---|
| 内存复杂度 | O ( N 2 ) O(N^2) O(N2) (平方级) | O ( N ) O(N) O(N) (线性级) |
| 计算速度 | 受限于内存带宽 | 充分利用 GPU 计算核心 |
| 适用场景 | 短文本 | 超长文本 (几十万 Token) |
总结 :
Flash Attention通过"少搬数据、多做计算"的策略,在不损失精度的前提下,让模型跑得更快、吃得更少、看得更长。
Flash Attention 编译安装
官方 Releases 页面 https://github.com/Dao-AILab/flash-attention/releases 提供许多批不同版本的 flash-attn,再点开 Assets 就能看见该版本具体兼容的各个文件。
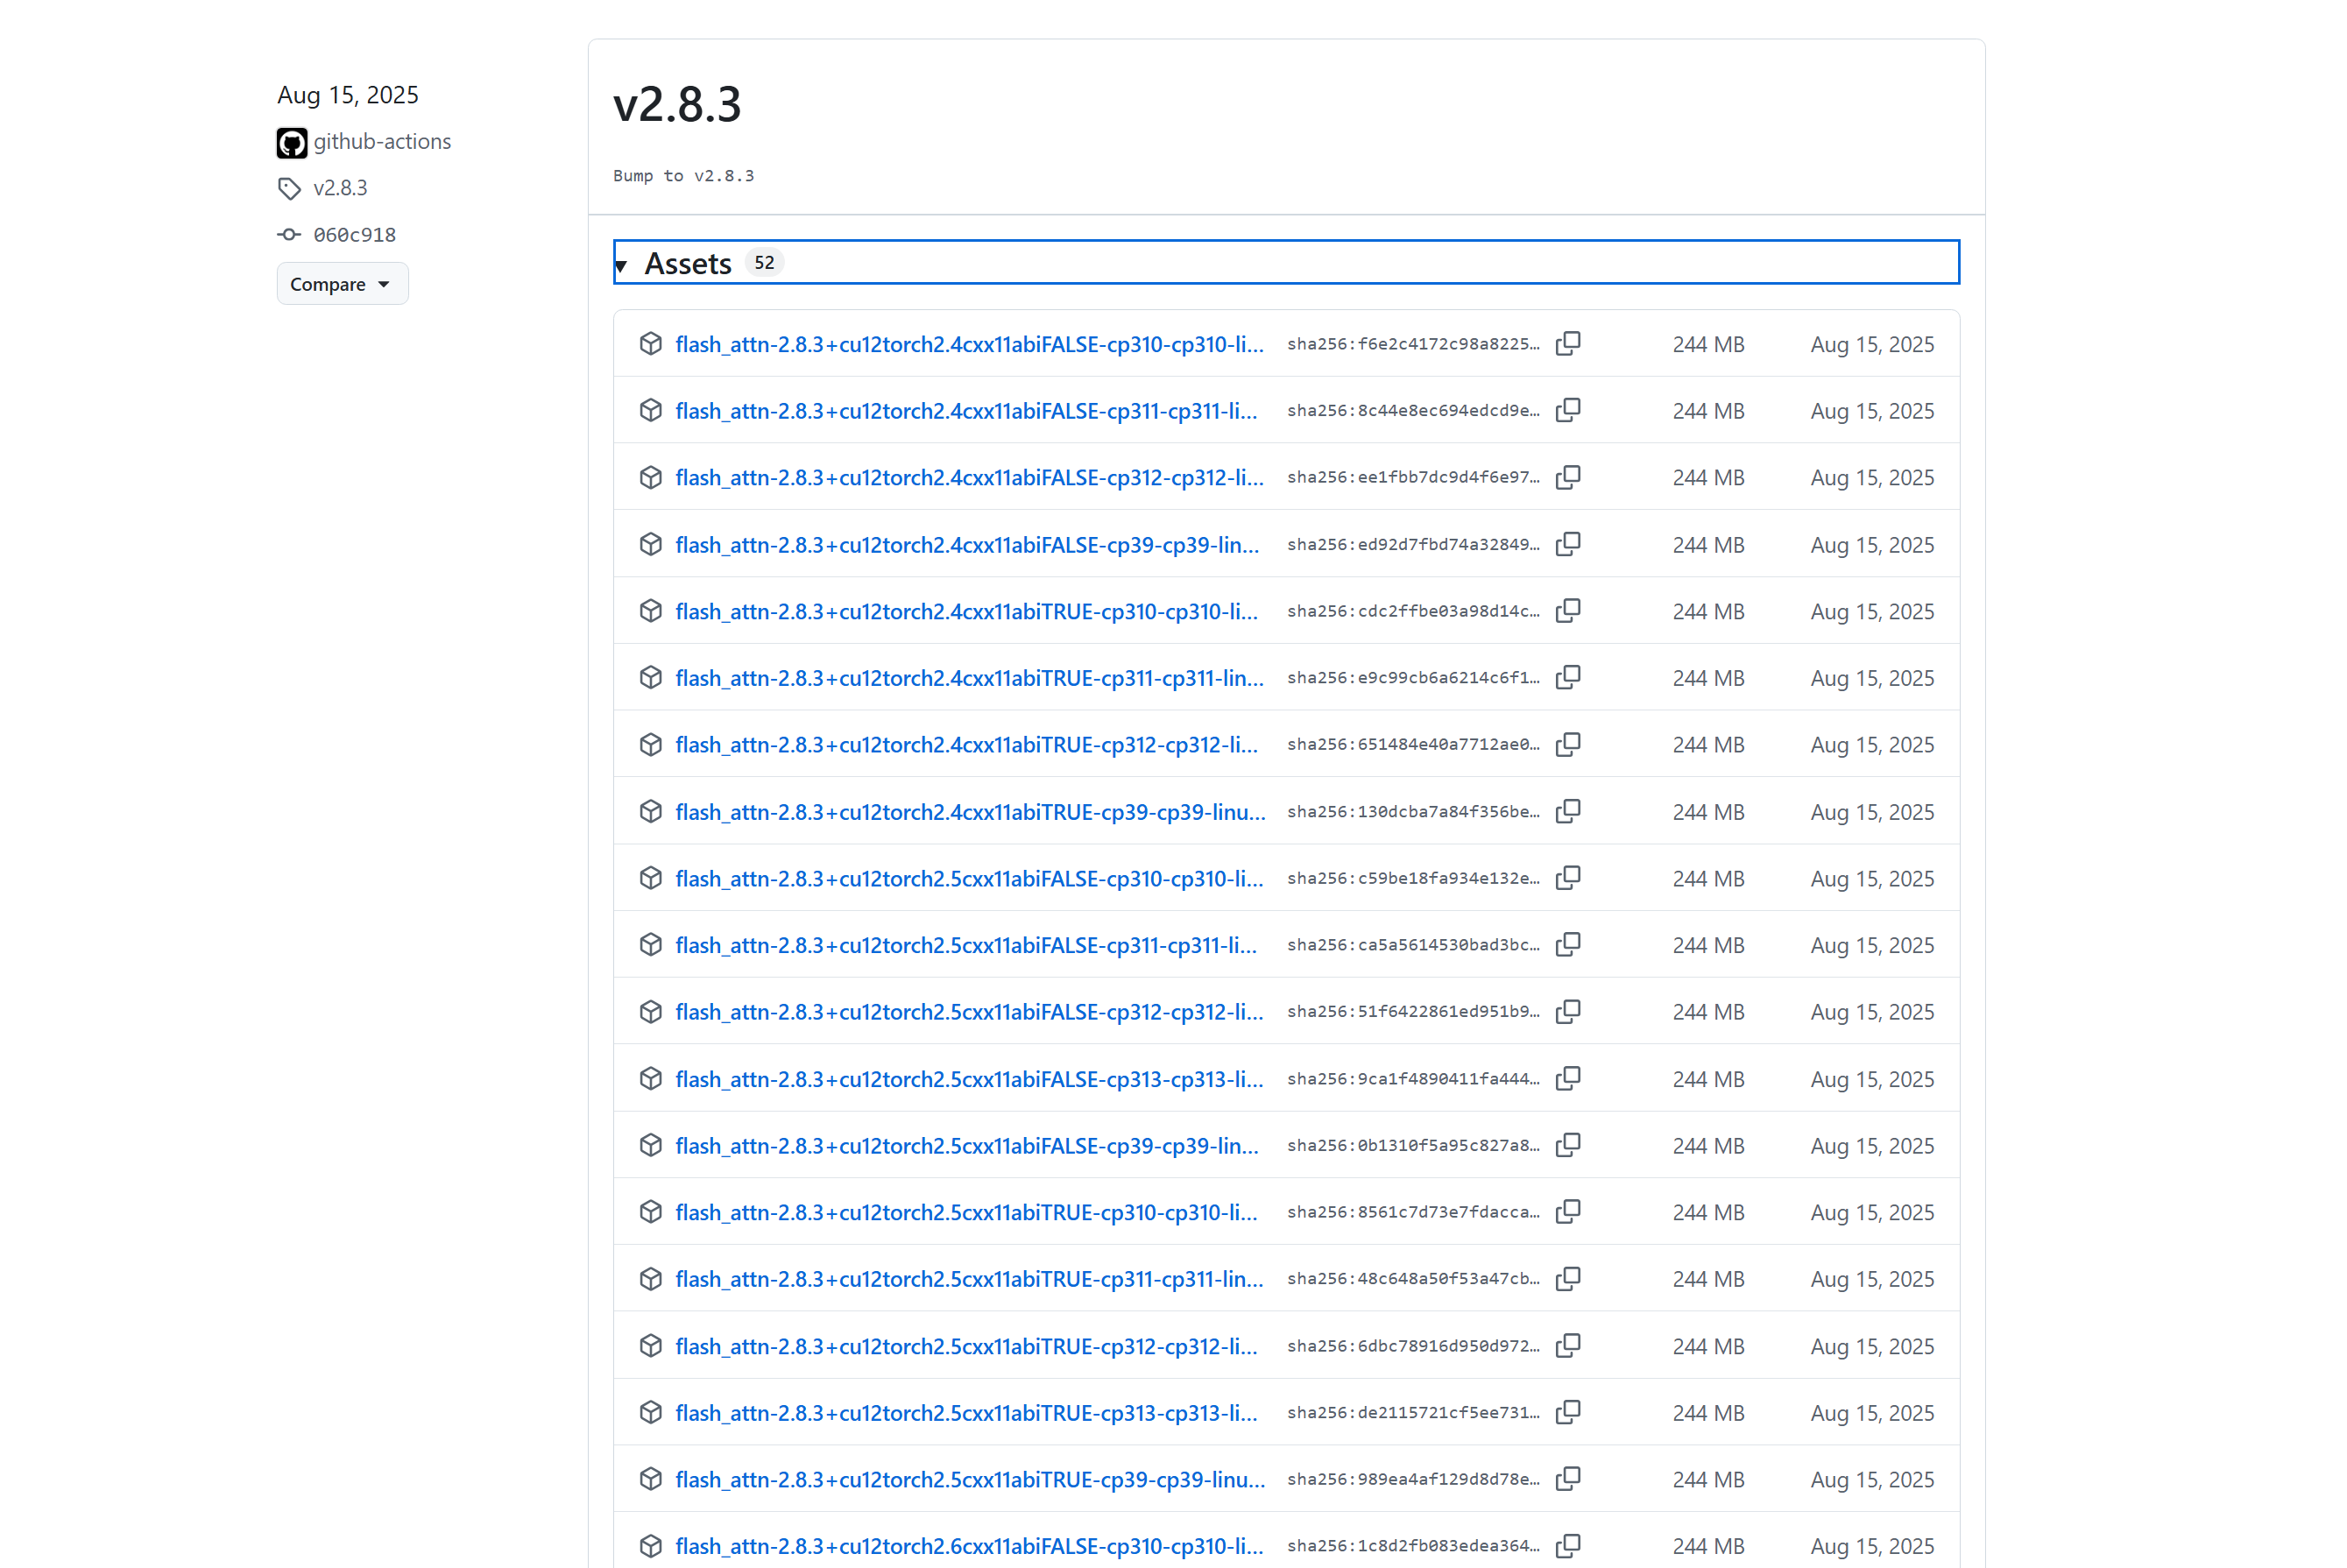
上面提供了多种版本,为了下到与环境匹配的版本,需要精确匹配到对应的文件名。
精准匹配对应 flash-attn 版本
官方提供的 .whl 文件名(例如 flash_attn-2.7.3+cu11torch2.6cxx11abiFALSE-cp312-cp312-linux_x86_64.whl)实际上是一张环境配置清单。我们需要逐一核对以下 5 个关键指标:
| 检查项 | 指令 | 目标值解读 |
|---|---|---|
| Python 版本 | python --version |
cp312 对应 Python 3.12 |
| CUDA 版本 | nvcc -V |
系统本地 CUDA Toolkit 版本 (如 cu11/cu12) |
| PyTorch 版本 | python -c "import torch; print(torch.__version__);" |
关注 torch2.6 部分 |
| Flash Attention 版本 | 查阅 GitHub Releases | 优先匹配模型要求的版本 |
| cxx11abi | python -c "import torch; print(torch._C._GLIBCXX_USE_CXX11_ABI)" |
输出 True/False,建议选 FALSE |
💡 专家提示: 若遇到 PyTorch 的 CUDA 版本与系统 CUDA Toolkit 不一致,优先通过重装 PyTorch 全家桶来匹配系统环境,这往往能解决 90% 的安装问题。
相关GPU 硬件架构限制表
安装前请务必确认你的显卡架构,并非所有版本都向下兼容:
| GPU 架构 | 代表型号 | 兼容性建议 |
|---|---|---|
| Hopper | H100/H800 | 完美支持 FA-2 & FA-3 |
| Ampere / Ada | A100/RTX 30系/40系 | 支持 FA-2 |
| Turing | RTX 20系/T4 | 需退回 FA-1.x |
| Pascal | GTX 10系 | 暂不支持 |
具体安装步骤
当你在 GitHub Releases 页面根据上述信息锁定目标文件后,执行以下操作:
-
准备环境:确保 PyTorch 环境已正确配置。
-
上传文件 :将下载好的
.whl文件通过 SCP/FTP 等方式上传至服务器。 -
安装命令 :
bash# 进入你的虚拟环境 pip install /path/to/your/flash_attn-xxx.whl
如果你在安装过程中遇到其他奇怪的 ABI 兼容问题,可以参考 Flash-Attention Issue #975。