4月24日,DeepSeek V4正式开源。同一天,海光DCU宣布完成Day0适配。消息一出,业内不少人感慨:这次国产算力跟上模型的速度,真不一样了。
这种"发布即适配"的能力并非偶然,背后折射出国产AI算力的三个结构性变化。
拐点一:从"追赶适配"到"同步适配"
以前是模型等芯片。一个大模型发布后,等国产芯片适配少则数周、多则数月,等适配好了下一版模型又快出来了。海光这次不一样------DeepSeek V4开源当天,适配同步完成。能做到这一步,靠的是内部建立的"预适配机制":通过技术路线预判和早期协同开发,提前完成底层准备。这意味着国产算力厂商已具备与头部模型厂商同频迭代的能力,时间窗口从"季度级"压缩到"天级",这是质的飞跃。
拐点二:从"单点突破"到"全栈闭环"
以前很多芯片厂商喜欢讲单卡算力,但企业要的不是一张卡,而是一套能用的方案。海光这次打的不只是芯片,而是DTK(算力层)+ DAS(框架层)+ DAP(应用层)的全栈方案。DTK搞定底层算力释放,DAS集成2000+算子覆盖主流框架,DAP内置知识库引擎和智能体编排,企业拿来就能搭应用。三层打通,这种"交钥匙"能力才是商业化落地的真正门槛。
拐点三:从"实验室可用"到"超大规模验证"
单卡跑通是及格线,万卡集群稳定跑才是真本事。海光DCU已为数万张卡组成的大规模算力集群提供支撑,多个万亿参数大模型在上面跑训练。分布式场景下的线性加速比、通信效率、故障容错、负载均衡,每一项都是硬骨头。海光能把这套系统跑通并投入生产,证明其工程化能力已过大规模验证。算力基础设施的成熟度,决定了上层应用的天花板。
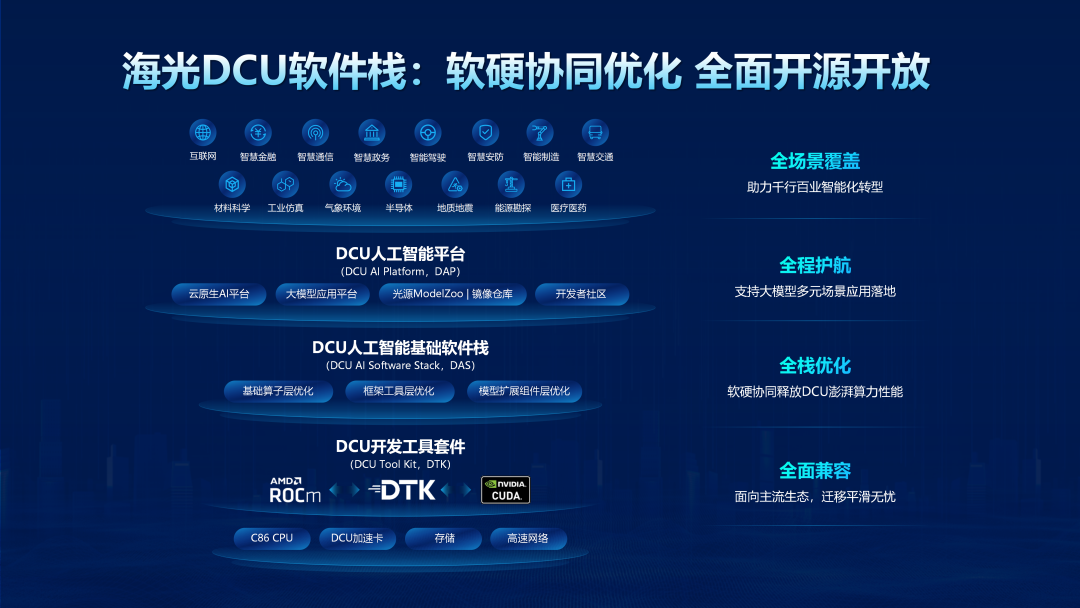
综合来看,国产AI算力正在从"可用"向"好用"阶段演进。海光DCU通过全栈软件栈和开放生态建设,为国产大模型提供了从底层算力到上层应用的完整支撑。未来12个月,国产大模型与国产算力的协同迭代效率,将成为行业关注的重要变量。这种模型与芯片的深度联动,正在逐步形成国产AI技术栈的独特竞争力。
**声明:**如以上内容有误或侵犯到你公司、机构、单位或个人权益,请联系我们说明理由,我们会配合,无条件删除处理。