模型独立的学习方式——自训练

一、定义

自训练(Self-Training),也叫自训练(Self-Teaching)或自举法(Bootstrapping),是一种非常简单的半监督学习算法Scudder, 1965, Yarowsky, 1995。

二、算法解析及伪代码

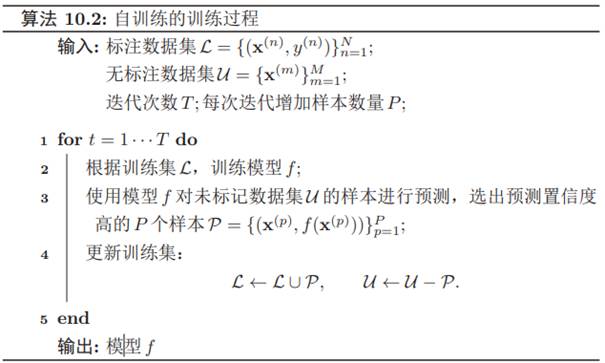
自训练是首先使用标注数据来训练一个模型,并使用这个模型来预测无标注样本的标签,把预测置信度比较高的样本及其预测的伪标签加入训练集,然后重新训练新的模型,并不断重复这个过程。算法10.2给出了自训练的训练过程。
三、总结

自训练和密度估计中EM算法有一定的相似之处,通过不断地迭代来提高模型能力。但自训练的缺点是无法保证每次加入训练集的样本的伪标签是正确的。如果选择样本的伪标签是错误的,反而会损害模型的预测能力。因此,自训练最关键的步骤是如何设置挑选样本的标准。

相关推荐
Asher11251 小时前
电池数据整理复盘:从 MAT 文件到充电曲线
机器学习
龙腾AI白云2 小时前
具身智能的空间导航与未知环境探索
大数据·数据库·人工智能·机器学习·知识图谱
汤姆宝库5 小时前
RoPE旋转位置编码的实现与长上下文外推
python·深度学习·机器学习
tellmewhoisi5 小时前
深度学习0:数学知识:(L1正则化和L2正则化)
人工智能·深度学习
回眸&啤酒鸭7 小时前
【回眸】Hy4 模型效果展示与能力评测大纲
大数据·人工智能·机器学习
AI小怪兽7 小时前
你的视觉基础模型会说“植物语“吗?面向目标检测的视觉基础模型植物语法
人工智能·深度学习·机器学习
峯5807 小时前
机器学习05,用 scikit-learn 做加州房价预测的完整入门工程
人工智能·机器学习·scikit-learn
伞伞悦读7 小时前
【第86期】分类指标与错误成本对照的实验与排查
大数据·人工智能·机器学习
AI源码8 小时前
基于机器学习的优衣库销售预测与决策系统
人工智能·机器学习