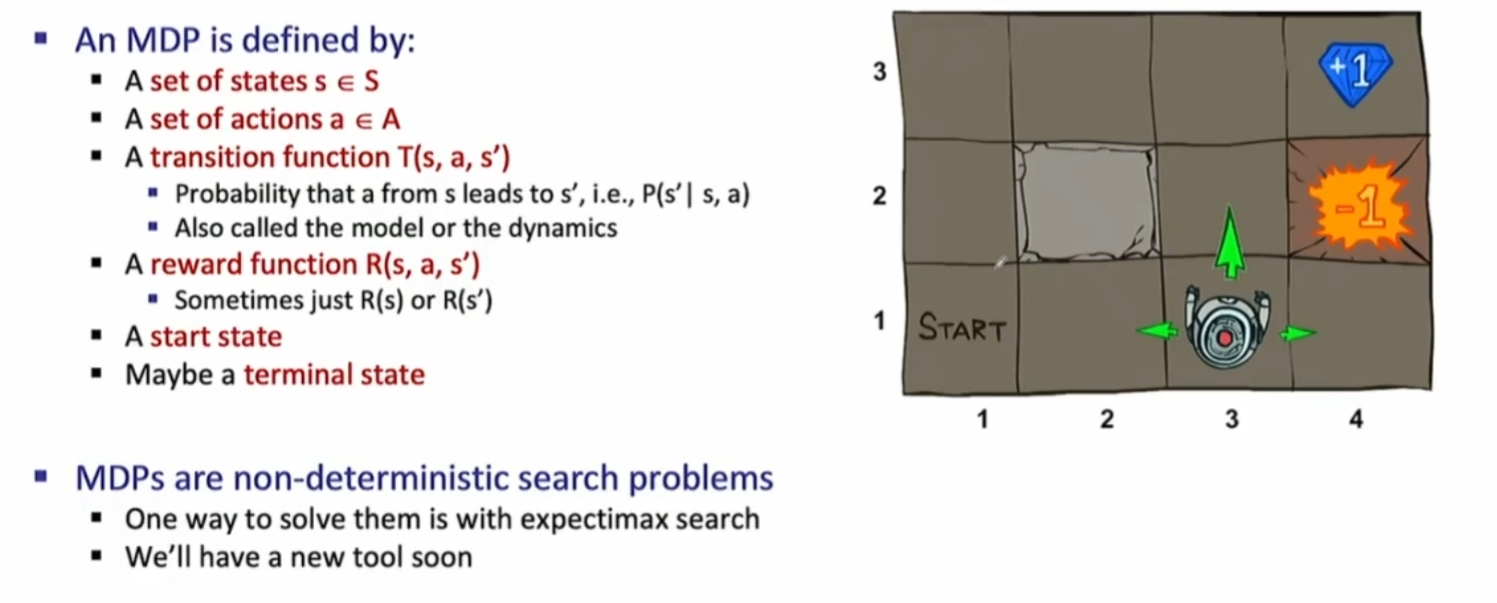
📖 学习笔记:从 MDP 到具身智能核心算法
1. 马尔可夫决策过程 (MDP):决策的数学基石
- 本质: 一种描述"带有选择权的随机过程"的数学模型。
- 五元组 (S,A,P,R,γ)(S, A, P, R, \gamma)(S,A,P,R,γ):
- SSS (状态):环境现在的样子(如机器人的关节角度、视觉画面)。
- AAA (动作):智能体能做的选择(如电机力矩、移动方向)。
- PPP (转移概率):世界运行的规律,即执行动作后环境变化的概率。
- RRR (奖励):对动作好坏的即时评价。
- γ\gammaγ (折扣因子):决定看重眼前利益还是长远发展。
- 核心特性: 马尔可夫性。即"未来只取决于现在,与过去无关"。
2. 核心概念对比:寻找最优策略
- MDP vs. 强化学习 (RL):
- MDP 是"剧本/地图",规则已知,通过数学计算(贝尔曼方程)求最优解。
- RL 是"探险/试错",规则未知,通过在环境中不断摸索来逼近 MDP 的最优解。
- 搜索 vs. MDP:
- 搜索(如 A*)通常处理确定性环境下的路径规划。
- MDP 处理带有随机性(概率)和多步奖励的复杂动态决策。
3. 学习方式的演进:如何获取动作逻辑?
| 学习方式 | 核心驱动 | 比喻 | 适用场景 |
|---|---|---|---|
| 强化学习 (RL) | 奖励信号 (Reward) | 独自摸索,撞墙后总结 | 仿真环境中优化极致性能,自创动作。 |
| 模仿学习 (IL) | 专家数据 (Demos) | 跟着老师学动作 | 快速上手,学习人类的先验知识(如灵巧手抓取)。 |
| 扩散模型 (Diffusion) | 概率分布还原 | 从模糊意图打磨出丝滑动作 | 解决多方案(多峰)问题,生成像人一样连贯的动作流。 |
这份笔记总结非常到位,尤其是你最后补充的这张幻灯片,正好精准地抓住了 规划(Planning) 与 学习(Learning) 的分水岭。
以下是为你整理的完整学习笔记,包含这张图片的深度解读:
4. 关键转折点:规划 (Planning) vs. 学习 (Learning)
正如幻灯片所言:"那不是规划,而是学习!"
| 维度 | 规划 (Planning) | 学习 (Learning/强化学习) |
|---|---|---|
| 已知条件 | 模型已知 :你知道所有的 PPP 和 RRR。 | 模型未知:你不知道动作后的后果和奖励。 |
| 操作方式 | 离线计算:在脑子里或纸上根据公式推导。 | 实地尝试:必须"实际行动"去摸索。 |
| 典型算法 | 价值迭代、策略迭代。 | Q-Learning, PPO, SAC。 |
| 比喻 | 拿着完美的地图找路线。 | 在迷宫里边撞墙边画地图(老虎机比喻)。 |
关键认知: 即使底层是一个 MDP,如果你无法通过纯计算(Computation)解决它,你就必须通过**行动(Act)**来获取经验,这正是强化学习的起点。
5. 具身智能 (Embodied AI) 中的算法演进
在机器人(如灵巧手操控)领域,这几类算法扮演着不同的角色:
- 强化学习 (RL):通过"试错"最大化奖励。适合在仿真环境中优化极致的物理性能。
- 模仿学习 (IL):跟着老师学动作(专家数据)。利用先验知识缩小搜索范围。
- 扩散模型 (Diffusion):将模糊意图"去噪"成丝滑动作。处理复杂多变的动作流(多峰分布)。
6. 实操工具:Gymnasium
- 定位:强化学习的标准接口协议。
- 作用:将算法与环境(MuJoCo, Isaac Gym)解耦。
- 核心循环 :
reset()初始化。step(action)获得next_state,reward,terminated。- 根据反馈更新策略。
💡 结语:如何算"懂了"?
- 建模能力 :能把现实任务(点外卖、抓物体)拆解成 S,A,P,RS, A, P, RS,A,P,R。
- 直觉判断:看到任务能立刻分辨是该用"纯搜索规划"还是"强化学习"。
- 工程落地 :能通过修改奖励函数 RRR 和折扣因子 γ\gammaγ 来引导 AI 做出符合人类预期的行为。