深度剖析NLP模型的实现步骤(二)

我们接着上文来讲:

2. 数据预处理

先贴出代码部分:
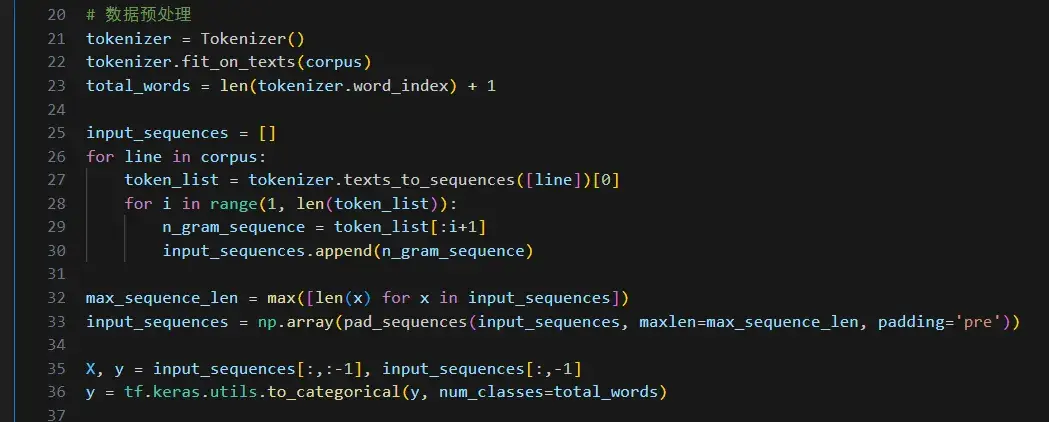
之所以这么写是因为在这一步中,使用 Tokenizer 类来对文本进行标记化处理,将每个单词转换为一个唯一的整数标识。

然后,根据标记化后的文本创建了输入序列 X 和目标序列 y,其中 X 包含了每个序列的前 n-1 个单词,而 y 包含了每个序列的最后一个单词,并将其转换为 one-hot 编码的形式。
3. 模型的构建和训练

当文本数据处理好后,就可以构建模型了,相关代码如下:
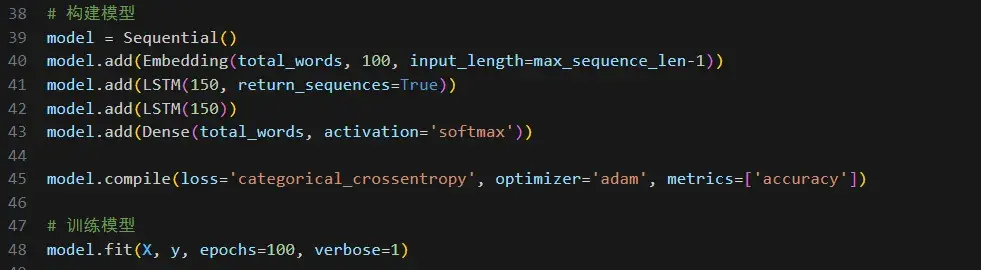
在这一步中,我们构建了一个 基于 LSTM 的神经网络模型。

该模型包含了一个 Embedding 层用于将整数标识的单词转换为密集向量表示,两个 LSTM 层用于学习文本序列的时间依赖关系,以及一个 Dense 层用于输出下一个预测的单词。接着使用了交叉熵损失函数和 Adam 优化器进行模型的编译,并使用训练数据对模型进行了训练。

当然,上面的模型相关参数是可以修改的,我这里只是为了讲解设置了很简单的参数,你可以后面把他们修改成你想要的参数值。

相关推荐
深蓝AI7 小时前
26.1% 的 Agent 技能带漏洞:skills 霸榜 GitHub 当天,NVIDIA 和 OpenAI 同时掏出安检仪
人工智能·程序员
锋行天下13 小时前
langgraph 后端发自定义数据,前端接收方法概括
人工智能·python
泯泷14 小时前
单个 AI 再强,为什么也干不过一支 AI 团队?
人工智能·llm·agent
浪遏14 小时前
认识 wm:从多平台发布到可扩展 CLI 的架构设计
人工智能
深蓝AI15 小时前
英伟达换帅当天,我先跑了一遍 GPU 环境体检:版本矩阵比人事更值得盯
人工智能·gpu
罗西的思考16 小时前
【轻量化复刻大模型 / KIMI K3】AttnRes 模块交互式演示
人工智能·算法·机器学习
stormzhangV17 小时前
涨薪 50% 怎么做到的?
人工智能·面试·aigc
老金带你玩AI17 小时前
如何在5分钟之内创建Grok Bot的超级团队
人工智能
程序员cxuan18 小时前
离谱,AI 大佬顺手搓了个 YouTube ,而我顺手给他搓了个中文插件
人工智能·后端·程序员
zixu_star18 小时前
上下文工程:Prompt、记忆和上下文如何管理?
人工智能·prompt