随着大模型参数规模持续扩大,智算中心的竞争重点正在从"部署多少张GPU",转向"能够输出多少有效算力"。
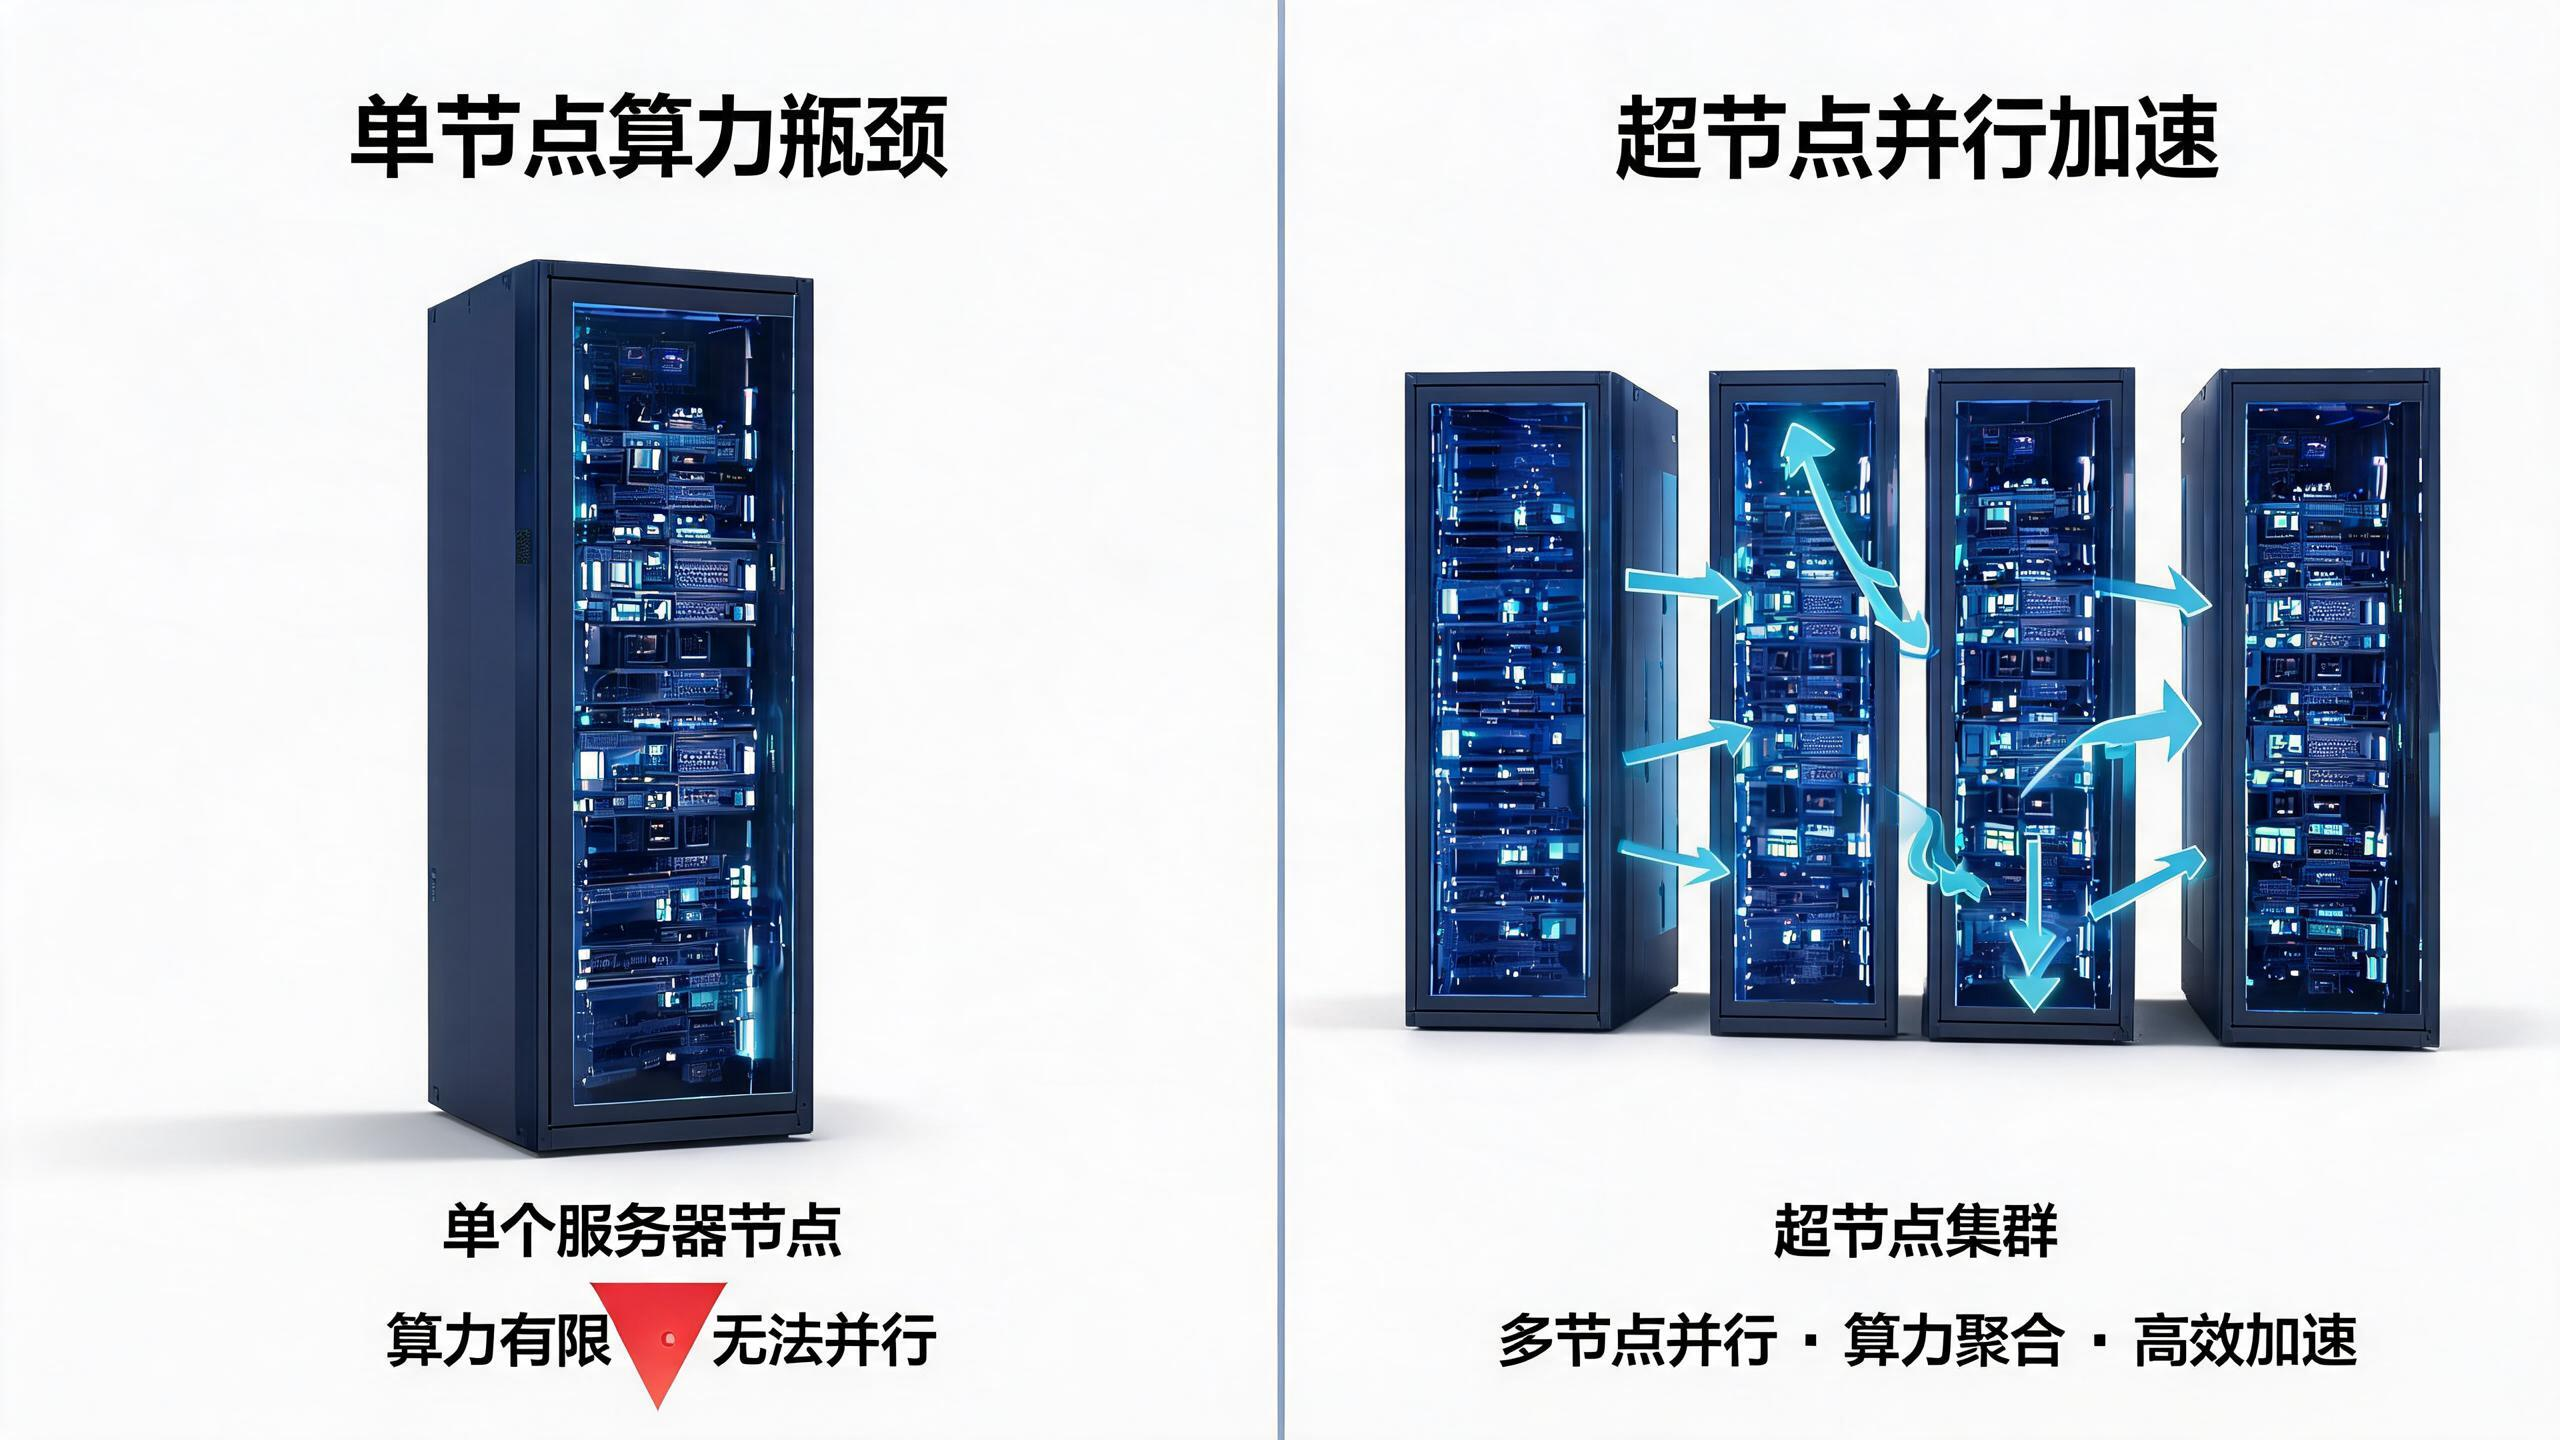
在传统智算集群中,大量服务器虽然可以提供较高的理论算力,但在实际训练过程中,GPU之间需要频繁进行数据传输、参数同步和任务协同。如果网络带宽不足、通信时延过高,就容易出现GPU等待、资源空转等问题。
超节点集群由此成为新一代智算中心的重要发展方向。
什么是超节点集群?
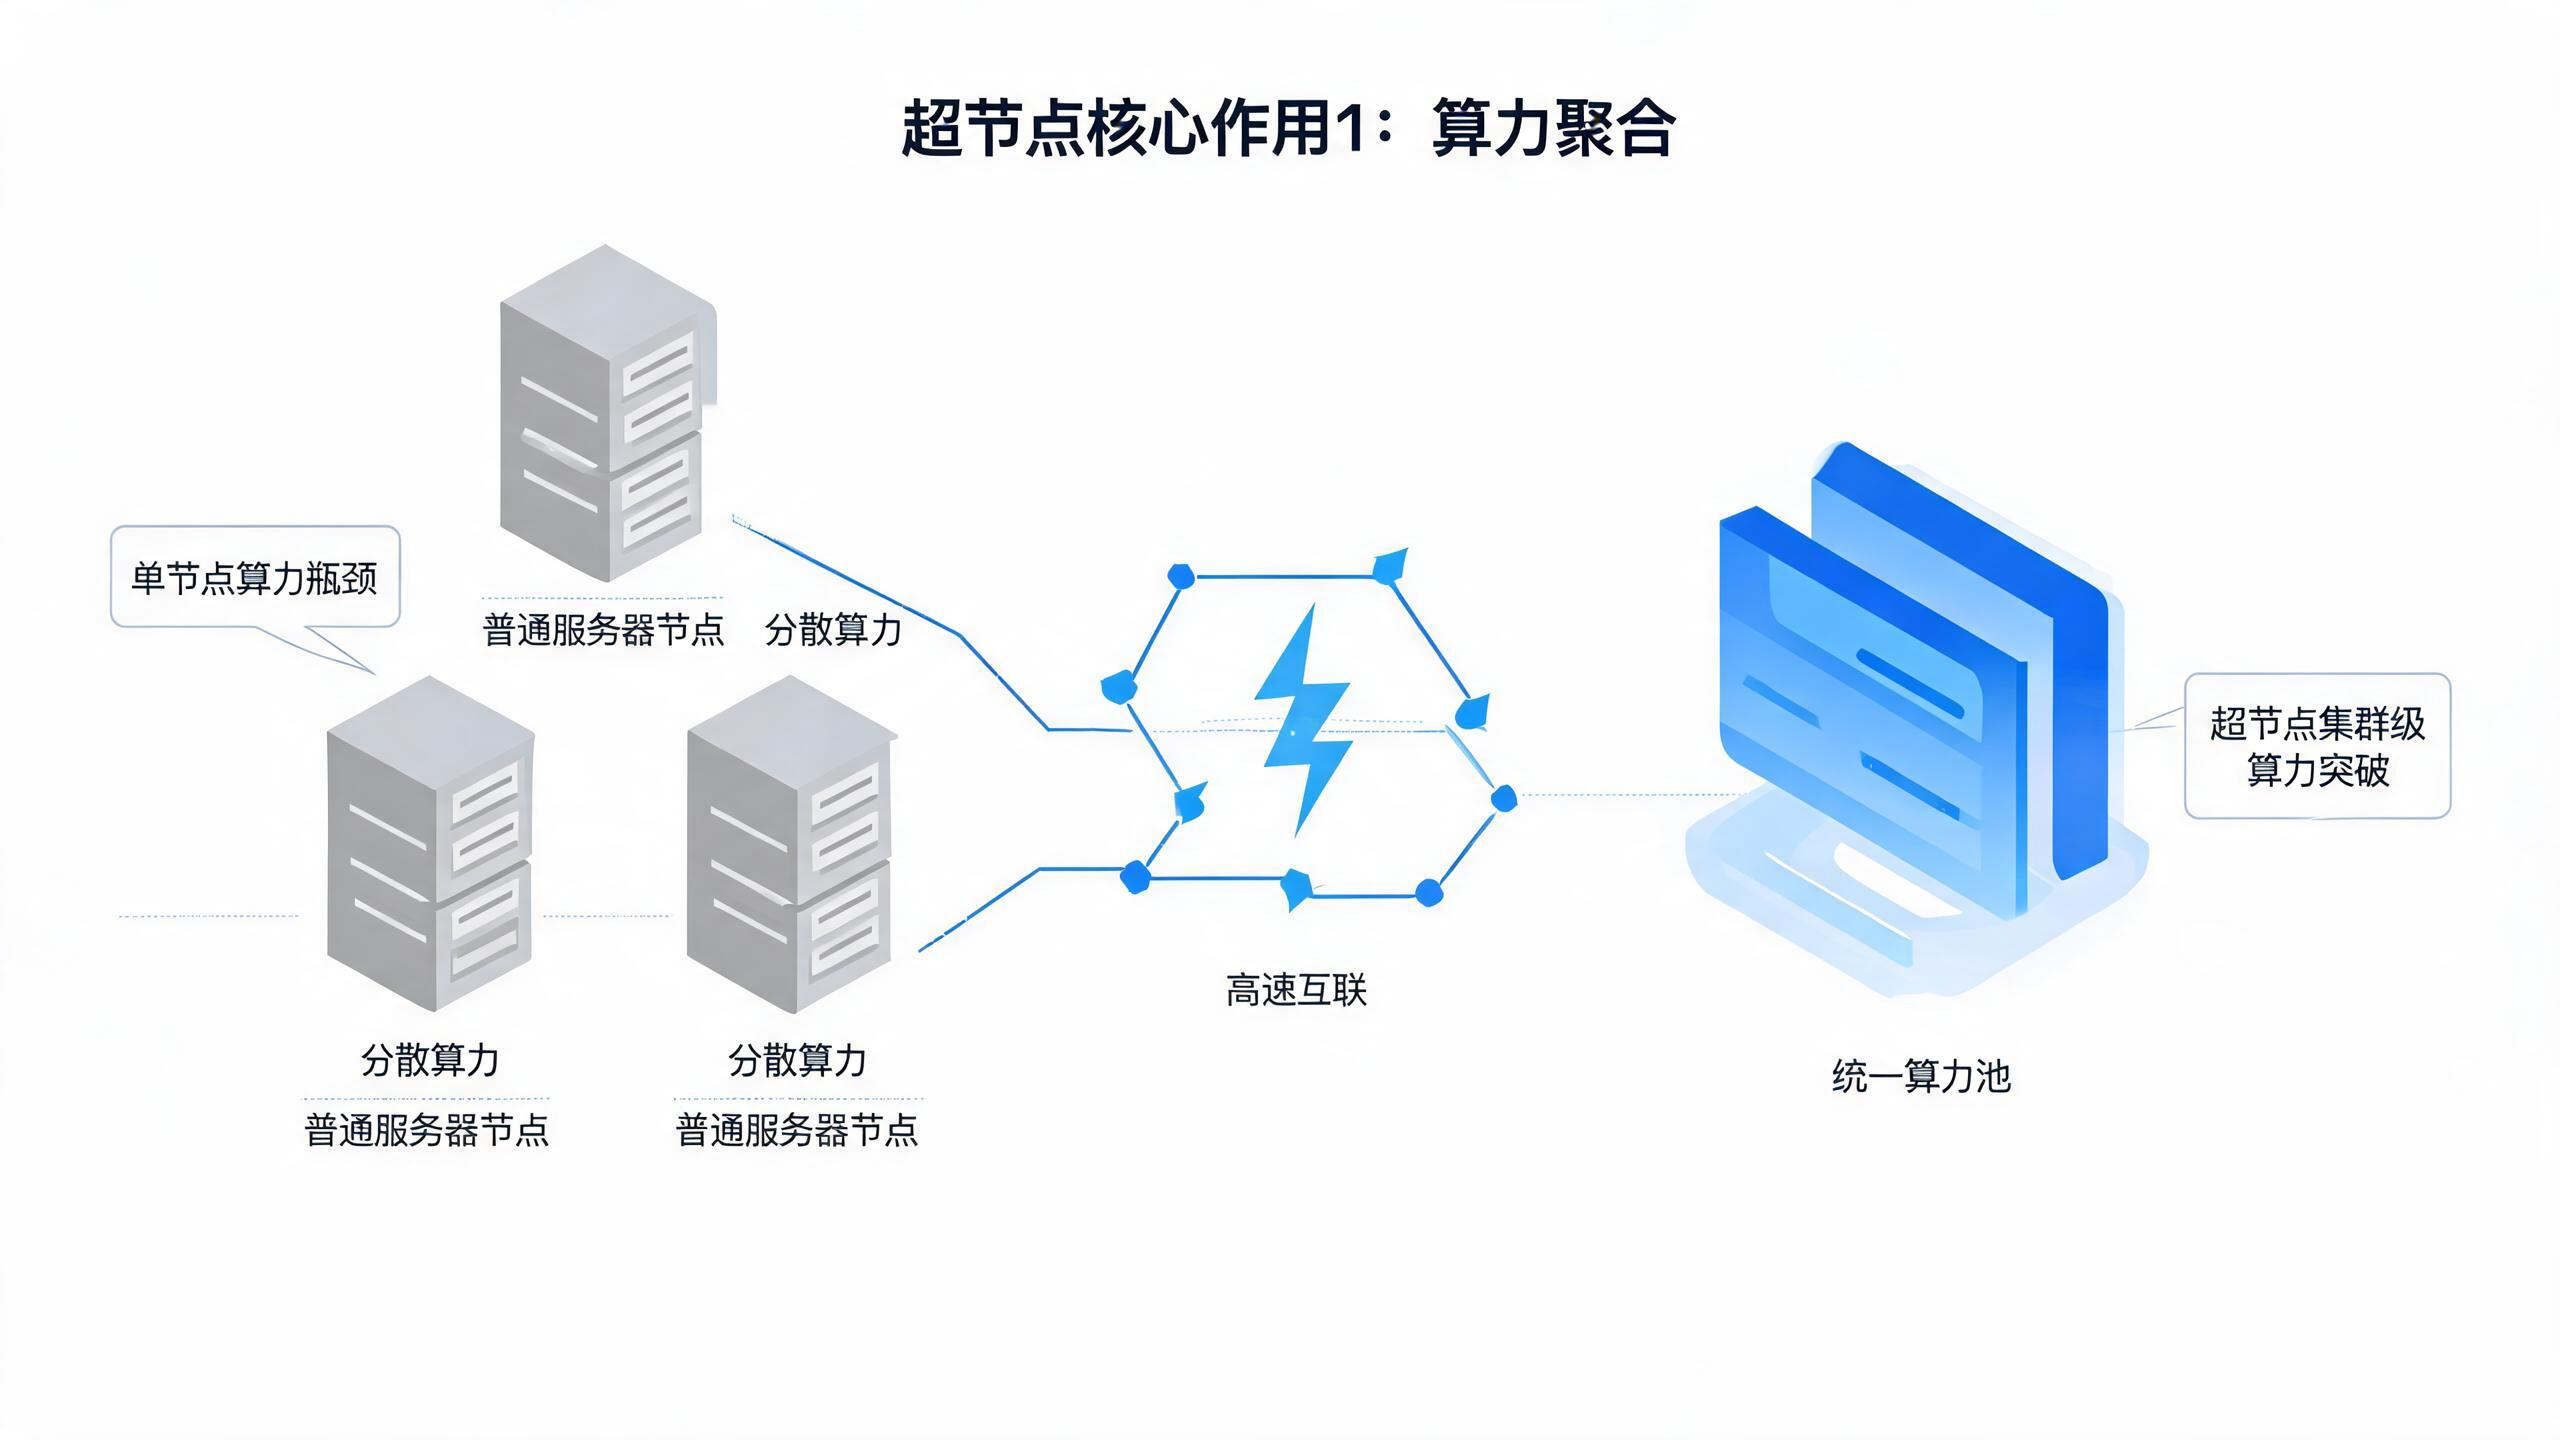
超节点集群是通过高速互联技术,将多台服务器、数十张甚至数百张GPU连接起来,使其在逻辑上像一台大型计算机一样协同运行。
它并不是简单增加服务器数量,而是对计算、网络、存储和调度系统进行统一设计,从而提升整个集群的运行效率。
智算中心为什么需要超节点?
提升大模型训练效率
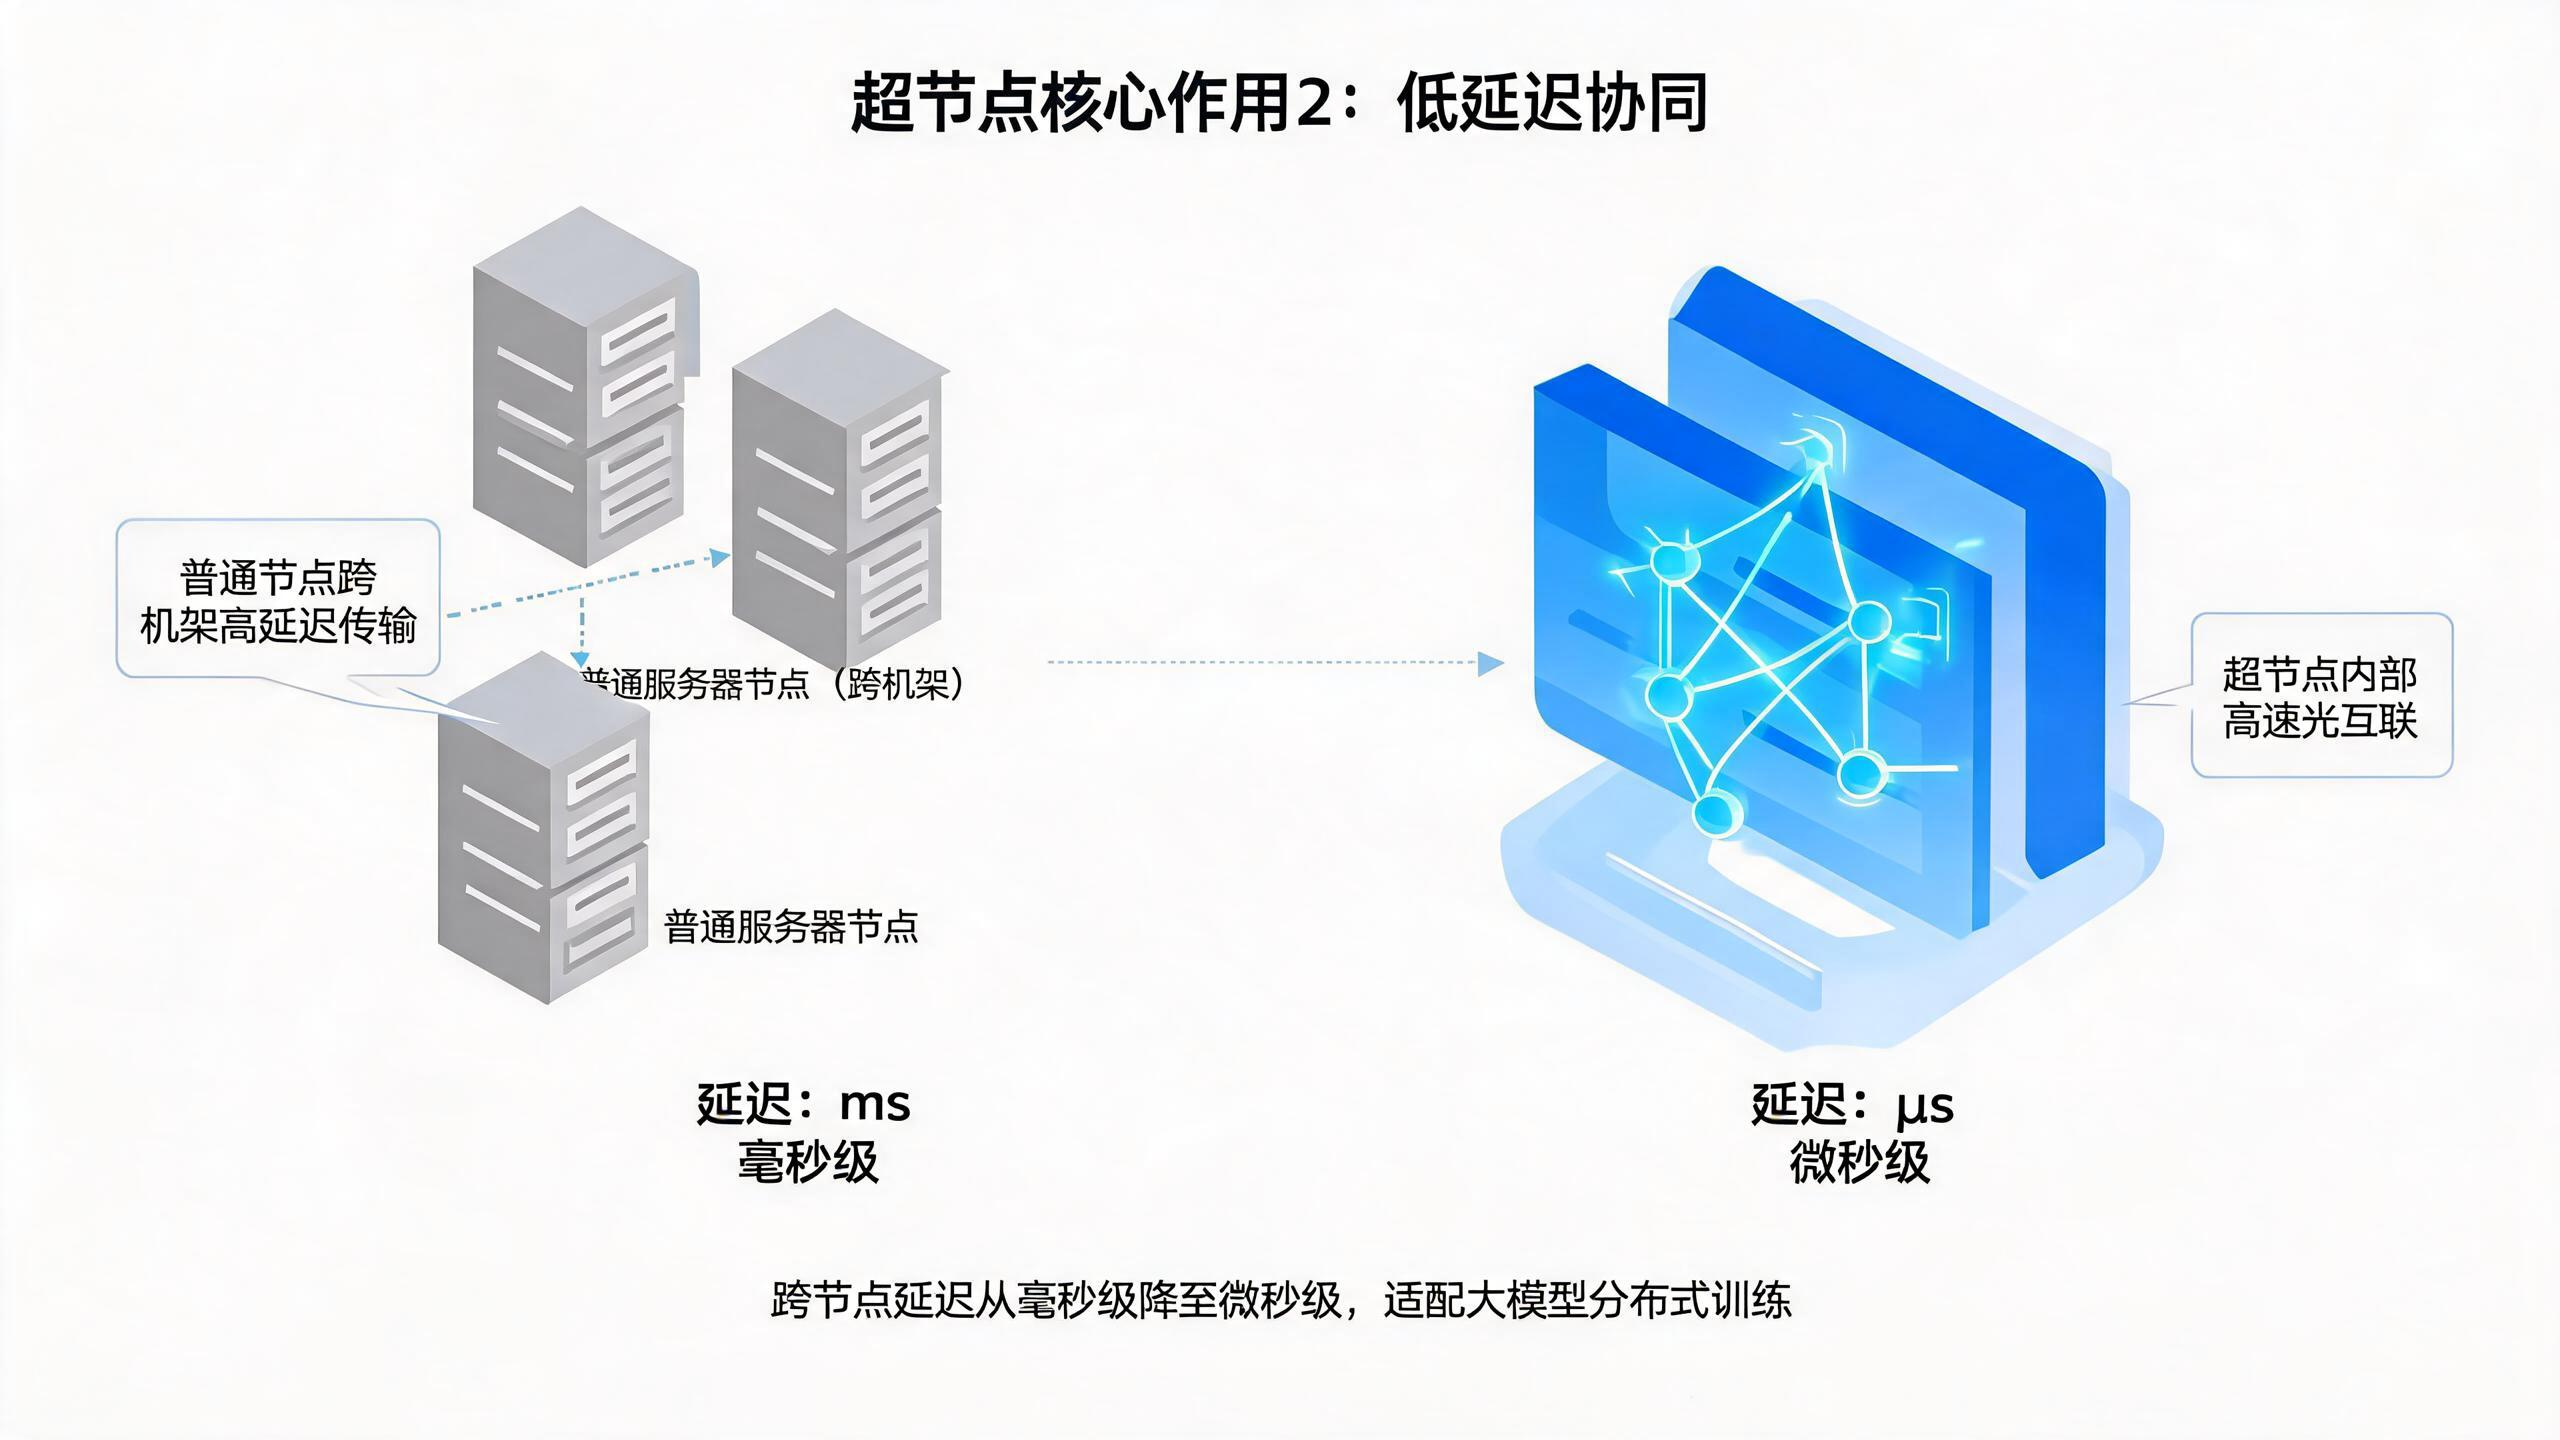
大模型训练通常需要将任务拆分到大量GPU上运行。超节点通过高带宽、低时延互联,可以减少GPU之间的数据等待时间,提高分布式训练效率。
突破单机算力与显存限制
单台服务器的显存和计算能力有限。超节点能够将多台设备的GPU和显存资源协同起来,为大模型、多模态模型和长上下文训练提供更大的计算空间。
提高有效算力利用率
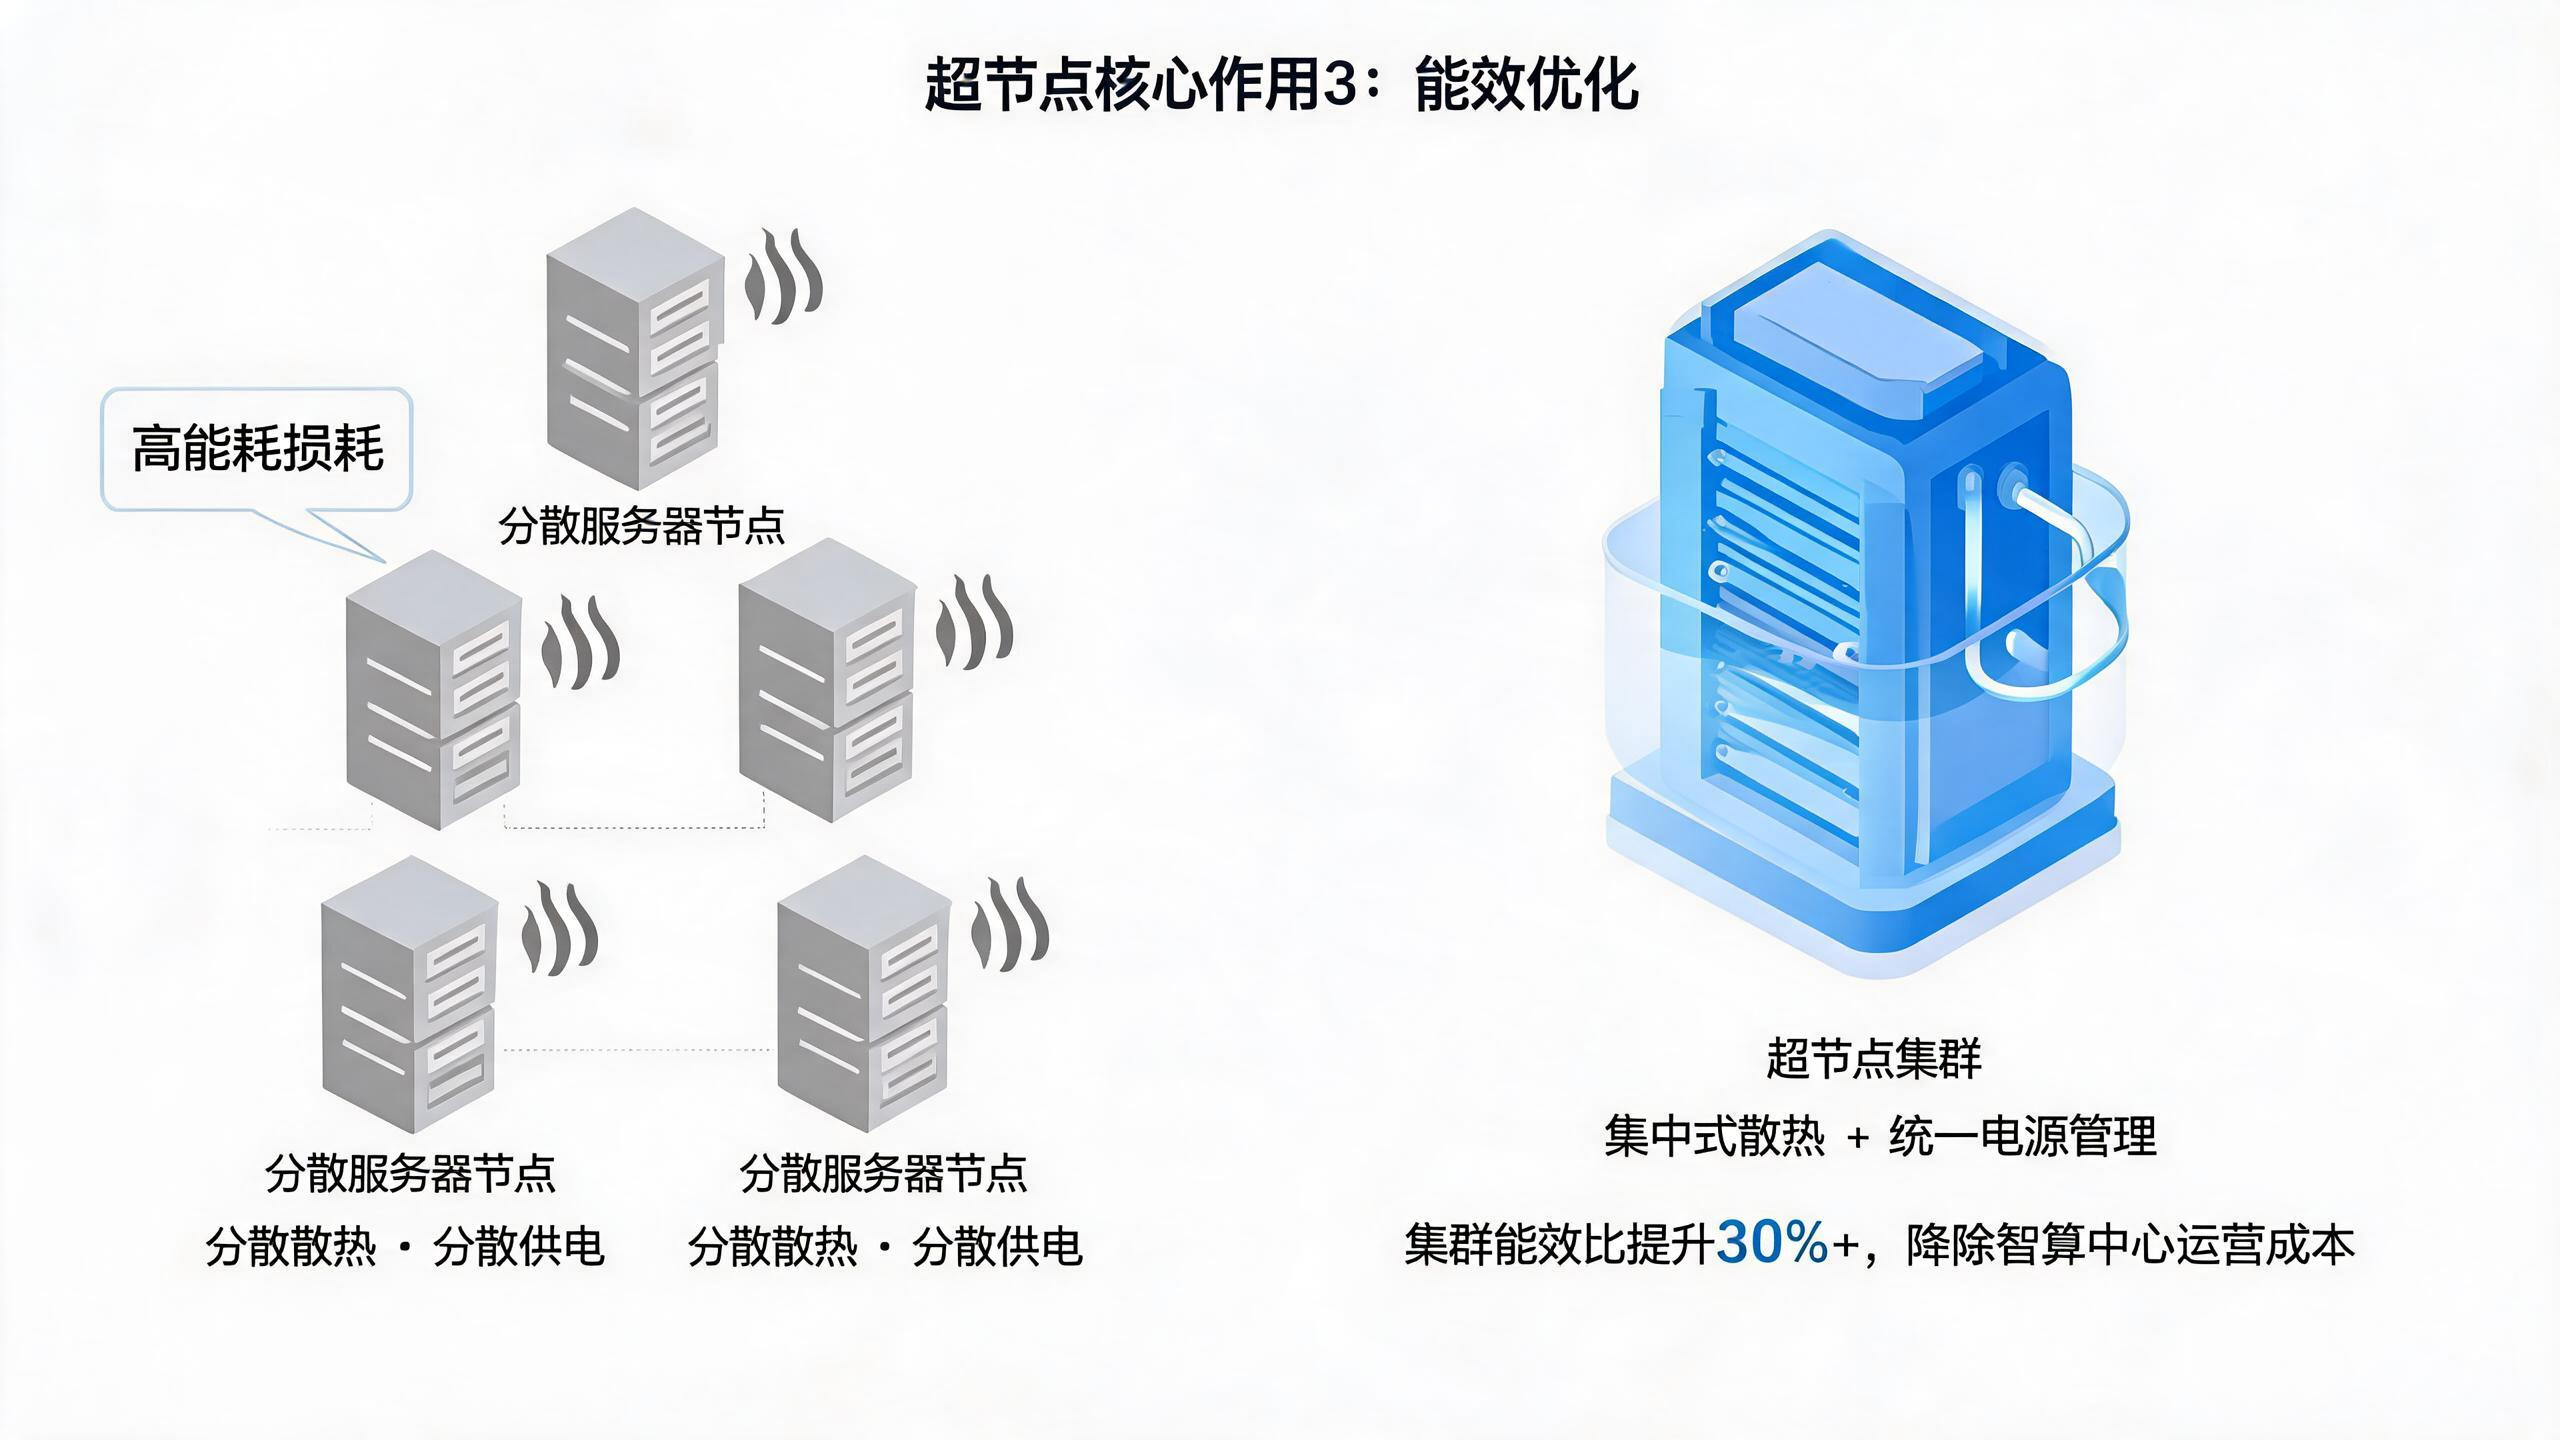
智算中心不能只看设备数量,还要看设备是否真正参与计算。超节点通过统一调度和资源管理,可以减少算力碎片和GPU空转,让更多硬件资源转化为可实际使用的算力。
满足训练与推理需求
当前人工智能应用正在从集中训练向大规模推理延伸。无论是大模型训练、智能体应用,还是多模态推理,都需要更高效的集群协同能力。
提升集群稳定性
大规模集群运行时,设备、网络和存储故障难以完全避免。超节点通常会配套故障监控、任务迁移、断点续训和自动恢复机制,保障长时间计算任务稳定运行。
超节点不是简单"堆GPU"
真正决定智算中心性能的,不只是GPU型号和数量,还包括互联网络、存储速度、调度系统、软件适配和运维能力。
即使两套集群使用相同数量的GPU,如果网络架构和调度能力不同,最终输出的有效算力也可能存在明显差距。
因此,智算中心正在由硬件规模竞争,逐步转向系统效率和算力交付能力竞争。
奇点算力:推动算力资源高效协同
奇点算力围绕GPU算力租赁、算力资源整合、设备托管运营、集群调度和运维服务,为大模型训练、AI推理、AIGC、科研计算及企业研发等场景提供算力支持。
在超节点集群加快发展的背景下,客户需要的不再只是单台服务器或单张GPU,而是一套能够快速部署、稳定运行、灵活扩展的算力环境。
奇点算力将持续关注高速互联、分布式训练、异构算力调度、集群监控和故障恢复等技术方向,推动分散的算力设备转化为标准化、可调度、可交付的算力服务。
未来,衡量智算中心竞争力的关键,不是拥有多少张卡,而是能够稳定输出多少有效算力。超节点集群也将成为智算中心由设备集合迈向高效计算系统的重要基础。