一、Linux
查看文件前十行
查看文件后二十行
统计文件有多少行
bash
head -10 app.log
tail -20 app.log
wc -l app.log
head 查看文件开头,快速预览日志头部
tail 查看文件末尾,排查最新日志报错
wc -l 统计文本行数,数据量统计、校验数据条数常用
二、SQL
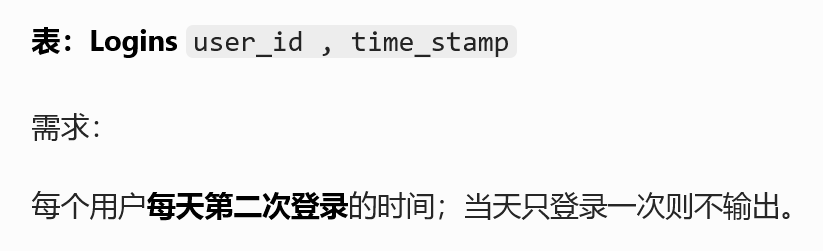
1890. 迟到的最早时刻
sql
SELECT user_id, time_stamp
FROM (
    SELECT
        user_id,
        time_stamp,
        ROW_NUMBER() OVER(PARTITION BY user_id,DATE(time_stamp) ORDER BY time_stamp) AS rn
    FROM Logins
) t
WHERE rn = 2;
窗口函数 ROW_NUMBER 分组内排序
按用户 + 日期双层分区,每日独立排名
取第二名,行为序列、二次到访、复购分析经典模板
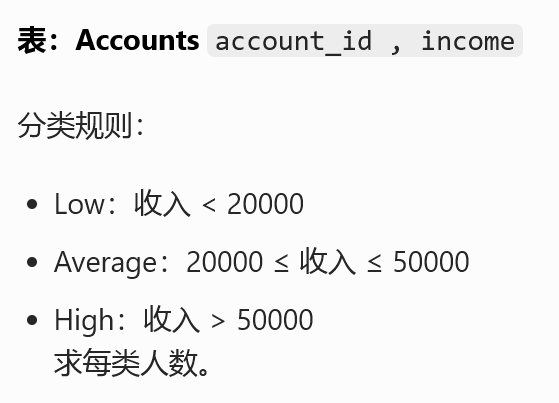
1907. 按分类统计薪水
sql
SELECT
    CASE
        WHEN income < 20000 THEN 'Low Salary'
        WHEN income BETWEEN 20000 AND 50000 THEN 'Average Salary'
        ELSE 'High Salary'
    END AS category,
    COUNT(*) AS accounts_count
FROM Accounts
GROUP BY category;
CASE 区间分层 + GROUP BY 统计各层人数
用户分层、收入分层、价值分层标准写法
数仓画像分层报表高频
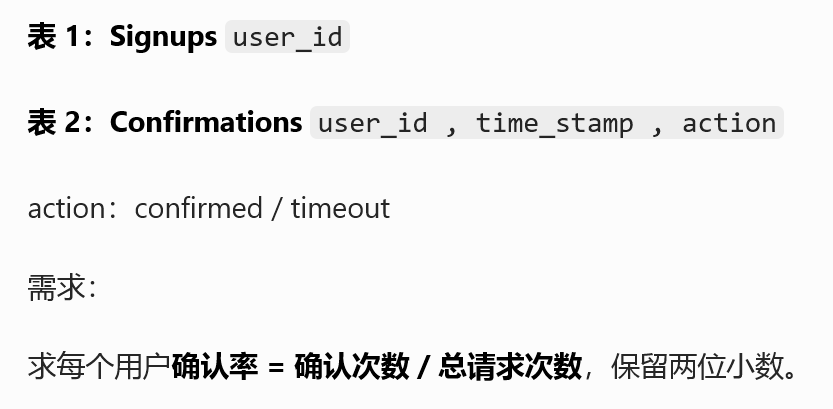
1934. 确认率
sql
SELECT
    s.user_id,
    ROUND(AVG(IF(c.action='confirmed',1,0)),2) AS confirmation_rate
FROM Signups s
LEFT JOIN Confirmations c ON s.user_id = c.user_id
GROUP BY s.user_id;
LEFT JOIN 保留所有注册用户
IF 条件转 0/1,AVG 直接等于比率
转化率、点击率、确认率通用计算公式
三、Pyspark
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, row_number, date_format, avg, round, when
from pyspark.sql.window import Window

spark = SparkSession.builder.master("local[*]").appName("Day33").getOrCreate()

# 1. 每日第二次登录
login = spark.createDataFrame([
    (1, "2025-05-01 08:00:00"),
    (1, "2025-05-01 09:00:00"),
    (1, "2025-05-02 10:00:00")
], ["user_id","time_stamp"])

win = Window.partitionBy("user_id", date_format("time_stamp","yyyy-MM-dd"))\
            .orderBy("time_stamp")

login.withColumn("rn", row_number().over(win))\
     .filter(col("rn") == 2)\
     .select("user_id","time_stamp").show()

# 2. 薪资分层统计
acc = spark.createDataFrame([(1,15000),(2,30000),(3,60000)],["account_id","income"])

acc.withColumn("category",
    when(col("income") < 20000, "Low Salary")
    .when(col("income").between(20000,50000), "Average Salary")
    .otherwise("High Salary")
).groupBy("category").count().show()

spark.stop()
Spark 窗口函数分区排序,和 SQL ROW_NUMBER 逻辑一致
when-otherwise 等价 SQL CASE,做分层标签
转化率用平均值求占比,极简高效写法
四、算法
66. 加一
python
def plusOne(digits):
    for i in range(len(digits)-1, -1, -1):
        if digits[i] < 9:
            digits[i] += 1
            return digits
        digits[i] = 0
    return [1] + digits
从后往前进位模拟
全 9 特殊情况前面补 1
数组模拟大数运算基础题