linux------进程控制
本节重点:
• 学习进程创建,fork/vfork
• 学习到进程终⽌,认识$?
• 学习到进程等待
• 学习到进程程序替换
• 微型shell,重新认识shell运⾏原理
1.进程创建
1.1 fork函数初识
在 linux 中 fork 函数是⾮常重要的函数,它从已存在进程中创建⼀个新进程。新进程为⼦进程, ⽽原进程为⽗进程。
#include <unistd.h>
pid_t fork(void);返回值说明:
子进程中返回0,父进程返回子进程id,出错返回-1
问题列表:
-
为啥
fork函数要给子进程返回 0,给父进程返回子进程的 ID 呢? -
为啥同一个
fork函数,能返回两个不同的值啊? -
为啥同一个 ID,既能等于 0,又能大于 0 呢?
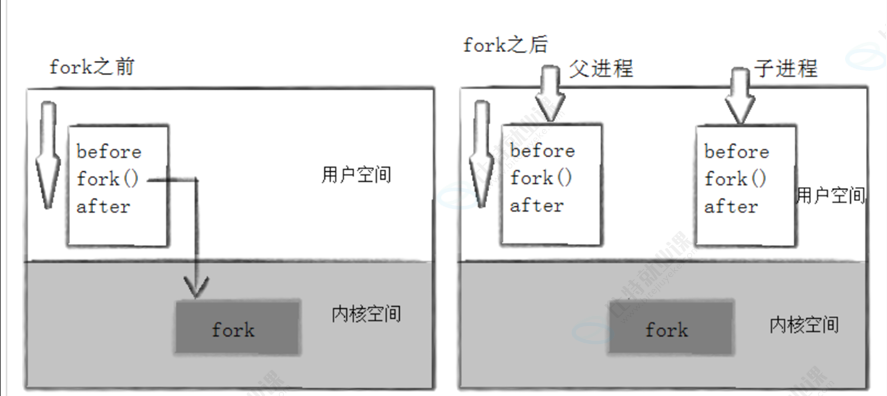
进程调⽤ fork ,当控制转移到内核中的 fork 代码后,内核做:
• 分配新的内存块和内核数据结构给⼦进程
• 将⽗进程部分数据结构内容拷⻉⾄⼦进程
• 添加⼦进程到系统进程列表当中
• fork 返回,开始调度器调度
当⼀个进程调⽤fork之后,就有两个⼆进制代码相同的进程。⽽且它们都运⾏到相同的地⽅。但每个进 程都将可以开始它们⾃⼰的旅程,看如下程序。
int main( void )
{
    pid_t pid;

    printf("Before: pid is %d\n", getpid());
    if ((pid=fork()) == -1) perror("fork()"), exit(1);
    printf("After:pid is %d, fork return %d\n", getpid(), pid);
    sleep(1);
    return 0;
}
运行结果:
[root@localhost linux]# ./a.out
Before: pid is 43676
After:pid is 43676, fork return 43677
After:pid is 43677, fork return 0
这⾥看到了三⾏输出,⼀⾏before,两⾏after。进程43676先打印before消息,然后它有打印after。 另⼀个after消息是43677打印的。注意到进程43677没有打印before,为什么呢?如下图所⽰
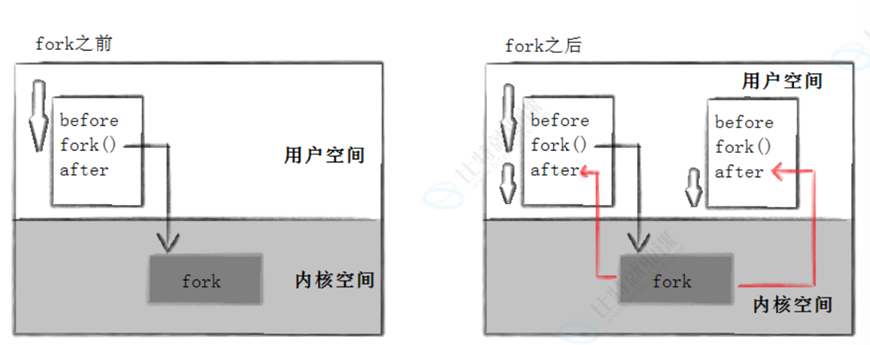
所以,fork之前⽗进程独⽴执⾏,fork之后,⽗⼦两个执⾏流分别执⾏。注意,fork之后,谁先执⾏完 全由调度器决定
1.2 fork函数返回值
• ⼦进程返回0
• ⽗进程返回的是⼦进程的pid。
1.3 写时拷贝
通常,⽗⼦代码共享,⽗⼦再不写⼊时,数据也是共享的,当任意⼀⽅试图写⼊,便以写时拷⻉的⽅ 式各⾃⼀份副本。具体⻅下图:
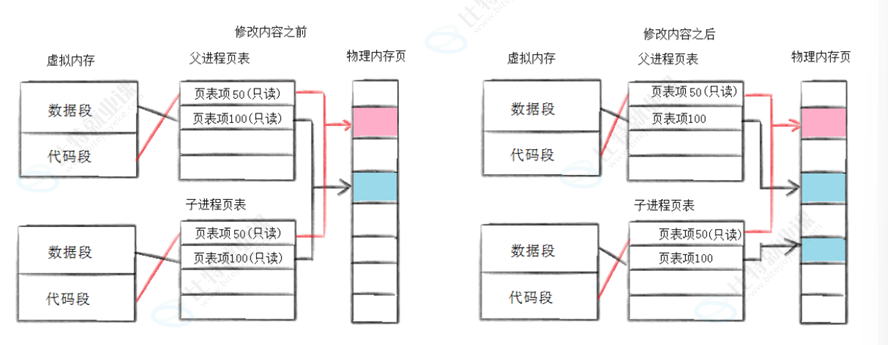
因为有写时拷⻉技术的存在,所以⽗⼦进程得以彻底分离离!完成了进程独⽴性的技术保证!
写时拷⻉,是⼀种延时申请技术,可以提⾼整机内存的使⽤率。
因为上一节已经详细地讲解过了写时拷贝,这里就不再赘述了。
1.4 fork常规用法
(1) ⼀个⽗进程希望复制⾃⼰,使⽗⼦进程同时执⾏不同的代码段。
底层本质: 利用上一节课讲的**写时拷贝(COW)*和*文件描述符表的复制,实现主控与业务的「物理隔离」。如果处理业务的子进程因为收到恶意数据引发段错误(被 OS 击毙),父进程依然存活,继续监听新请求。整个系统不会崩溃。
例如,⽗进程等待客⼾端请求, ⽣成⼦进程来处理请求。
网络请求分发模型:
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/wait.h>
#include <signal.h>

// 模拟的高并发服务器主循环
int main() {
    // 【导师硬核防线】忽略子进程退出信号,防止产生"僵尸进程"(Zombie Process)
    // 很多新手写多进程服务器会把内存撑爆,就是因为没处理这个。
    signal(SIGCHLD, SIG_IGN);

    printf("主服务进程(Master)启动,PID: %d\n", getpid());

    while (1) {
        printf("\n[Master %d] 正在监听端口,等待新的网络请求...\n", getpid());
        sleep(2); // 模拟阻塞在 accept() 等待客户端接入

        printf("[Master %d] 收到新请求!准备派生 Worker...\n", getpid());

        // 核心:拔下毫毛,变出分身
        pid_t id = fork();

        if (id < 0) {
            perror("fork 失败,系统资源可能耗尽");
            continue; // 工业级代码不能直接 return,要继续接客
        }
        else if (id == 0) {
            // ==========================================
            // 【子进程(Worker)的专属结界】
            // 此时触发写时拷贝,子进程有了自己独立的运行栈
            // ==========================================
            printf("  -> [Worker %d] 我是子进程,我接管了该请求的数据(COW机制)。\n", getpid());

            // 模拟极其复杂的业务处理(如:查询数据库、计算、返回报文)
            printf("  -> [Worker %d] 正在进行高强度计算与响应...\n", getpid());
            sleep(3);

            printf("  -> [Worker %d] 请求处理完毕,我将销毁自己释放资源。\n", getpid());

            // 【致命易错点】处理完请求后,子进程必须主动自杀!
            // 否则它会跑出这个 if 块,进入外层的 while(1) 去监听端口,导致群魔乱舞。
            exit(0);
        }
        else {
            // ==========================================
            // 【父进程(Master)的专属结界】
            // id 是刚刚创建出来的子进程的 PID
            // ==========================================
            printf("[Master %d] 已将请求甩锅给 Worker[%d],我继续去监听下一个请求。\n", getpid(), id);
            // 父进程绝对不参与具体的业务计算,立刻进入下一次 while 循环
        }
    }
    return 0;
}
因为Linux 系统规定 → 父进程忽略子进程退出信号 signal(SIGCHLD, SIG_IGN) 是提示 系统自动收尸,防僵尸。
exit(0); 是为了结束子进程,防止污染监听窗口
(2) ⼀个进程要执⾏⼀个不同的程序。例如⼦进程从fork返回后,调⽤exec函数。
底层本质: 为什么 Linux 启动一个新程序(比如你在终端输入 ls -l)非要分两步?为什么不直接搞一个 create_process("ls")? 这就是计算世界的解耦哲学。
fork 只负责「复制外壳(资源、环境变量、文件描述符)」,而 exec 只负责「替换灵魂(代码段、数据段)」。这使得我们在运行新程序前,有了介入的绝佳时机(比如重定向标准输出到文件)。
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/wait.h>

int main() {
    printf("我是父进程(比如 Bash Shell),PID: %d\n", getpid());
    printf("用户输入了指令:想要运行系统自带的 'ls -l' 程序\n");

    pid_t id = fork();

    if (id < 0) {
        perror("fork 失败");
        return 1;
    }
    else if (id == 0) {
        // ==========================================
        // 子进程逻辑:准备"夺舍"
        // ==========================================
        printf("[子进程 %d] 准备调用 exec 替换我自己...\n", getpid());

        // execvp 是 exec 家族的一员。
        // 第一个参数 "ls" 是要执行的程序名(会在系统环境变量 PATH 里找)
        // 第二个参数 argv 是传给 ls 的命令行参数数组(必须以 NULL 结尾)
        char *const argv[] = {"ls", "-l", "--color=auto", NULL};

        // 【灵魂替换发生在此刻】
        execvp("ls", argv);

        // 【导师提问】:如果 exec 成功了,下面这行代码会执行吗?
        // 答案是:绝对不会!因为当前子进程的整个 4GB 虚拟内存空间(代码区、堆、栈)
        // 都被操作系统一把火烧了,替换成了 `ls` 程序的代码。
        // 只有当 exec 调用失败(比如找不到程序)时,才会执行到这里。
        perror("exec 失败了!老子的灵魂没换成!");
        exit(1);
    }
    else {
        // ==========================================
        // 父进程逻辑:等待儿子执行完毕
        // ==========================================
        int status;
        // 父进程阻塞在这里,耐心等待被夺舍的子进程(ls程序)运行结束
        waitpid(id, &status, 0);

        if (WIFEXITED(status)) {
            printf("[父进程 %d] 子进程(ls)正常执行完毕,退出码: %d\n", getpid(), WEXITSTATUS(status));
        }
    }

    return 0;
}
·导师核心视角:结合你上节课学的 mm_struct(虚拟空间)看 exec
很多初学者觉得 exec 是启动了一个新进程。错!大错特错!
结合上节课的"大富翁"与"38线"理论: 当子进程调用 exec 的瞬间,操作系统内核(大富翁)冲进子进程的房间,把子进程桌子上原来拷贝父进程的遗产清单(代码区、数据区的 38 线配置)全部撕毁 。 然后,大富翁从硬盘上拿来 ls 程序的执行文件,照着 ls 的要求,重新画了一张新的遗产清单(新的 mm_struct),并把底层物理内存清空重写。
最惊悚的是:进程的 PID 没有变! 在操作系统的眼里,这个进程还是它,但是脑子(代码和数据)已经完全变成了另外一个人的。
为了让你看清这种"保留肉身,替换灵魂"的底层魔法,我专门做了一个 fork + exec 的内存替换沙盘,你可以亲自点击执行,观察 mm_struct 的区域是如何被瞬间洗脑的。
1.5 fork 调用失败的原因
• 系统中有太多的进程
• 实际⽤⼾的进程数超过了限
一、 系统中有太多的进程 (全局天花板)
1. 本质逻辑:全局资源的绝对枯竭 当这个报错出现时,说明操作系统的"家底"已经被彻底掏空了。这通常涉及两个层面的枯竭:
- 逻辑枯竭(PID 耗尽): 我们前面讲过,每个进程都需要一个身份证号(PID)。在 Linux 内核中,PID 并不是无限的,它受到内核参数
pid_max的限制(早期默认只有 32768)。如果系统里存活的进程数达到了这个值,内核的 PID 分配表就满了,哪怕你的内存还有 100GB,fork()也会因为"摇不到号"而直接失败。 - 物理枯竭(内核内存耗尽): 还记得我们上节课看的
task_struct和mm_struct吗?即使fork运用了写时拷贝(COW)不复制物理数据,但内核依然必须为新进程在物理内存中真实地开辟这几个核心的结构体空间 (大约几 KB 到几十 KB)。如果服务器的物理内存已经被压榨到了极限,连这几 KB 的内核结构体都分不出来了,fork()就会直接暴毙。
2. 严类比:火车站的春运 操作系统就是一个火车站。火车站不仅有"最大容纳人数"(物理内存空间),还有"每日最多能打印的火车票数量"(逻辑 PID 上限)。春运高峰期,只要这两个指标哪怕其中一个爆表,哪怕你是天王老子,售票大厅(内核)也会拉下卷帘门,拒绝放任何一个新乘客(新进程)进来。
二、 实际用户的进程数超过了限制 (爆炸半径隔离)
1. 本质逻辑:防止"单点故障"拖垮全局的保险丝 为什么操作系统要在"系统总上限"之外,还要单独搞一个"用户层面的限制"? 因为这是一个多租户安全(Multi-tenant Security)问题。
假设一台拥有 32768 个 PID 容量的 Linux 服务器上,运行着重要的数据核心服务(Root 权限),同时你也用你的普通账号登录了这台机器做实验。 如果你写了一段极其糟糕的代码------比如大名鼎鼎的 Fork 炸弹 (Fork Bomb):
#include <unistd.h>
int main() {
    while(1) {
        fork(); // 无限进行细胞分裂
    }
}
如果没有用户限制: 这段不到 5 行的代码,会在零点几秒内疯狂分裂,瞬间把系统仅存的几万个 PID 全部吃光。此时,不仅你的程序崩溃了,操作系统的网络组件、系统的 SSH 远程登录模块全都会因为无法 fork 新进程而彻底瘫痪。 连系统管理员(Root)想登录服务器敲一句 kill 命令都做不到(因为 kill 命令本身也需要 fork 才能运行!),唯一的解法只有硬拔服务器电源。
有了用户限制 (ulimit -u): 操作系统(大富翁)会给每一个普通用户设定一个配额 (比如最多只能创建 1024 个进程)。 当你的 Fork 炸弹跑到第 1024 个进程时,操作系统会冷酷地直接返回 fork 失败。 你的炸弹哑火了,但这台服务器上其他的 31000 多个 PID 依然完好无损,Root 管理员依然可以从容地 SSH 登录进来,顺手把你的进程杀掉,并对你提出严厉的口头警告。
2. 严类比:银行的防挤兑机制
- 系统极限: 银行总金库里只有 10 个亿(全局 PID 上限)。
- 用户限制: 为了防止某个疯狂的富豪(Fork 炸弹)一次性把 10 个亿全部取空,导致其他排队的老百姓取不到钱而发生暴乱,银行强行规定:每个储户每天最多只能取 100 万(用户进程限额)。 这样就把灾难的"爆炸半径"死死地锁在了单个用户的范围内。
2. 进程终止
进程终⽌的本质是释放系统资源,就是释放进程申请的相关内核数据结构和对应的数据和代码。
2.1 进程退出场景
• 代码运⾏完毕,结果正确
• 代码运⾏完毕,结果不正确
• 代码异常终⽌
2.2 进程常见退出方法
(1)正常终⽌(可以通过 echo $? 查看进程退出码):
- 从main返回
- 调用exit
- exit
(2)异常退出:
ctrl+c ,信号终⽌
2.2.1 退出码
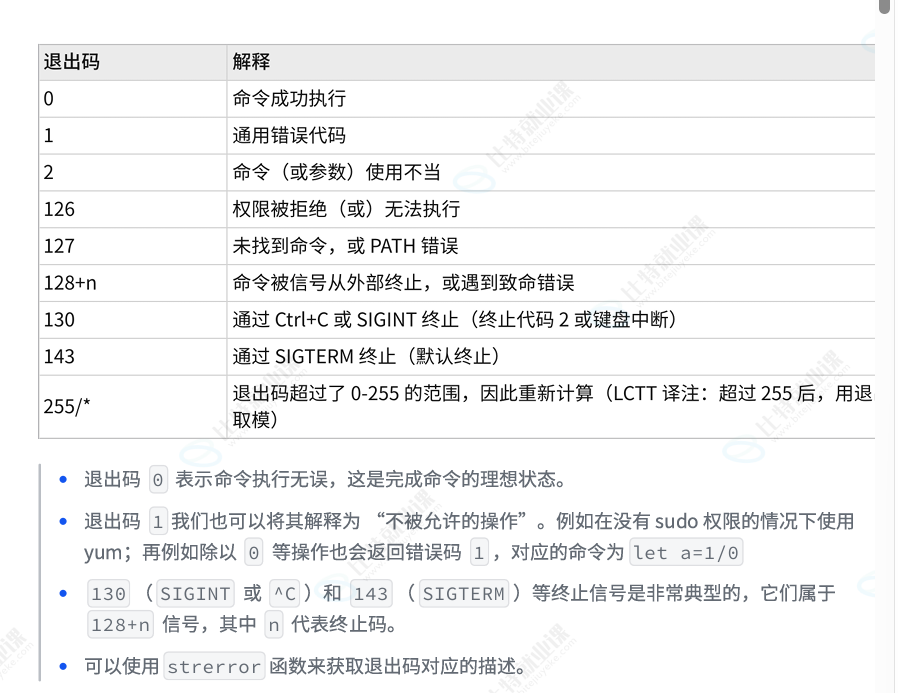
退出码(退出状态)可以告诉我们最后⼀次执⾏的命令的状态。在命令结束以后,我们可以知道命令 是成功完成的还是以错误结束的。其基本思想是,程序返回退出代码 0 时表⽰执⾏成功,没有问题。 代码 1 或 0 以外的任何代码都被视为不成功。
Linux Shell 中的主要退出码:
2.2.2 _exit函数
#include <unistd.h>
void _exit(int status);
参数:status 定义了进程的终⽌状态,⽗进程通过wait
来获取该值
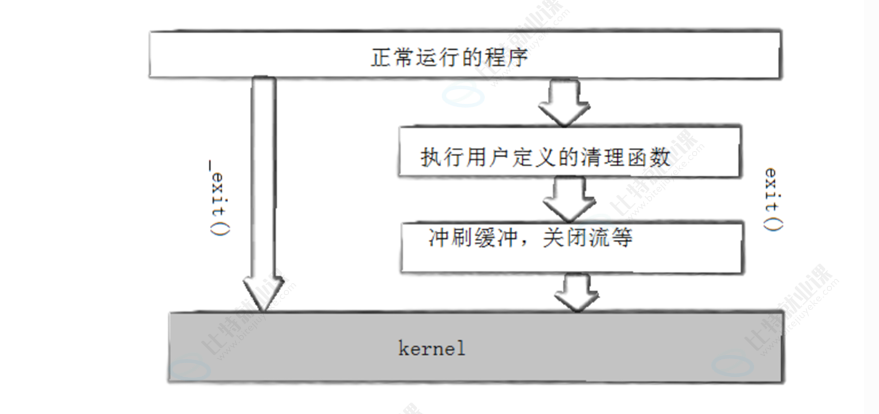
说明:虽然status是int,但是仅有低8位可以被⽗进程所⽤。所以_exit(-1)时,在终端执⾏$?发现 返回值是255。
2.2.3 exit函数
#include <unistd.h>
void exit(int status)
exit最后也会调⽤_exit,但在调⽤_exit之前,还做了其他⼯作:
- 执⾏⽤⼾通过atexit或on_exit定义的清理函数。
- 关闭所有打开的流,所有的缓存数据均被写⼊
- 调⽤_exit
实例:
int main()
{
printf("hello");
exit(0);
}
运⾏结果:
[root@localhost linux]# ./a.out
hello[root@localhost linux]#
int main()
{
printf("hello");
_exit(0);
}
运⾏结果:
[root@localhost linux]# ./a.out
[root@localhost linux]#
2.2.4 return 退出
return是⼀种更常⻅的退出进程⽅法。执⾏returnn等同于执⾏exit(n),因为调⽤main的运⾏时函数会 将main的返回值当做exit的参数。
3. 进程等待
3.1 进程等待的必要性
- 之前讲过,⼦进程退出,⽗进程如果不管不顾,就可能造成'僵⼫进程'的问题,进⽽造成内存 泄漏。
- 另外,进程⼀旦变成僵⼫状态,那就⼑枪不⼊,"杀⼈不眨眼"的kill-9也⽆能为⼒,因为谁也 没有办法杀死⼀个已经死去的进程。
- 最后,⽗进程派给⼦进程的任务完成的如何,我们需要知道。如,⼦进程运⾏完成,结果对还是 不对,或者是否正常退出。
- ⽗进程通过进程等待的⽅式,回收⼦进程资源,获取⼦进程退出信息
3.2 进程等待的方法
3.2.1 wait方法
#include<sys/types.h>
#include<sys/wait.h>
pid_t wait(int* status);
返回值:
成功返回被等待进程 pid ,失败返回-1 。
参数:
输出型参数,获取⼦进程退出状态 , 不关⼼则可以设置成为 NULL
3.2.2 waitpid 方法
pid_ t waitpid(pid_t pid, int *status, int options);返回值:
当正常返回的时候 waitpid 返回收集到的子进程的进程 ID;
如果设置了选项 WNOHANG,而调用中 waitpid 发现没有已退出的子进程可收集,则返回 0;
如果调用中出错,则返回 -1,这时 errno 会被设置成相应的值以指示错误所在;
参数:
pid:
pid=-1:等待任一个子进程。与wait等效。pid>0:等待其进程 ID 与pid相等的子进程。
status:输出型参数
WIFEXITED(status):若为正常终止子进程返回的状态,则为真。(查看进程是否是正常退出)WEXITSTATUS(status):若WIFEXITED非零,提取子进程退出码。(查看进程的退出码)options:默认为0,表示阻塞等待
WNOHANG:若 pid 指定的子进程没有结束,则 waitpid() --函数返回 0,不予以等待。若正常结束,则返回该子进程的 ID。
注意:
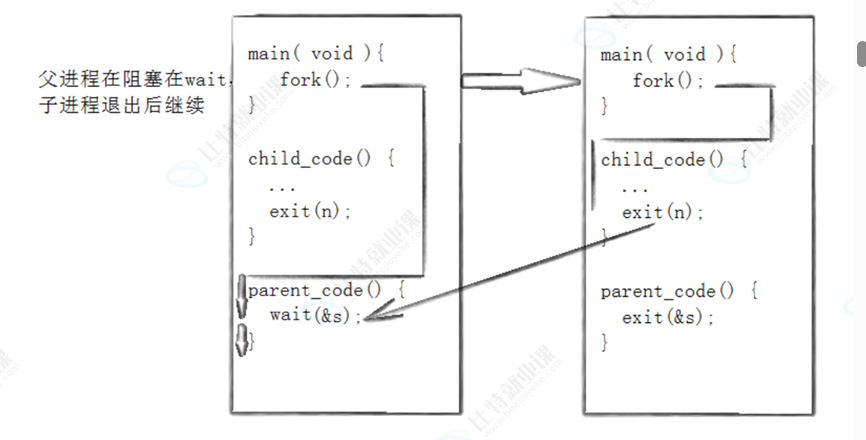
- 如果⼦进程已经退出,调⽤
wait/waitpid时,wait/waitpid会⽴即返回,并且释放资源,获得⼦ 进程退出信息。 - 如果在任意时刻调⽤
wait/waitpid,⼦进程存在且正常运⾏,则进程可能阻塞。 - 如果不存在该⼦进程,则⽴即出错返回。
3.2.3 获取子进程status
小结:
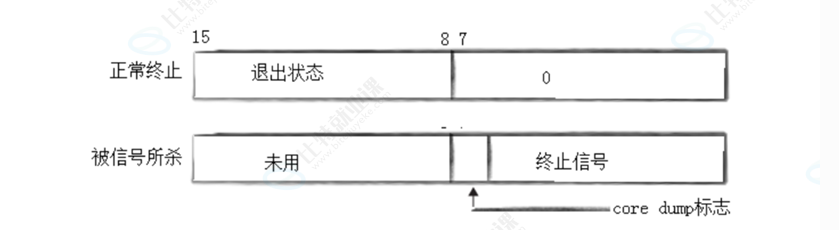
wait和waitpid,都有⼀个status参数,该参数是⼀个输出型参数,由操作系统填充。- 如果传递NULL,表⽰不关⼼⼦进程的退出状态信息
- 否则,操作系统会根据该参数,将⼦进程的退出信息反馈给⽗进程
- status不能简单的当作整形来看待,可以当作位图来看待,具体细节如下图(只研究status低16 ⽐特位):
测试代码:
#include <sys/wait.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <errno.h>

int main( void )
{
    pid_t pid;

    if ( (pid=fork()) == -1 )
        perror("fork"),exit(1);

    if ( pid == 0 ){
        sleep(20);
        exit(10);
    } else {
        int st;
        int ret = wait(&st);

        if ( ret > 0 && ( st & 0X7F ) == 0 ){ // 正常退出
            printf("child exit code:%d\n", (st>>8)&0XFF);
        } else if( ret > 0 ) { // 异常退出
            printf("sig code : %d\n", st&0X7F);
        }
    }
}

测试结果:
# ./a.out
#等20秒退出
child exit code:10

# ./a.out
#在其他终端kill掉
sig code : 9
3.2.4 阻塞与⾮阻塞等待
(1) 进程的阻塞等待⽅式
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>   // fork(), getpid(), sleep(), exit()
#include <sys/wait.h> // waitpid(), WIFEXITED(), WEXITSTATUS()

int main()
{
    pid_t pid;
    // 1. 创建子进程
    pid = fork();

    // 分支1:fork失败(系统资源不足/进程数达上限)
    if (pid < 0) {
        printf("%s fork error\n", __FUNCTION__);
        return 1;
    }
    // 分支2:子进程执行逻辑(pid == 0)
    else if (pid == 0) {
        printf("child is run, pid is : %d\n", getpid());
        sleep(5);       // 模拟业务处理,让子进程暂停5秒
        exit(257);      // 子进程退出码(注意:Linux退出码仅低8位有效,257会被截断为1)
    }
    // 分支3:父进程执行逻辑(pid > 0,pid为子进程的PID)
    else {
        int status = 0;
        // 2. 阻塞式等待任意子进程退出(pid=-1表示等待所有子进程,options=0表示阻塞等待)
        pid_t ret = waitpid(-1, &status, 0);
        printf("this is test for wait\n");

        // 3. 判断子进程是否正常退出
        // WIFEXITED(status):若为真,表示子进程通过exit/_exit正常退出,而非被信号杀死
        if (WIFEXITED(status) && ret == pid) {
            // WEXITSTATUS(status):提取子进程的退出码(仅低8位有效)
            printf("wait child 5s success, child return code is :%d.\n", WEXITSTATUS(status));
        } else {
            printf("wait child failed, return.\n");
            return 1;
        }
    }

    return 0;
}

运⾏结果:
[root@localhost linux]# ./a.out
child is run, pid is : 45110
this is test for wait
wait child 5s success, child return code is :1
exit(257) 的隐藏细节
Linux 中进程退出码仅低 8 位有效(范围0-255),257的二进制是100000001,低 8 位为00000001,所以最终退出码会被截断为1,WEXITSTATUS(status)会输出1。
waitpid(-1, &status, 0) 的含义
pid=-1:表示等待任意一个 子进程退出,与wait(&status)等价。options=0:表示阻塞等待,父进程会暂停执行,直到有子进程退出。
WIFEXITED 与 WEXITSTATUS 的配合使用
WIFEXITED(status):用于判断子进程是否正常退出 (调用exit/_exit或从main函数return)。WEXITSTATUS(status):仅当WIFEXITED为真时有效,用于提取子进程的退出码(低 8 位)。
(2) 进程的⾮阻塞等待⽅式:
// 标准C语言输入输出头文件
#include <stdio.h>
// 标准库:exit、内存分配等
#include <stdlib.h>
// 进程等待:waitpid
#include <sys/wait.h>
// 进程操作:fork、getpid、sleep
#include <unistd.h>
// C++容器:用于存储函数指针
#include <vector>

// 1. 定义函数指针类型:指向无参、无返回值的函数
typedef void (*handler_t)();

// 2. 全局函数指针数组:存储需要执行的任务函数
std::vector<handler_t> handlers;

// 任务1:自定义业务函数
void fun_one() {
    printf("这是⼀个临时任务1\n");
}

// 任务2:自定义业务函数
void fun_two() {
    printf("这是⼀个临时任务2\n");
}

// 加载任务:将自定义函数添加到任务数组中
void Load() {
    handlers.push_back(fun_one);
    handlers.push_back(fun_two);
}

// 任务调度器:执行所有注册的任务
void handler() {
    // 如果任务列表为空,先加载任务
    if (handlers.empty())
        Load();
    // 遍历任务列表,依次执行所有函数
    for (auto iter : handlers)
        iter();
}

int main() {
    pid_t pid;
    // 创建子进程
    pid = fork();

    // ============== fork失败分支 ==============
    if (pid < 0) {
        printf("%s fork error\n", __FUNCTION__);
        return 1;
    }
    // ============== 子进程分支 ==============
    else if (pid == 0) {
        printf("child is run, pid is : %d\n", getpid());
        sleep(5);       // 模拟子进程执行业务逻辑,休眠5秒
        exit(1);        // 子进程正常退出,退出码为1
    }
    // ============== 父进程分支 ==============
    else {
        int status = 0;  // 存储子进程退出状态
        pid_t ret = 0;  // 存储waitpid的返回值

        // 循环:非阻塞等待子进程退出
        do {
            // WNOHANG:非阻塞模式
            // -1:等待任意子进程;&status:接收退出状态
            ret = waitpid(-1, &status, WNOHANG);

            // 返回值=0:子进程还在运行,未退出
            if (ret == 0) {
                printf("child is running\n");
            }
            // 子进程运行期间,父进程执行自己的任务
            handler();

        // 只要子进程没退出,就一直循环
        } while (ret == 0);

        // 子进程已退出,判断是否正常退出
        if (WIFEXITED(status) && ret == pid) {
            // 打印子进程的退出码
            printf("wait child 5s success, child return code is :%d.\n",
                   WEXITSTATUS(status));
        } else {
            printf("wait child failed, return.\n");
            return 1;
        }
    }
    return 0;
}
核心注意事项(必看)
1. waitpid 非阻塞等待的核心逻辑
WNOHANG:非阻塞模式,父进程不会卡住等待子进程,而是立刻返回;- 返回值
ret=0:子进程正在运行,未退出; - 返回值
ret>0:子进程已退出,返回值是子进程 PID; - 父进程利用等待的空闲时间执行自定义任务,这是高并发服务器的常用设计。
2. 父子进程的内存隔离(写时拷贝)
vector<handler_t>是全局变量,fork 后父子进程各有一份独立副本;- 子进程不会执行父进程的任务函数,互不干扰。
3. 子进程退出规范
- 子进程必须调用
exit(1)退出,否则会执行父进程的代码逻辑; - 退出码仅支持
0~255,超出会被系统截断。
4. 循环的意义
do-while循环:父进程轮询检测子进程状态,同时持续执行自己的任务;- 直到子进程退出,
waitpid返回 PID,循环结束。
5. 代码兼容说明
- 代码混用了 C 标准库 和 C++ 容器 ,编译时必须用
g++编译,不能用gcc; - 编译命令:
g++ 文件名.cpp -o 程序名。
6. 僵尸进程防护
- 这里用了
waitpid主动回收子进程,不会产生僵尸进程; - 这是除了
signal(SIGCHLD, SIG_IGN)之外,另一种标准的回收方式。
4.进程程序替换
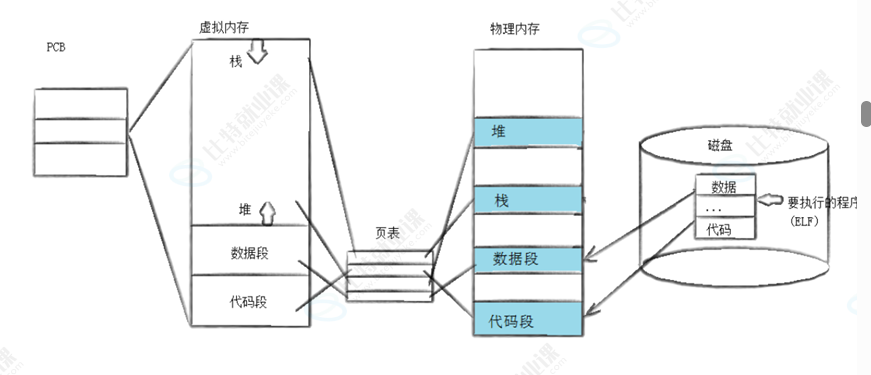
fork() 之后,⽗⼦各⾃执⾏⽗进程代码的⼀部分如果⼦进程就想执⾏⼀个全新的程序呢?进程的程序 替换来完成这个功能!
程序替换是通过特定的接⼝,加载磁盘上的⼀个全新的程序(代码和数据),加载到调⽤进程的地址空间 中!
4.1 替换原理
⽤fork创建⼦进程后执⾏的是和⽗进程相同的程序(但有可能执⾏不同的代码分⽀),⼦进程往往要调⽤⼀种exec函数以执行另外一个程序。当进程调用一种 exec 函数时,该进程的⽤⼾空间代码和数据完全被 新程序替换,从新程序的启动例程开始执⾏。调用 exec 并不创建新进程,所以调⽤ exec 前后该进程调⽤ 的 id 并未改变。
4.2 替换函数
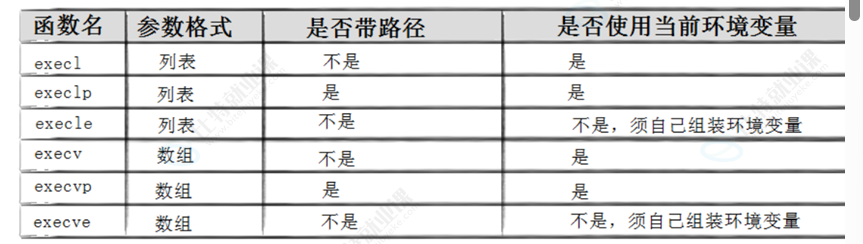
其实有六种以exec开头的函数,统称exec函数:
#include <unistd.h>
int execl(const char *path, const char *arg, ...);
int execlp(const char *file, const char *arg, ...);
int execle(const char *path, const char *arg, ...,char *const envp[]);
int execv(const char *path, char *const argv[]);
int execvp(const char *file, char *const argv[]);
int execve(const char *path, char *const argv[], char *const envp[]);
4.2.1 exec函数解释
- 这些函数如果调⽤成功则加载新的程序从启动代码开始执⾏,不再返回。
- 如果调⽤出错则返回
-1 - 所以
exec函数只有出错的返回值⽽没有成功的返回值。
4.2.2 命名理解
这些函数原型看起来很容易混,但只要掌握了规律就很好记。
l(list):表⽰参数采⽤列表v (vector):参数⽤数组p( path):有p⾃动搜索环境变量PATHe( env):表⽰⾃⼰维护环境变量
exec调用举例如下:
#include <unistd.h>

int main()
{
    char *const argv[] = {"ps", "-ef", NULL};
    char *const envp[] = {"PATH=/bin:/usr/bin", "TERM=console", NULL};

    execl("/bin/ps", "ps", "-ef", NULL);

    // 带p的,可以使用环境变量PATH,无需写全路径
    execlp("ps", "ps", "-ef", NULL);

    // 带e的,需要自己组装环境变量
    execle("ps", "ps", "-ef", NULL, envp);

    execv("/bin/ps", argv);

    // 带p的,可以使用环境变量PATH,无需写全路径
    execvp("ps", argv);

    // 带e的,需要自己组装环境变量
    execve("/bin/ps", argv, envp);

    exit(0);
}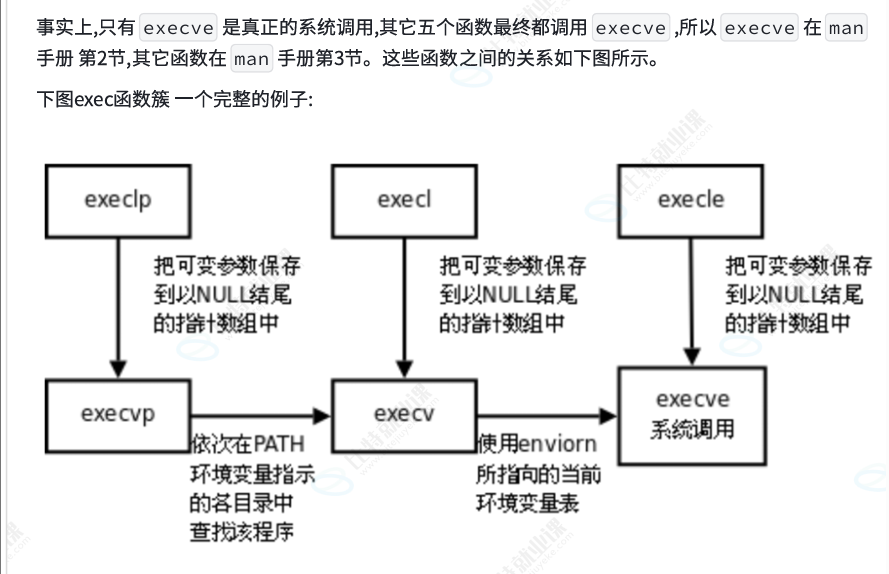
这张图揭示了 exec 函数族最关键的事实:
-
只有
execve是真正的系统调用 ,它的第三个参数就是用来传入自定义环境变量数组的:int execve(const char *filename, char *const argv[], char *const envp[]);
// envp 就是你要传入的自定义环境变量,格式为 "KEY=VALUE" 数组,以 NULL 结尾 -
其他 5 个函数(
execl/execlp/execle/execv/execvp)都是库函数封装 ,最终都会调用execve:- 带
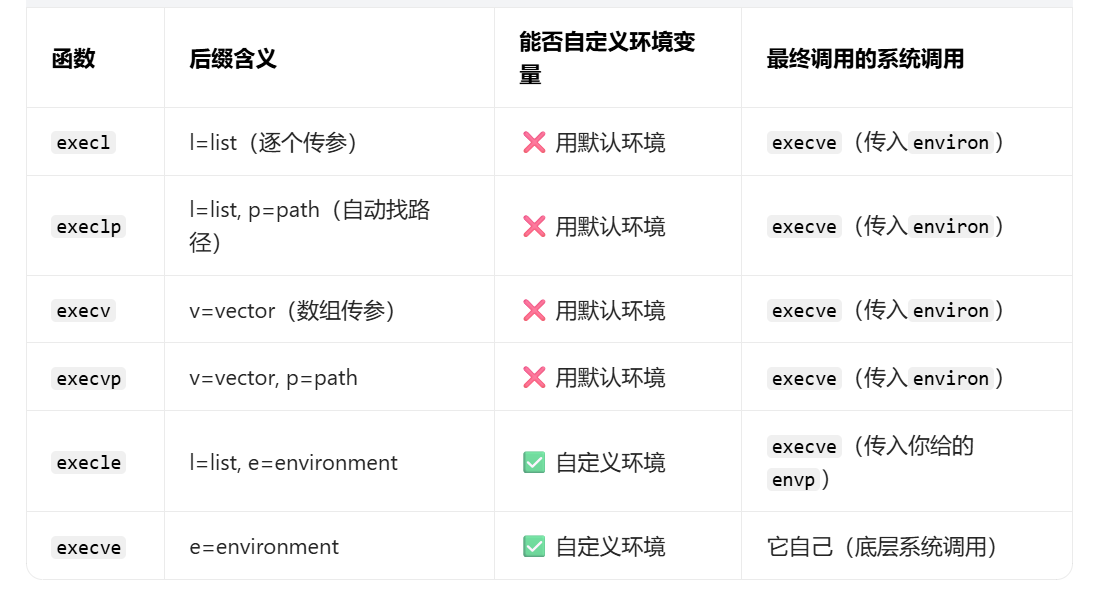
e后缀的execle/execve:允许你自定义环境变量,完全覆盖默认环境; - 不带
e的 4 个函数:只能使用当前进程默认的环境变量(继承父进程的environ全局表)。
- 带
最后,我们再来补充一下environ
environ 是一个全局变量 ,定义在 <unistd.h> 中,类型为 char **(字符串指针数组),存储格式为:
- 每个元素是一个
KEY=VALUE格式的字符串(比如PATH=/usr/bin:/bin、HOME=/home/yourname) - 数组的最后一个元素必须是
NULL,用来标记结束
它的作用是:保存当前进程的所有环境变量,供不带 e 后缀的 exec 函数默认使用
environ关键注意事项(新手必踩坑)
-
environ不是标准 C 库的内容它是 POSIX 标准定义的全局变量,声明在
<unistd.h>中,部分系统可能需要手动声明extern char **environ;才能使用。 -
自定义环境变量是「完全替换」,不是「追加」
用
execle/execve传入自定义envp时,会完全覆盖 新程序的环境变量,原来的PATH/HOME等变量都会消失,所以一定要手动加上PATH=/usr/bin:/bin,否则新程序会找不到命令。 -
子进程会继承父进程的
environfork()创建的子进程会复制父进程的environ,但父子进程的environ是独立的副本,修改子进程的environ不会影响父进程。 -
environ数组必须以NULL结尾不管是系统默认的
environ,还是你自定义的envp数组,最后一个元素必须是NULL,否则execve会因为找不到结束标记而内存越界。
environ和 main 函数 envp 参数的关系
有些教材会写 int main(int argc, char *argv[], char *envp[]),这个 envp 参数其实和 environ 指向的是同一个数组,所以:
- 修改
environ和修改envp的效果完全一样; - 但
envp不是标准 C 的内容,跨平台兼容性差,推荐用environ或setenv/getenv来操作环境变量。
5. ⾃主Shell命令⾏解释器
5.1 目标
- 要能处理普通命令
- 要能处理内建命令
- 要能帮助我们理解内建命令/本地变量/环境变量这些概念
- 要能帮助我们理解shell的允许原理
5.2 实现原理
考虑下⾯这个与shell典型的互动:
[root@localhost epoll]# ls
client.cpp  readme.md  server.cpp  utility.h
[root@localhost epoll]# ps
PID TTY          TIME CMD
3451 pts/0    	00:00:00 bash
3514 pts/0 		00:00:00 ps
⽤下图的时间轴来表⽰事件的发⽣次序。其中时间从左向右。shell由标识为 bash 的⽅块代表,它随着时 间的流逝从左向右移动。shell从⽤⼾读⼊字符串"ls"。shell建⽴⼀个新的进程,然后在那个进程中运 ⾏ls程序并等待那个进程结束。
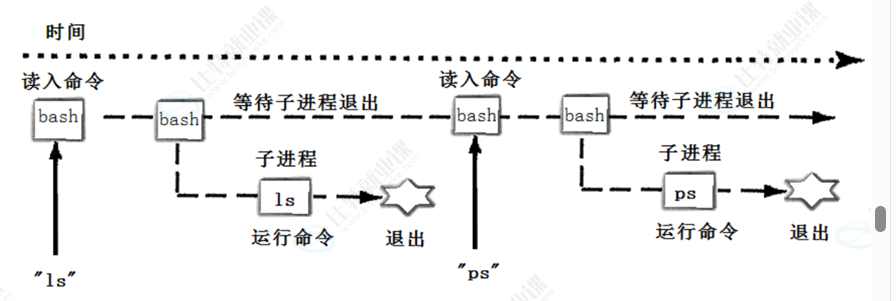
然后shell读取新的⼀⾏输⼊,建⽴⼀个新的进程,在这个进程中运⾏程序并等待这个进程结束。 所以要写⼀个shell,需要循环以下过程:
- 获取命令⾏
- 解析命令⾏
- 建⽴⼀个⼦进程(
fork) - 替换⼦进程(
execvp) - ⽗进程等待⼦进程退出(
wait)
根据这些思路,和我们前⾯的学的技术,就可以⾃⼰来实现⼀个shell了。
5.3源码
实现代码:
// 标准输入输出流头文件,用于cout/cin等基础IO操作
#include <iostream>
// C标准输入输出头文件,用于printf、scanf、fflush等底层IO操作
#include <cstdio>
// C标准库头文件,用于malloc、free、exit等内存/进程操作
#include <cstdlib>
// C字符串处理头文件,用于memset、strlen、strcmp等字符串函数
#include <cstring>
// C++字符串类头文件,提供string类型的便捷操作
#include <string>
// Linux系统头文件,提供unix标准函数,如close、read、write
#include <unistd.h>
// Linux系统头文件,定义进程ID类型(pid_t)
#include <sys/types.h>
// Linux系统头文件,提供进程等待函数(waitpid),用于回收子进程
#include <sys/wait.h>
// C字符处理头文件,用于isspace判断空白字符
#include <ctype.h>

// 使用标准命名空间,避免std::前缀重复书写
using namespace std;

// 宏定义常量:缓冲区基础大小、命令参数最大数量、环境变量最大数量
const int basesize = 1024;   // 命令行缓冲区/路径缓冲区大小
const int argvnum = 64;      // 命令参数数组最大长度
const int envnum = 64;       // 环境变量数组最大长度

// 全局的命令行参数表:存储解析后的命令和参数(如ls -l -> ["ls", "-l", nullptr])
char *gargv[argvnum];
// 全局命令参数个数:记录解析后有效参数的数量
int gargc = 0;

// 全局变量:存储上一条命令的退出码(0成功,非0失败)
int lastcode = 0;

// 全局环境变量表:存储shell的自定义环境变量
char *genv[envnum];

// 全局变量:存储当前shell的工作路径
char pwd[basesize];
// 全局变量:拼接PWD环境变量的缓冲区
char pwdenv[basesize];

// 宏函数:去除字符串开头的所有空白字符(空格、制表符、换行)
// 参数pos:字符串指针,直接修改原指针指向的位置
#define TrimSpace(pos) do{\
    while(isspace(*pos)){\
        pos++;\
    }\
}while(0)

// 功能:获取当前登录的用户名
// 返回值:用户名字符串,获取失败返回"None"
string GetUserName()
{
    // 从系统环境变量中读取USER(存储当前用户名)
    string name = getenv("USER");
    return name.empty() ? "None" : name;
}

// 功能:获取当前主机名
// 返回值:主机名字符串,获取失败返回"None"
string GetHostName()
{
    // 从系统环境变量中读取HOSTNAME(存储当前主机名)
    string hostname = getenv("HOSTNAME");
    return hostname.empty() ? "None" : hostname;
}

// 功能:获取当前shell的工作路径,并更新系统PWD环境变量
// 返回值:当前路径字符串,获取失败返回"None"
string GetPwd()
{
    // getcwd:获取当前工作目录,存入pwd缓冲区
    if(nullptr == getcwd(pwd, sizeof(pwd))) return "None";
    // 拼接字符串:PWD=当前路径
    snprintf(pwdenv, sizeof(pwdenv), "PWD=%s", pwd);
    // putenv:将拼接的PWD写入系统环境变量
    putenv(pwdenv);
    return pwd;

    // 注释掉的备用方案:直接读取系统PWD环境变量
    //string pwd = getenv("PWD");
    //return pwd.empty() ? "None" : pwd;
}

// 功能:获取当前工作路径的**最后一级目录名**(用于简化命令提示符)
// 示例:/home/user/test -> 返回 test
string LastDir()
{
    string curr = GetPwd();
    // 根目录/获取失败时,直接返回原路径
    if(curr == "/" || curr == "None") return curr;
    // 查找最后一个'/'的位置
    size_t pos = curr.rfind("/");
    if(pos == std::string::npos) return curr;
    // 截取最后一个/之后的字符串,即当前目录名
    return curr.substr(pos+1);
}

// 功能:拼接完整的命令提示符字符串
// 格式:[用户名@主机名 当前目录]#
string MakeCommandLine()
{
    char command_line[basesize];
    // 格式化拼接命令提示符
    snprintf(command_line, basesize, "[%s@%s %s]# ",\
        GetUserName().c_str(), GetHostName().c_str(), LastDir().c_str());
    return command_line;
}

// 核心功能1:打印命令行提示符(shell启动后的前缀)
void PrintCommandLine()
{
    printf("%s", MakeCommandLine().c_str());
    // 刷新标准输出缓冲区,确保提示符立即打印到屏幕
    fflush(stdout);
}

// 核心功能2:获取用户输入的命令行字符串
// 参数:command_buffer-存储命令的缓冲区,size-缓冲区大小
// 返回值:true-获取成功,false-获取失败/空输入
bool GetCommandLine(char command_buffer[], int size)
{
    // fgets:从标准输入读取一行命令,存入缓冲区
    char *result = fgets(command_buffer, size, stdin);
    if(!result)
    {
        return false;
    }
    // 去除fgets读取到的末尾换行符,替换为字符串结束符
    command_buffer[strlen(command_buffer)-1] = 0;
    // 处理空输入(用户直接回车)
    if(strlen(command_buffer) == 0) return false;
    return true;
}

// 核心功能3:解析命令行字符串,分割为命令参数数组
// 示例:输入"ls -a -l" -> 解析为gargv = ["ls", "-a", "-l", nullptr]
void ParseCommandLine(char command_buffer[], int len)
{
    (void)len;
    // 清空全局命令参数数组
    memset(gargv, 0, sizeof(gargv));
    gargc = 0;

    // 分隔符:以空格分割命令和参数
    const char *sep = " ";
    // strtok:第一次分割,提取命令名
    gargv[gargc++] = strtok(command_buffer, sep);
    // 循环分割剩余参数,直到分割完毕
    while((bool)(gargv[gargc++] = strtok(nullptr, sep)));
    // 修正参数个数(最后一次循环多自增了1)
    gargc--;
}

// 调试函数:打印解析后的命令参数个数和具体内容
void debug()
{
    printf("argc: %d\n", gargc);
    for(int i = 0; gargv[i]; i++)
    {
        printf("argv[%d]: %s\n", i, gargv[i]);
    }
}

// 重要设计:shell命令分为两类
// 1. 外部命令:由子进程执行(如ls、pwd)
// 2. 内建命令:由shell自身执行(如cd、export),子进程执行无效
// 核心功能4:创建子进程,执行外部命令
bool ExecuteCommand()
{
    // fork:创建子进程,返回值:-1失败,0子进程,>0父进程(子进程PID)
    pid_t id = fork();
    if(id < 0) return false;
    if(id == 0)
    {
        // 子进程代码区
        // execvpe:加载并执行外部命令,替换子进程的代码段
        // 参数:命令名、参数数组、环境变量数组
        execvpe(gargv[0], gargv, genv);
        // exec系列函数执行成功不会返回,执行失败才会走到这里
        // 子进程异常退出,退出码1
        exit(1);
    }
    // 父进程代码区
    int status = 0;
    // waitpid:等待子进程退出,回收子进程资源(避免僵尸进程)
    pid_t rid = waitpid(id, &status, 0);
    if(rid > 0)
    {
        // WIFEXITED:判断子进程是否正常退出
        if(WIFEXITED(status))
        {
            // WEXITSTATUS:获取子进程的退出码
            lastcode = WEXITSTATUS(status);
        }
        else
        {
            // 子进程异常终止(如信号杀死),设置退出码100
            lastcode = 100;
        }
        return true;
    }
    return false;
}

// 功能:向全局环境变量表中添加自定义环境变量
// 参数:item-环境变量字符串(如PATH=/usr/bin)
void AddEnv(const char *item)
{
    int index = 0;
    // 找到环境变量数组的末尾空位
    while(genv[index])
    {
        index++;
    }
    // 分配内存存储环境变量
    genv[index] = (char*)malloc(strlen(item)+1);
    // 拷贝环境变量字符串
    strncpy(genv[index], item, strlen(item)+1);
    // 数组末尾置空,标记结束
    genv[++index] = nullptr;
}

// 核心功能5:检查是否为内建命令,若是则直接执行
// 返回值:true-是内建命令并执行,false-不是内建命令
bool CheckAndExecBuiltCommand()
{
    // 内建命令1:cd 切换目录
    // 设计原因:子进程切换目录不会影响父shell,必须由shell自身执行
    if(strcmp(gargv[0], "cd") == 0)
    {
        if(gargc == 2)
        {
            // chdir:系统调用,切换当前工作目录
            chdir(gargv[1]);
            lastcode = 0;
        }
        else
        {
            // 参数错误,设置退出码1
            lastcode = 1;
        }
        return true;
    }
    // 内建命令2:export 添加自定义环境变量
    else if(strcmp(gargv[0], "export") == 0)
    {
        if(gargc == 2)
        {
            // 调用函数添加环境变量
            AddEnv(gargv[1]);
            lastcode = 0;
        }
        else
        {
            lastcode = 2;
        }
        return true;
    }
    // 内建命令3:env 打印所有环境变量
    else if(strcmp(gargv[0], "env") == 0)
    {
        for(int i = 0; genv[i]; i++)
        {
            printf("%s\n", genv[i]);
        }
        lastcode = 0;
        return true;
    }
    // 内建命令4:echo 打印内容(支持打印上一条命令退出码 $?)
    else if(strcmp(gargv[0], "echo") == 0)
    {
        if(gargc == 2)
        {
            // 判断是否为 $ 开头的环境变量/退出码
            if(gargv[1][0] == '$')
            {
                // 打印上一条命令的退出码 $?
                if(gargv[1][1] == '?')
                {
                    printf("%d\n", lastcode);
                    lastcode = 0;
                }
                else
                {
                    // 打印普通$变量
                    printf("%s\n", gargv[1]);
                    lastcode = 0;
                }
            }
        }
        else
        {
            lastcode = 3;
        }
        return true;
    }
    // 不是内建命令,返回false
    return false;
}

// 功能:初始化shell的环境变量,从父进程(系统shell)继承所有环境变量
void InitEnv()
{
    // 系统全局变量:存储所有系统环境变量
    extern char **environ;
    int index = 0;
    // 遍历系统环境变量,拷贝到自定义环境变量表
    while(environ[index])
    {
        genv[index] = (char*)malloc(strlen(environ[index])+1);
        strncpy(genv[index], environ[index], strlen(environ[index])+1);
        index++;
    }
    // 环境变量数组末尾置空
    genv[index] = nullptr;
}

// shell主函数:程序入口
int main()
{
    // 1. 初始化环境变量
    InitEnv();
    // 命令缓冲区:存储用户输入的命令
    char command_buffer[basesize];
    // 死循环:shell持续运行,等待用户输入命令
    while(true)
    {
        // 步骤1:打印命令提示符
        PrintCommandLine();
        // 步骤2:获取用户输入的命令
        if( !GetCommandLine(command_buffer, basesize) )
        {
            // 空输入/获取失败,重新循环
            continue;
        }
        // 步骤3:解析命令字符串为参数数组
        ParseCommandLine(command_buffer, strlen(command_buffer));

        // 步骤4:优先执行内建命令,执行成功则跳过外部命令
        if ( CheckAndExecBuiltCommand() )
        {
            continue;
        }

        // 步骤5:不是内建命令,创建子进程执行外部命令
        ExecuteCommand();
    }
    return 0;
}
5.4 总结
在继续学习新知识前,我们来思考函数和进程之间的相似性
exec/exit就像call/return
⼀个C程序有很多函数组成。⼀个函数可以调⽤另外⼀个函数,同时传递给它⼀些参数。被调⽤的函数 执⾏⼀定的操作,然后返回⼀个值。每个函数都有他的局部变量,不同的函数通过call/return系统进 ⾏通信。
这种通过参数和返回值在拥有私有数据的函数间通信的模式是结构化程序设计的基础。Linux⿎励将这 种应⽤于程序之内的模式扩展到程序之间。如下图:
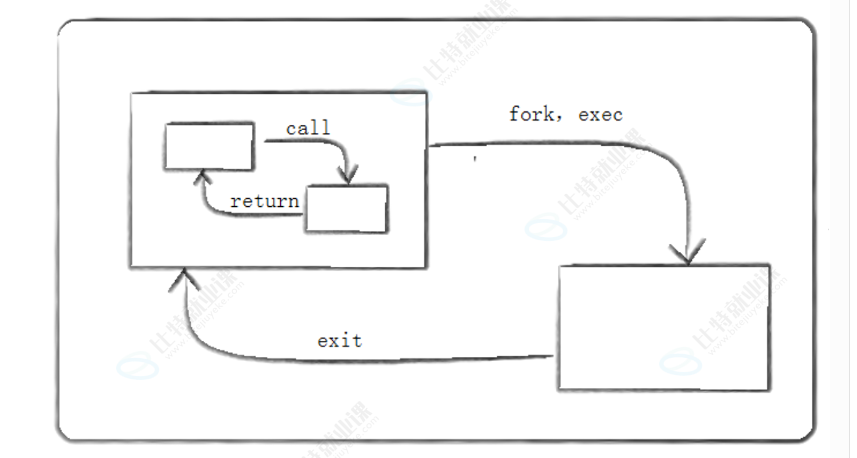
⼀个C程序可以fork/exec另⼀个程序,并传给它⼀些参数。这个被调⽤的程序执⾏⼀定的操作,然后 通过exit(n)来返回值。调⽤它的进程可以通过wait(&ret)来获取exit的返回值。