Transformer 解码器组成部分
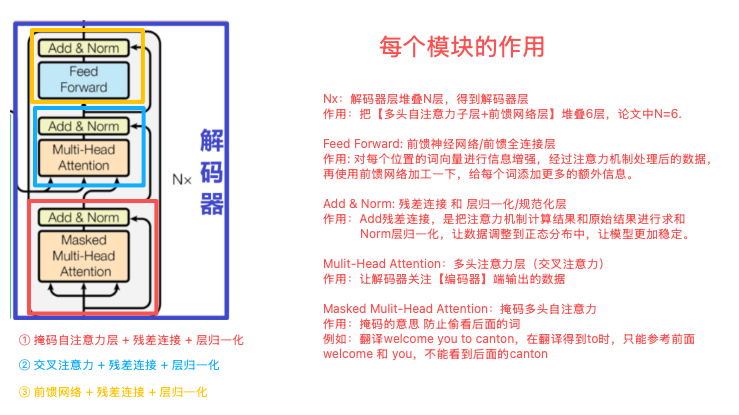
Transformer 解码器由 (解码器输入层数据 + 编码器输出数据),
最终输出层通过(线性层+Softmax权重)输出
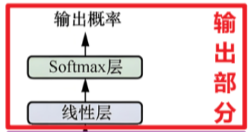
输出部分代码:
python
"""
    输出层
    N层解码器 输出值 带入 经过 线性 + 权重 最后输出 【batch_size, seq_len, d_model】
"""
class Output(nn.Module):
    def __init__(self, d_model, vocab_size):
        super().__init__()
        self.linear = nn.Linear(in_features=d_model, out_features=vocab_size)

    def forward(self, input_data):
        return torch.softmax(self.linear(input_data), dim=-1)
解码器代码:
1.解码器器层
由三部分组成
① 掩码多头自注意力层 + 层归一化 + 残差连接
② 交叉注意力层 + 层归一化 + 残差连接
③ 前馈网络 + 层归一化 + 残差连接
python
"""
    解码器器层
    由三部分组成
        ① 掩码多头自注意力层 + 层归一化 + 残差连接
        ② 交叉注意力层 + 层归一化 + 残差连接
        ③ 前馈网络 + 层归一化 + 残差连接
"""
class DecoderLayer(nn.Module):
    def __init__(self, d_model, mask_multi_self_atten_obj, multi_head_atten_obj, feed_forward_obj):
        super().__init__()

        self.d_model = d_model
        """
            三个层 对象实例
        """
        self.mask_multi_self_atten_obj = mask_multi_self_atten_obj
        self.multi_head_atten_obj = multi_head_atten_obj
        self.feed_forward_obj = feed_forward_obj

        """
            三个部分层
        """
        self.mask_multi_self_atten_layer = SubLayerConnection(d_model)
        self.multi_head_atten_layer = SubLayerConnection(d_model)
        self.feed_forward_layer = SubLayerConnection(d_model)

    def forward(self, data, mask, encoder_output):
        """
        :param data:    输入部分数据 (位置编码 + 词嵌入层)
        :param mask:    掩码
        :param encoder_output:  编码器成输出值
        :return:    解码器最后输出
        """
        mask_multi_self_atten_output = self.mask_multi_self_atten_layer(
            data,
            lambda x: self.mask_multi_self_atten_obj(query=x,key=x,value=x,mask=mask)
        )

        multi_head_atten_output = self.multi_head_atten_layer(
            mask_multi_self_atten_output,
            lambda y: self.multi_head_atten_obj(query=y,key=encoder_output,value=encoder_output)
        )

        feed_forward_output = self.feed_forward_layer(
            multi_head_atten_output,
            lambda z: self.feed_forward_obj(z)
        )

        return feed_forward_output
2.N层解码器层
python
"""
    N层 解码器层
"""
class Decoder(nn.Module):
    def __init__(self, decoder_layer_obj):
        super().__init__()

        self.decoder_layer_list = clones(decoder_layer_obj, 6)
        """
            【可选】多一次层归一化处理,让数据更稳定。
        """
        self.layer_norm = LayerNorm(decoder_layer_obj.d_model)

    def forward(self, data, mask, encoder_output):
        for decoder_layer in self.decoder_layer_list:
            data = decoder_layer(data, mask, encoder_output)

        return self.layer_norm(data)
3.全流程测试 从编码输入层 ->.编码器输出 + 解码器输入层 -> N层解码器 ->. 输出部分
**构建解码器部分
- 解码器端 输入部分
- 解码器三个部分
- 拼接单层解码器
- 多层解码器层
- 准备掩码. 【num_heads, seq_len, seq_len】
- 词嵌入层
- 位置编码层
- N层 编码器 输入 -> 输出**
python
def use_Decoder():
    """
        准备数据
    """
    d_model = 512
    dropout_p = 0.1
    max_len = 20    #最大翻译词的长度
    num_heads = 8
    encoder_output = use_encoder()
    print(f'编码器输出{encoder_output}')

    # 解码器的原始数据目标数据
    decoder_input_data = torch.tensor([
        # 2条句子 每条4个词,词索引
        [1, 2, 3, 4],
        [5, 6, 7, 8]
    ])

    """
        构建解码器部分
        1. 解码器端 输入部分
        2. 解码器三个部分
        3. 拼接单层解码器
        4. 多层解码器层
        5. 准备掩码. 【num_heads, seq_len, seq_len】
        6. 词嵌入层
        7. 位置编码层
        8. N层 编码器 输入 -> 输出
    """
    # 1
    embed = Embedding(vocab_size=1200, d_model=d_model)
    position_encoding = PositionalEncoding(d_model=d_model,max_len=max_len,dropout_p=dropout_p)
    # 2
    feed_forward = FeedForward(d_model=d_model,output_dim=1024, dropout_p=dropout_p)
    mulit_att = MultiHeadAttention(d_model=d_model,num_heads=num_heads,dropout_p=dropout_p)
    mulit_self_att = MultiHeadAttention(d_model=d_model,num_heads=num_heads,dropout_p=dropout_p)
    # 3
    decoder_layer = DecoderLayer(
        mask_multi_self_atten_obj=mulit_self_att,
        multi_head_atten_obj=mulit_att,
        feed_forward_obj=feed_forward,
        d_model=d_model
    )
    # 4
    decoder = Decoder(decoder_layer)
    # 5
    mask = torch.zeros(size=(num_heads, len(decoder_input_data[0]), len(decoder_input_data[0])))
    # 6
    input_data = embed(decoder_input_data)
    # 7.
    input_data = position_encoding(input_data)
    # 8.
    decoder_result = decoder(
        data=input_data,
        mask=mask,
        encoder_output=encoder_output
    )

    print(f"解码器最终的结果:{decoder_result.shape}")
    return decoder_result