下载解压
下载地址:https://hadoop.apache.org/releases.html
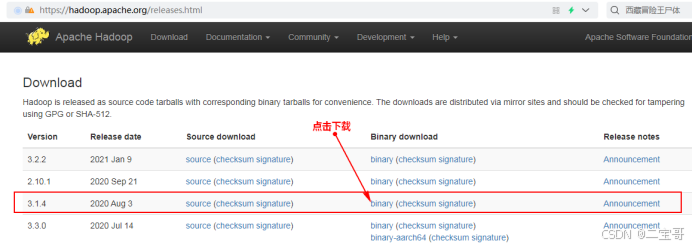
上传下载好的Hadoop安装包到node1节点上,并解压:tar -zxvf ./hadoop-3.1.4.tar.gz
配置
在node1节点上配置Hadoop的环境变量
[root@node1 software]# vim /etc/profile
export HADOOP_HOME=/software/hadoop-3.1.4/
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin:

#使配置生效
source /etc/profile
配置$HADOOP_HOME/etc/hadoop下的hadoop-env.sh文
#导入JAVA_HOME
export JAVA_HOME=/usr/java/jdk1.8.0_181-amd64/
配置$HADOOP_HOME/etc/hadoop下的hdfs-site.xml文件
XML
<configuration>
    <property>
        <!--这里配置逻辑名称,可以随意写 -->
        <name>dfs.nameservices</name>
        <value>mycluster</value>
    </property>
    <property>
        <!-- 禁用权限 -->
        <name>dfs.permissions.enabled</name>
        <value>false</value>
    </property>
    <property>
        <!-- 配置namenode 的名称,多个用逗号分割  -->
        <name>dfs.ha.namenodes.mycluster</name>
        <value>nn1,nn2</value>
    </property>
    <property>
        <!-- dfs.namenode.rpc-address.[nameservice ID].[name node ID] namenode 所在服务器名称和RPC监听端口号  -->
        <name>dfs.namenode.rpc-address.mycluster.nn1</name>
        <value>node1:8020</value>
    </property>
    <property>
        <!-- dfs.namenode.rpc-address.[nameservice ID].[name node ID] namenode 所在服务器名称和RPC监听端口号  -->
        <name>dfs.namenode.rpc-address.mycluster.nn2</name>
        <value>node2:8020</value>
    </property>
    <property>
        <!-- dfs.namenode.http-address.[nameservice ID].[name node ID] namenode 监听的HTTP协议端口 -->
        <name>dfs.namenode.http-address.mycluster.nn1</name>
        <value>node1:50070</value>
    </property>
    <property>
        <!-- dfs.namenode.http-address.[nameservice ID].[name node ID] namenode 监听的HTTP协议端口 -->
        <name>dfs.namenode.http-address.mycluster.nn2</name>
        <value>node2:50070</value>
    </property>

    <property>
        <!-- namenode 共享的编辑目录, journalnode 所在服务器名称和监听的端口 -->
        <name>dfs.namenode.shared.edits.dir</name>
        <value>qjournal://node3:8485;node4:8485;node5:8485/mycluster</value>
    </property>

    <property>
        <!-- namenode高可用代理类 -->
        <name>dfs.client.failover.proxy.provider.mycluster</name>
        <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
    </property>

    <property>
        <!-- 使用ssh 免密码自动登录 -->
        <name>dfs.ha.fencing.methods</name>
        <value>sshfence</value>
    </property>

    <property>
        <name>dfs.ha.fencing.ssh.private-key-files</name>
        <value>/root/.ssh/id_rsa</value>
    </property>

    <property>
        <!-- journalnode 存储数据的地方 -->
        <name>dfs.journalnode.edits.dir</name>
        <value>/opt/data/journal/node/local/data</value>
    </property>

    <property>
        <!-- 配置namenode自动切换 -->
        <name>dfs.ha.automatic-failover.enabled</name>
        <value>true</value>
    </property>

</configuration>
配置$HADOOP_HOME/ect/hadoop/core-site.xml
XML
<configuration>
    <property>
        <!-- 为Hadoop 客户端配置默认的高可用路径  -->
        <name>fs.defaultFS</name>
        <value>hdfs://mycluster</value>
    </property>
    <property>
        <!-- Hadoop 数据存放的路径,namenode,datanode 数据存放路径都依赖本路径,不要使用 file:/ 开头,使用绝对路径即可
            namenode 默认存放路径 :file://${hadoop.tmp.dir}/dfs/name
            datanode 默认存放路径 :file://${hadoop.tmp.dir}/dfs/data
        -->
        <name>hadoop.tmp.dir</name>
        <value>/opt/data/hadoop/</value>
    </property>

    <property>
        <!-- 指定zookeeper所在的节点 -->
        <name>ha.zookeeper.quorum</name>
        <value>node3:2181,node4:2181,node5:2181</value>
    </property>

</configuration>
配置$HADOOP_HOME/etc/hadoop/yarn-site.xml
XML
<configuration>
    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
    </property>
    <property>
        <name>yarn.nodemanager.env-whitelist</name>
        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>
    </property>

    <property>
        <!-- 配置yarn为高可用 -->
        <name>yarn.resourcemanager.ha.enabled</name>
        <value>true</value>
    </property>
    <property>
        <!-- 集群的唯一标识 -->
        <name>yarn.resourcemanager.cluster-id</name>
        <value>mycluster</value>
    </property>
    <property>
        <!--  ResourceManager ID -->
        <name>yarn.resourcemanager.ha.rm-ids</name>
        <value>rm1,rm2</value>
    </property>
    <property>
        <!-- 指定ResourceManager 所在的节点 -->
        <name>yarn.resourcemanager.hostname.rm1</name>
        <value>node1</value>
    </property>
    <property>
        <!-- 指定ResourceManager 所在的节点 -->
        <name>yarn.resourcemanager.hostname.rm2</name>
        <value>node2</value>
    </property>
    <property>
        <!-- 指定ResourceManager Http监听的节点 -->
        <name>yarn.resourcemanager.webapp.address.rm1</name>
        <value>node1:8088</value>
    </property>
    <property>
        <!-- 指定ResourceManager Http监听的节点 -->
        <name>yarn.resourcemanager.webapp.address.rm2</name>
        <value>node2:8088</value>
    </property>
    <property>
        <!-- 指定zookeeper所在的节点 -->
        <name>yarn.resourcemanager.zk-address</name>
        <value>node3:2181,node4:2181,node5:2181</value>
</property>
<property>
       <!-- 关闭虚拟内存检查 -->
    <name>yarn.nodemanager.vmem-check-enabled</name>
    <value>false</value>
</property>
	<!-- 启用节点的内容和CPU自动检测,最小内存为1G -->
    <!--<property>
        <name>yarn.nodemanager.resource.detect-hardware-capabilities</name>
        <value>true</value>
    </property>-->
</configuration>
配置$HADOOP_HOME/etc/hadoop/mapred-site.xml
XML
<configuration>
    <property>
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>
</configuration>
配置$HADOOP_HOME/etc/hadoop/workers文件
XML
[root@node1 ~]# vim /software/hadoop-3.1.4/etc/hadoop/workers
node3
node4
node5
配置$HADOOP_HOME/sbin/start-dfs.sh 和stop-dfs.sh两个文件中顶部添加以下参数,防止启动错误
XML
HDFS_DATANODE_USER=root
HDFS_DATANODE_SECURE_USER=hdfs
HDFS_NAMENODE_USER=root
HDFS_JOURNALNODE_USER=root
HDFS_ZKFC_USER=root
配置$HADOOP_HOME/sbin/start-yarn.sh和stop-yarn.sh两个文件顶部添加以下参数,防止启动错误
XML
YARN_RESOURCEMANAGER_USER=root
YARN_NODEMANAGER_USER=root
将配置好的Hadoop安装包发送到其他4个节点
XML
[root@node1 ~]# scp -r /software/hadoop-3.1.4 node2:/software/
[root@node1 ~]# scp -r /software/hadoop-3.1.4 node3:/software/
[root@node1 ~]# scp -r /software/hadoop-3.1.4 node4:/software/
[root@node1 ~]# scp -r /software/hadoop-3.1.4 node5:/software/
在node2、node3、node4、node5节点上配置HADOOP_HOME
XML
#分别在node2、node3、node4、node5节点上配置HADOOP_HOME
vim /etc/profile
export HADOOP_HOME=/software/hadoop-3.1.4/
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin:

#最后记得Source
source /etc/profile
设置免密登录
生成ssh密钥(如果没生成过),在当前节点
bash
# 在当前节点(root用户)执行,一路回车,不要设置密码
ssh-keygen -t rsa -P ""
分发公钥到所有节点(包括自身)
bash
# 循环分发到 node1、node2、node3、node4、node5
for host in node1 node2 node3 node4 node5; do
  ssh-copy-id -i ~/.ssh/id_rsa.pub root@$host
done
测试免密登录
bash
# 测试每个节点,不需要输入密码才算成功
ssh node1 date
ssh node2 date
ssh node3 date
ssh node4 date
ssh node5 date
启动HDFS和Yarn
XML
#在node3,node4,node5节点上启动zookeeper
zkServer.sh start

#在node1上格式化zookeeper
[root@node1 ~]# hdfs zkfc -formatZK

#在每台journalnode中启动所有的journalnode,这里就是node3,node4,node5节点上启动
hdfs --daemon start journalnode
(配置/opt/data......目录下存储数据,需要root权限)

#在node1中格式化namenode
[root@node1 ~]# hdfs namenode -format

#在node1中启动namenode,以便同步其他namenode
[root@node1 ~]# hdfs --daemon start namenode

#高可用模式配置namenode,使用下列命令来同步namenode(在需要同步的namenode中执行,这里就是在node2上执行):
[root@node2 software]# hdfs namenode -bootstrapStandby

#node1上启动HDFS,启动Yarn
[root@node1 sbin]# start-dfs.sh
[root@node1 sbin]# start-yarn.sh
注意以上也可以使用start-all.sh命令启动Hadoop集群。
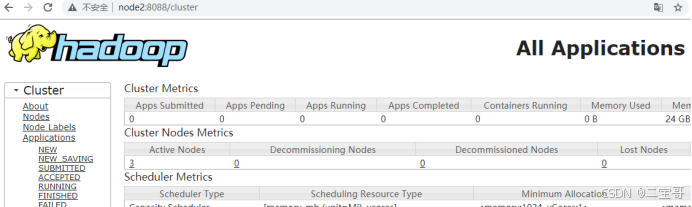
访问WebUI
|--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| #访问HDFS : http://node1:50070 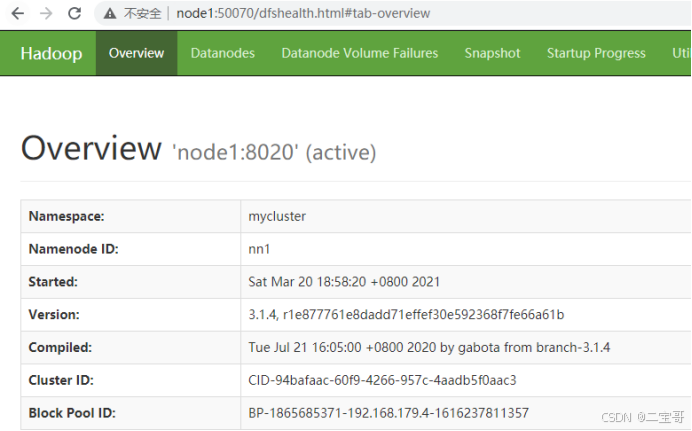 #访问Yarn WebUI :http://node1:8088
 |