Spark 从入门到部署:核心模块解析与 Yarn 模式实战指南
文章目录
- [Spark 从入门到部署:核心模块解析与 Yarn 模式实战指南](#Spark 从入门到部署:核心模块解析与 Yarn 模式实战指南)
一、Spark核心模块
摘要:本文系统介绍了Apache Spark大数据计算引擎的核心模块(Spark Core、Spark SQL、Spark Streaming、Spark MLlib、Spark GraphX)及其功能,并详细讲解了Spark的三种安装模式:本地模式、Standalone模式和Yarn模式。重点以Yarn模式为例,演示了从解压缩、配置文件修改、Hadoop集群启动到应用提交的完整部署流程,并配置了历史服务器以记录任务运行情况。
Spark是一种基于内存的快速、通用、可扩展的大数据分析计算引擎。
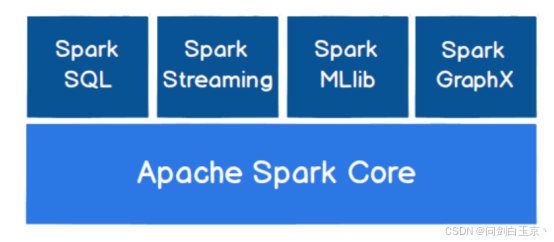
Spark是一种由Scala语言开发的快速、通用、可扩展的大数据分析引擎
➢ Spark Core
Spark Core中提供了Spark最基础与最核心的功能,Spark其他的功能如:Spark SQL,Spark Streaming,GraphX, MLlib都是在Spark Core的基础上进行扩展的
➢ Spark SQL
Spark SQL是Spark用来操作结构化数据的组件。通过Spark SQL,用户可以使用SQL或者Apache Hive版本的SQL方言(HQL)来查询数据。
➢ Spark Streaming
Spark Streaming是Spark平台上针对实时数据进行流式计算的组件,提供了丰富的处理数据流的API。
➢ Spark MLlib
MLlib是Spark提供的一个机器学习算法库。MLlib不仅提供了模型评估、数据导入等额外的功能,还提供了一些更底层的机器学习原语。
➢ Spark GraphX
GraphX是Spark面向图计算提供的框架与算法库。
二、安装模式
1、本地模式
基本测试,单机
2、Standalone模式
只使用Spark自身节点运行的集群模式,也就是我们所谓的独立部署(Standalone)模式。
spark本身自带了完整的资源调度管理服务,可以独立部署到一个集群中,无须依赖任何其他的资源管理系统。该模式下,同样为主从模式,即一台Master与多台Slave节点。
3、Yarn模式
Yarn模式被称为Spark on Yarn模式,即把Spark作为一个客户端,将作业提交给Yarn服务,由于在生产环境中,很多时候都要与Hadoop使用同一个集群,因此采用Yarn来管理资源调度,可以有效提高资源利用率。
独立部署(Standalone)模式由Spark自身提供计算资源,无需其他框架提供资源。这种方式降低了和其他第三方资源框架的耦合性,独立性非常强。但是也要记住,Spark主要是计算框架,而不是资源调度框架,所以本身提供的资源调度并不是它的强项,所以还是和其他专业的资源调度框架集成会更靠谱一些。
2.3.1 解压缩文件
将spark-2.3.2-bin-hadoop2.7.tgz文件上传到linux并解压缩,放置在指定位置。
bash
[root@master ~]$ cd /opt/software
[root@master software]$ tar -zvxf spark-2.3.2-bin-hadoop2.7.tgz -C /opt/module
[root@master software]$ cd /opt/module
[root@master module]$ mv spark-2.3.2-bin-hadoop2.7/ spark
2.3.2 修改配置文件
- 修改hadoop配置文件/opt/module/hadoop/etc/hadoop/yarn-site.xml, 并分发。
bash
<!--是否启动一个线程检查每个任务正使用的物理内存量,如果任务超出分配值,则直接将其杀掉,默认是true -->
<property>
<name>yarn.nodemanager.pmem-check-enabled</name>
<value>false</value>
</property>
<!--是否启动一个线程检查每个任务正使用的虚拟内存量,如果任务超出分配值,则直接将其杀掉,默认是true -->
<property>
<name>yarn.nodemanager.vmem-check-enabled</name>
<value>false</value>
</property>- 修改/opt/module/spark/conf/spark-env.sh,添加JAVA_HOME、YARN_CONF_DIR和HADOOP_CONF_DIR配置
bash
export JAVA_HOME=/opt/module/java
export YARN_CONF_DIR=/opt/module/hadoop/etc/hadoop
export HADOOP_CONF_DIR=/opt/module/hadoop/etc/hadoop
2.3.3 启动Hadoop集群
2.3.4 提交应用
bash
[root@master spark]$ bin/spark -submit \
-- class org.apache.spark.examples.SparkPi \
-- master yarn \
-- deploy -mode cluster \
./examples/jars/spark -examples_2.12 -3.0.0.jar \
10
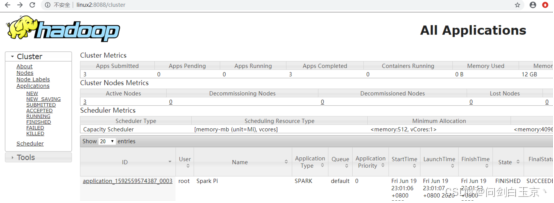
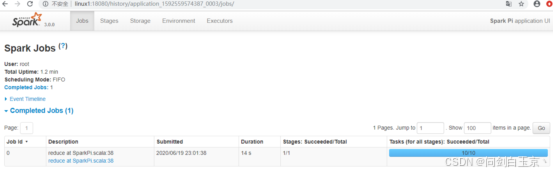
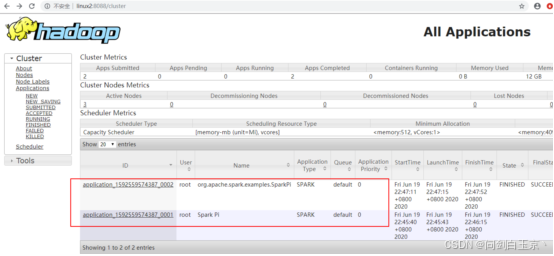
查看master:8088页面,点击History,查看历史页面
2.3.5 配置历史服务器
由于spark-shell停止掉后
历史服务器的配置与工作流程如下:
Spark 作业运行
写入事件日志
HDFS 日志存储目录
hdfs://master:8020/directory
History Server
端口 18080
Web UI 展示
master:8088
查看历史任务
运行详情
,集群监控master:4040页面就看不到历史任务的运行情况,所以开发时都配置历史服务器记录任务运行情况。
- 复制spark-defaults.conf.template文件为spark-defaults.conf
bash
cp spark-defaults.conf.template spark-defaults.conf- 修改 spark-default.conf文件,配置日志存储路径
bash
spark.eventLog.enabled true
spark.eventLog.dir hdfs://master:8020/directory
注意:需要启动hadoop集群,HDFS上的目录需要提前存在。
bash
[root@master conf]$ hdfs dfs -mkdir /directory- 修改 spark-env.sh文件 , 添加日志配置
bash
export SPARK_HISTORY_OPTS="
-Dspark.history.ui.port=18080
-Dspark.history.fs.logDirectory=hdfs://master:8020/directory
-Dspark.history.retainedApplications=30"
⚫ 参数1含义:WEB UI访问的端口号为18080
⚫ 参数2含义:指定历史服务器日志存储路径
⚫ 参数3含义:指定保存Application历史记录的个数,如果超过这个值,旧的应用程序信息将被删除,这个是内存中的应用数,而不是页面上显示的应用数。
- 修改spark-defaults.conf
bash
spark.yarn.historyServer.address= master:18080
spark.history.ui.port=18080
5)启动历史服务
bash
sbin/start-history-server.sh6)重新提交应用
bash
sbin/start-history-server.sh

bin/spark -submit \
-- class org.apache.spark.examples.SparkPi \
-- master yarn \
-- deploy-mode client
-- ./examples/jars/spark -examples_2.12 -3.0.0.jar \
10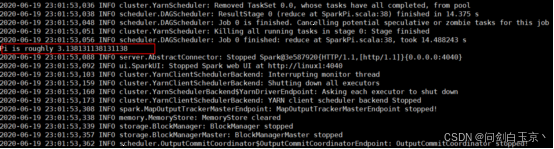
7)web页面查看日志:master:8088