在多模态大模型快速迭代的背景下,传统OCR技术的短板愈发明显。基于字符匹配的识别方式,无法适配复杂版式、公式、嵌套表格、手写内容等场景,存在格式错乱、识别误差大、无法结构化输出等问题。
2026年新一代大模型OCR,融合视觉与语言大模型能力,实现了版式理解、语义纠错、结构化解析的技术升级。目前国内主流厂商OCR模型差异化显著,适配开发部署、学术研究、企业商用等不同场景。本文从技术特性与落地场景出发,盘点六款主流大模型OCR,为开发者和企业提供精准选型参考。
大模型OCR与传统OCR的核心技术差异
传统OCR仅完成单层字符检测与识别,不具备文档逻辑认知。而新版大模型OCR拥有全局文档理解能力,支持自动还原排版结构、智能修正模糊残缺文本,兼顾轻量化端侧部署与云端高精度批量处理,完美适配个人开发、中小项目、企业规模化落地等多元场景。
六大主流大模型OCR技术特性与落地场景
1. 百度 PaddleOCR-VL:轻量化开源部署首选
作为国内开源生态最完善的OCR方案,该模型主打小参数、高精度、低部署成本。支持文本、表格、公式全场景识别,适配本地部署、二次开发、RAG知识库搭建等需求。开源生态完善、文档齐全,是个人开发者、中小型项目快速落地OCR功能的最优选择,广泛应用于试卷识别、合同解析、图文数字化等场景。
2. DeepSeek-OCR:专业长文档与公式识别标杆
模型核心优势为超强上下文感知与长文本建模能力,针对性优化多栏排版、复杂数理公式、长篇学术文献识别难题,可有效规避公式乱码、文本错位、内容缺失等问题。适配科研数字化、专业文档解析、技术资料结构化处理,是学术与技术场景的专用方案。
3. 腾讯混元 HunyuanOCR:企业级标准化解决方案
面向企业商用场景打造,依托混元多模态大模型底座,擅长标准化文档批量处理。支持多语种识别、复杂版式解析,可直接输出标准化结构化数据,可无缝对接企业OA、财务、档案管理系统。稳定适配发票、流水、政务档案、批量合同识别,是企业自动化办公的主流选型。
4. 智谱 GLM-OCR:复杂非标版式适配利器
针对图文混排、嵌套表格、不规则非标版式优化,具备优秀的复杂文档解析能力,自带语义甄别、关键信息提取功能,多语种识别性能突出,适合跨境文档处理、图书数字化、广告图文解析等非标场景开发。
5. 小红书 FireRed-OCR:手写与UGC内容识别专精
差异化聚焦生活化、社交化UGC内容,对潦草手写体、涂鸦文字、不规则排版容错率极高,可高效完成手写笔记数字化、社交内容识别、电商信息提取,适配轻量化C端项目开发。
6. LightOnOCR-2:低功耗工业级批量方案
采用光子计算加速架构,主打低功耗、高吞吐,无需高性能设备即可实现海量数据批量识别,适配物流面单、工业设备信息采集、边缘端批量识别等工业级落地场景。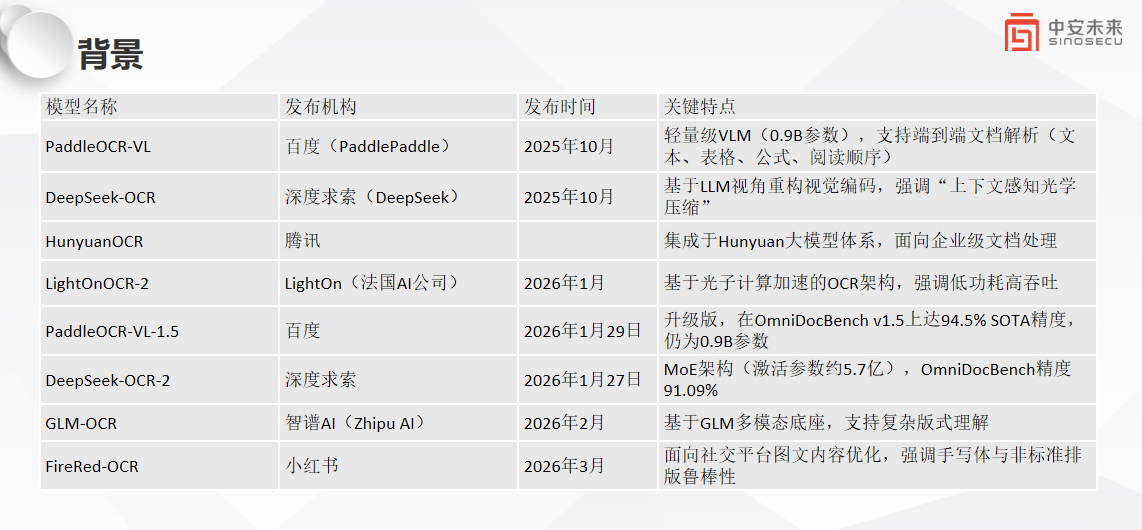
技术选型总结
开源轻量化部署选PaddleOCR-VL,专业学术文档解析选DeepSeek-OCR,企业标准化业务选腾讯混元OCR,非标多语种场景用GLM-OCR,手写UGC场景适配FireRed-OCR,工业边缘批量处理优先LightOnOCR-2。
不同模型技术侧重点不同,开发者可根据部署环境、业务场景、算力条件灵活选型,有效降低开发成本,提升文档识别与结构化处理效率。