目录
开始热身
1、理解源IP地址和目的IP地址
在IP数据包头部有两个IP地址,分别叫做源IP地址和目的IP地址
如果我们的台式机或者笔记本没有IP地址就无法上网,而因为每台主机都有IP地址,所以注定了数据从一台主机传输到另一台主机就一定有源IP地址和目的IP地址,所以在报头中就会包含源IP地址和目的IP地址
而我们将数据从一台主机传递到另一台主机并不是目的,真正通信的其实是应用层上的软件
而我们知道应用层可不止一个软件 。既然有了公网IP标识了一台唯一的主机 ,那么数据就可以由一台主机传递到另一台主机。但是这么多的软件(进程),如何保证软件A发送的被软件B接受呢?(用什么来标识主机上的进程的唯一性呢?)
2、理解端口号和进程ID
端口号是用于标识在一台设备上运行的不同网络应用程序或服务的数字标识符,它是一个16位的数字,可以是0-65535之间任意值。当一个应用程序或服务需要通过网络进行通信时候,它会打开一个特定的端口,并侦听该端口上的连接,这个侦听过程称为绑定(binding),当其他设备或应用程序尝试连接到此端口时,操作系统会将连接转发给已经绑定到该端口的应用程序进程。
因此,可以说端口号和进程之间存在一对一的映射关系。一个特定的端口号通常与一个特定的进程或应用程序相关联,而且一个端口号只能与绑定一个进程。当网络通信发生时,数据包会通过端口号被正确的路由至相应的进程,确保通信的正确进行
同一个设备上的不同进程可以绑定不同的端口号,这样就使得多个应用程序能够同时进行网络通信,而无需担心冲突。每个进程可以通过独立的端口号进行区分和识别,从而实现并发的网络通信
为了更好的表示一台主机上服务进程的唯一标识性,规定用端口号标识服务进程、客户端进程的唯一性。端口号(port)是传输层的协议内容
- 端口号是一个2字节16位的整数
- 端口号用来标识一个进程,告诉操作系统:当前的这个数据要交给哪一个进程来处理
- 一个端口号只能被一个进程占用。(一个进程可以绑定多个端口号,但是一个端口号不能被多个进程绑定)
IP地址(标识唯一主机)+端口号(标识唯一进程)能够标识网络上的某一台主机的某一个进程(全网唯一的进程)
端口号的解释:
- HTTP通信使用的端口号是80。在浏览器中输入网址并访问一个网站时,浏览器会与服务器进行HTTP通信。在这个过程中,浏览器将通过端口号80发送请求,以与服务器上运行的Web服务器进行通信。Web服务器接受到请求后,会将相应的网页内容返回给浏览器,并通过端口号80将响应发送回浏览器。因此,端口号80在这种情况下用于标识HTTP通信
- FTP通信使用的端口号是21.使用FTP客户端与远程服务器进行文件传输时,通常使用的端口号是21。FTP客户端通过端口号21与FTP服务器建立连接并发送指令来上传、下载或删除文件。端口号21被FTP协议保留,用于标识FTP通信
每个端口号都有特定的作用和用途,列入常见的端口号有:
- 20和21:FTP
- 22:SSH
- 25:SMTP(用于发送电子邮件)
- 53:DNS(域名系统)
- 80:HTTP
- 443:HTTPS
将数据发送给对方的机器是我们的目的吗?
不是的,是手段。真正的网络通信过程,本质其实就是进程间通信。将数据在主机间转发仅仅是手段,机器收到之后,需要将数据交付给指定的进程。
前面说过进程间通信的本质是看到同一份资源,现在这个资源就是网络,而通信的本质就是IO,因为我们上网的行为就两种情况:
1、把数据发送出去
2、接收到数据
标识一个进程有pid,为什么还需要有端口号呢?
- 首先pid是系统规定的,而port是网络规定的,这样就可以把系统和网络解耦
- port标识服务器的唯一性不能做任何改变,要让客户端能找到服务器,就像110,120一样不能被改变,而pid每次启动进程,pid就会改变
- 不是所有的进程都需要提供网络服务或请求(不需要port),但每个进程都需要pid
虽然一个端口号只能绑定一个进程,但是一个进程可以绑定多个端口号。前面说了有源IP和目的IP,而这里的port也有源端口号和目的端口号,我们在发送数据的时候也要把自己的ip和端口号发送过去,因为数据还要被发送回来,所以发送数据时,一定会多出一部分数据(以协议的形式呈现)
那么第一次是如何知道给哪个IP和port发送的?
服务器已经内置好了
3、理解源端口号和目的端口号
传输层协议(TCP和UDP)的数据段中有两个端口号,分别叫做源端口号和目的端口号,就是在描述"数据是谁发的,要发给谁"
4、认识TCP、UDP协议
我们用的套接字接口一定会使用传输层协议,不会绕过传输层去调用下面的协议
传输层的协议分为TCP协议和UDP协议
(1)TCP协议
TCP的特点:
- 传输层协议
- 有连接(在正式通信前要先建立连接)
- 可靠传输(在内部帮我们做可靠传输工作)
- 面向字节流
(2)UDP协议
UDP的特点
- 传输层协议
- 无连接
- 不可靠传输(可能出现网络丢包或数据包乱序、重复等问题)
- 面向数据报
传输层就是用来解决可靠性的一个协议
那为什么UDP是不可靠传输的,而我们还要有这个协议呢?
在网络通信中,现在的主流网络出现丢包的概率并不大。即使出现了丢包的情况,在有些场景下也是可以容忍的。可不可靠在这里只是一个中性词,是他们的特点。可靠性是需要付出大量的编码和数据的处理成本的,往往在维护和编码上都比较复杂。而不可靠没有成本,使用起来也简单。所以二者要分场景使用。
(3)网络字节序
小端:低权值的数放入低地址
大端:低权值的数放入高地址
我们已经知道,内存中的多字节数据相对于内存地址有大端和小端之分,磁盘文件中的多字节数据相对于文件中的偏移地址也有大端小端之分,网络数据流同样有大端小端之分
那么如何定义网络数据流的地址呢?(如果一个大端机用大端的方式发送数据到一个小端机,现在跨网络我们也不知道数据到底是大端和小端)
发送主机通常将发送缓冲区中的数据按内存地址从低到高的顺序发出,接受主机把从网络上接到的字节依次保存在接收缓冲区中,也是按按内存地址从低到高的顺序保存
因此,网络数据流的地址应该这样规定:先发出的数据是低地址,后发出的数据是高地址。TCP/IP协议规定:网络数据流应采用大端字节序,即低地址高字节。不管这台主机是大端机还是小端机,都会按照这个TCP/IP规定的网络字节序来发送/接收数据。如果当前发送主机是小端,就需要先将数据转换大端;否则就忽略。直接发送即可
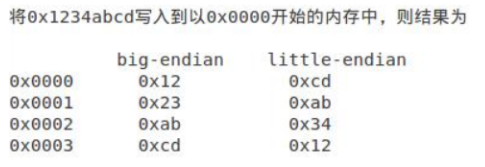
为使网络程序具有可移值性,使同样的C代码在大端和小端计算机上编译后都能正常运行,可以调用以下库函数做网络字节序和主机字节序的转换
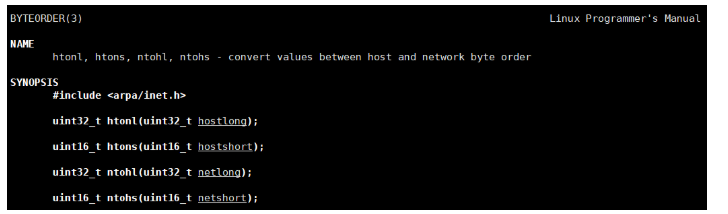
- h表示host,n表示network,l表示32位长整数,s表示16位短整数
- 例如htonl表示是将32位的长整数从主机字节序转换为网络字节序,例如将IP地址转换后准备发送
- 如果主机是小端字节序,这些函数将参数做相应的大小端转换然后返回
- 如果主机是大端字节序,这些函数不做转换,将参数原封不动的返回
一、socket套接字
1、socket常见API
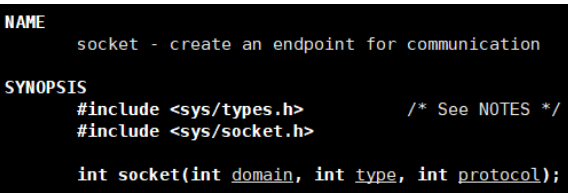
(1)socket
创建socket文件描述符(TCP/UDP,客户端+服务端)

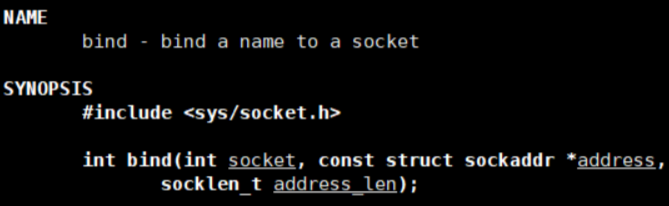
(2)bind
绑定端口号(TCP/UDP,服务器)

(3)listen
开始监听 socket (TCP,服务器)
(4)accept
接收请求(TCP,服务器)
(5)connect
建立连接(TCP,客户端)
2、sockaddr结构
socket API是一层抽象的网络编程接口,适用于各种底层网络协议,如IPv4,IPv6,以及后面要讲的UNIX Domain Socket。然而,各种网络协议的地址格式并不相同
套接字有不少类型,常见的有三种:
1、原始socket
2、域间socket
3、网络socket
三种应用场景:网络套接字主要运用于跨主机之间的通信,也能支持本地通信,而域间套接字只能在本地通信,而原始套接字可以跨过传输层(TCP/IP协议)访问底层的数据
为了方便,设计者只使用了一套接口,这样就可以通过不同的参数来解决所有的通信场景。这里举两个具体的套接字类型:sockaddr_in和sockaddr_un;
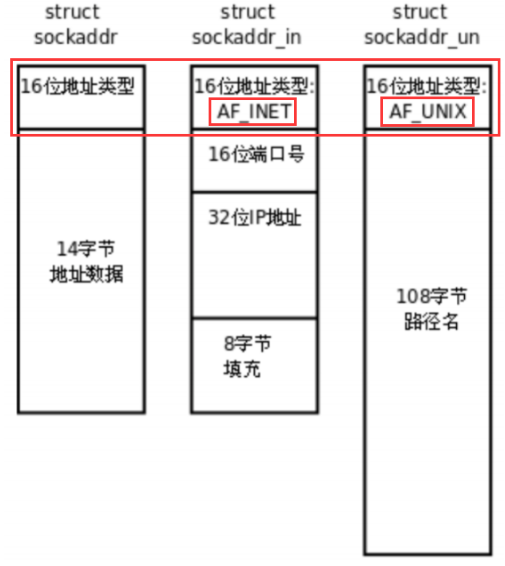
可以看到sockaddr_in和sockaddr_un是两个不同的通信场景,区分它们就用16地址类型协议家族的标识符。但是,这两个结构体都不用,我们用sockaddr。
比方说我们想用网络通信,虽然参数是const struct sockaddr* addr,但实际传递进去的却是sockaddr_in结构体(注意要强制类型转换)。在函数内部一视同仁,全部看成sockaddr类型,然后根据前两个字节判断到底是什么通信类型然后再强制回去。可以把sockaddr看成甚类,把sockaddr_in和sockaddr_un看成派生类,构成了多态体系
- IPv4和IPv6的地址格式定义再netinet/in.h中,IPv4地址用sockaddr_in结构体表示,包括16位地址类型,16位端口号和32位IP地址
- IPv4、IPv6地址类型分别定义为常数AF_INET、AF_INET6。这样,只要取得某种sockaddr结构体的首地址,不需要知道具体是那种类型的sockaddr结构体,就可以根据地址类型字段确定结构体中的内容
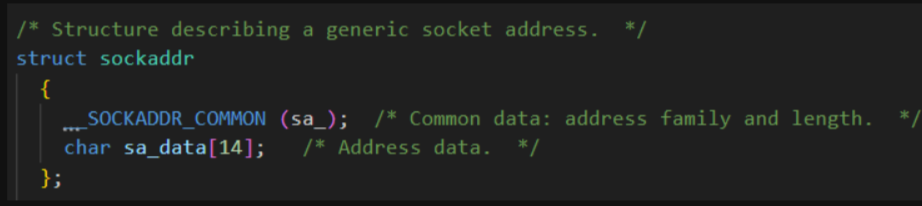
- socket API可以都用struct sockaddr* 类型表示,在使用的时候需要强制转换成sockaddr_in,这样的好处是程序通用性,可以接收IPv4,IPv6,以及UNIX Domain Socket 各种类型的 sockaddr 结构体指针做为参数
(1)sockaddr结构
(2)sockaddr_in结构
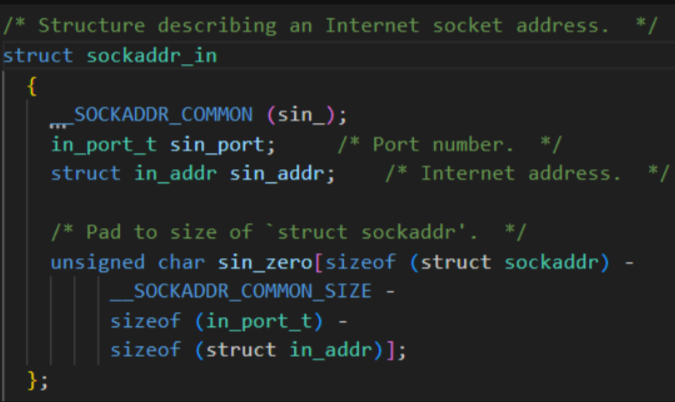
虽然socket api 的接口是sockaddr,但是我们真正在基于IPv4编程时,使用的数据结构是sockaddr_in,这个结构里主要有三部分信息:地址类型,端口号,IP 地址。
(3)in_addr结构
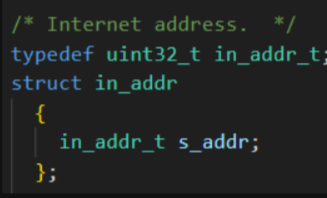
in_addr 用来表示一个IPv4的IP地址,其实就是一个32位的整数