先在智谱提问,让它给出PPT大纲。
以下是为您规划的西门子 WinCC 7.4 脚本编程基础 PPT 大纲,共 20 页。内容精简,重点突出,适合制作教程型 PPT。每页包含标题和核心内容要点。
第 1 页:封面
标题:西门子 WinCC 7.4 脚本编程基础
副标题:从入门到实战的 20 页教程
演讲人:您的名字
日期:202X 年 X 月 X 日
配图:WinCC 7.4 图标或 SCADA 系统界面截图
第 2 页:课程目标与适用对象
适用对象:
WinCC 工程师、自动化调试人员
有 PLC 基础但需提升 HMI 交互能力的技术人员
学习目标:
掌握 WinCC 7.4 脚本环境
熟悉基本语法与数据操作
能够编写常用逻辑控制脚本
了解调试与错误处理
课程时长:建议 45 分钟讲解 + 15 分钟练习
第 3 页:WinCC 7.4 脚本引擎概述
核心语言:基于 VBScript 的扩展语法
然后让它给写出python源代码
以下代码当前时间是调试成功的:
requirements.txt
powershell
在这里插入代码片annotated-types==0.7.0
anyio==4.13.0
certifi==2026.5.20
colorama==0.4.6
distro==1.9.0
forge-guardrails==0.7.2
h11==0.16.0
httpcore==1.0.9
httpx==0.28.1
idna==3.17
jiter==0.15.0
lxml==6.1.1
openai==2.38.0
pillow==12.2.0
pydantic==2.13.4
pydantic_core==2.46.4
python-pptx==1.0.2
PyYAML==6.0.3
sniffio==1.3.1
tqdm==4.67.3
typing-inspection==0.4.2
typing_extensions==4.15.0
xlsxwriter==3.2.9
config.yaml
python
# LLM 后端配置 (直连 llama-server)
llm:
  base_url: "https://example.com/v1"
  api_key: "api-key"
  model_name: "glm-5"
  temperature: 0.7
  max_tokens: 16000 # 确保足够长,防止大纲较长时截断

# 大纲文件路径
outline_file: "content.txt"

# PPT 渲染配置
ppt_settings:
  output_dir: "./output"
  slide_width: 13.333
  slide_height: 7.5
  font_name: "微软雅黑"
  title_font_size: 36
  body_font_size: 20
  paragraph_spacing: 10
可以用阿里、智谱等的免费额度,也可以用本地llama.cpp,本地测试Phi-4-mini-reasoning-Q5_K_M.gguf会失败,总是输出报错。
main.py
python
import os
import re
import yaml
import json
from pydantic import BaseModel, Field, ValidationError
from typing import List
from openai import OpenAI
from lxml import etree

from pptx import Presentation
from pptx.util import Pt, Inches
from pptx.enum.text import PP_ALIGN
from pptx.oxml.ns import qn

# ================= 加载配置 =================
def load_config(config_path="config.yaml"):
    if not os.path.exists(config_path):
        raise FileNotFoundError(f"配置文件 {config_path} 不存在!")
    with open(config_path, 'r', encoding='utf-8') as f:
        return yaml.safe_load(f)

CONFIG = load_config()
# ==========================================

# ================= 定义 Pydantic 模型 =================
# 用于验证 LLM 输出的 JSON 结构是否符合预期
class SlideContent(BaseModel):
    title: str = Field(description="当前幻灯片的标题")
    points: List[str] = Field(description="当前幻灯片的要点列表,每个要点不超过30字")

class PPTGenerationParams(BaseModel):
    slides: List[SlideContent] = Field(description="包含所有幻灯片内容的列表")
# =====================================================

def read_outline(file_path: str) -> str:
    """读取大纲文件"""
    if not os.path.exists(file_path):
        raise FileNotFoundError(f"大纲文件 {file_path} 不存在!")
    with open(file_path, 'r', encoding='utf-8') as f:
        return f.read().strip()

def generate_ppt_content(outline_content: str) -> list:
    """调用本地 LLM 生成 PPT 结构化内容,带强容错提取"""
    print(f"🤖 正在让 Qwen 基于大纲生成结构化数据...")

    llm_cfg = CONFIG['llm']
    client = OpenAI(base_url=llm_cfg['base_url'], api_key=llm_cfg['api_key'], timeout=300.0)

    system_prompt = """你是一个专业的PPT内容策划师。用户会提供一份现有的PPT大纲。
你的任务是基于这份大纲,输出PPT的结构化数据。
严格要求:
1. 必须完全遵循用户提供的大纲结构和页数,不得自行增删页面。
2. 提取大纲中的核心内容作为 title 和 points。
3. 如果大纲中的要点过于简略,你可以适当润色扩写,但绝不能偏离原意。
4. 【格式要求】你必须且只能输出一个合法的 JSON 数组,不要输出任何解释性文字,绝对不要用 markdown 代码块包裹。
格式示例:
[
  {"title": "第一页标题", "points": ["要点1", "要点2"]},
  {"title": "第二页标题", "points": ["要点1", "要点2"]}
]"""

    user_prompt = f"这是我的PPT大纲:\n---\n{outline_content}\n---\n请基于以上大纲,生成完整的PPT结构化JSON数据。"

    try:
        response = client.chat.completions.create(
            model=llm_cfg['model_name'],
            messages=[
                {"role": "system", "content": system_prompt},
                {"role": "user", "content": user_prompt}
            ],
            temperature=llm_cfg['temperature'],
            max_tokens=llm_cfg['max_tokens']
        )
        raw_content = response.choices[0].message.content.strip()

        # ================= 强容错解析 =================
        # 1. 清洗可能存在的 Markdown 代码块标记
        content = re.sub(r'^```json\s*', '', raw_content)
        content = re.sub(r'^```\s*', '', content)
        content = re.sub(r'\s*```$', '', content)

        # 2. 核心:强制截取第一个 '[' 和最后一个 ']' 之间的内容
        # 这样可以无视模型在 JSON 前后输出的任何废话、思维链标记或乱码
        start_idx = content.find('[')
        end_idx = content.rfind(']')

        if start_idx != -1 and end_idx != -1 and end_idx > start_idx:
            json_str = content[start_idx:end_idx+1]
        else:
            # 如果连方括号都找不到,说明模型完全没有输出结构,直接报错
            print("❌ 模型输出中未找到合法的 JSON 数组标志 '[' 和 ']'")
            print(f"原始输出:\n{raw_content}")
            return None

        # 3. (新增) 去除 JSON 字符串内部可能混入的控制字符和不可见字符
        # 防止类似 \u200b (零宽空格) 等字符藏在 JSON 键名里导致解析失败
        json_str = re.sub(r'[\x00-\x1f\x7f-\x9f]', '', json_str)

        # 3. 解析 JSON
        data_list = json.loads(json_str)

        # 4. 使用 Pydantic 进行结构校验
        validated_data = PPTGenerationParams(slides=data_list)
        print("✅ 内容生成并校验成功!")
        return [slide.model_dump() for slide in validated_data.slides]

    except json.JSONDecodeError as e:
        print(f"❌ JSON 解析失败,模型可能输出了非法格式: {e}")
        print(f"原始输出:\n{raw_content}")
        return None
    except ValidationError as e:
        print(f"❌ 数据结构校验失败,模型输出的字段不符合要求: {e}")
        return None
    except Exception as e:
        print(f"❌ 调用 LLM 失败: {e}")
        return None

def set_chinese_font(run, font_name, font_size):
    """为文本块设置中文字体 (使用 lxml 原生操作,适配所有 python-pptx 版本)"""
    run.font.name = font_name
    run.font.size = font_size

    # 获取底层 rPr (文本属性) 节点
    rPr = run._r.get_or_add_rPr()

    # 尝试查找是否已存在东亚字体节点 <a:ea>
    ea = rPr.find(qn('a:ea'))

    if ea is None:
        # 如果不存在,使用 lxml 原生方法直接创建子节点
        ea = etree.SubElement(rPr, qn('a:ea'))

    # 设置 typeface 属性为指定的中文字体
    ea.set('typeface', font_name)

def create_ppt_file(slides_data: list, filename: str):
    """将 JSON 数据渲染为 PPT 文件"""
    print(f"🎨 正在渲染 PPT 文件...")
    ppt_cfg = CONFIG['ppt_settings']
    font_name = ppt_cfg['font_name']
    title_size = Pt(ppt_cfg['title_font_size'])
    body_size = Pt(ppt_cfg['body_font_size'])
    spacing = Pt(ppt_cfg['paragraph_spacing'])

    prs = Presentation()
    prs.slide_width = Inches(ppt_cfg['slide_width'])
    prs.slide_height = Inches(ppt_cfg['slide_height'])

    for slide_info in slides_data:
        title = slide_info.get("title", "无标题")
        points = slide_info.get("points", [])

        # 使用"标题和内容"布局
        slide_layout = prs.slide_layouts[1]
        slide = prs.slides.add_slide(slide_layout)

        # 渲染标题
        title_shape = slide.shapes.title
        title_shape.text = ""
        p = title_shape.text_frame.paragraphs[0]
        p.alignment = PP_ALIGN.LEFT
        run = p.add_run()
        run.text = title
        set_chinese_font(run, font_name, title_size)

        # 渲染正文
        body_shape = slide.shapes.placeholders[1]
        tf = body_shape.text_frame
        tf.clear()

        for i, point in enumerate(points):
            if i == 0:
                p = tf.paragraphs[0]
            else:
                p = tf.add_paragraph()

            p.space_before = spacing
            p.space_after = spacing
            p.level = 0

            run = p.add_run()
            run.text = point
            set_chinese_font(run, font_name, body_size)

    output_dir = ppt_cfg['output_dir']
    os.makedirs(output_dir, exist_ok=True)
    filepath = os.path.join(output_dir, filename)
    prs.save(filepath)
    print(f"🎉 PPT 已成功保存至: {os.path.abspath(filepath)}")

if __name__ == "__main__":
    outline_file = CONFIG.get('outline_file', 'content.txt')
    outline_content = read_outline(outline_file)
    print(f"📄 已读取大纲文件,共 {len(outline_content)} 字符。")

    slides = generate_ppt_content(outline_content)

    if slides:
        safe_filename = re.sub(r'[\\/:*?"<>|]', '', "output") + ".pptx"
        create_ppt_file(slides, filename=safe_filename)
    else:
        print("生成中断,请检查上方错误信息后重试。")
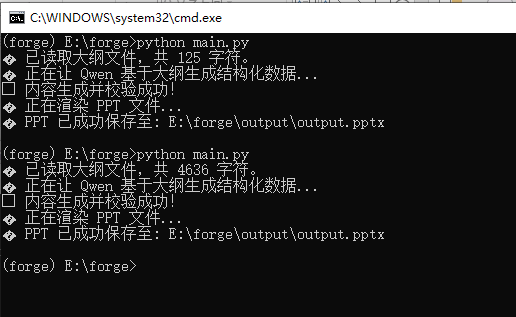
测试时,content.txt里的内容尽量短少,生成PPT成功后再用全部内容,避免浪费。
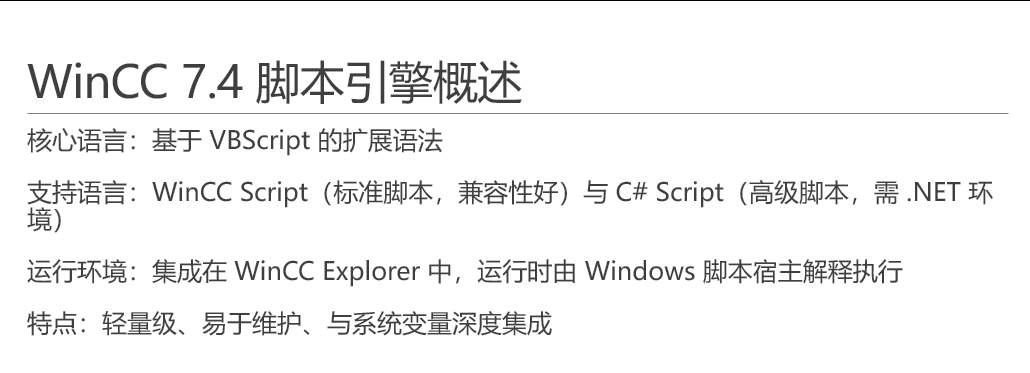
生成PPT的效果
不咋样,就是糊弄糊弄差事,正儿八经的讲课得润色。
本地纯CPU llama.cpp 9t/s,还是Phi-4-mini 尺寸2.65G。如果本地