题目描述
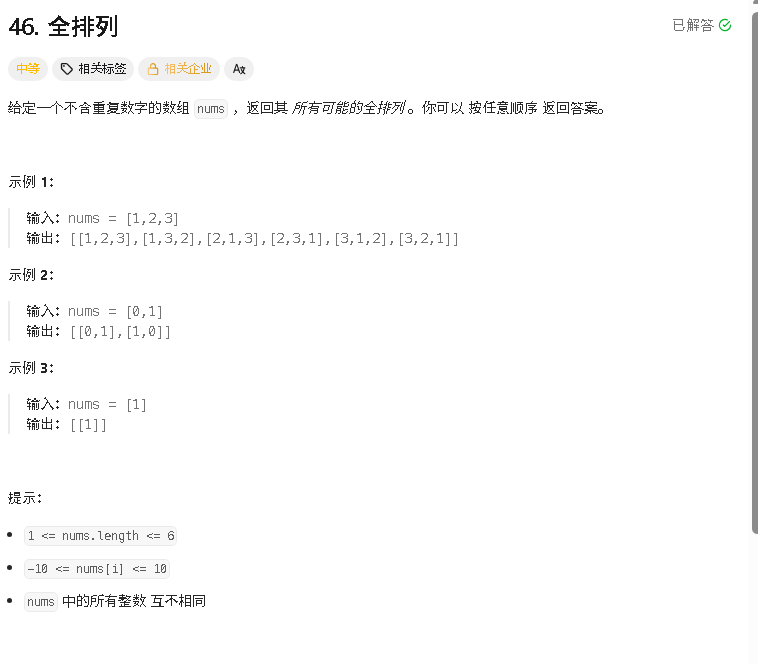
给定一个不含重复数字的数组 nums ,返回其 所有可能的全排列 。你可以 按任意顺序 返回答案。
示例 1:
输入:nums = [1,2,3]
输出:[[1,2,3],[1,3,2],[2,1,3],[2,3,1],[3,1,2],[3,2,1]]
示例 2:
输入:nums = [0,1]
输出:[[0,1],[1,0]]
示例 3:
输入:nums = [1]
输出:[[1]]
提示:
- 1 <= nums.length <= 6
- -10 <= numsi <= 10
- nums 中的所有整数 互不相同
解题思路
全排列问题是回溯算法的经典入门题目,核心是穷举所有可能的元素排列顺序。下面我们将详细讲解两种最常用的解法:基于 used 数组标记的回溯法和基于原地交换的优化回溯法。
方法一:回溯法(used 数组标记)
思路分析
回溯法的核心思想是 "选择 - 递归 - 回溯"。对于全排列问题,我们需要从数组中依次选择未被使用过的元素,加入当前排列路径,直到路径长度等于数组长度,得到一个完整的排列。然后回溯撤销选择,尝试其他可能的元素。
具体来说:
- 维护一个当前排列
path和一个布尔数组used,used[i]表示数组中第 i 个元素是否已被使用 - 遍历数组中的每个元素,如果该元素未被使用,则:
- 将其标记为已使用
- 加入当前排列
path - 递归处理下一个位置
- 递归返回后,从
path中移除该元素(回溯) - 将其标记为未使用
- 当
path的长度等于数组长度时,将path加入结果集
代码实现(C++)
#include <vector>
using namespace std;

class Solution {
private:
    vector<vector<int>> result; // 存储所有全排列结果
    vector<int> path;           // 存储当前正在构建的排列

    void backtracking(vector<int>& nums, vector<bool>& used) {
        // 终止条件:当前排列长度等于数组长度,得到一个完整排列
        if (path.size() == nums.size()) {
            result.push_back(path);
            return;
        }

        // 遍历所有元素,选择未被使用的
        for (int i = 0; i < nums.size(); i++) {
            if (used[i]) continue; // 已使用的元素跳过

            used[i] = true;               // 标记为已使用
            path.push_back(nums[i]);      // 加入当前排列
            backtracking(nums, used);     // 递归处理下一个位置
            path.pop_back();              // 回溯,撤销选择
            used[i] = false;              // 取消标记
        }
    }

public:
    vector<vector<int>> permute(vector<int>& nums) {
        result.clear();
        path.clear();
        vector<bool> used(nums.size(), false);
        backtracking(nums, used);
        return result;
    }
};
复杂度分析
- 时间复杂度:\(O(n \times n!)\)。共有 \(n!\) 种不同的全排列,每个排列需要 \(O(n)\) 的时间复制到结果集中。
- 空间复杂度 :\(O(n)\)。递归调用栈的深度为 n,同时
path数组和used数组的大小均为 n。
方法二:回溯法(原地交换优化)
思路分析
这种方法不需要额外的used数组来标记已使用的元素,而是通过交换数组元素的方式,将已选择的元素 "固定" 在当前位置,从而避免重复选择。
具体来说:
- 维护一个起始索引
start,表示当前正在处理的位置 - 从
start开始遍历数组,将每个元素与start位置的元素交换(相当于选择该元素作为当前位置的元素) - 递归处理下一个位置(
start + 1) - 递归返回后,将元素交换回来(回溯)
- 当
start等于数组长度时,将当前数组加入结果集
代码实现(C++)
#include <vector>
#include <algorithm> // 用于swap函数
using namespace std;

class Solution {
private:
    vector<vector<int>> result; // 存储所有全排列结果

    void backtracking(vector<int>& nums, int start) {
        // 终止条件:处理完所有位置,得到一个完整排列
        if (start == nums.size()) {
            result.push_back(nums);
            return;
        }

        // 从start开始遍历,选择当前位置的元素
        for (int i = start; i < nums.size(); i++) {
            swap(nums[start], nums[i]);    // 选择第i个元素作为当前位置的元素
            backtracking(nums, start + 1); // 递归处理下一个位置
            swap(nums[start], nums[i]);    // 回溯,交换回来
        }
    }

public:
    vector<vector<int>> permute(vector<int>& nums) {
        result.clear();
        backtracking(nums, 0);
        return result;
    }
};
复杂度分析
- 时间复杂度:\(O(n \times n!)\)。与方法一相同,共有 \(n!\) 种排列,每个排列需要 \(O(n)\) 时间复制。
- 空间复杂度 :\(O(n)\)。递归调用栈的深度为 n,不需要额外的
used数组,空间效率略高于方法一。
两种方法对比
| 方法 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| used 数组标记法 | 逻辑清晰,易于理解,不易出错 | 需要额外的布尔数组空间 | 初学者入门,面试答题(不易写错) |
| 原地交换法 | 节省空间,代码更简洁 | 生成的排列顺序与输入顺序不同,逻辑稍抽象 | 追求空间效率,熟悉回溯思想后使用 |
总结
全排列问题是回溯算法的标杆题目,掌握这两种解法对于理解回溯算法的核心思想至关重要。
- used 数组标记法是最直观的写法,通过显式标记已使用的元素,逻辑清晰,面试时优先推荐使用
- 原地交换法通过交换元素实现标记,节省了额外的空间,但需要注意交换和回溯的顺序
- 与子集问题不同,全排列问题每次都需要遍历所有未使用的元素,而不是从某个起始索引开始,这是两者最核心的区别