台大李宏毅老师讲解memba和类似linear atttenion 模型,笔记

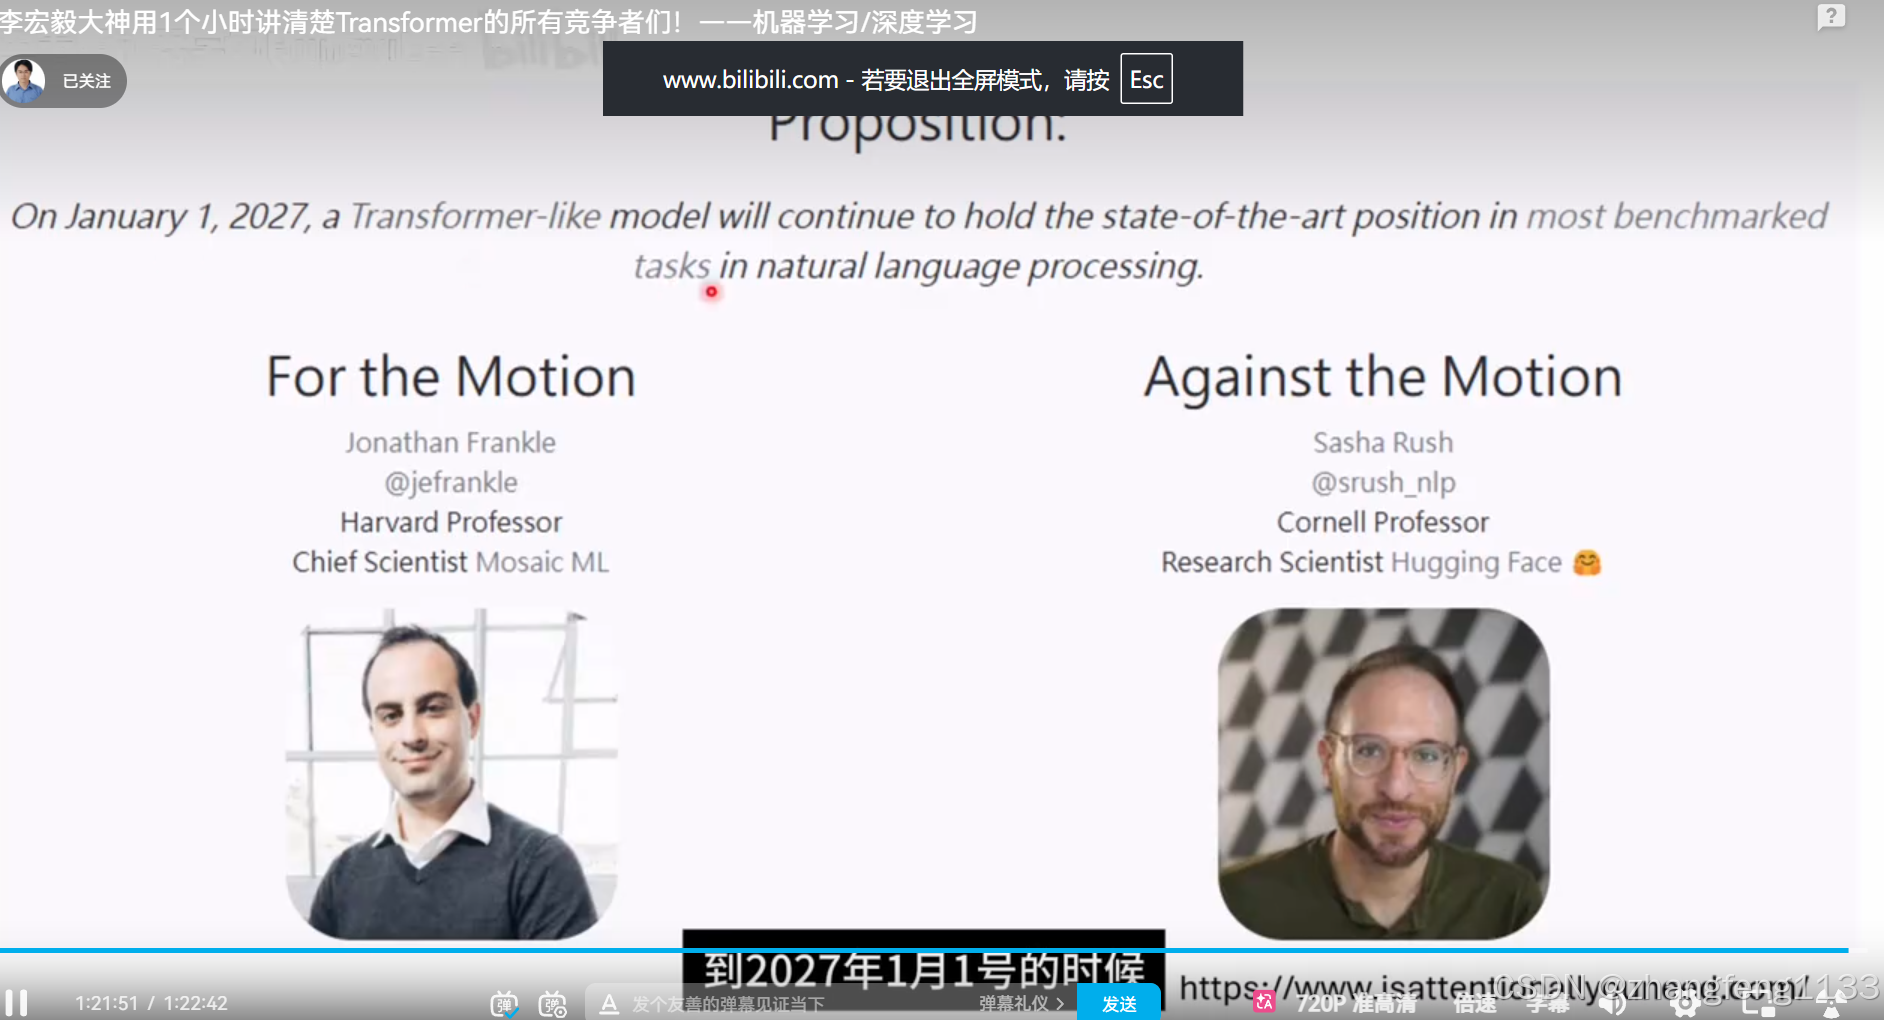
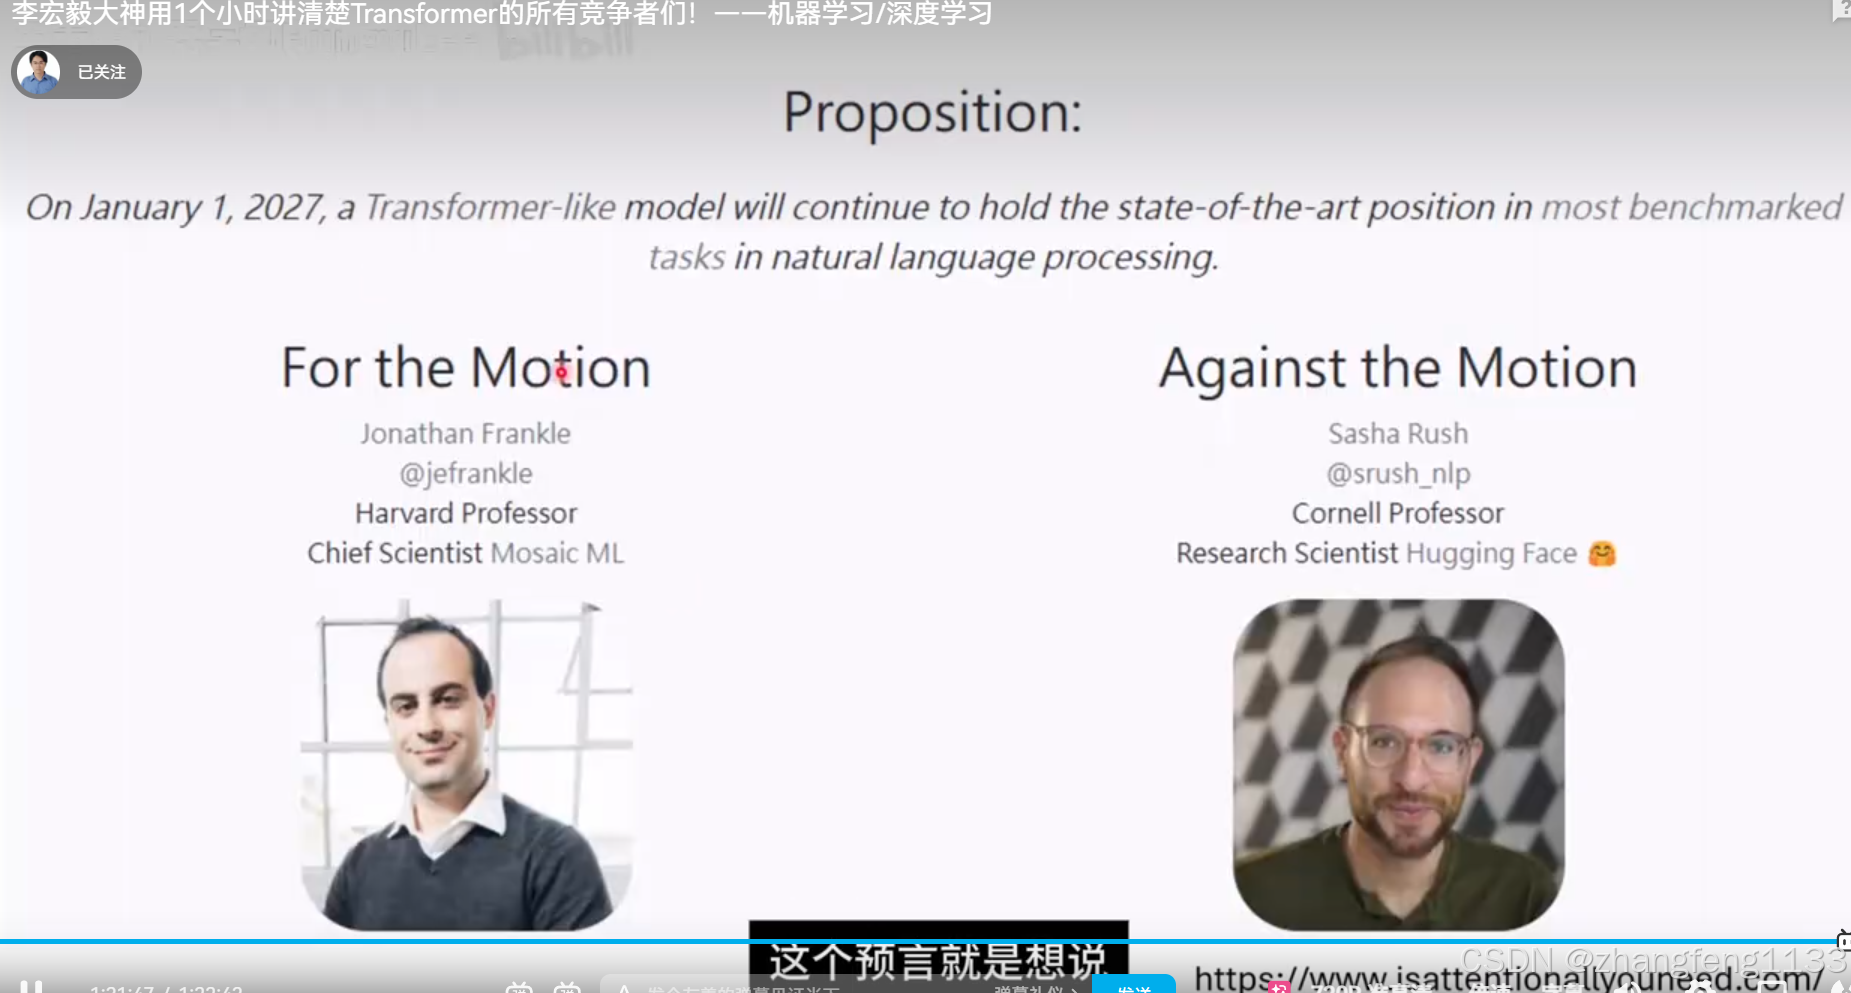
还有外国人还是会万玩, du公司股份,看 2027年 transformer 还是霸榜

可以使用bili2text工具从指定B站视频中根据语音提取文字资料,该工具输入链接即可使用,免费且能一步到位地实现Bilibili视频转文字。其项目地址为:https://gitcode.com/gh_mirrors/bi/bili2text
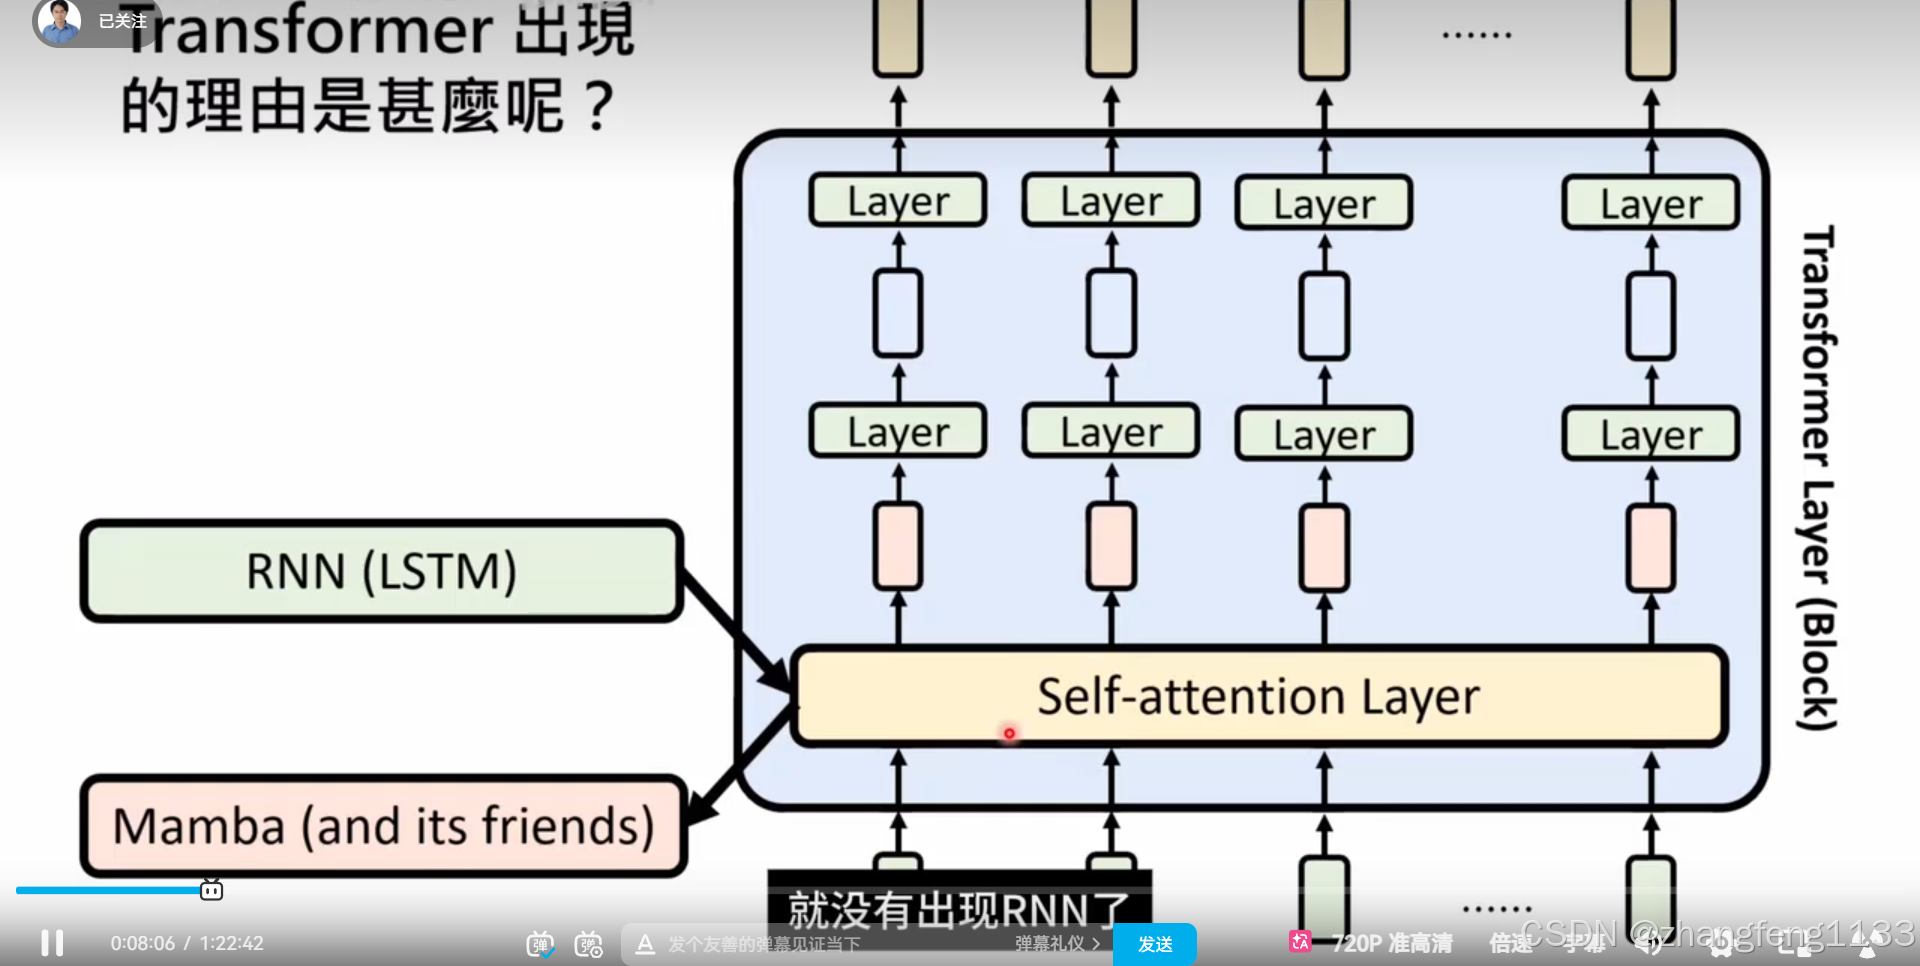
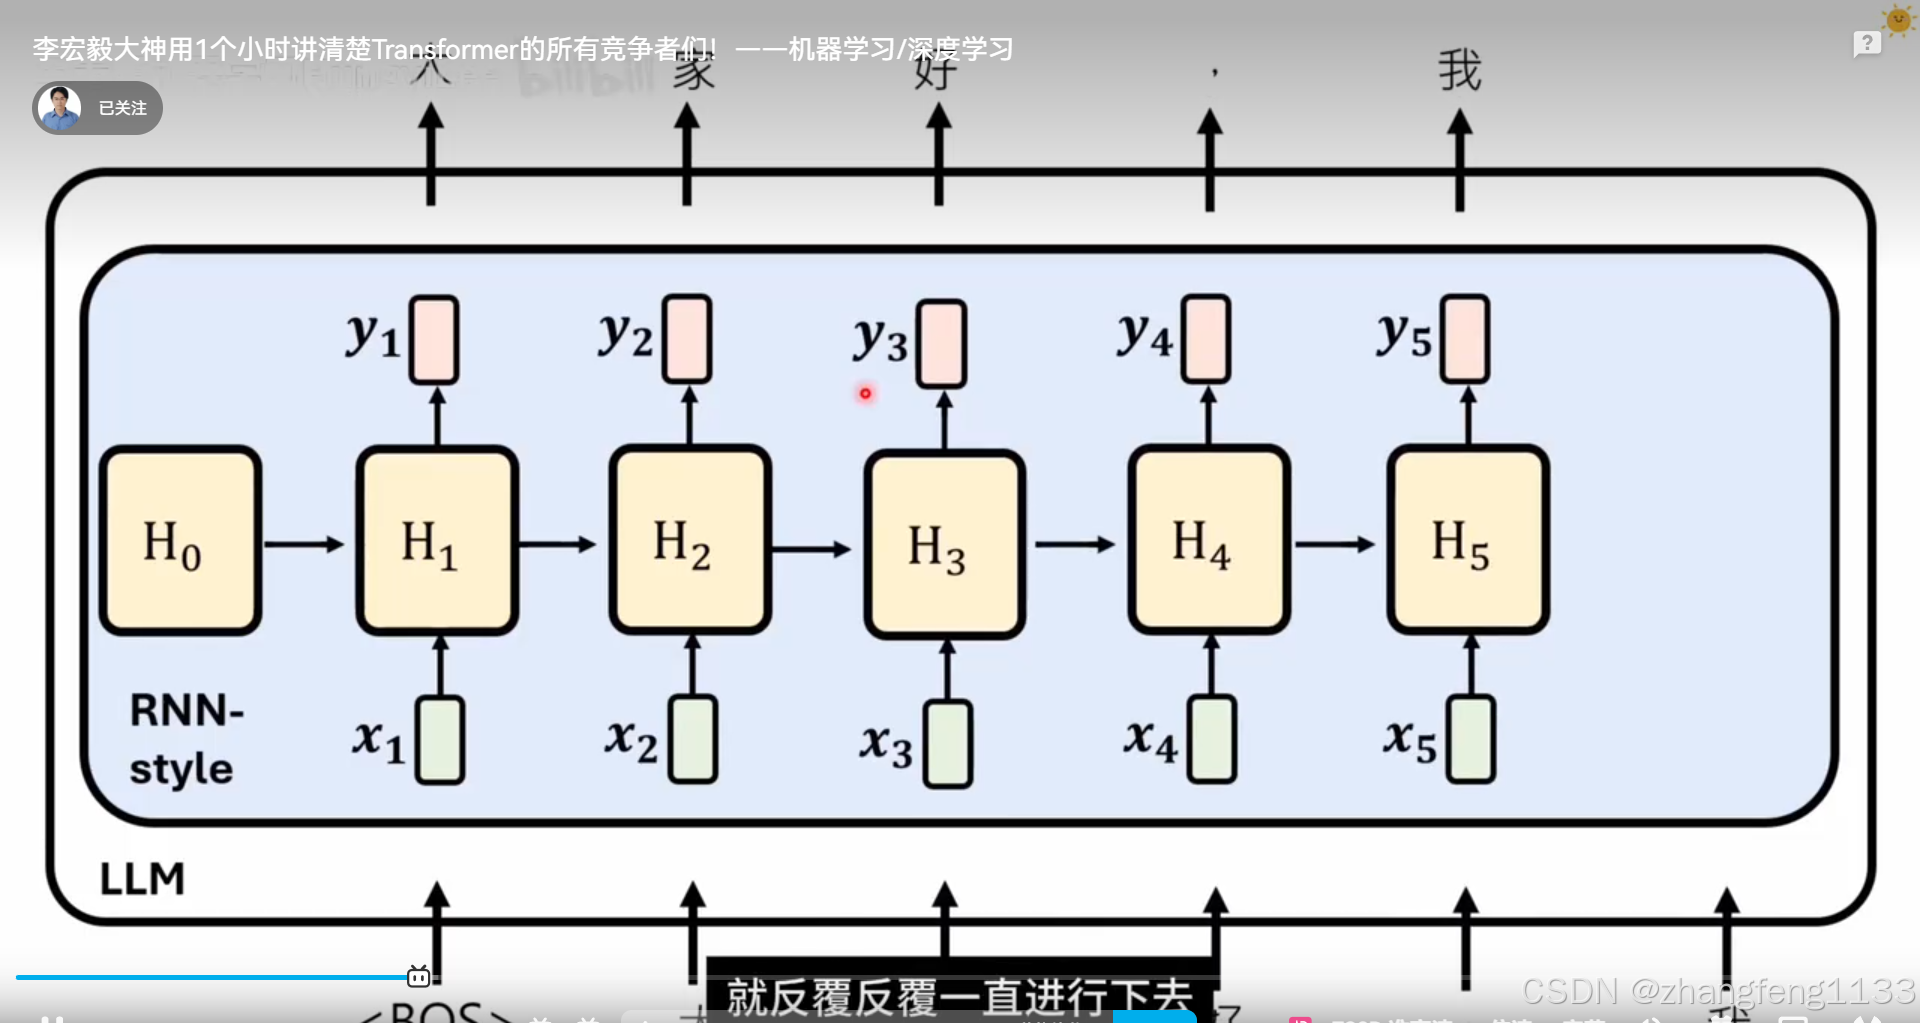
memba 通过RNN讲解 ,而不是从工程学的smm 角度讲解

每一个模型为了解决一个问题,存在都有他的理由

残差网络
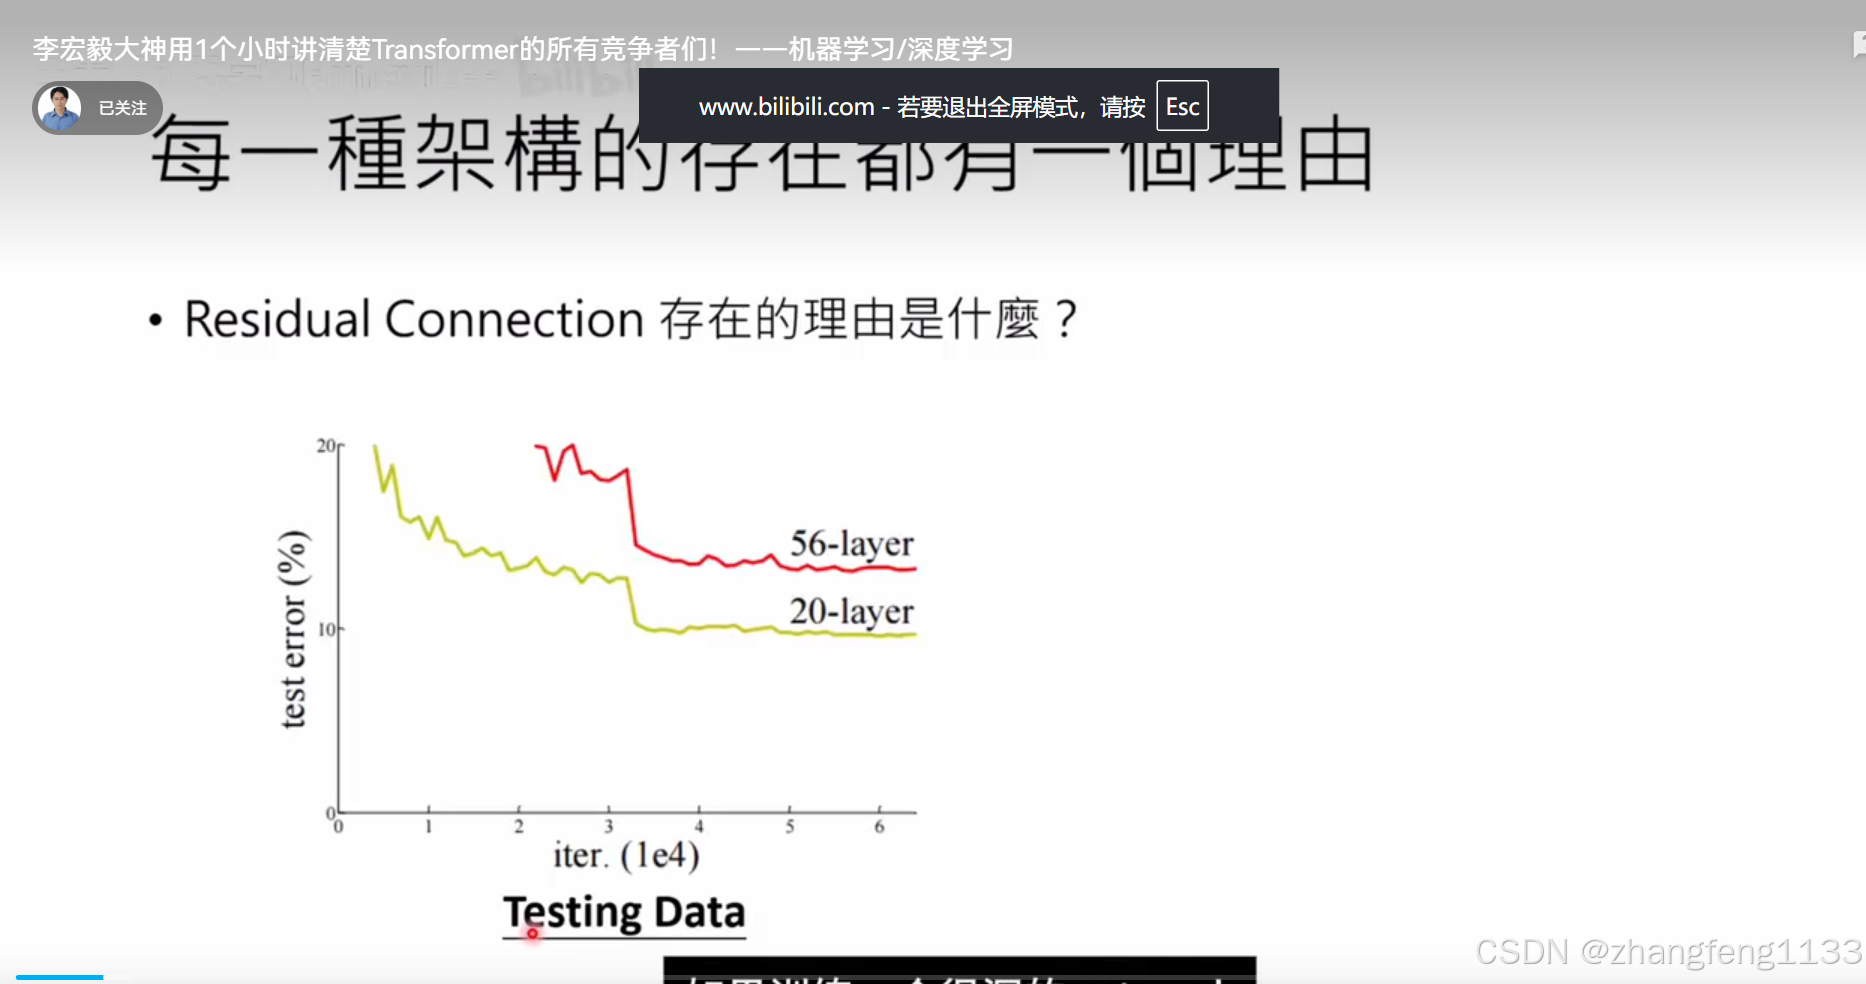
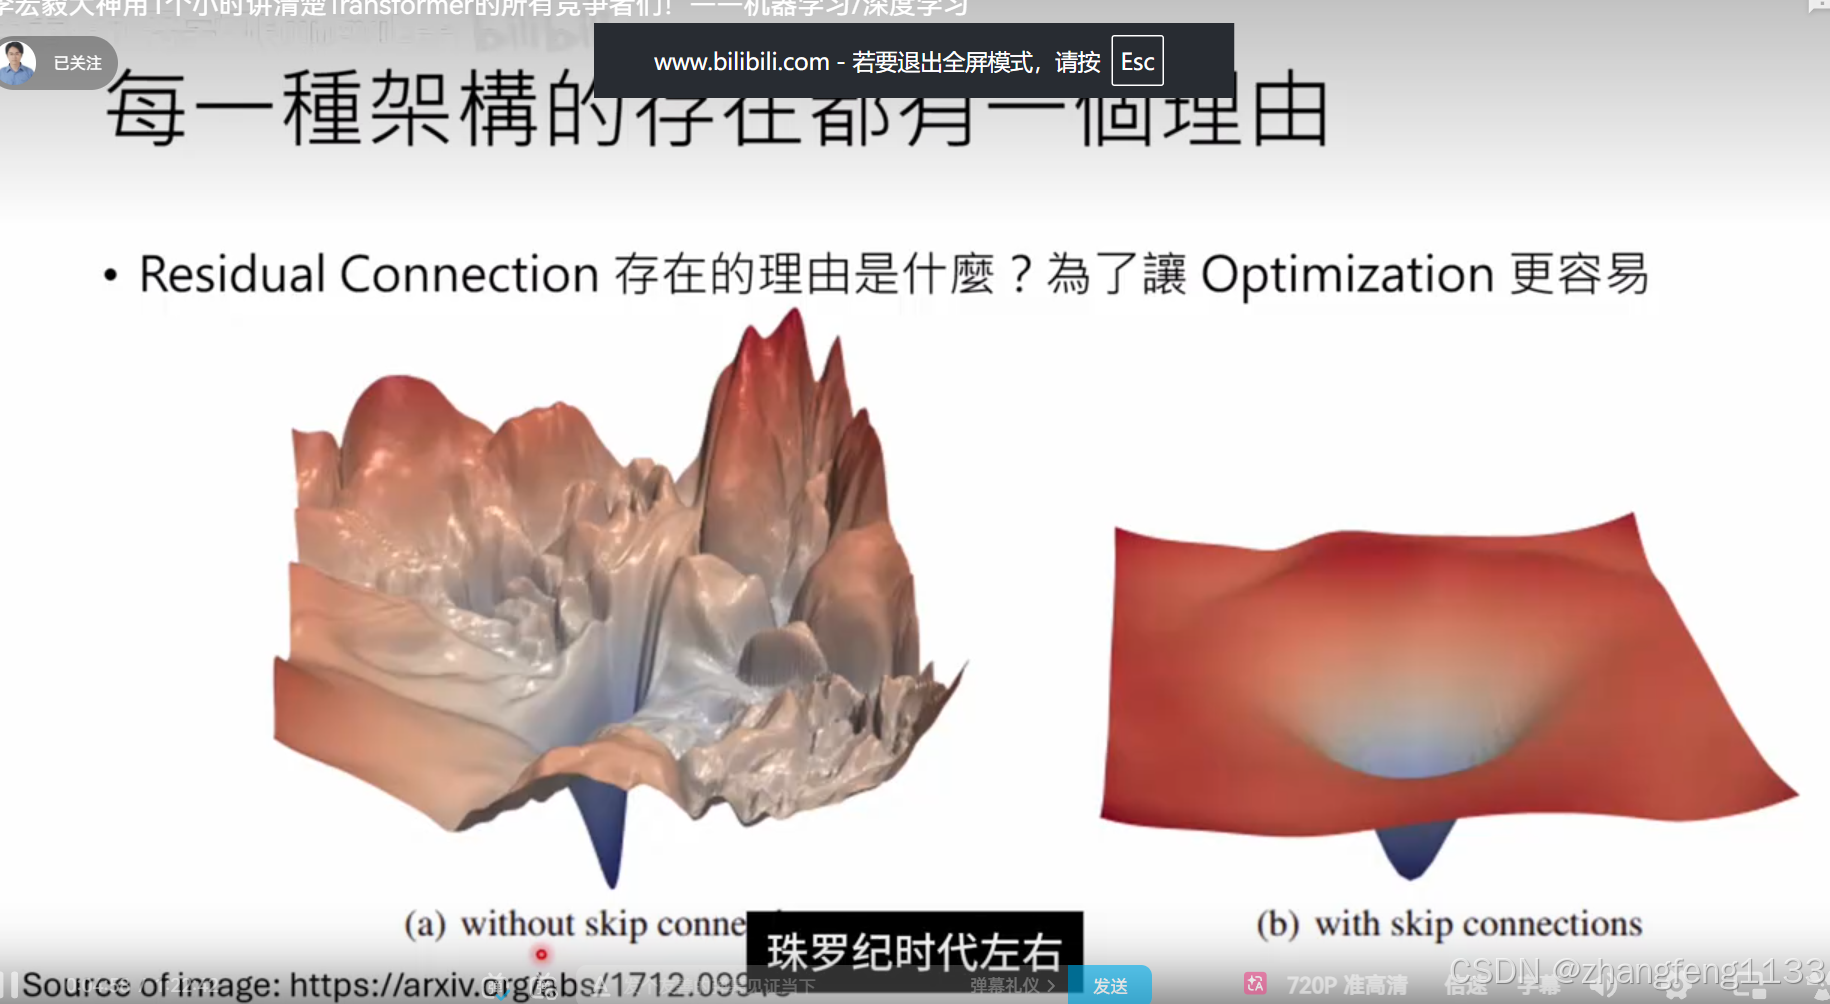
解释为什么要有残差网络,提供了可视化 loss变化
self-attenion
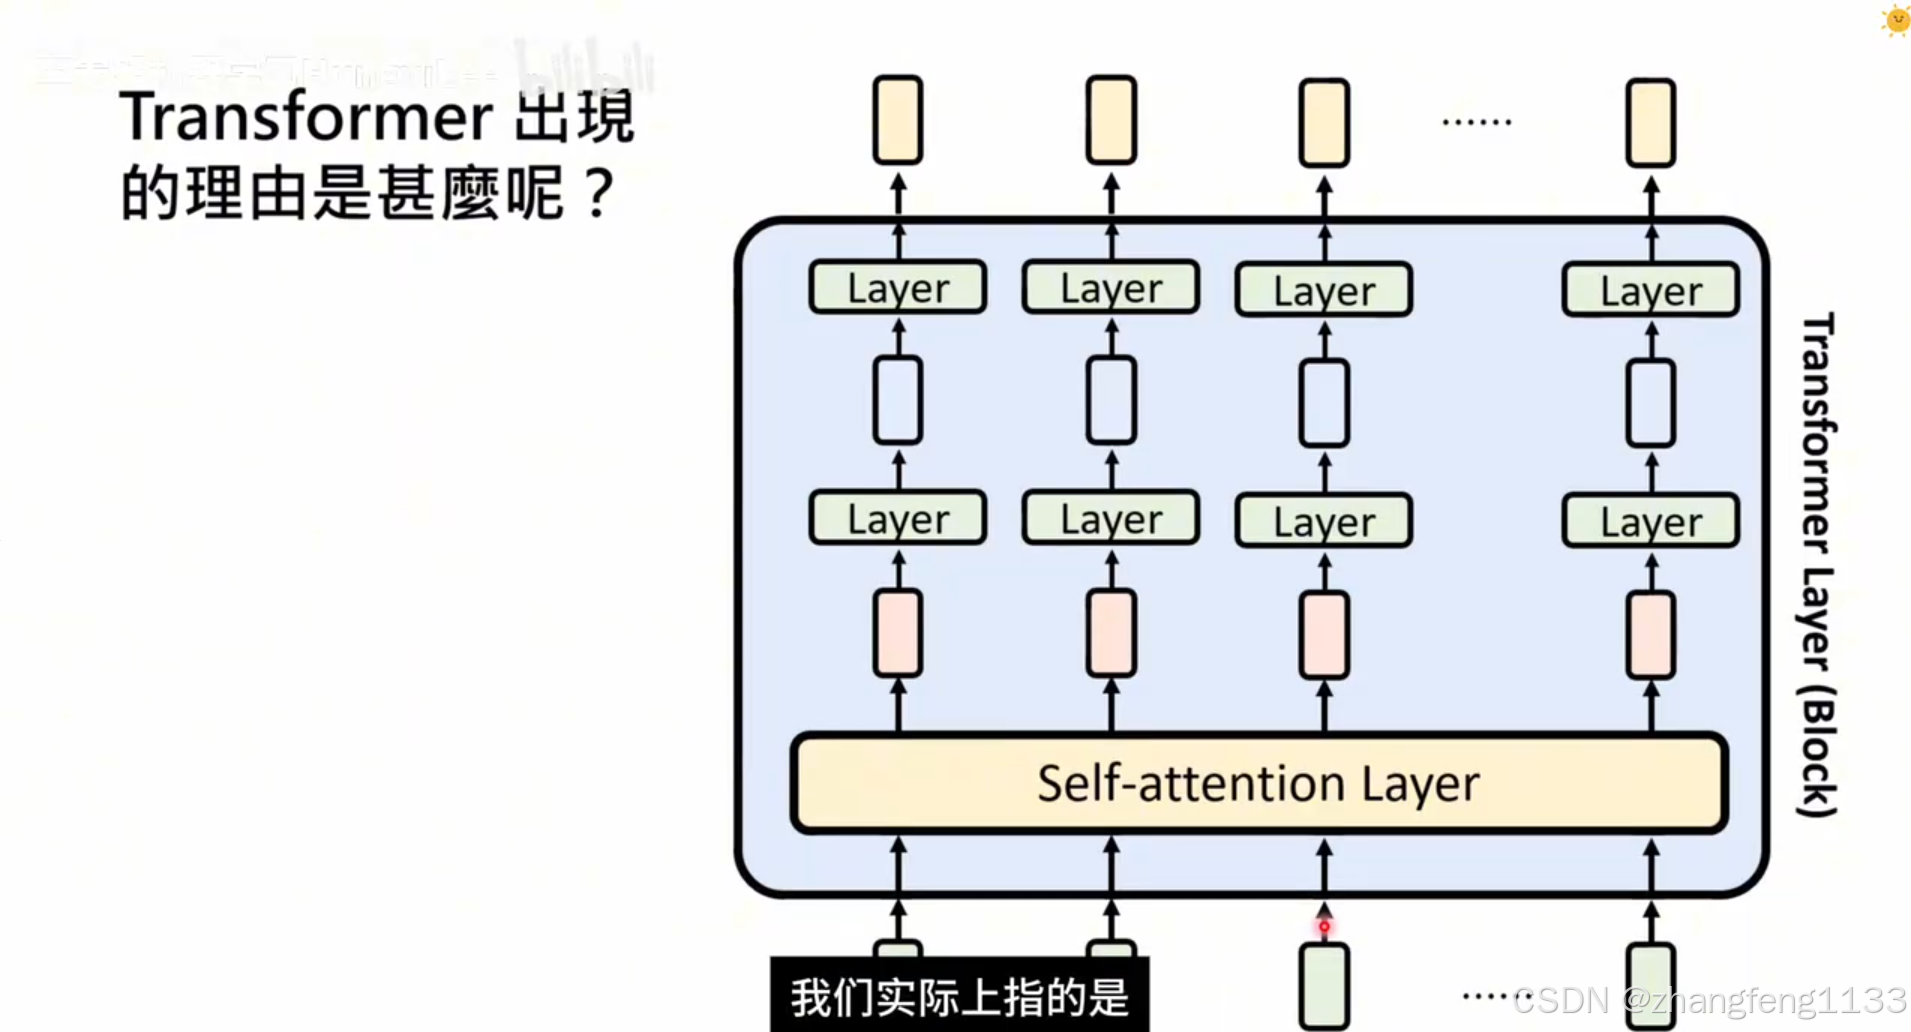
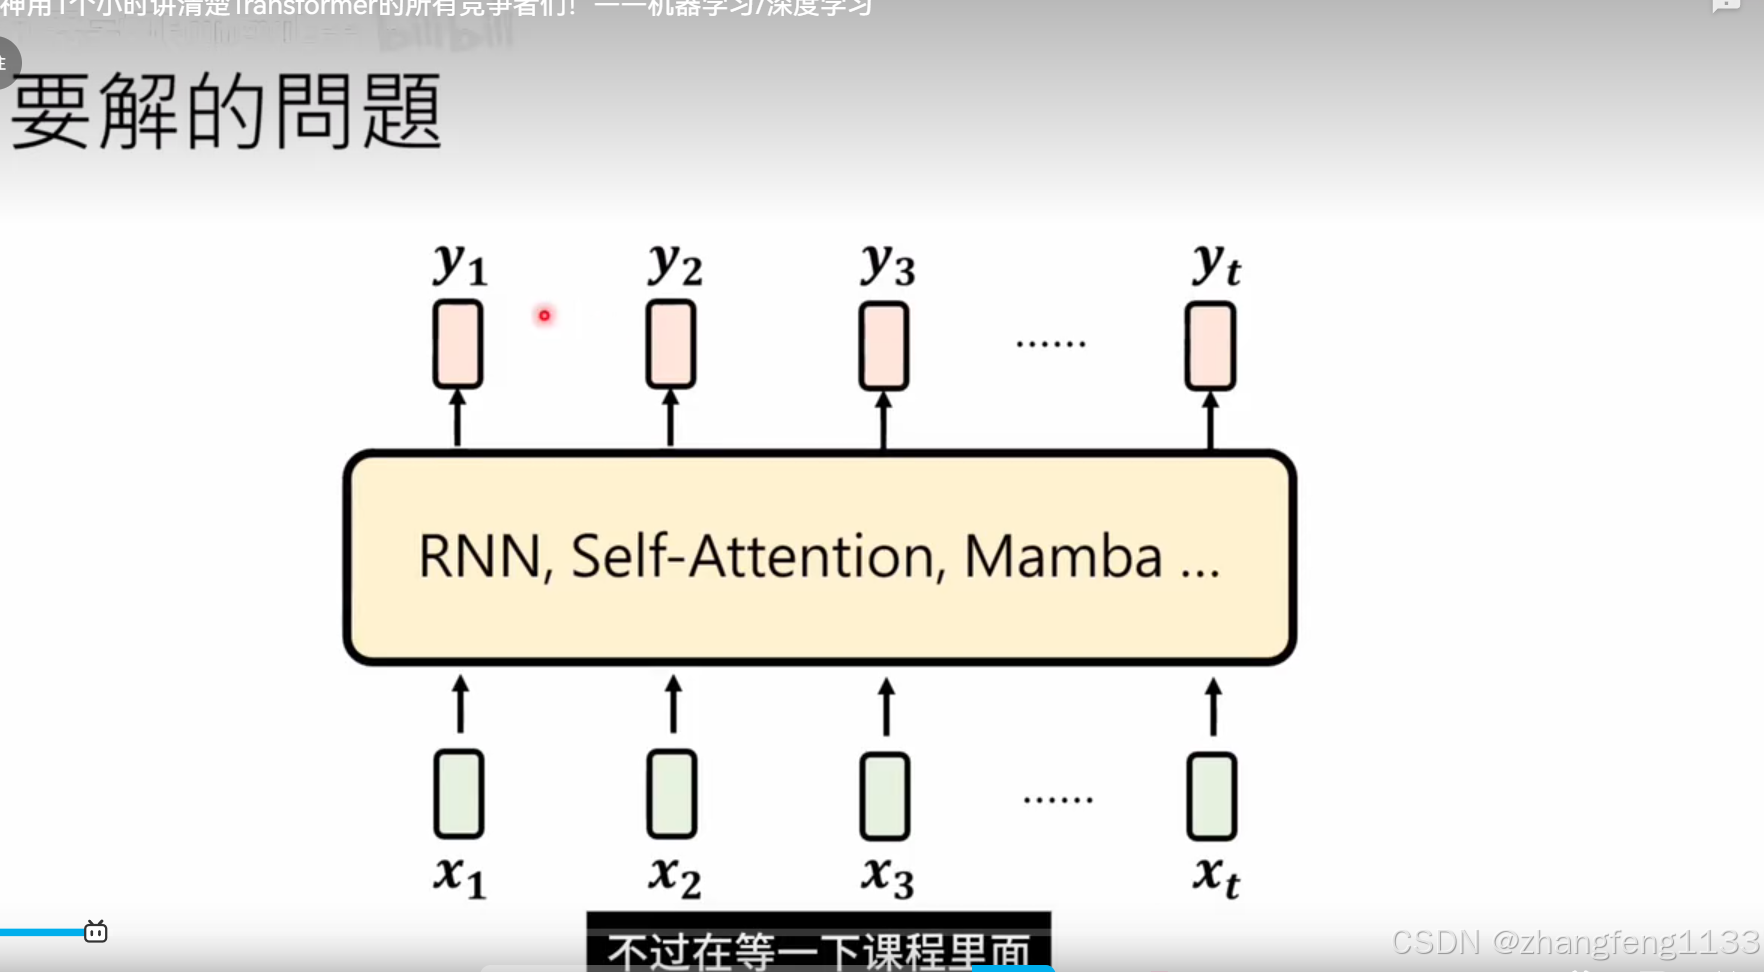
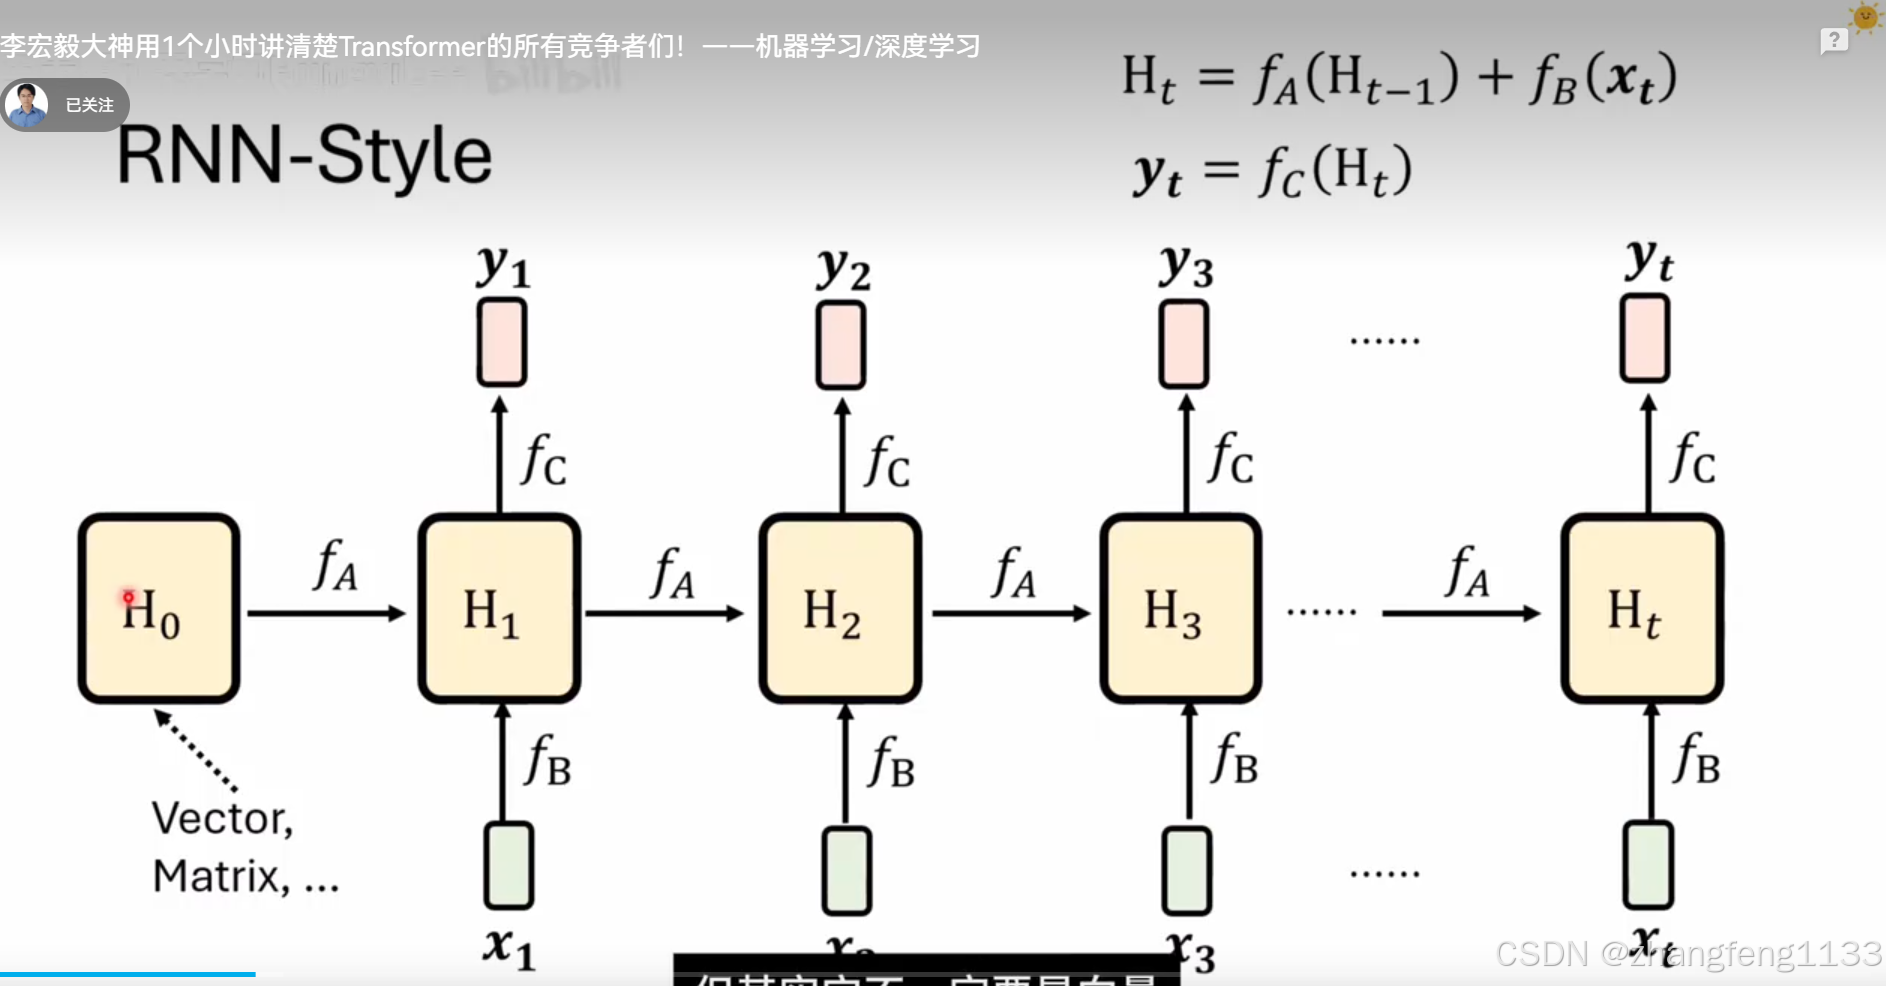
RNN
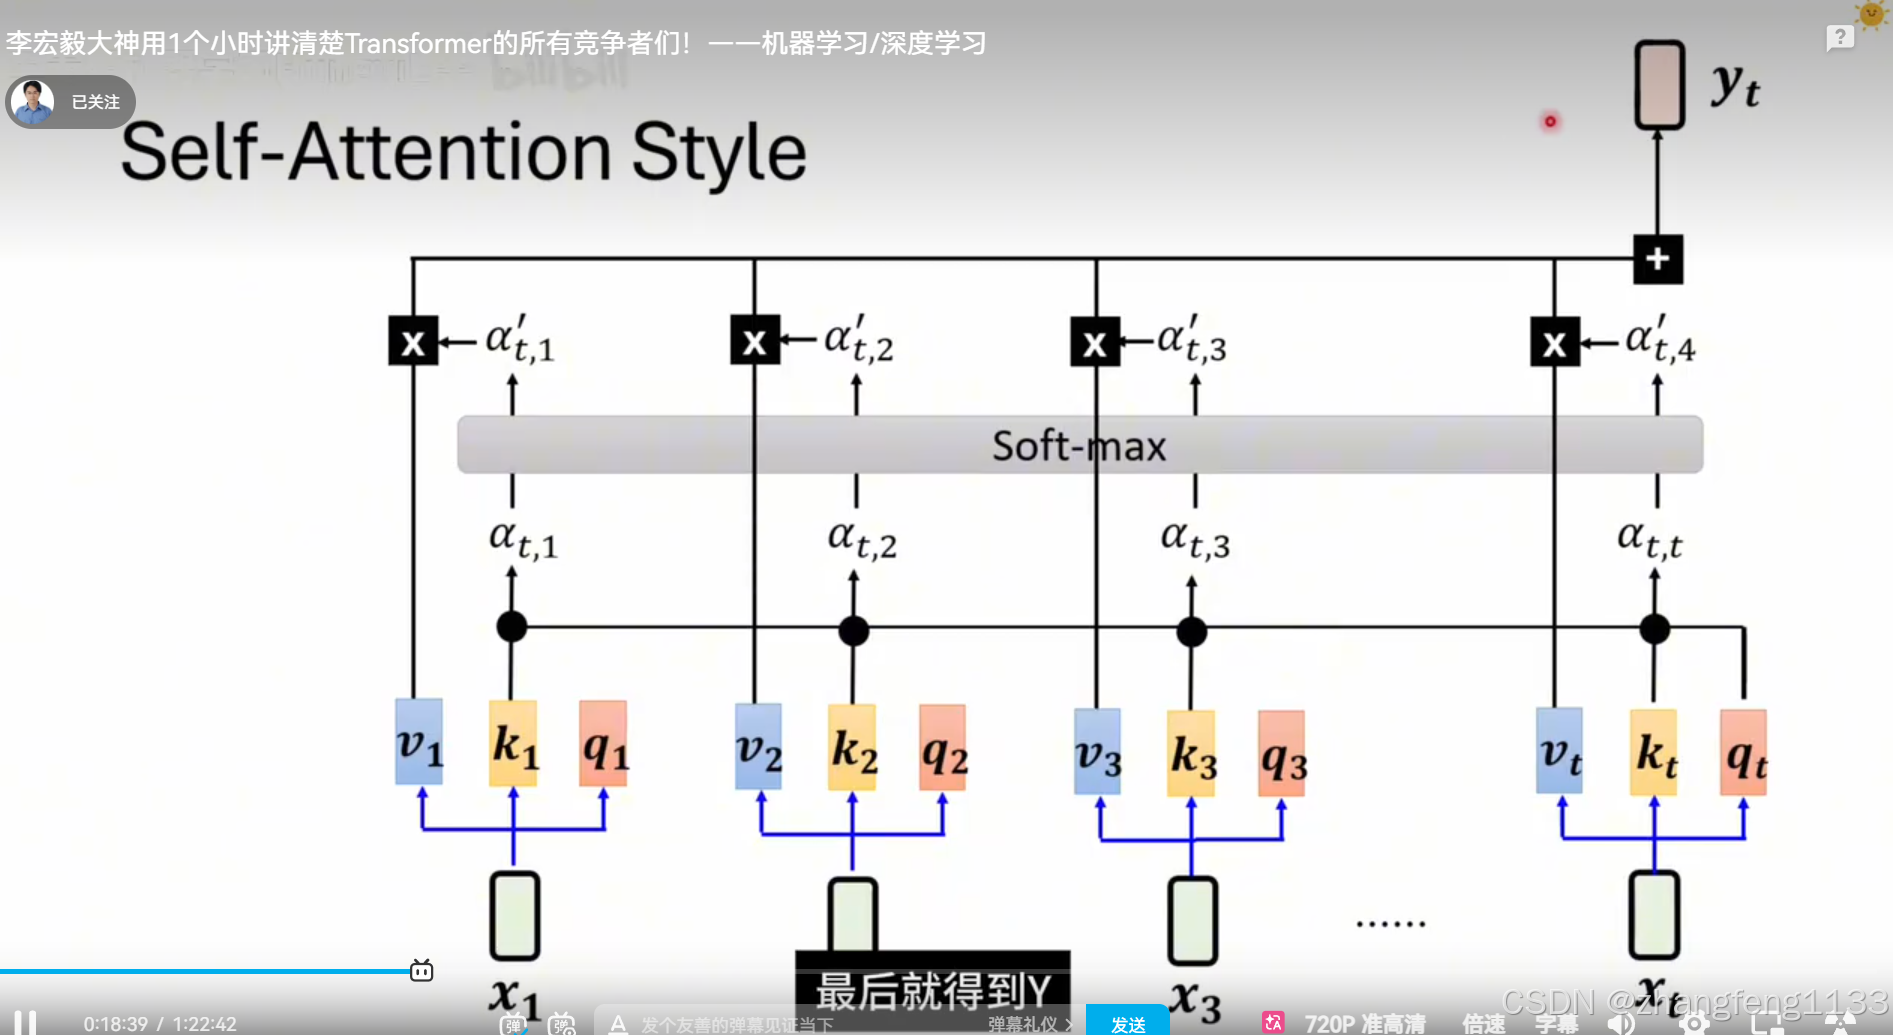
self-attention
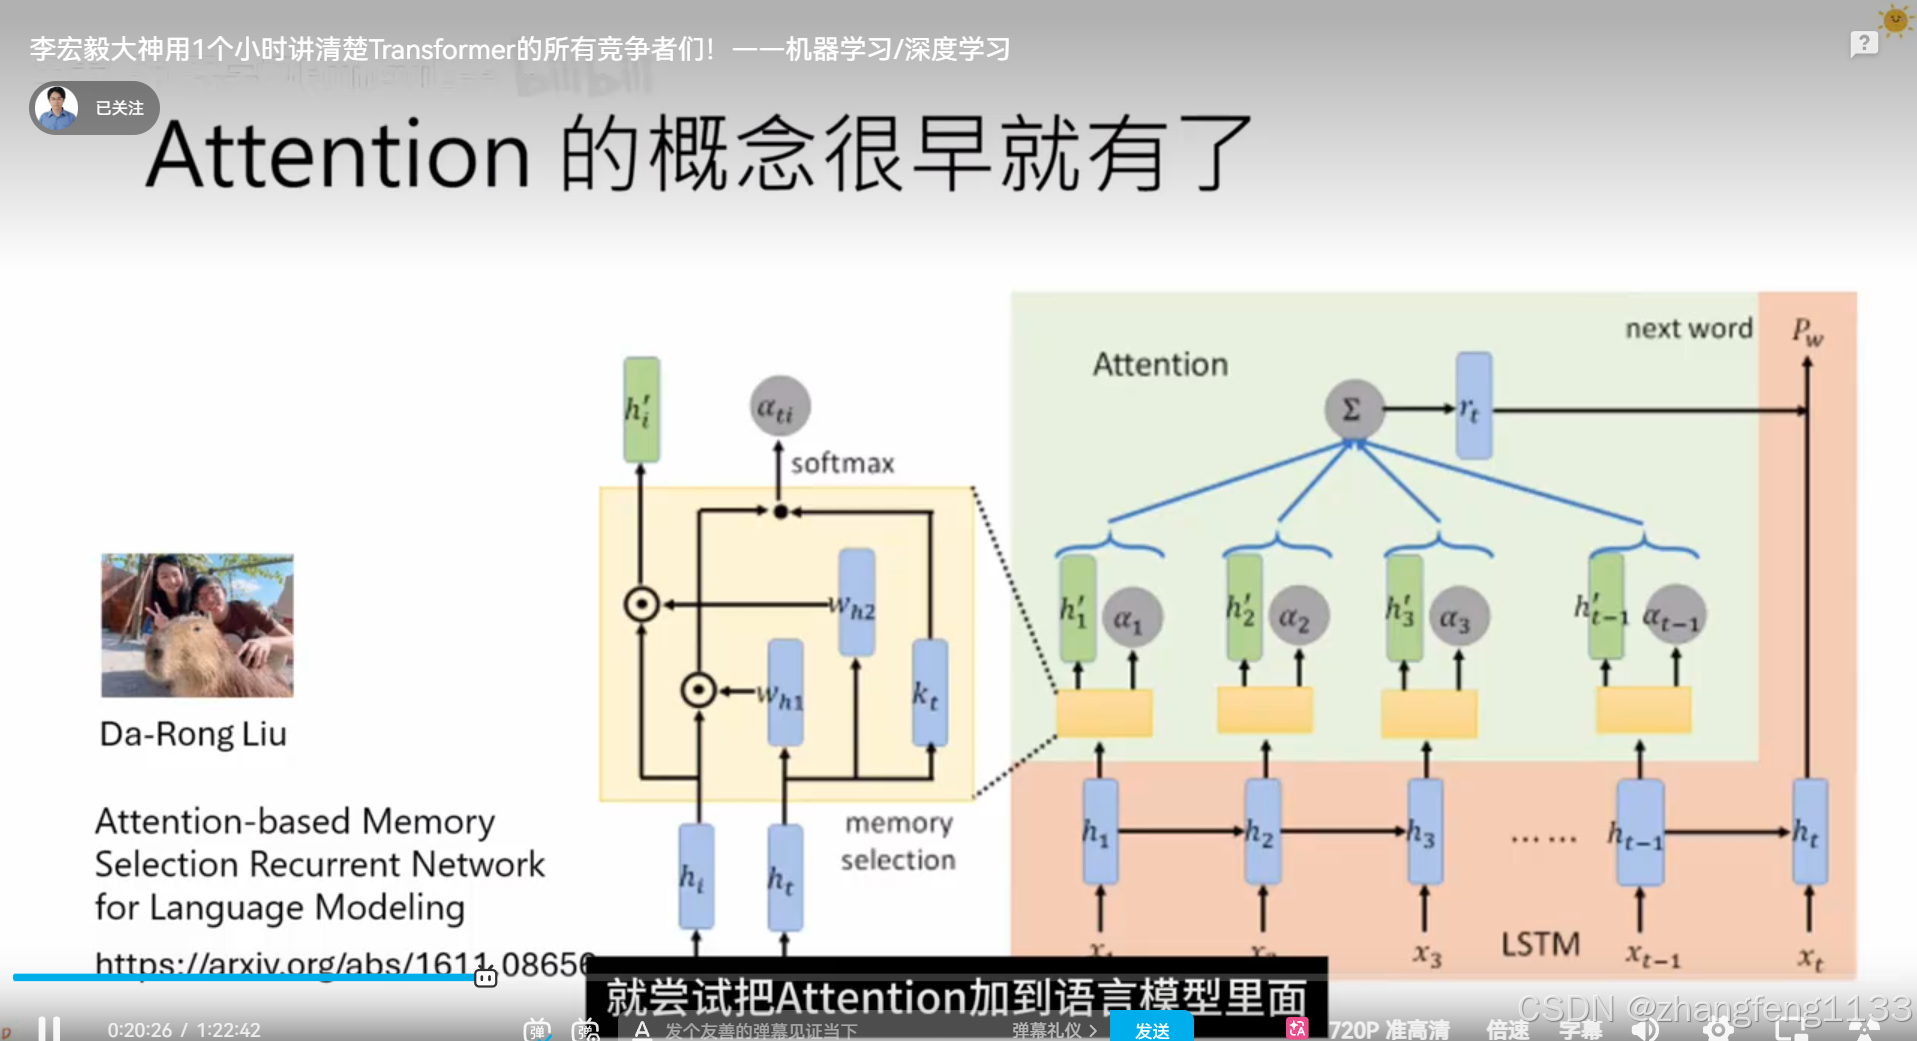
\\
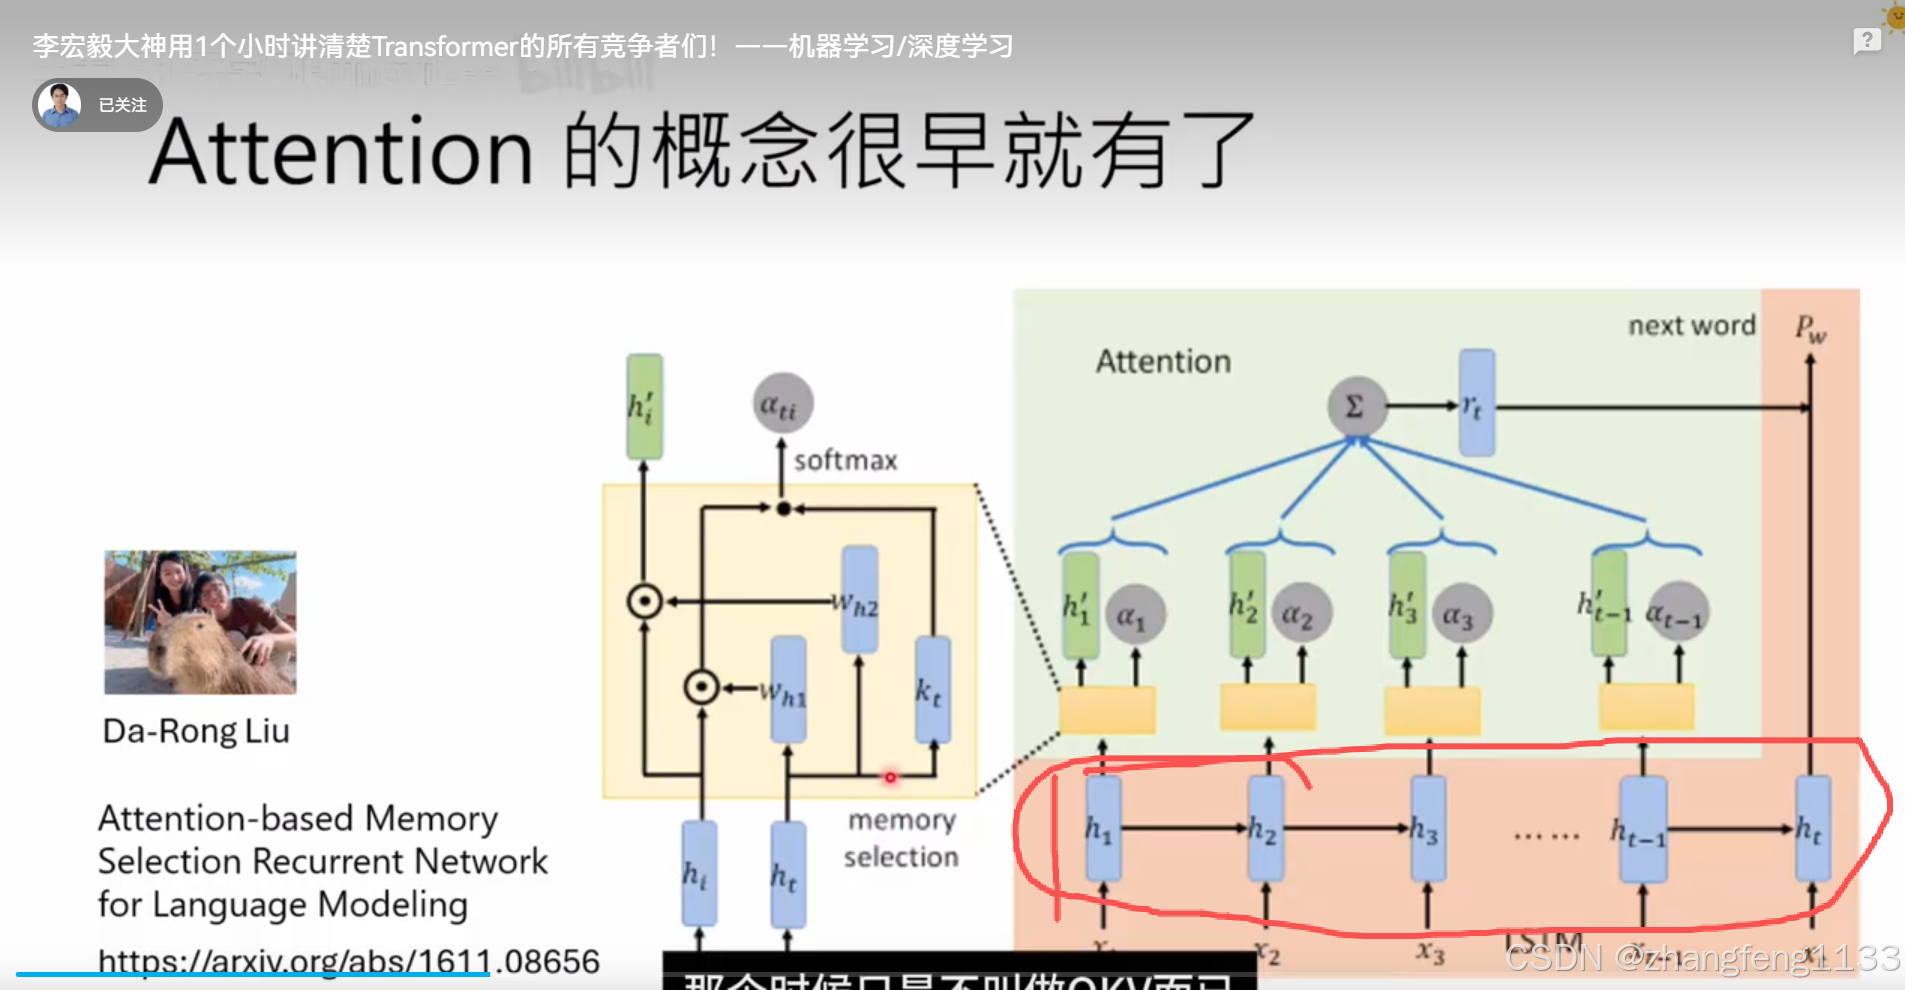
### selft-attenion
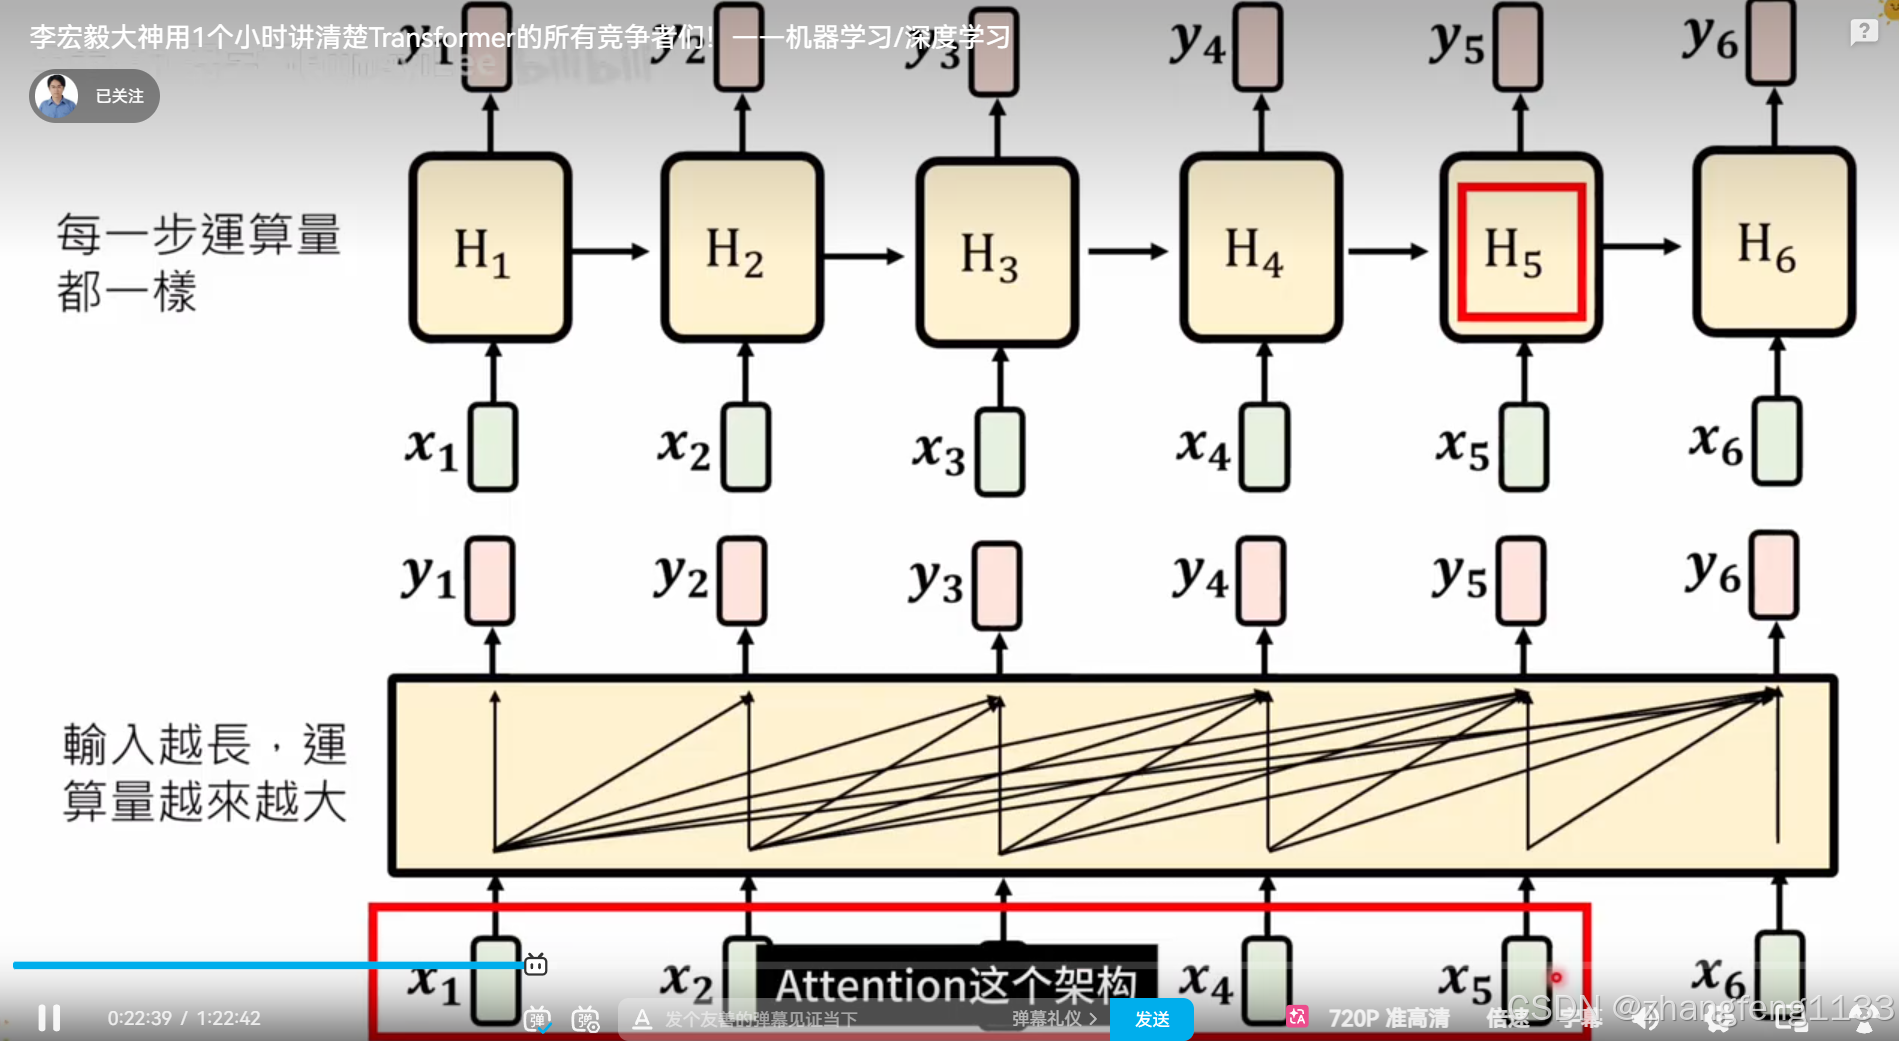
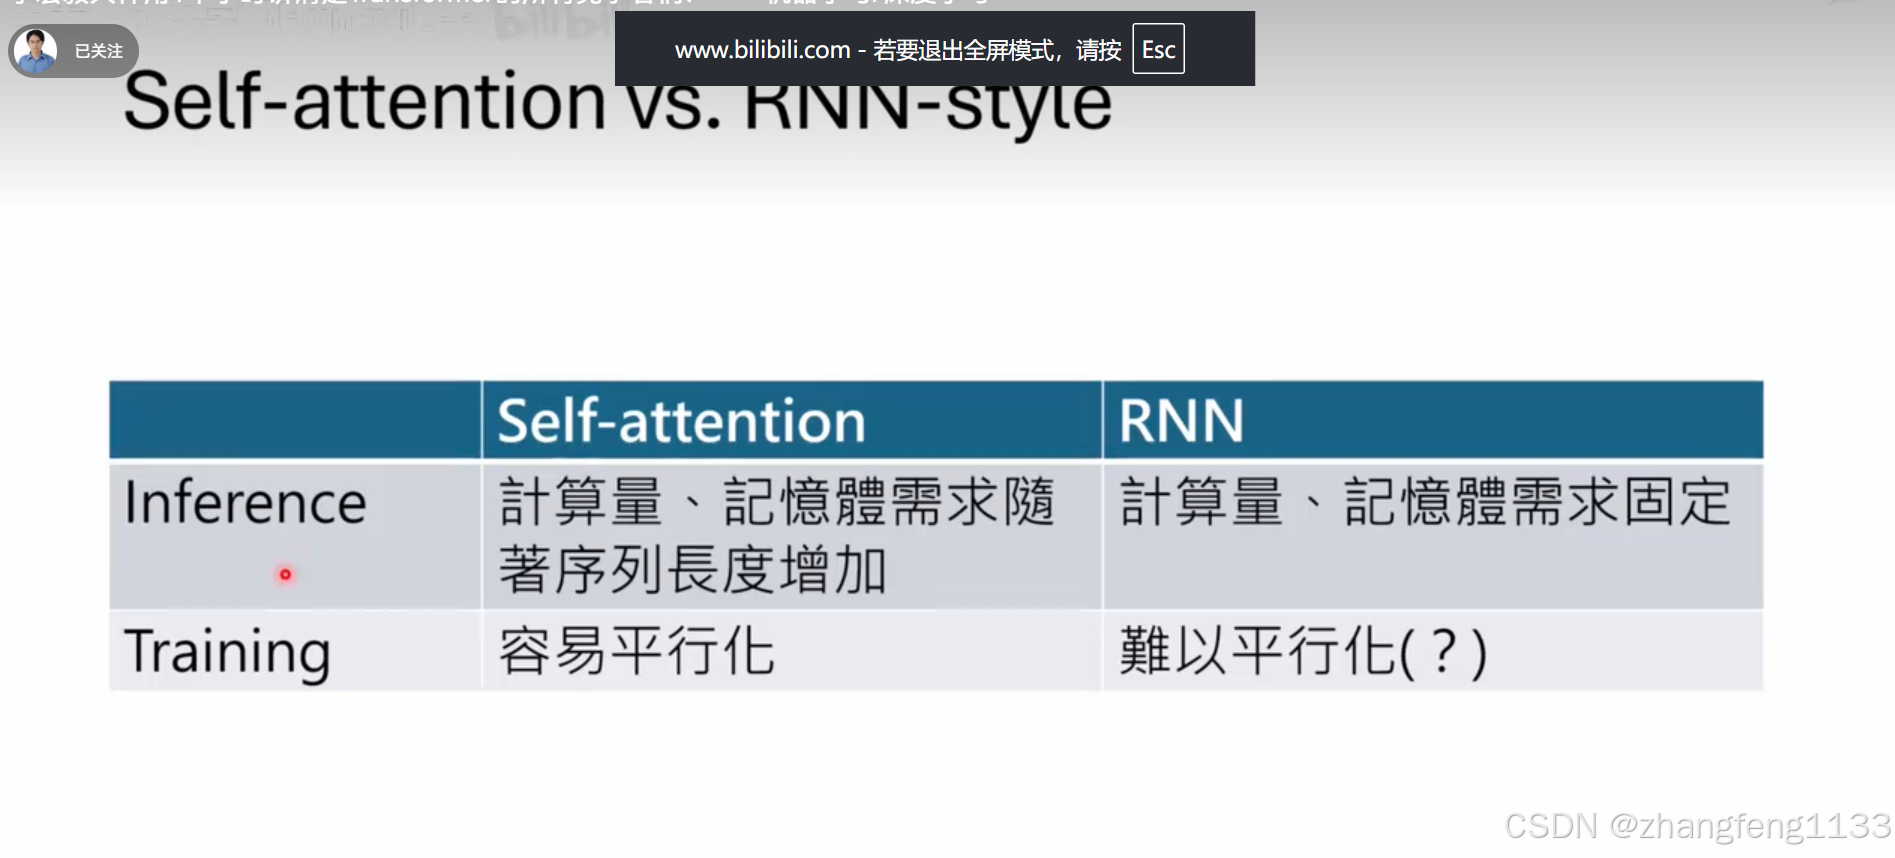
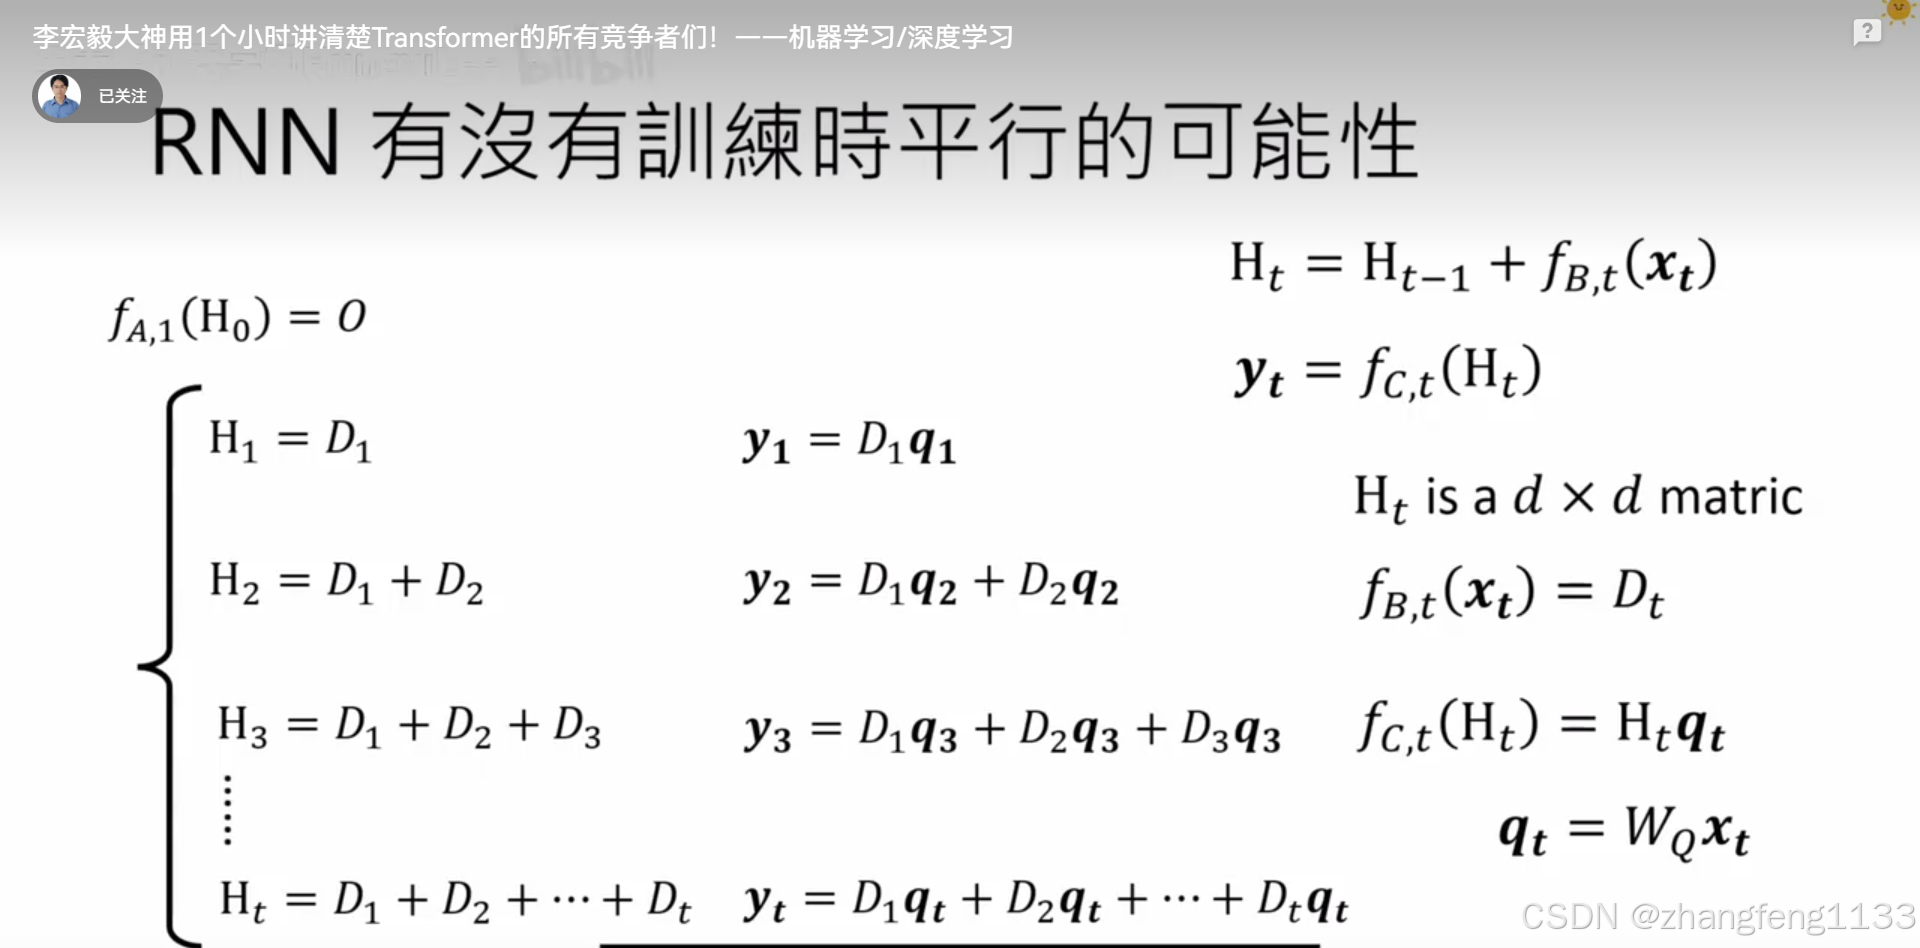
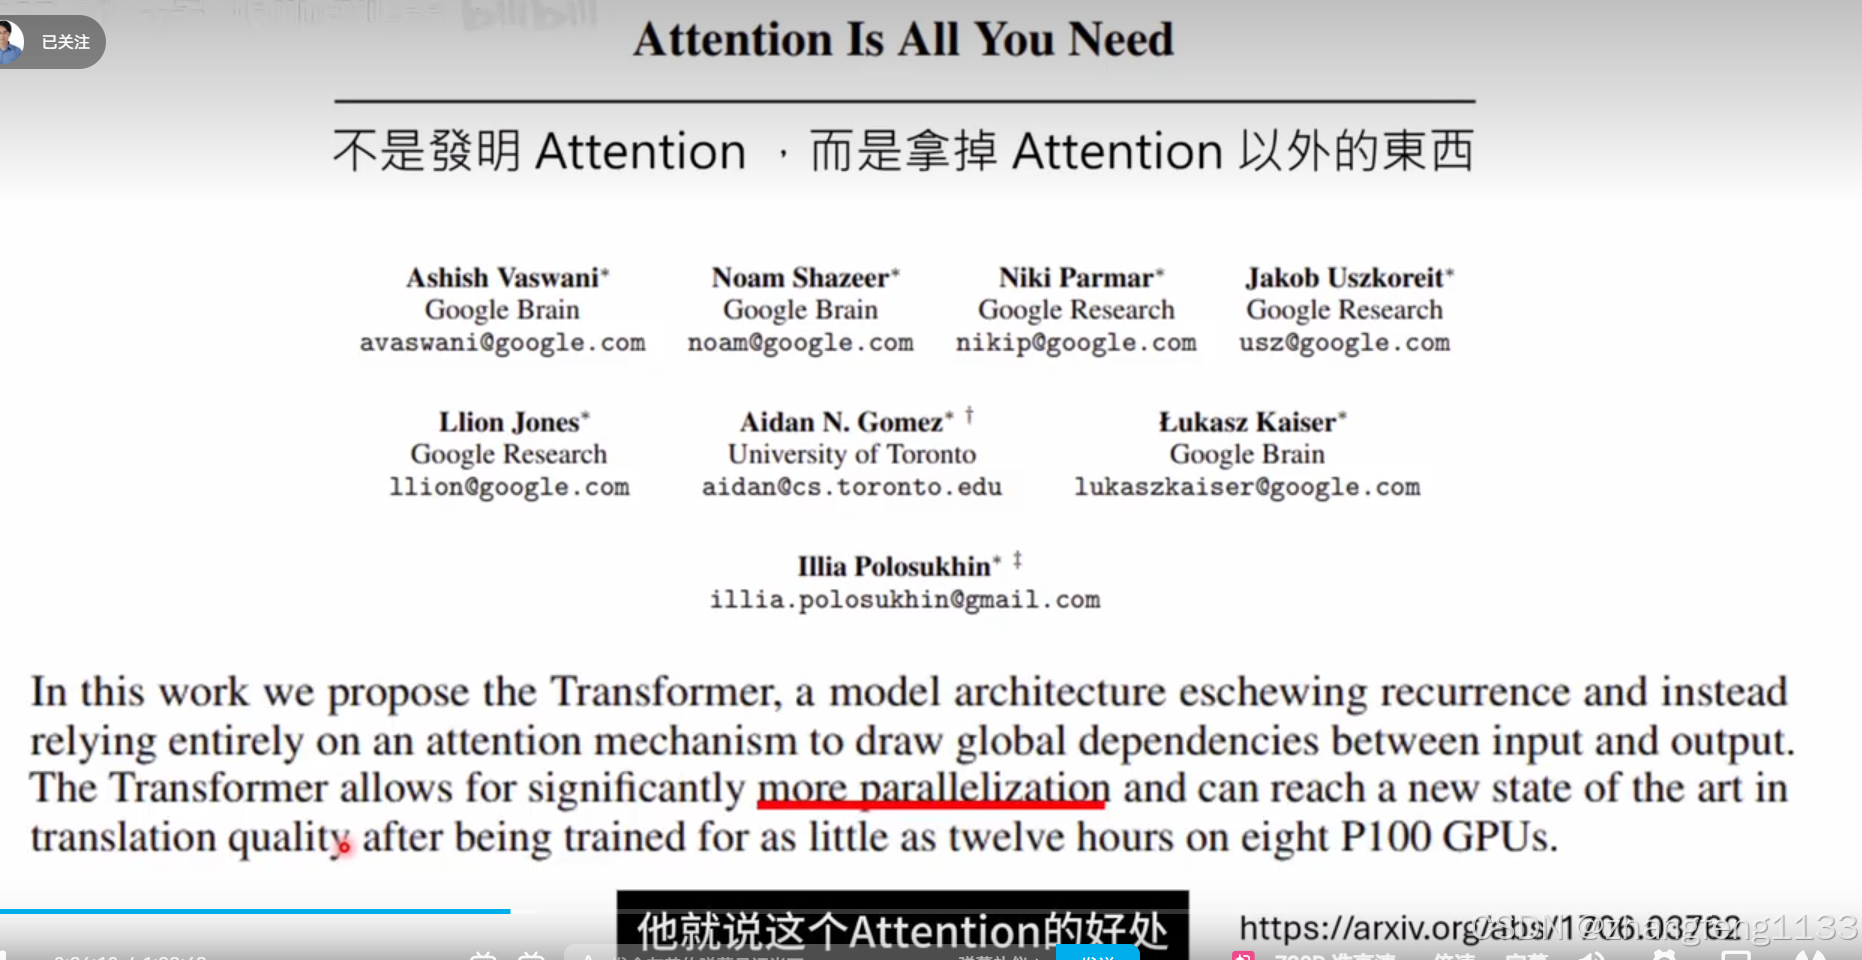
更加并行计算(台湾叫平行化)
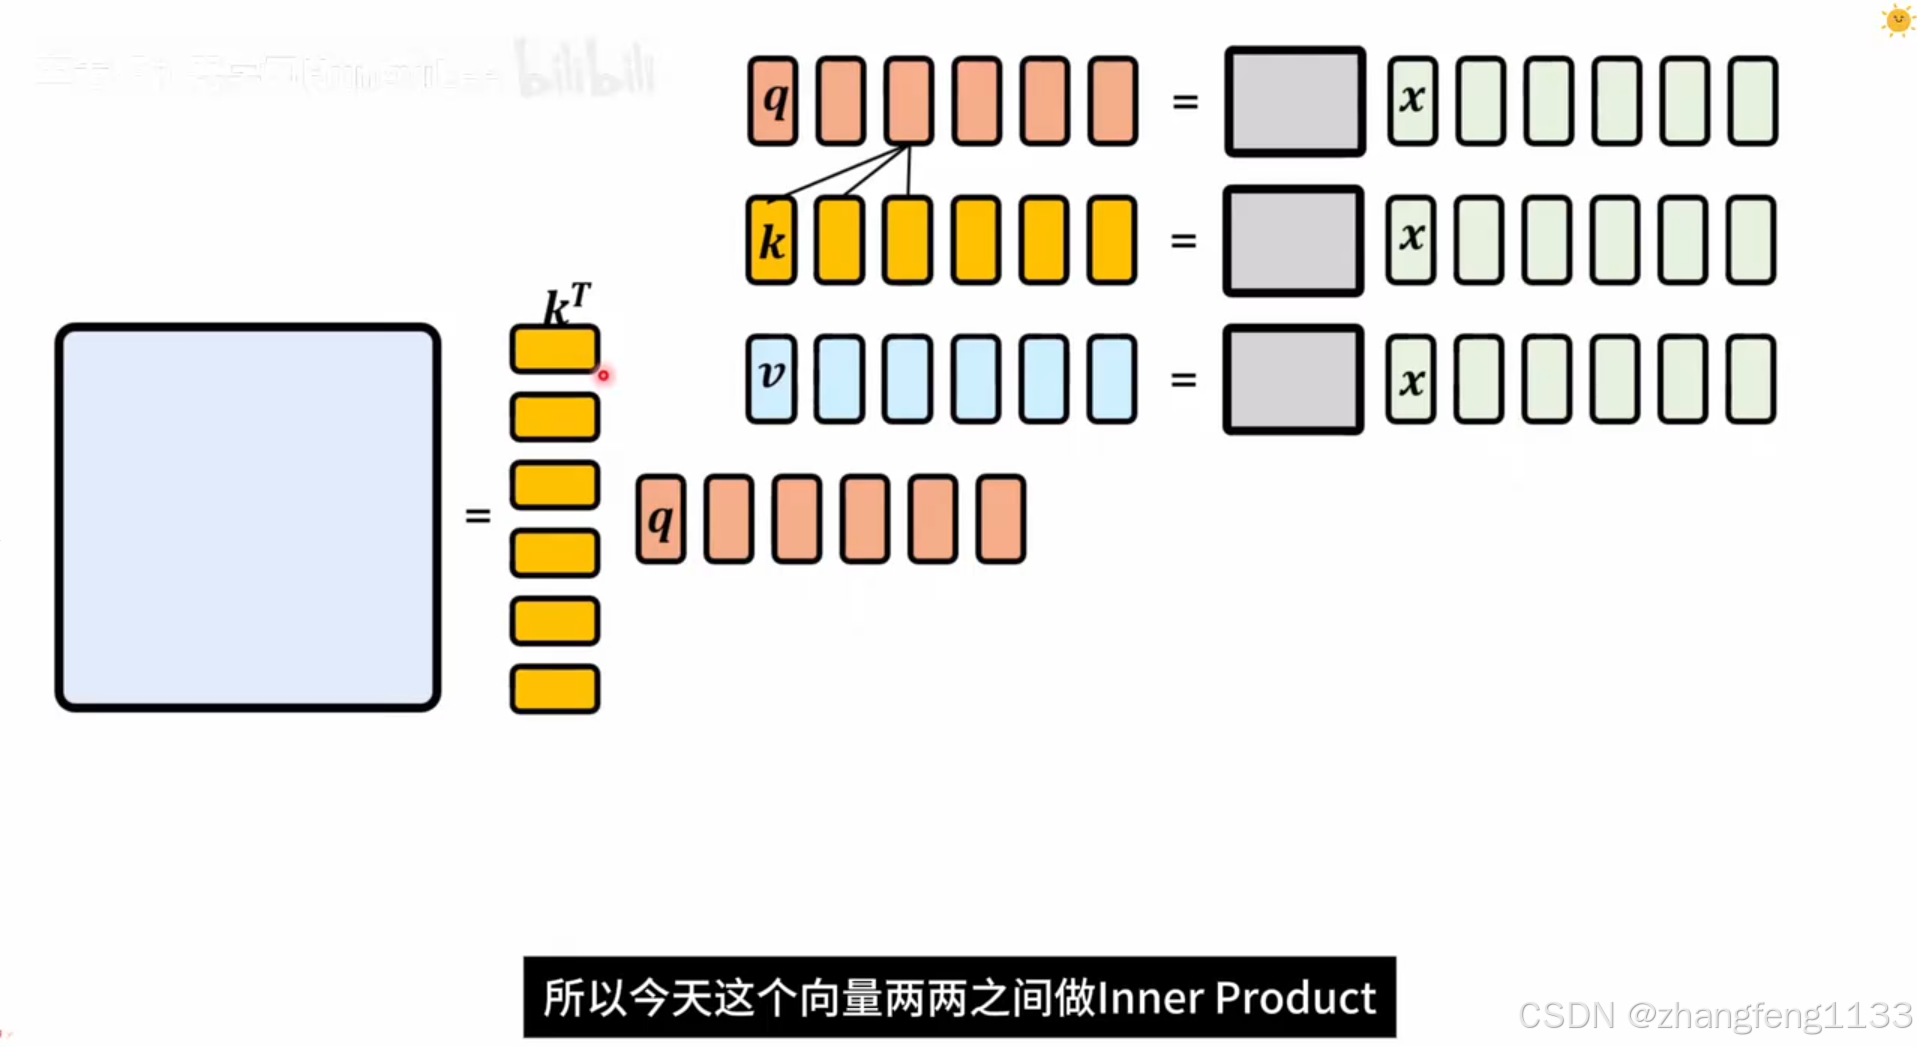
在这里插入图片描述
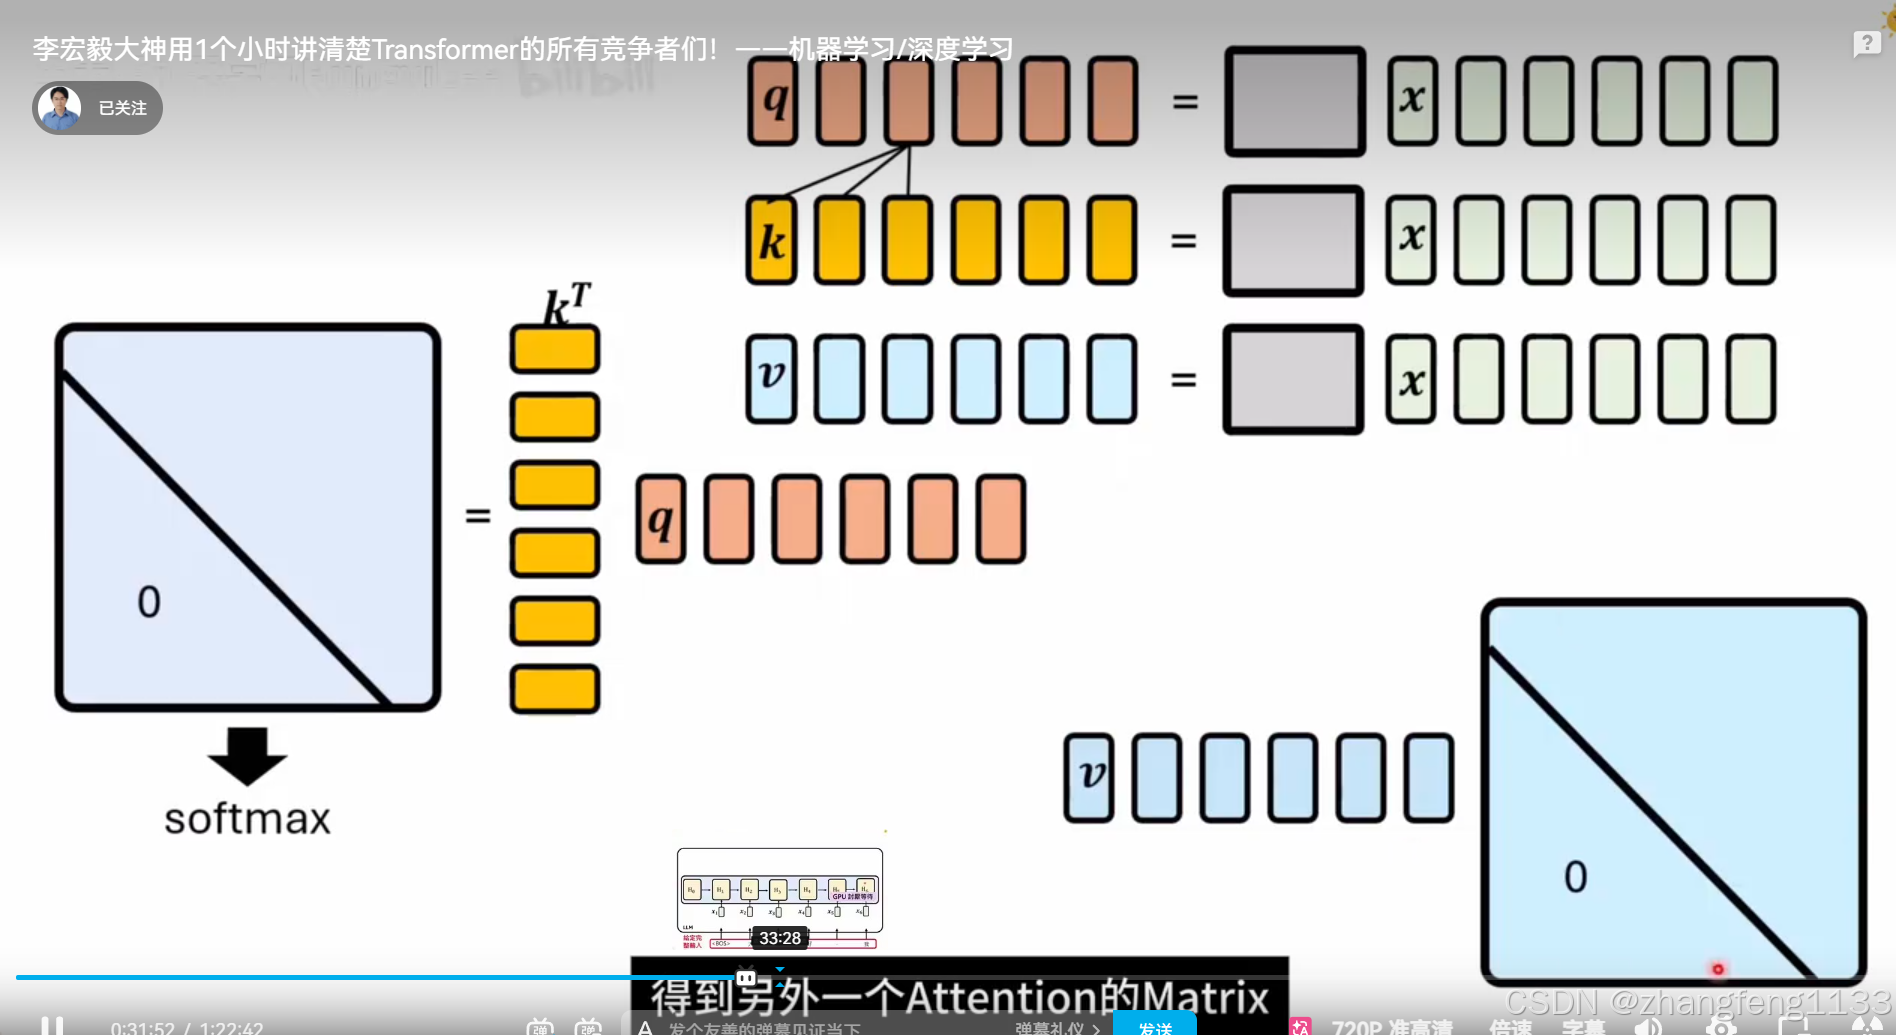
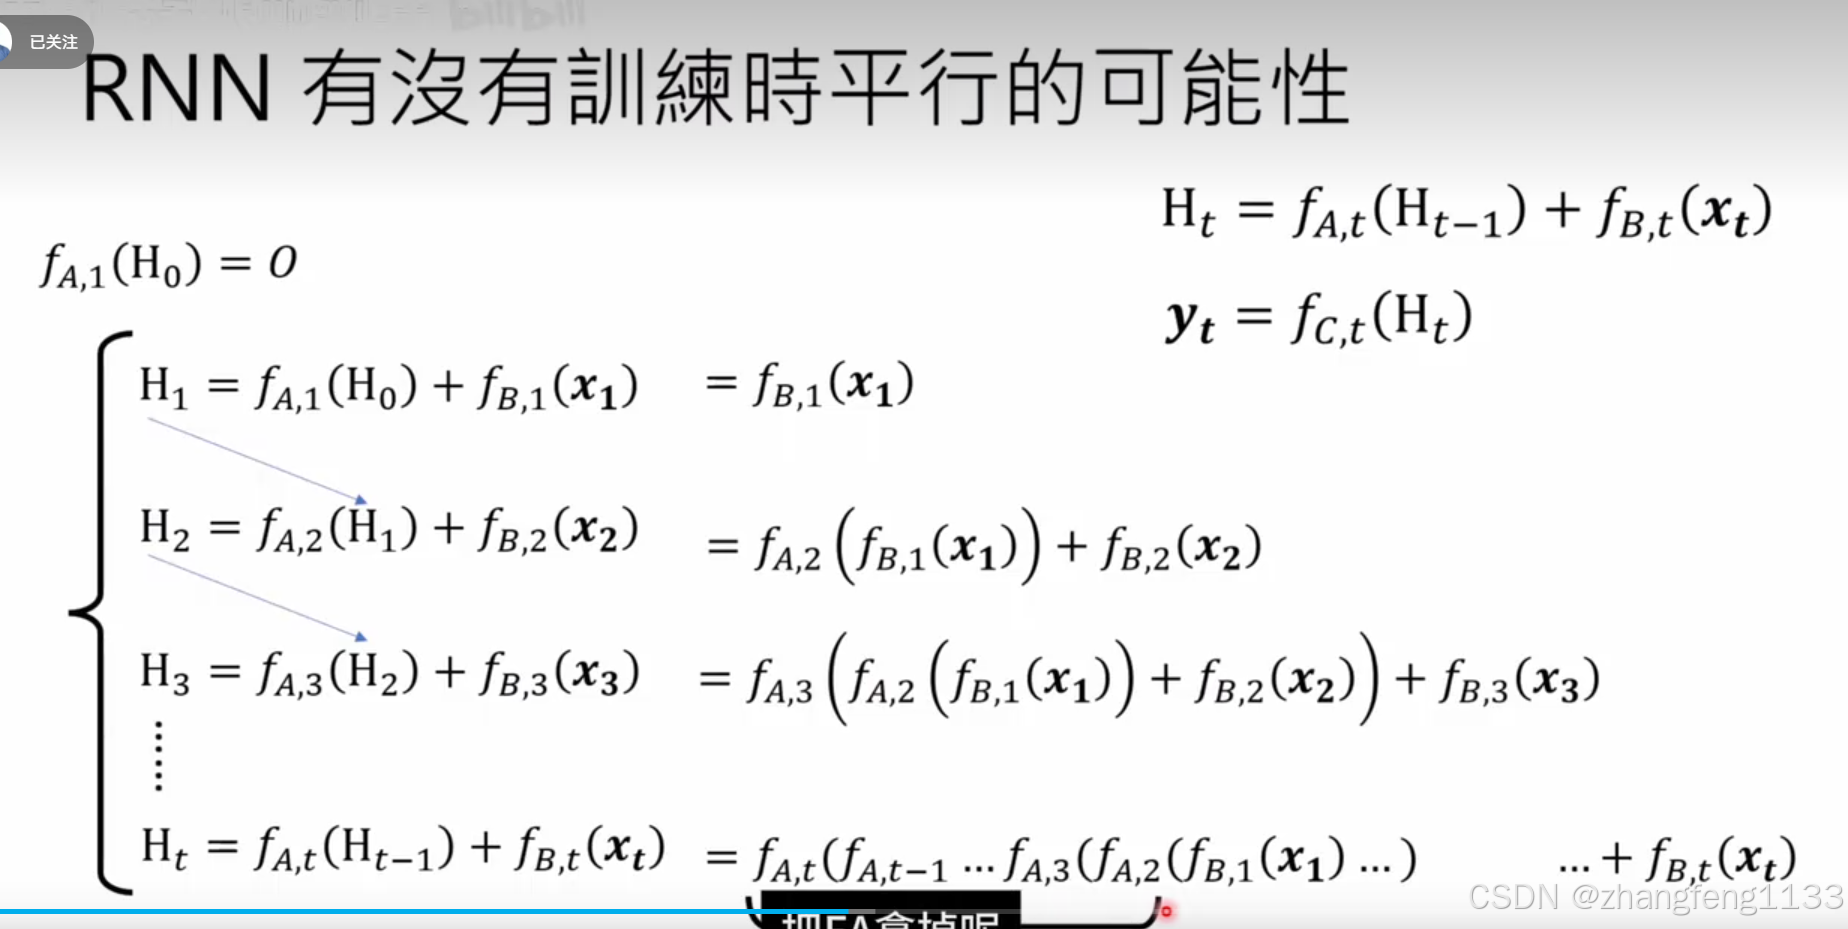
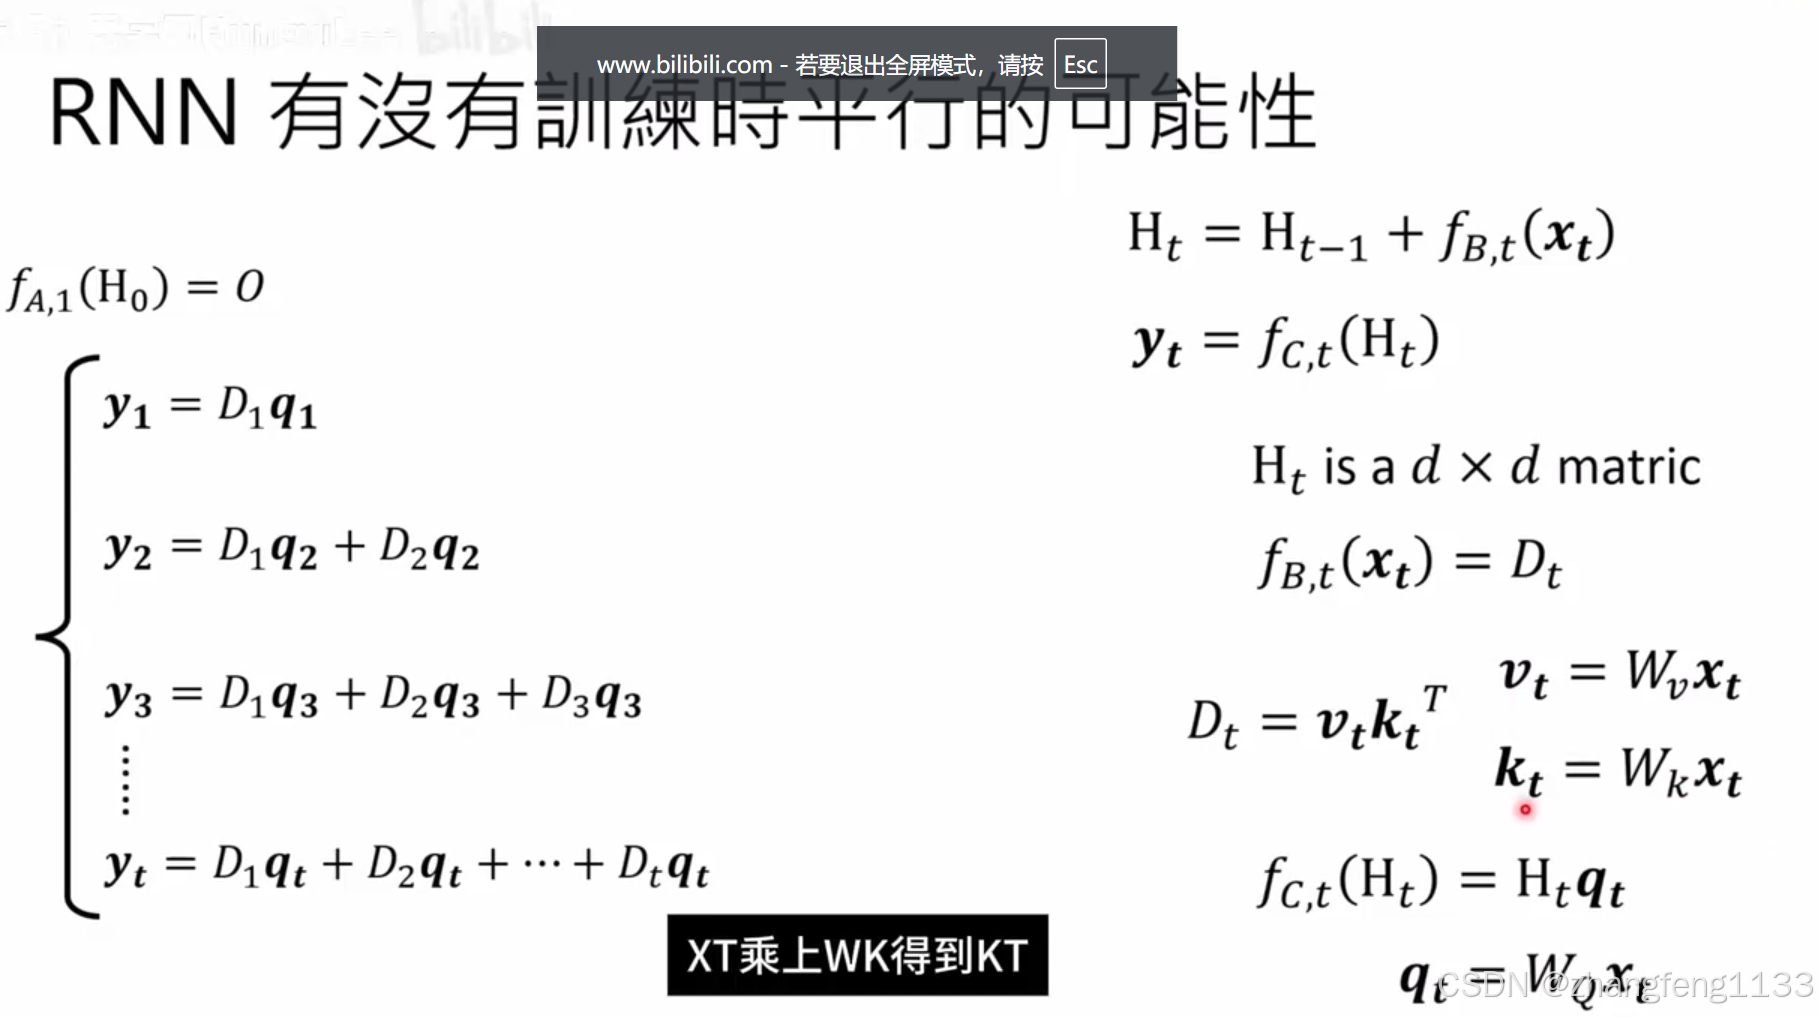
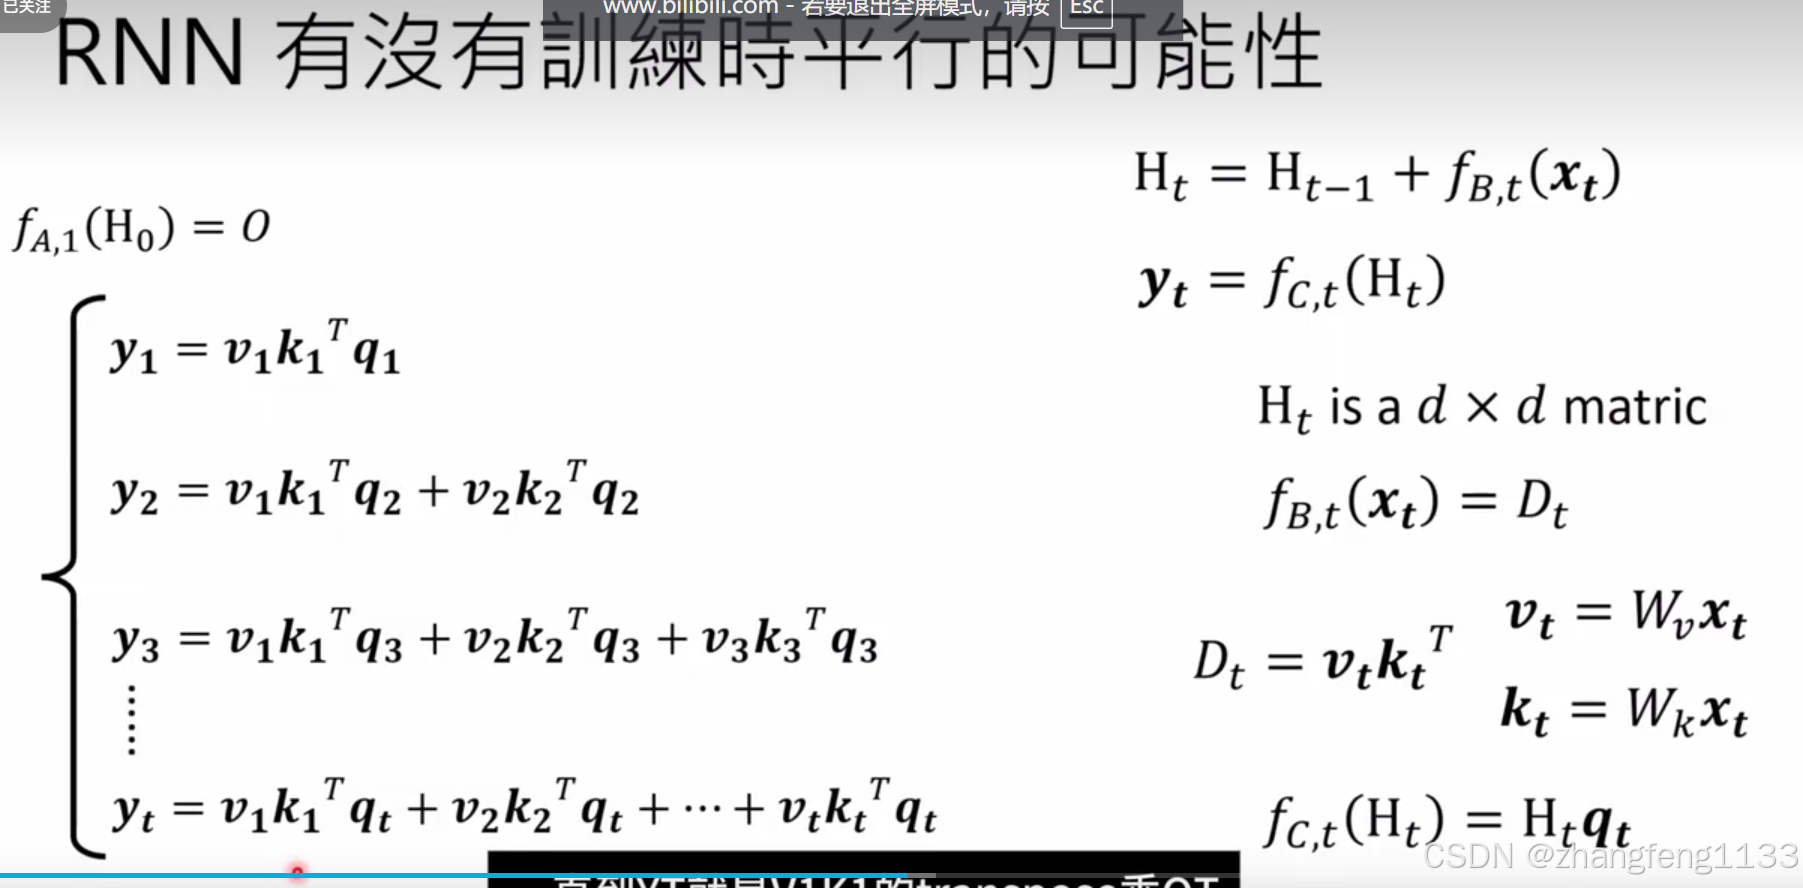
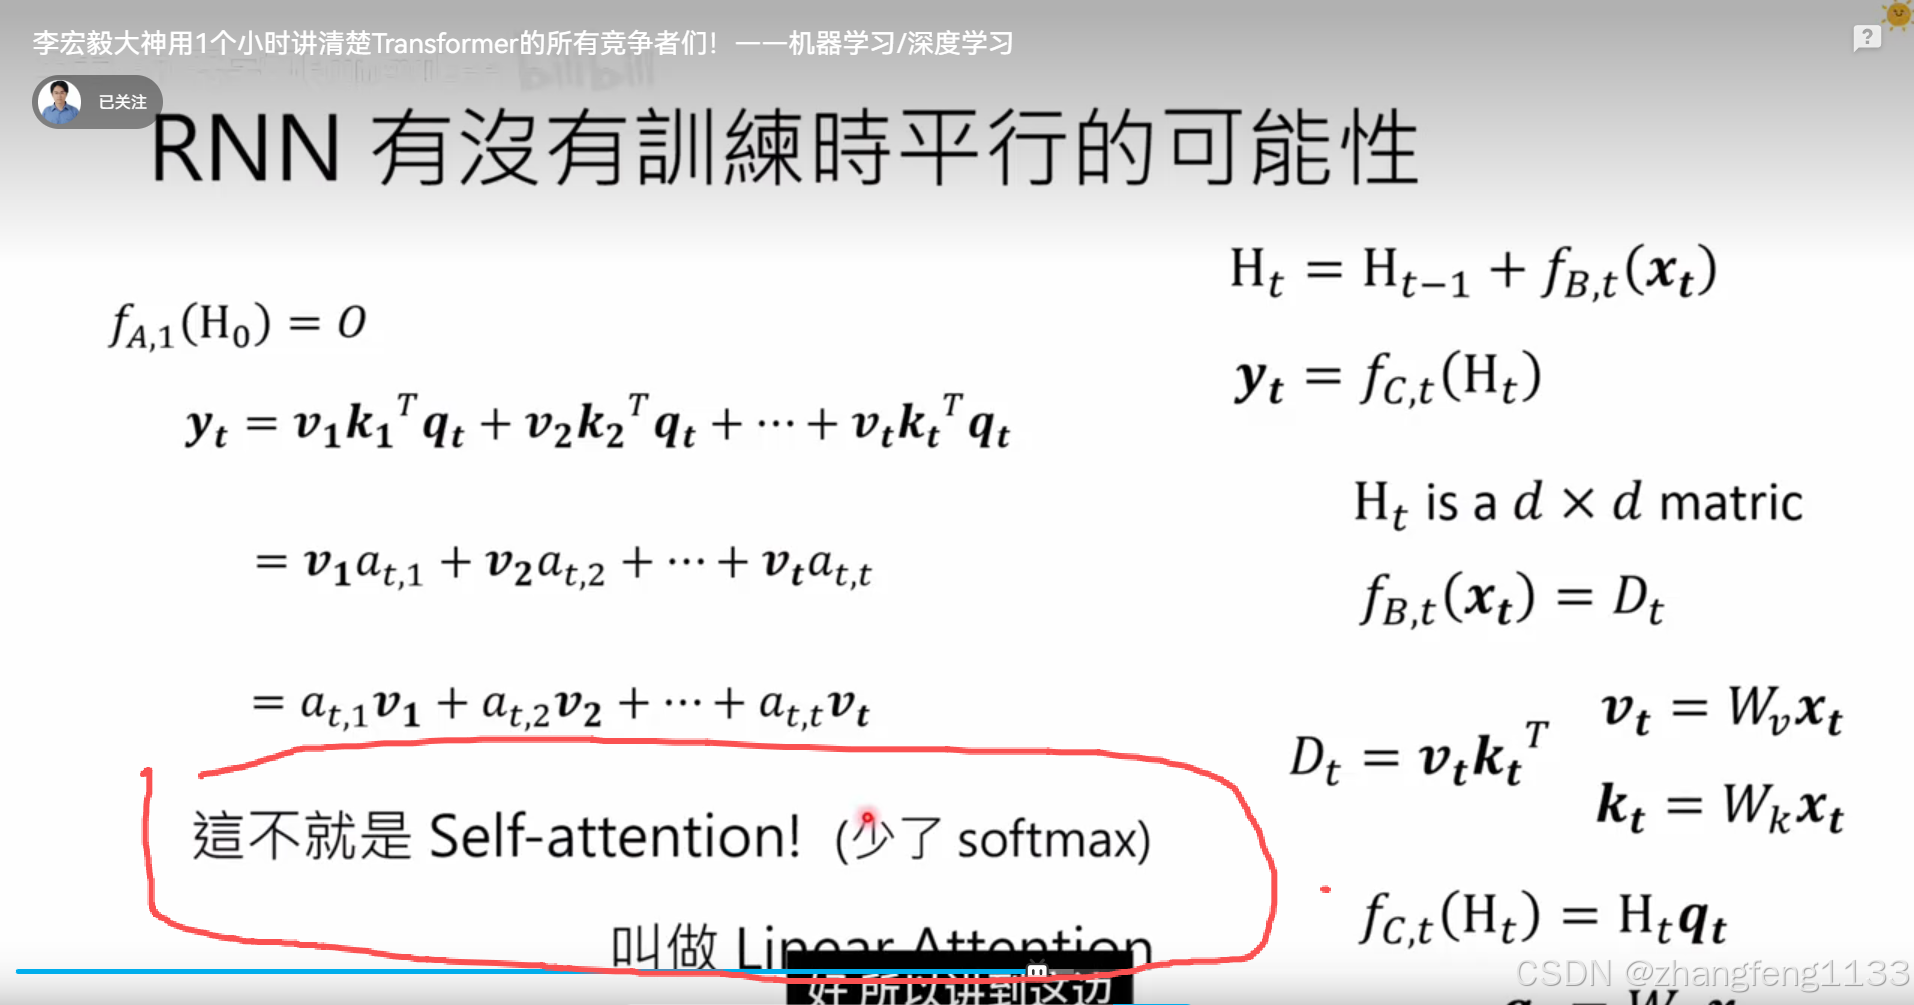
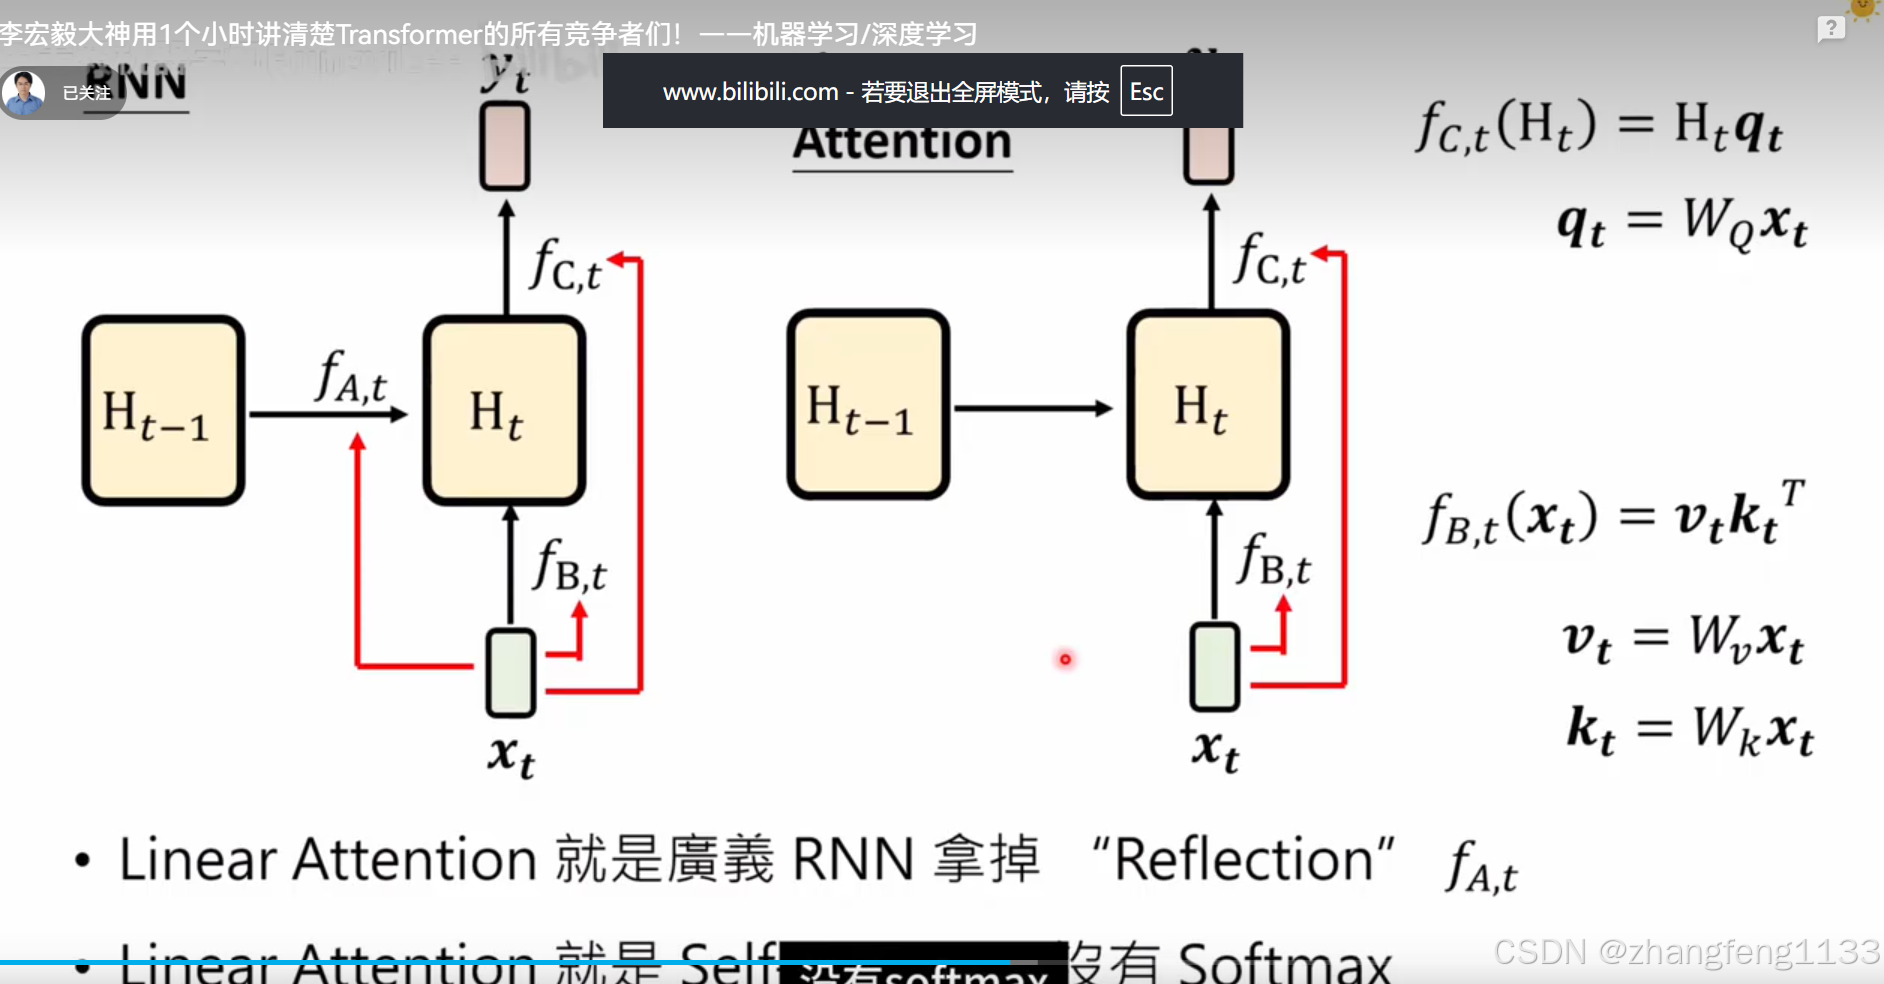
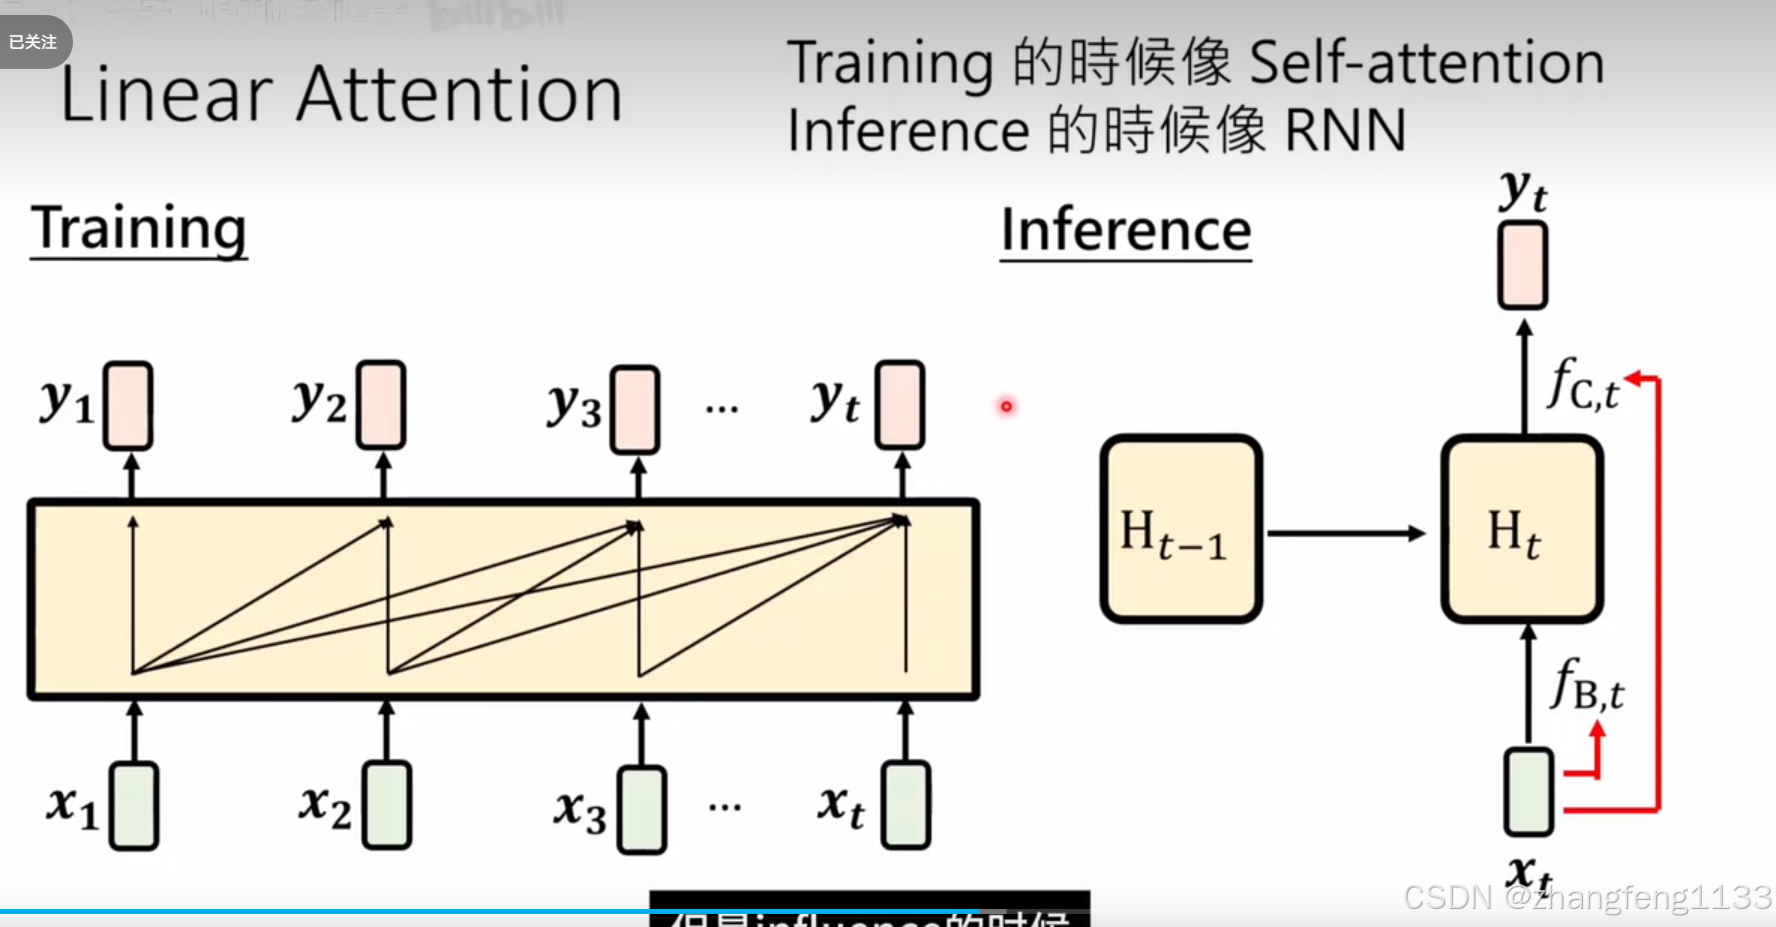
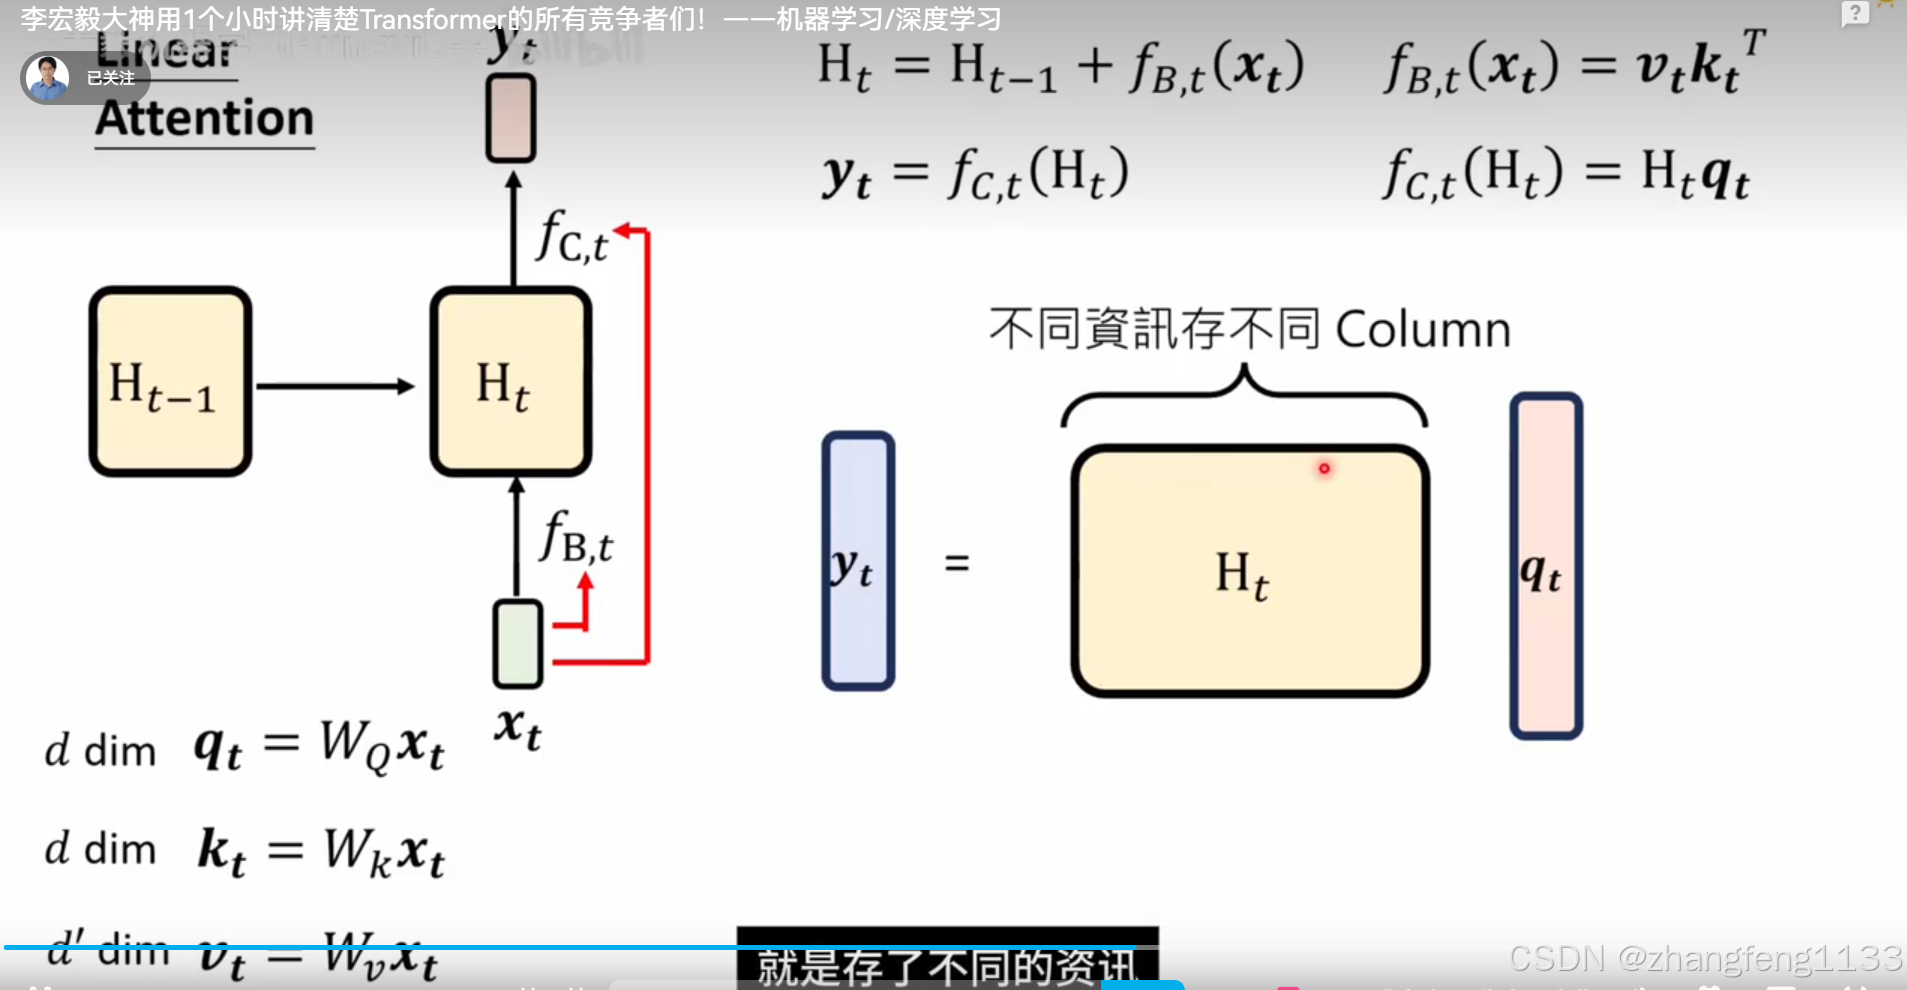
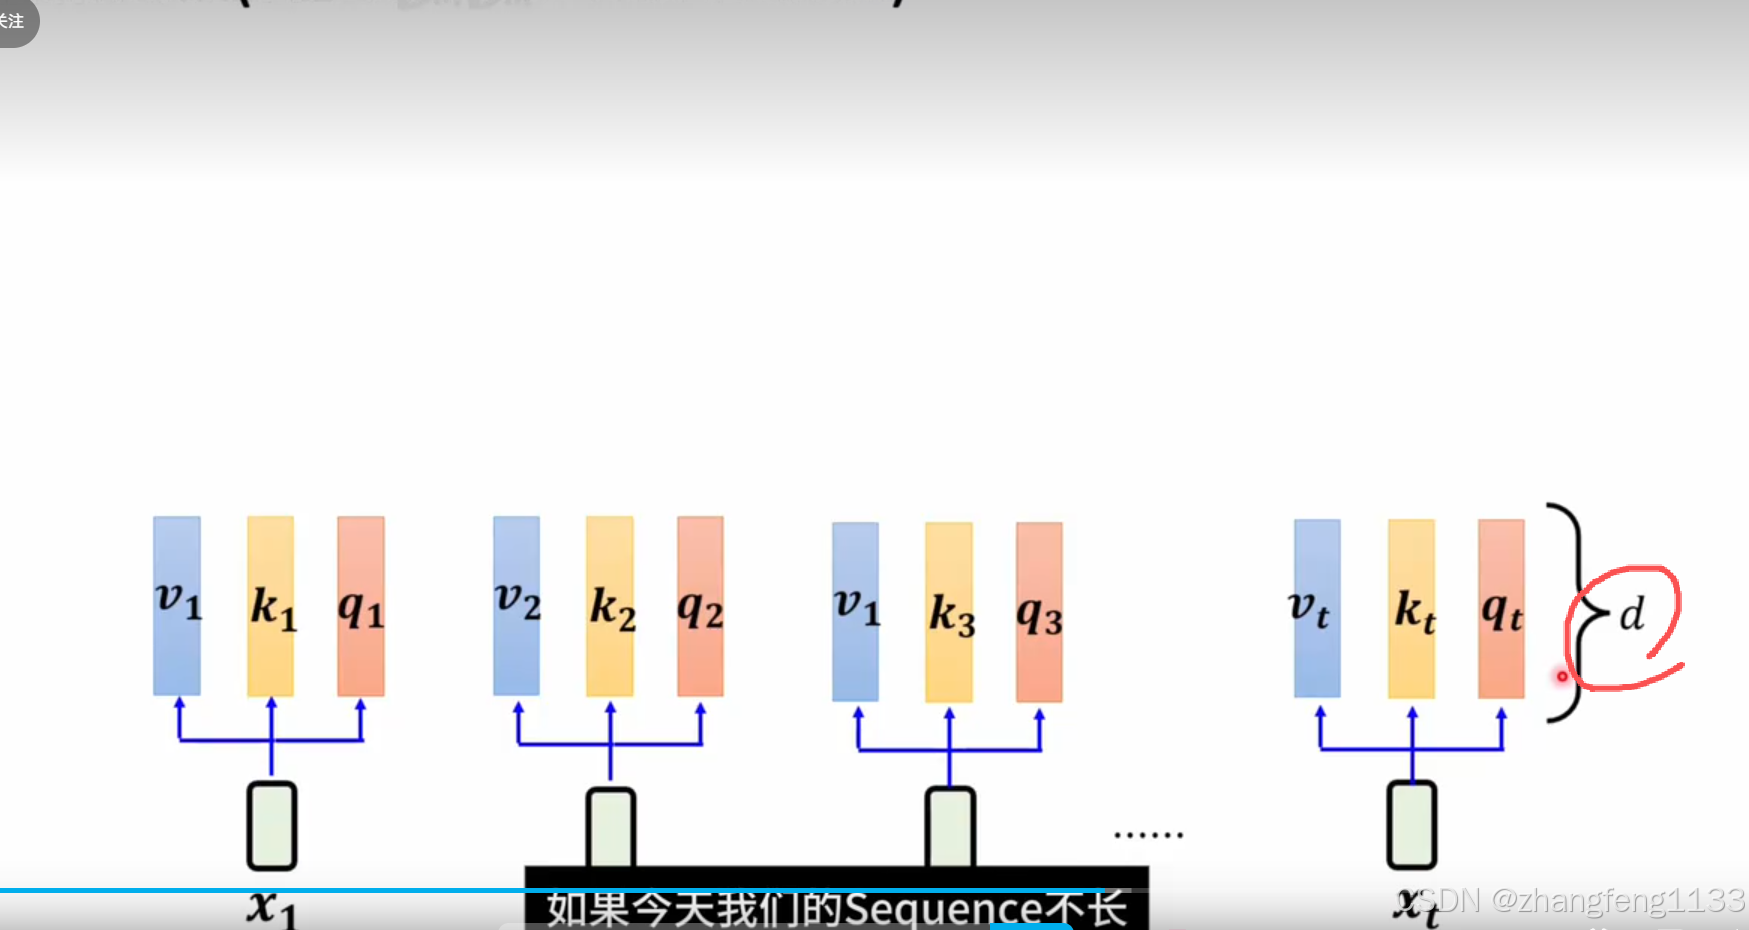
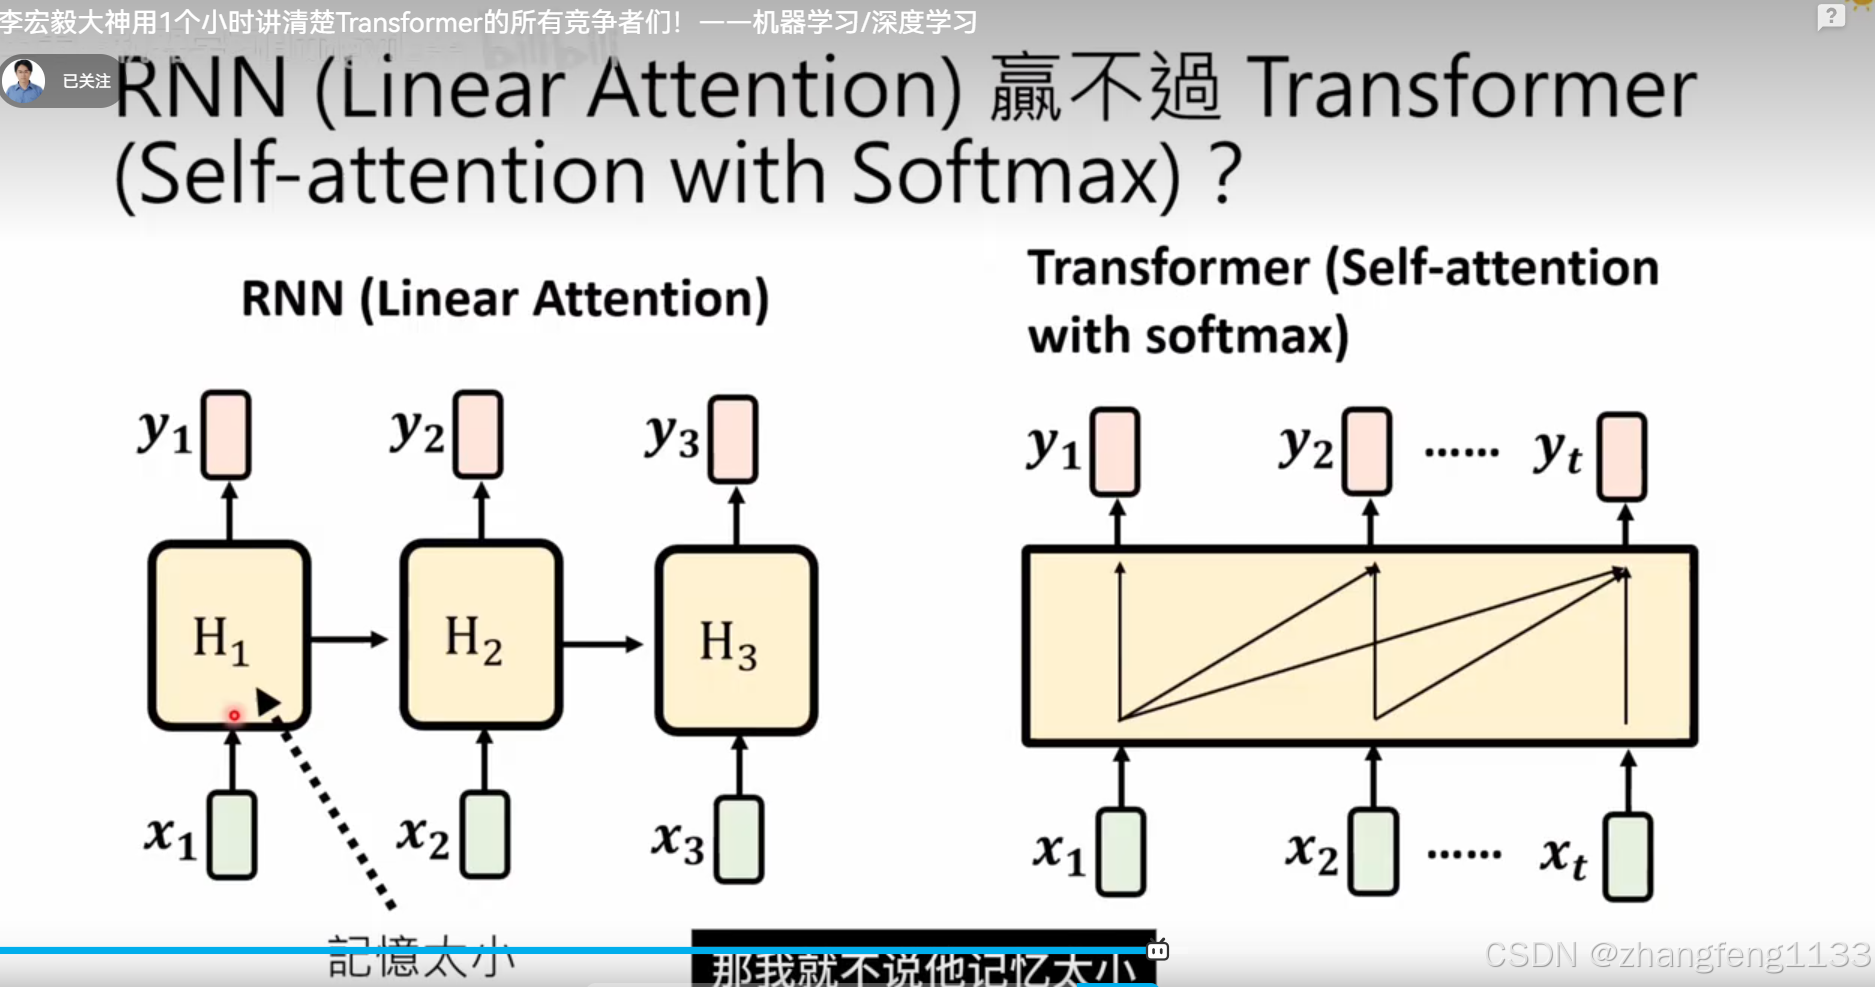
RNN 改进 linear attention
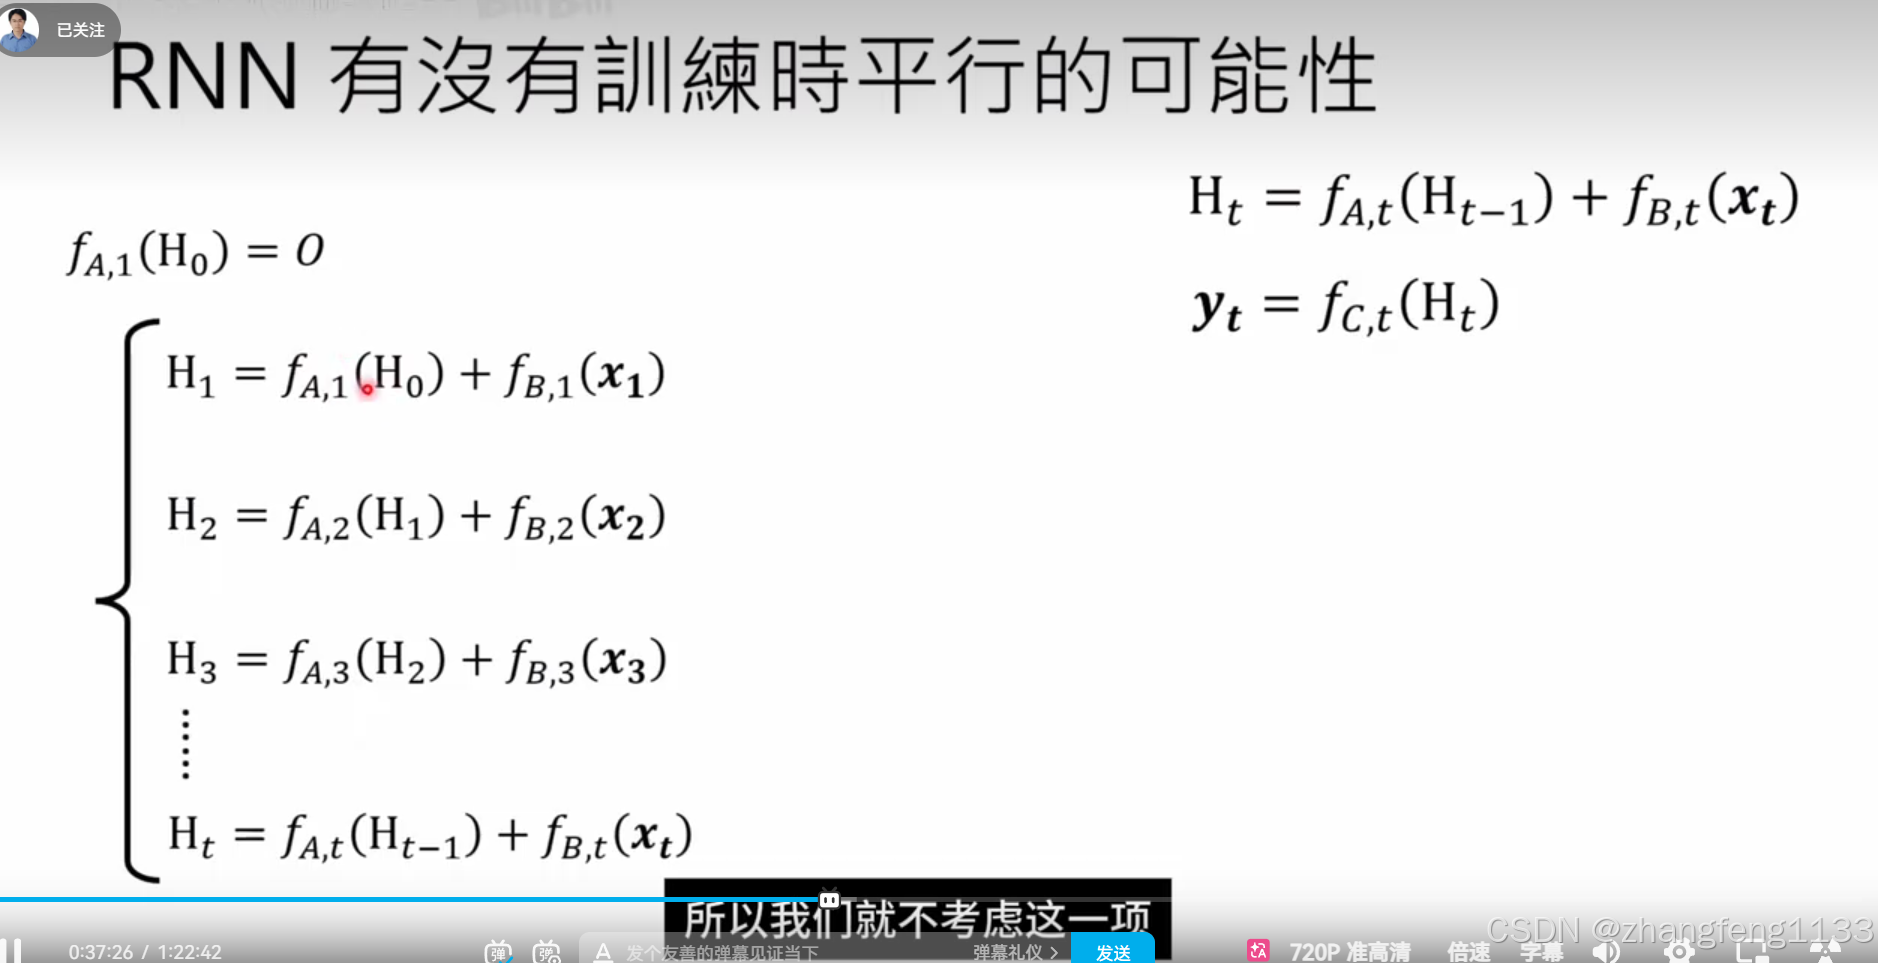
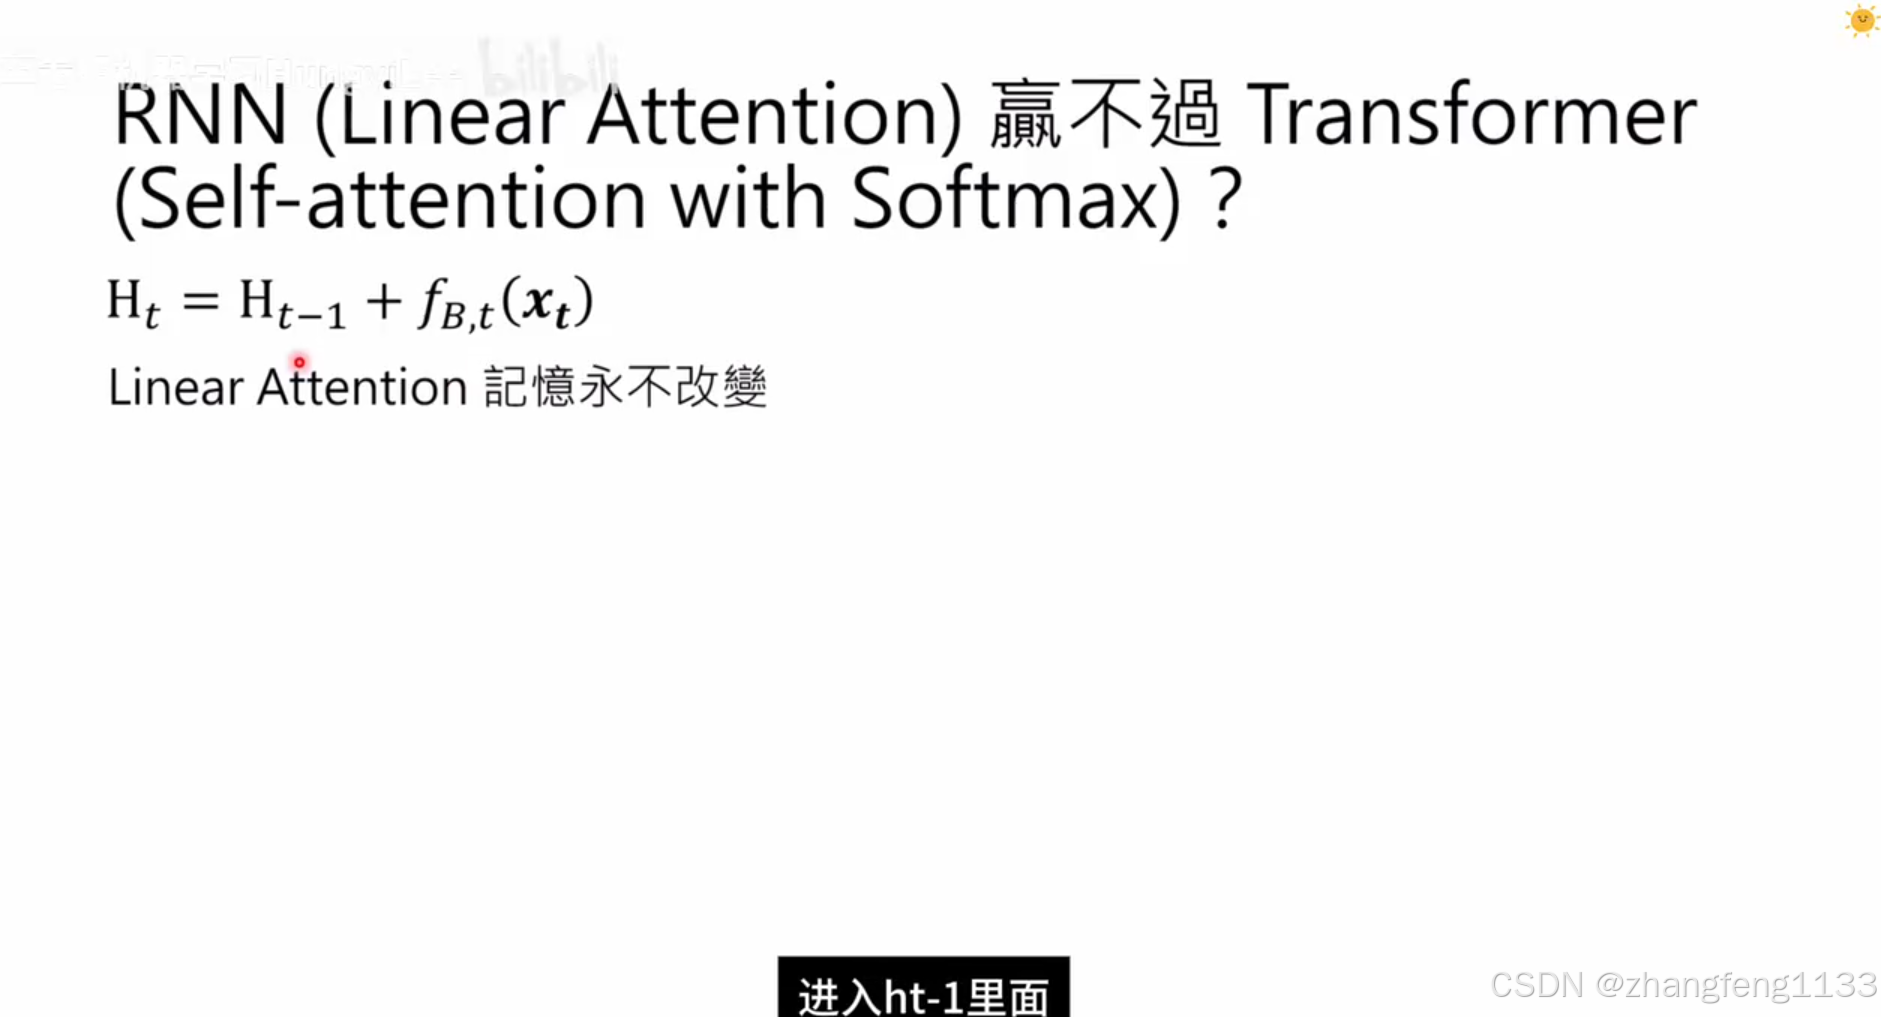
简化函数 fa 去掉 相当 不做运算 ht-1 -= ht-1 不做计算
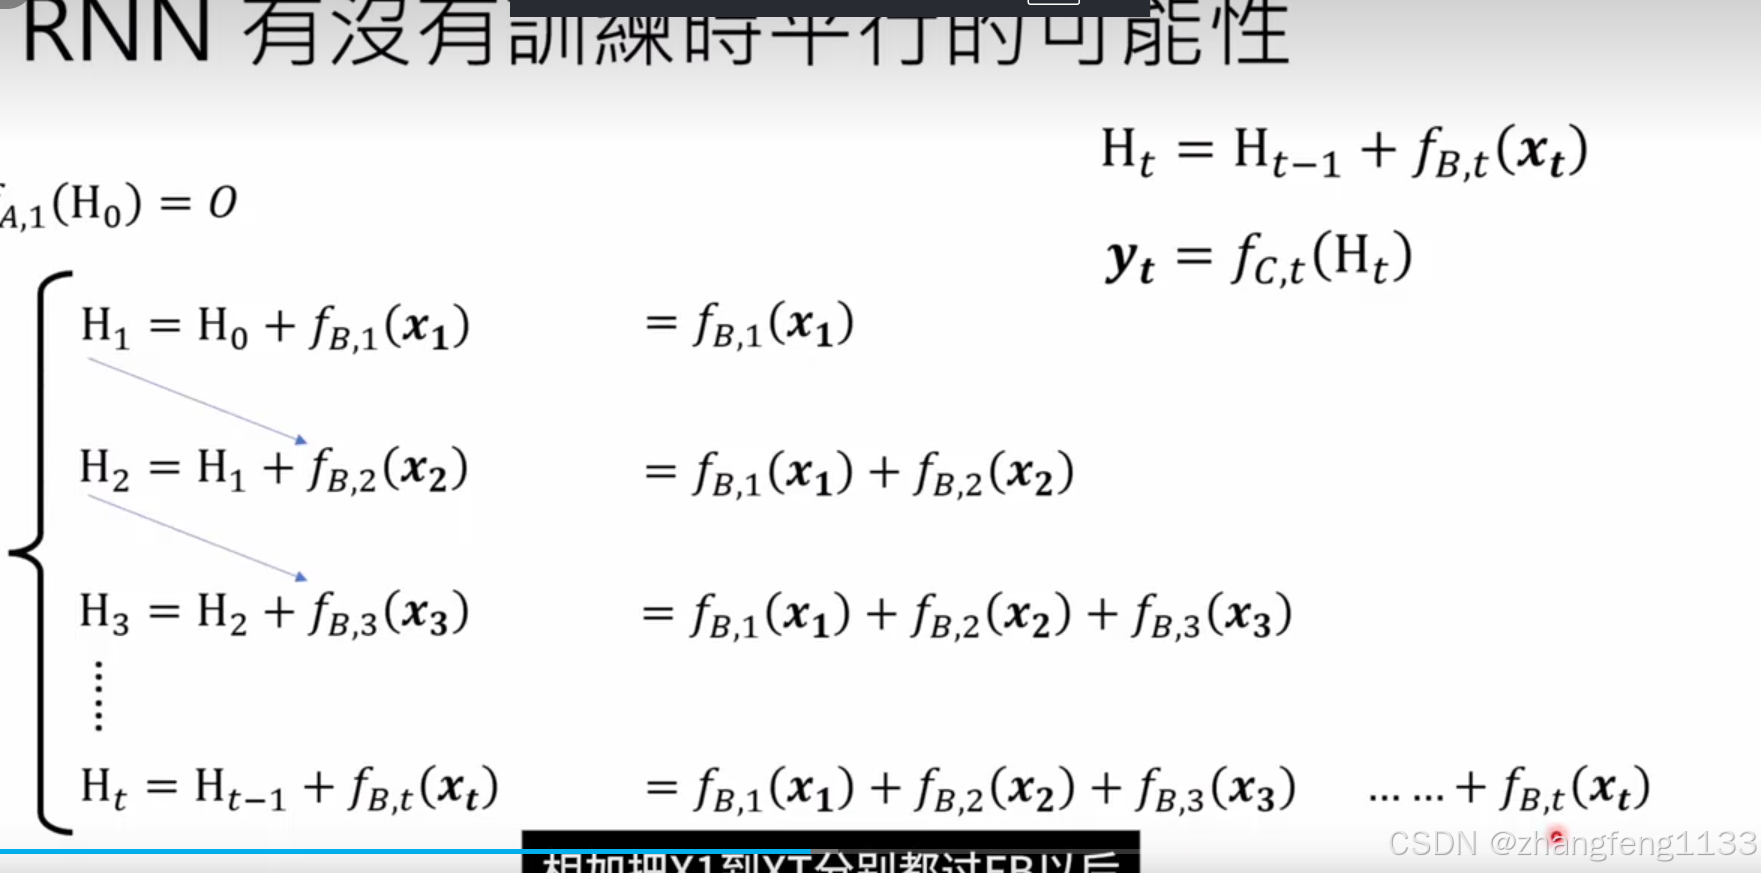
扫描算法,不作介绍,后面有i更加简单的
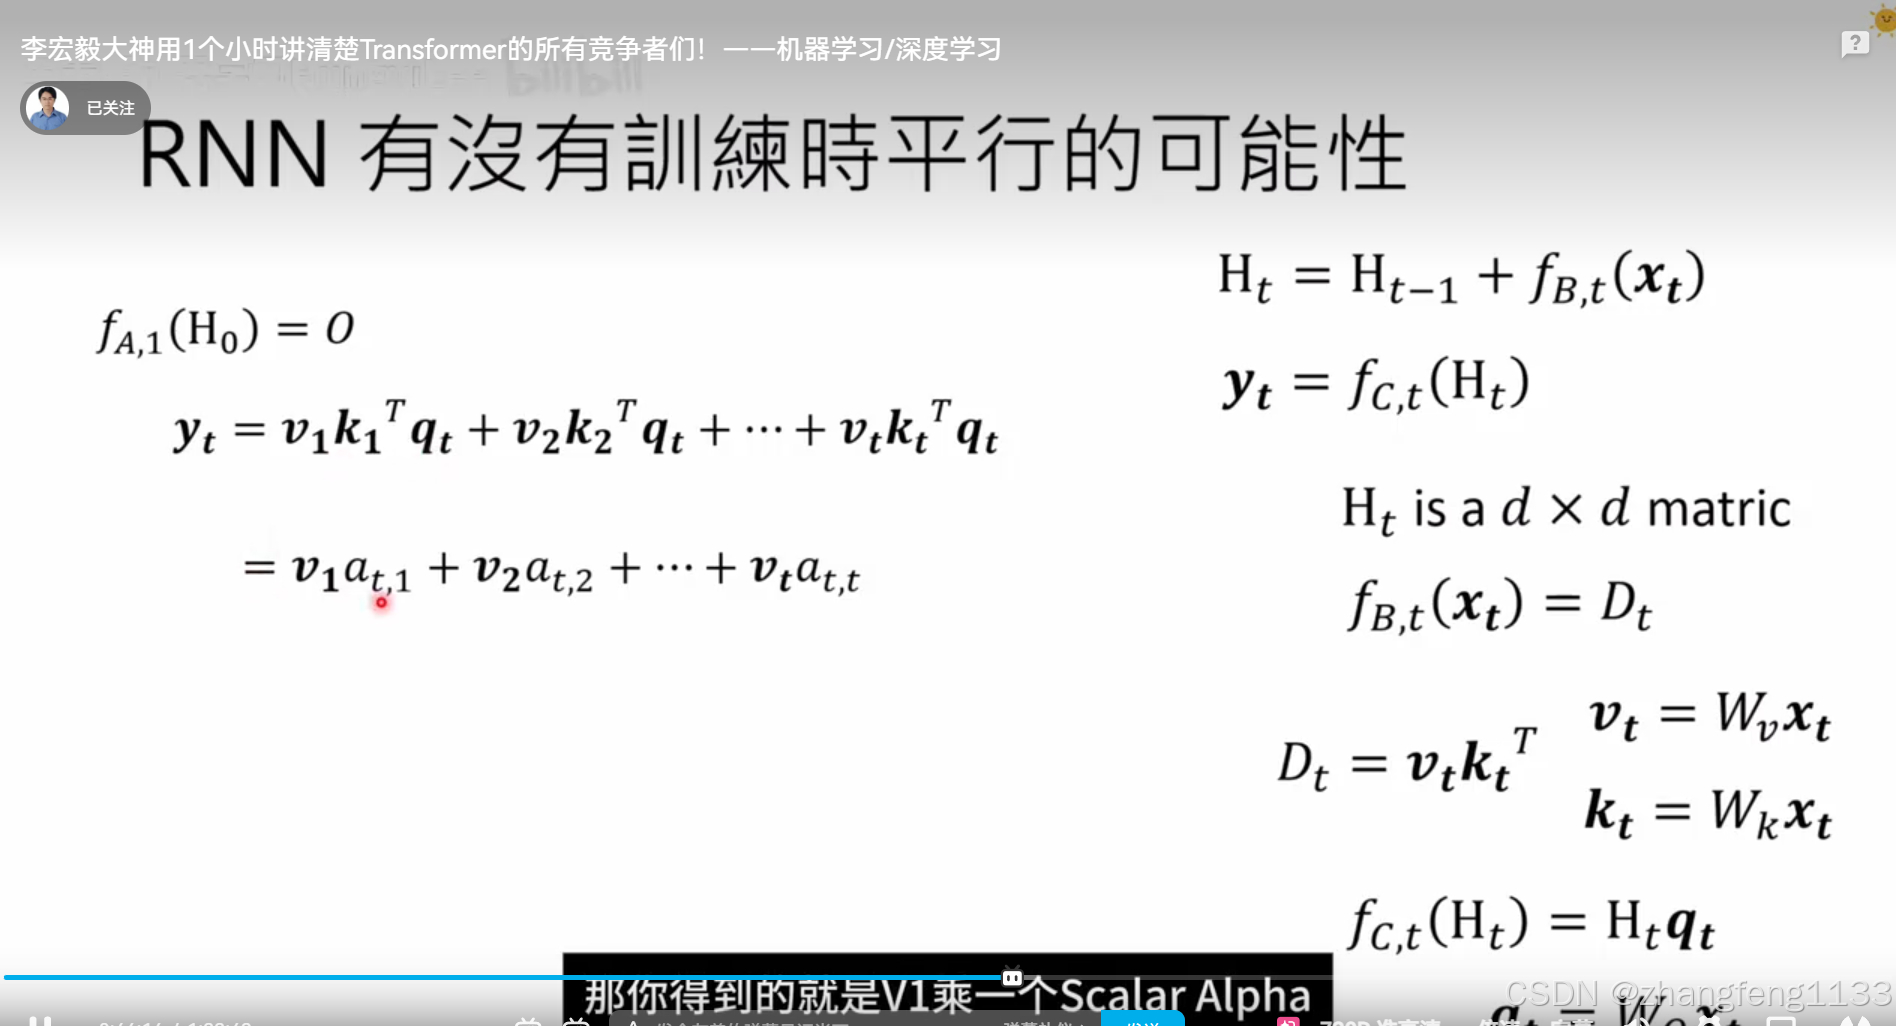
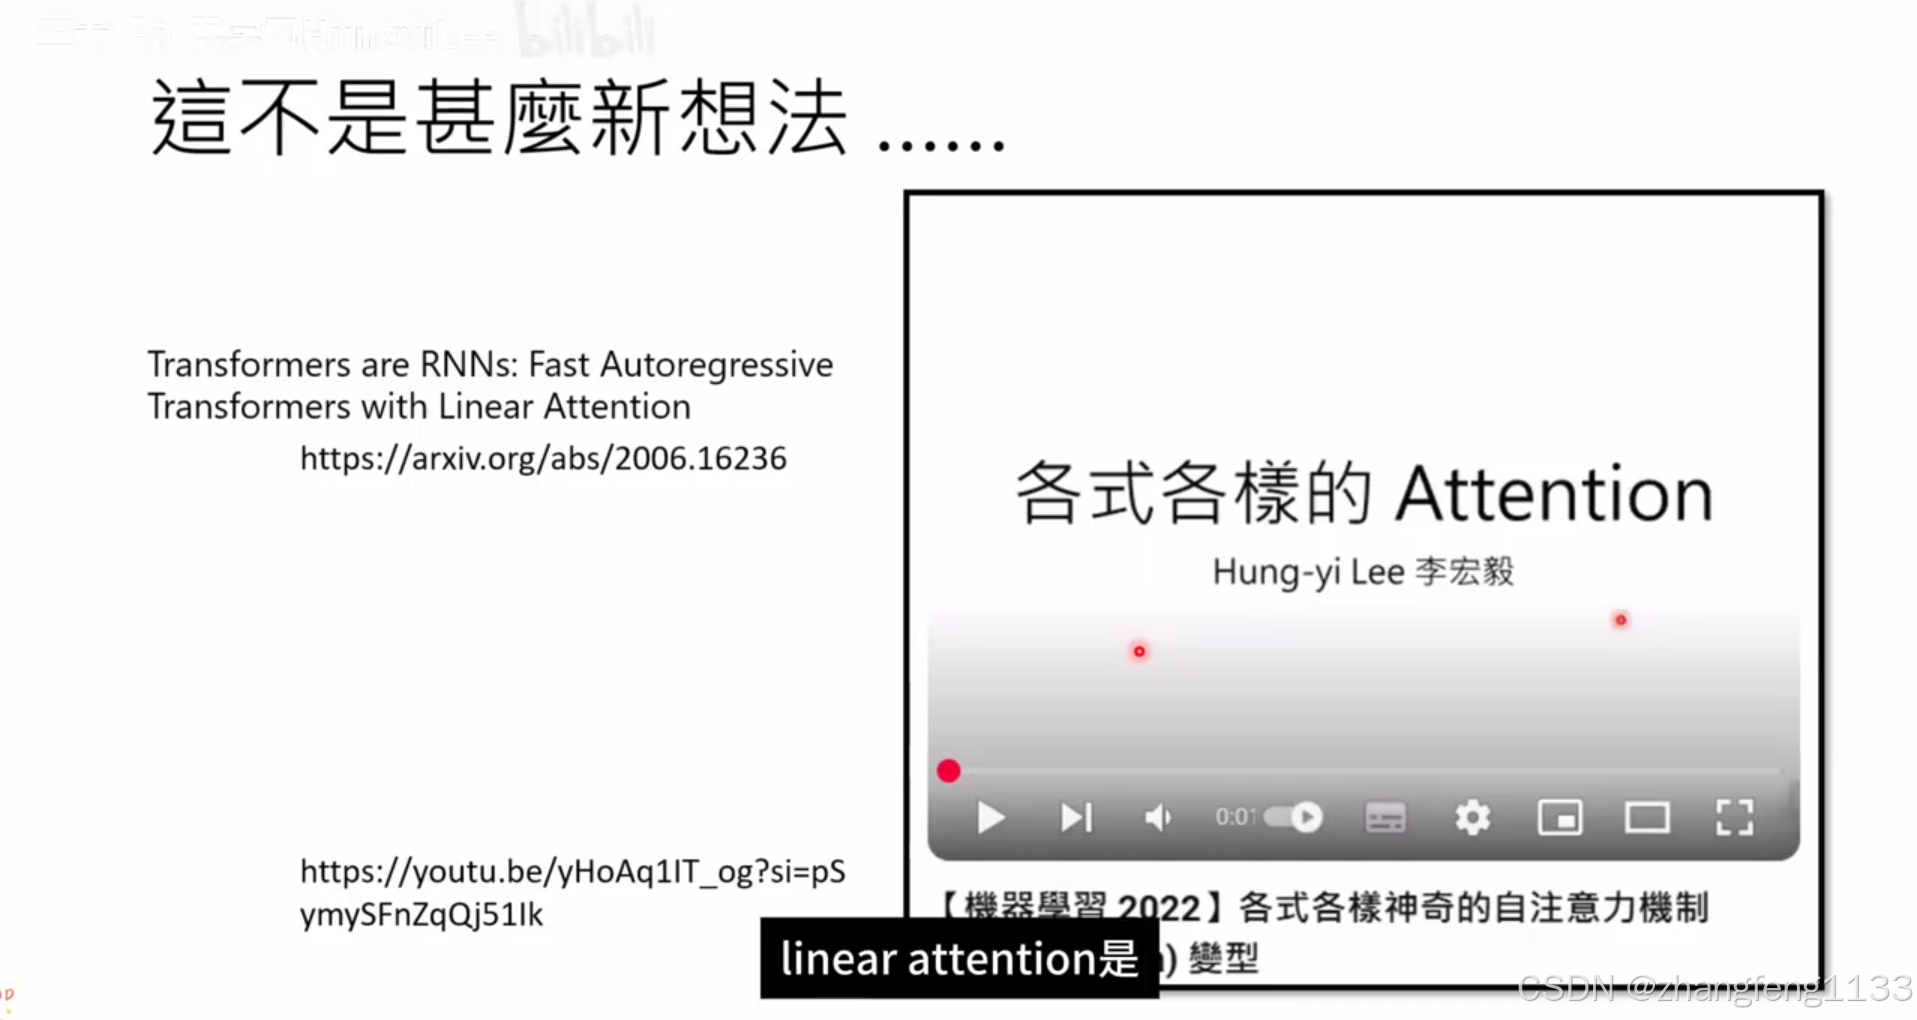
linear attention 2020年
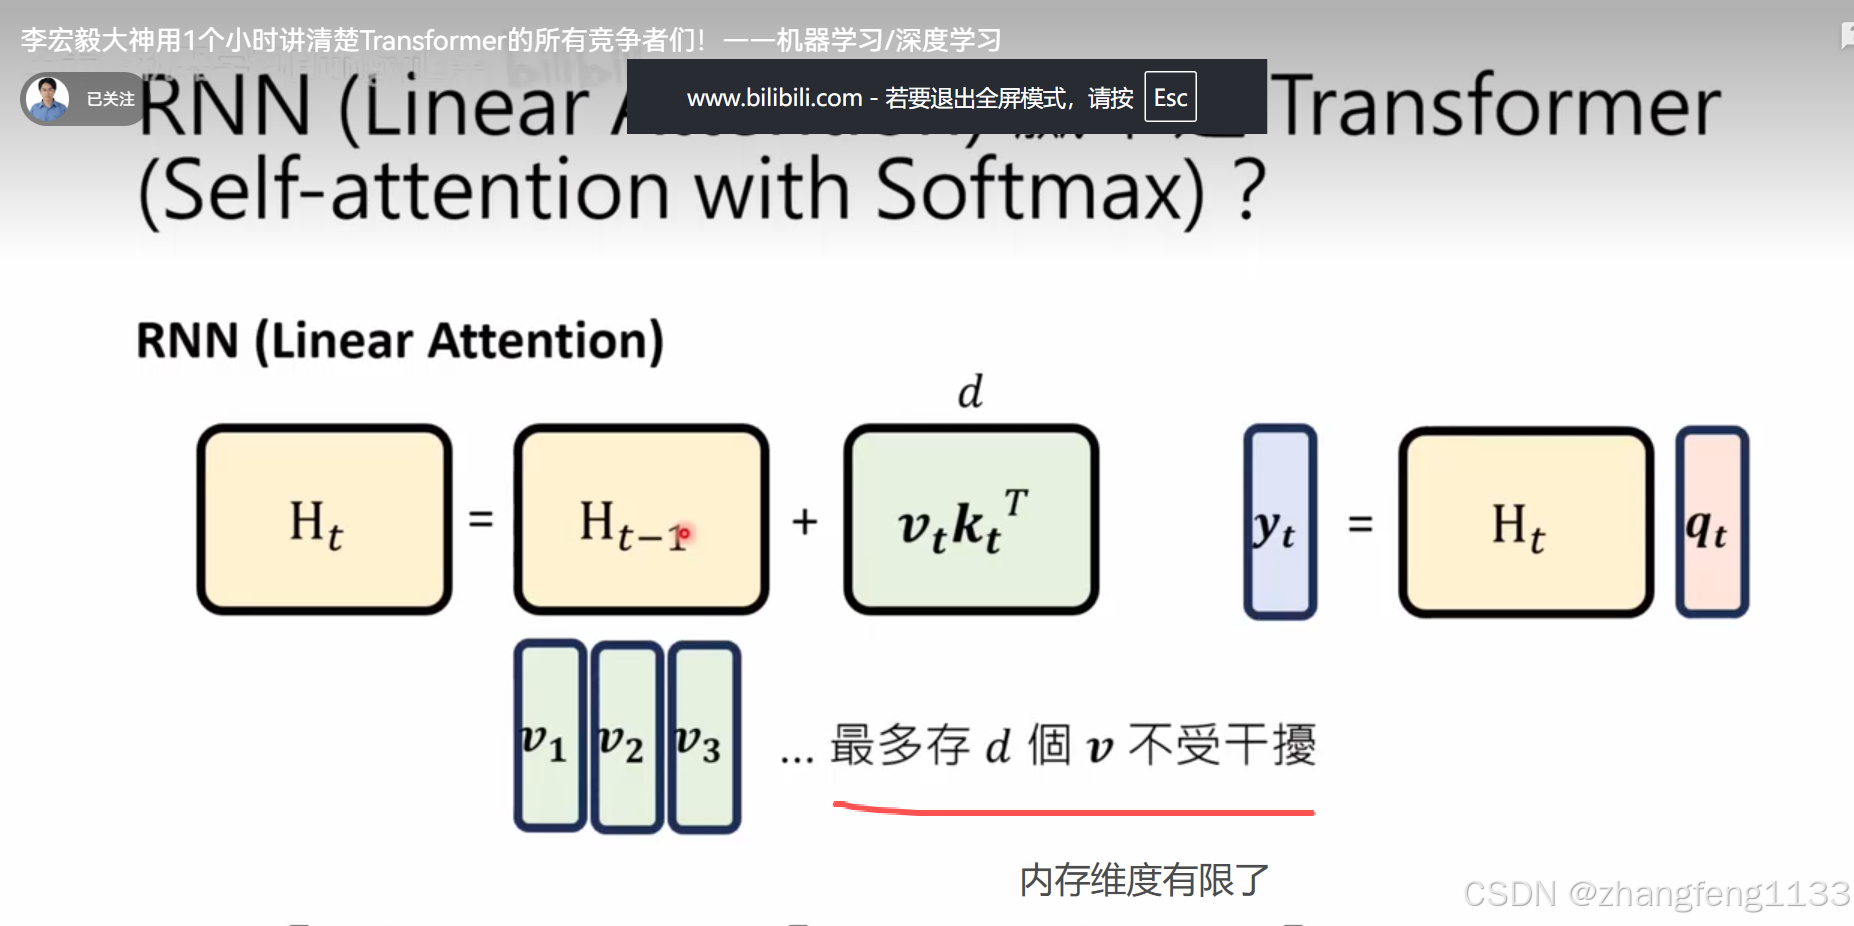
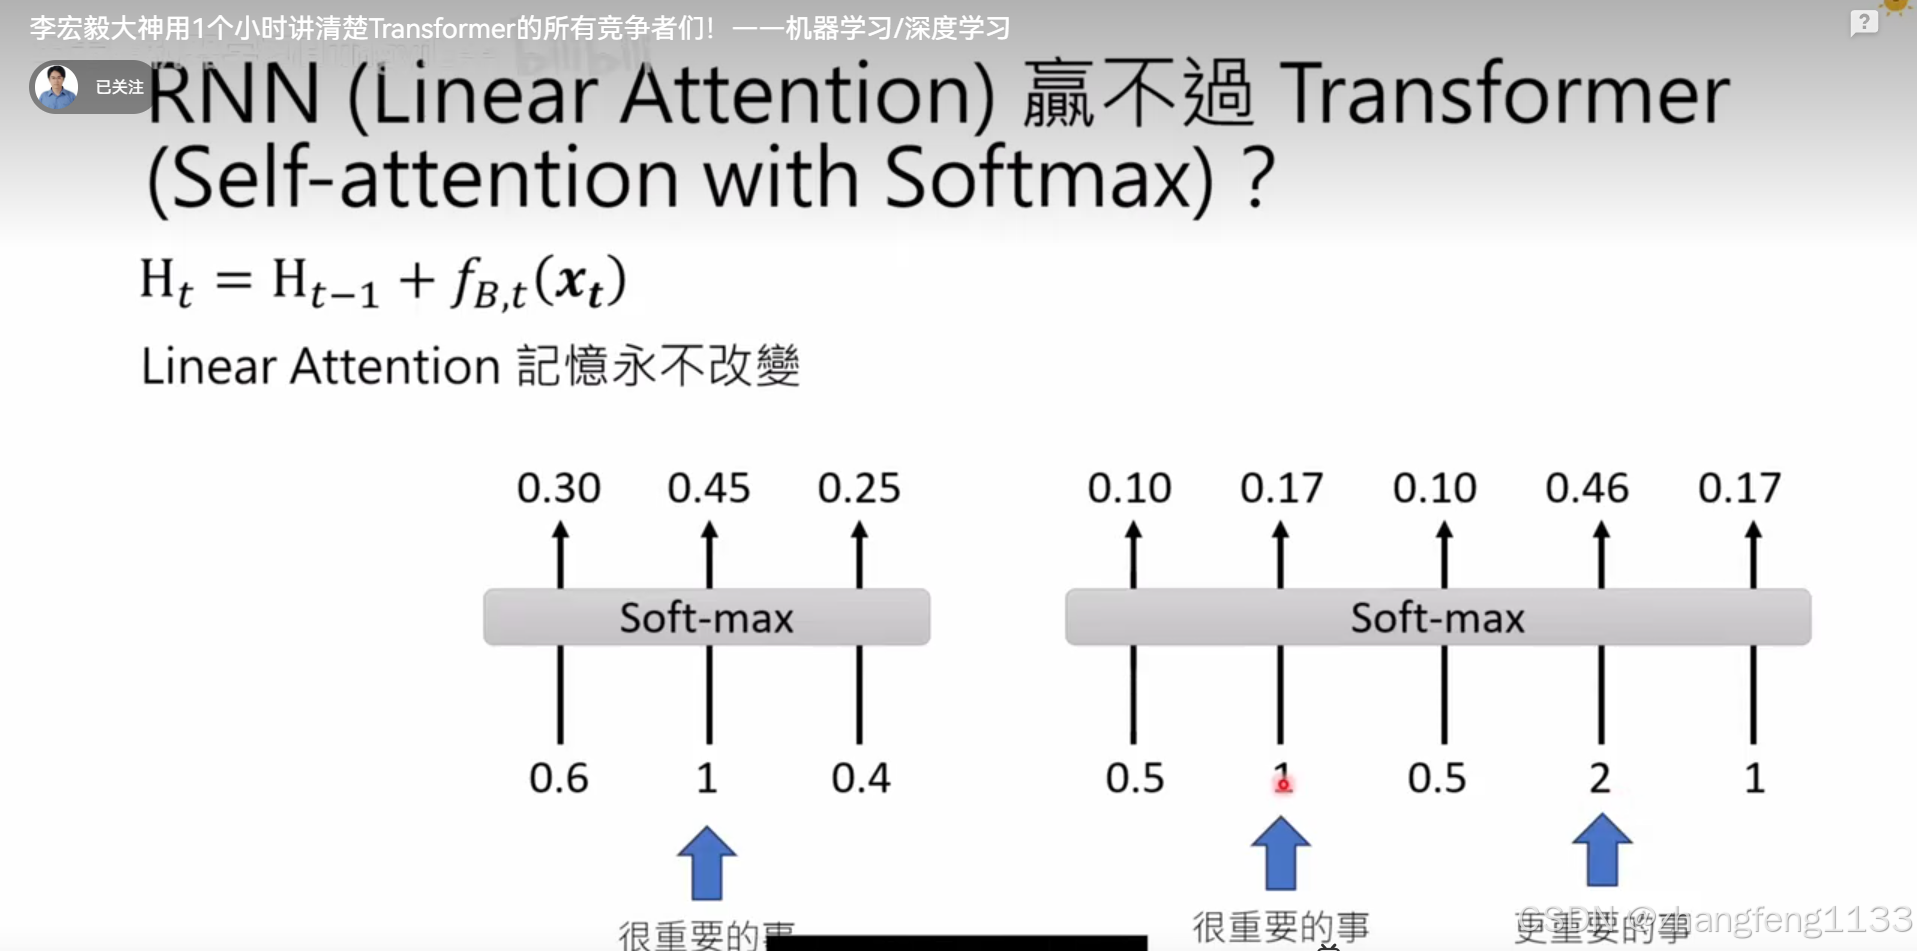
记忆有限 transformer 一样。其实就是少了softmax
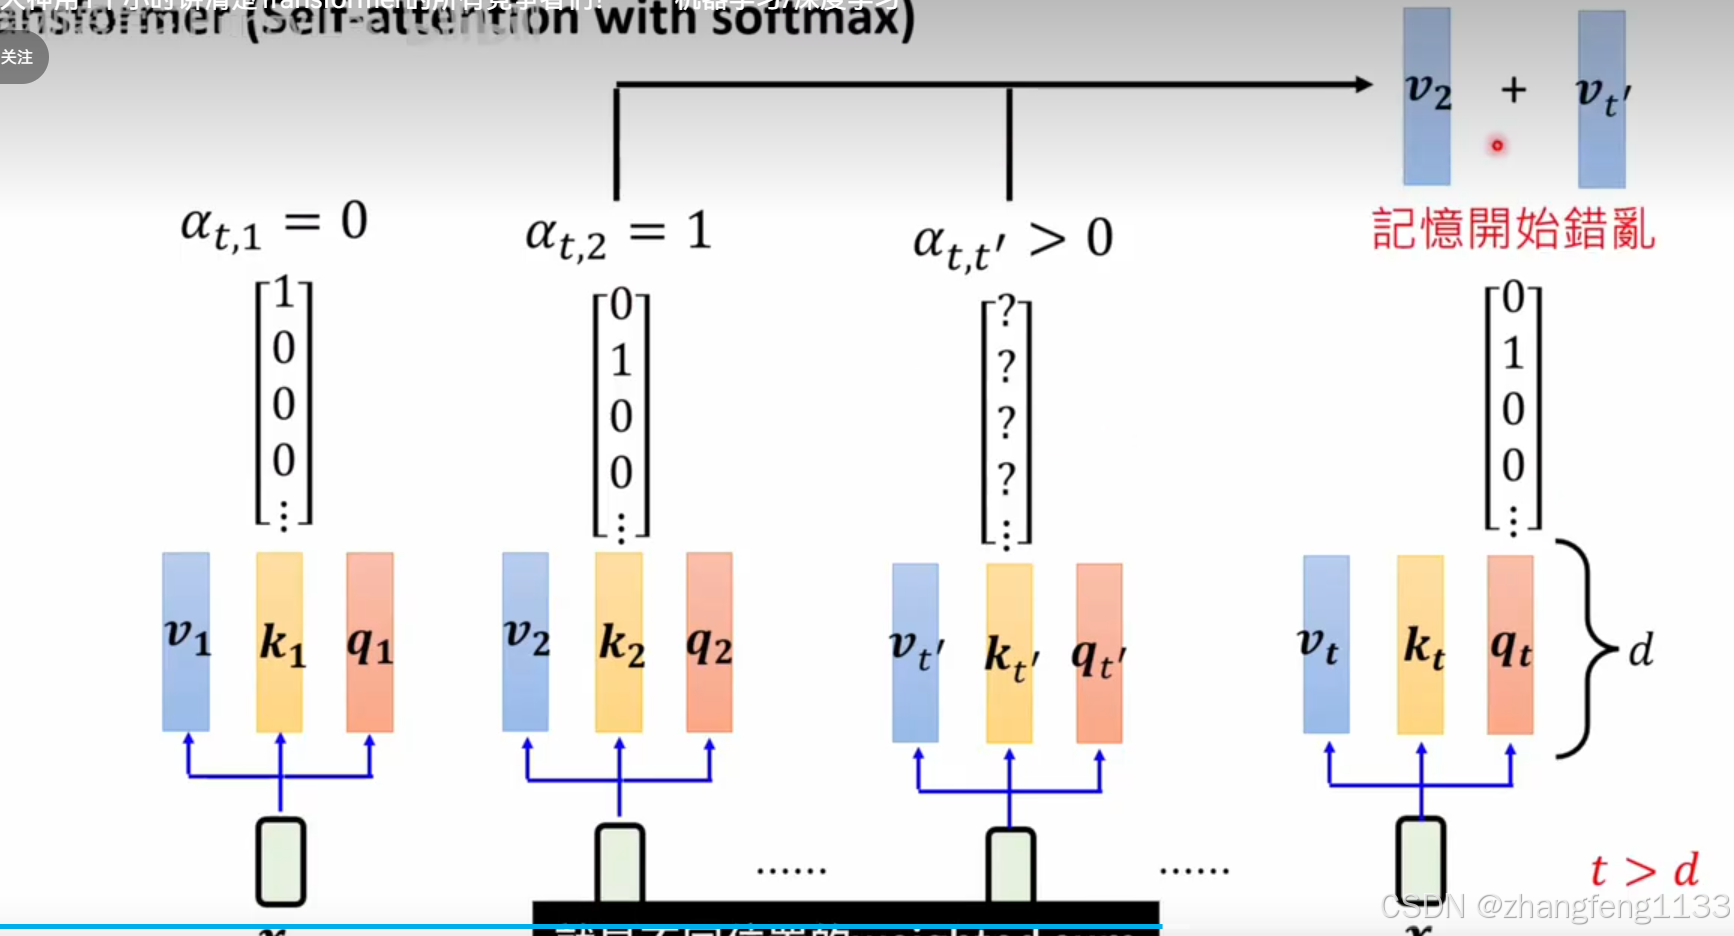
长度够长 数据会重复 ,t>d
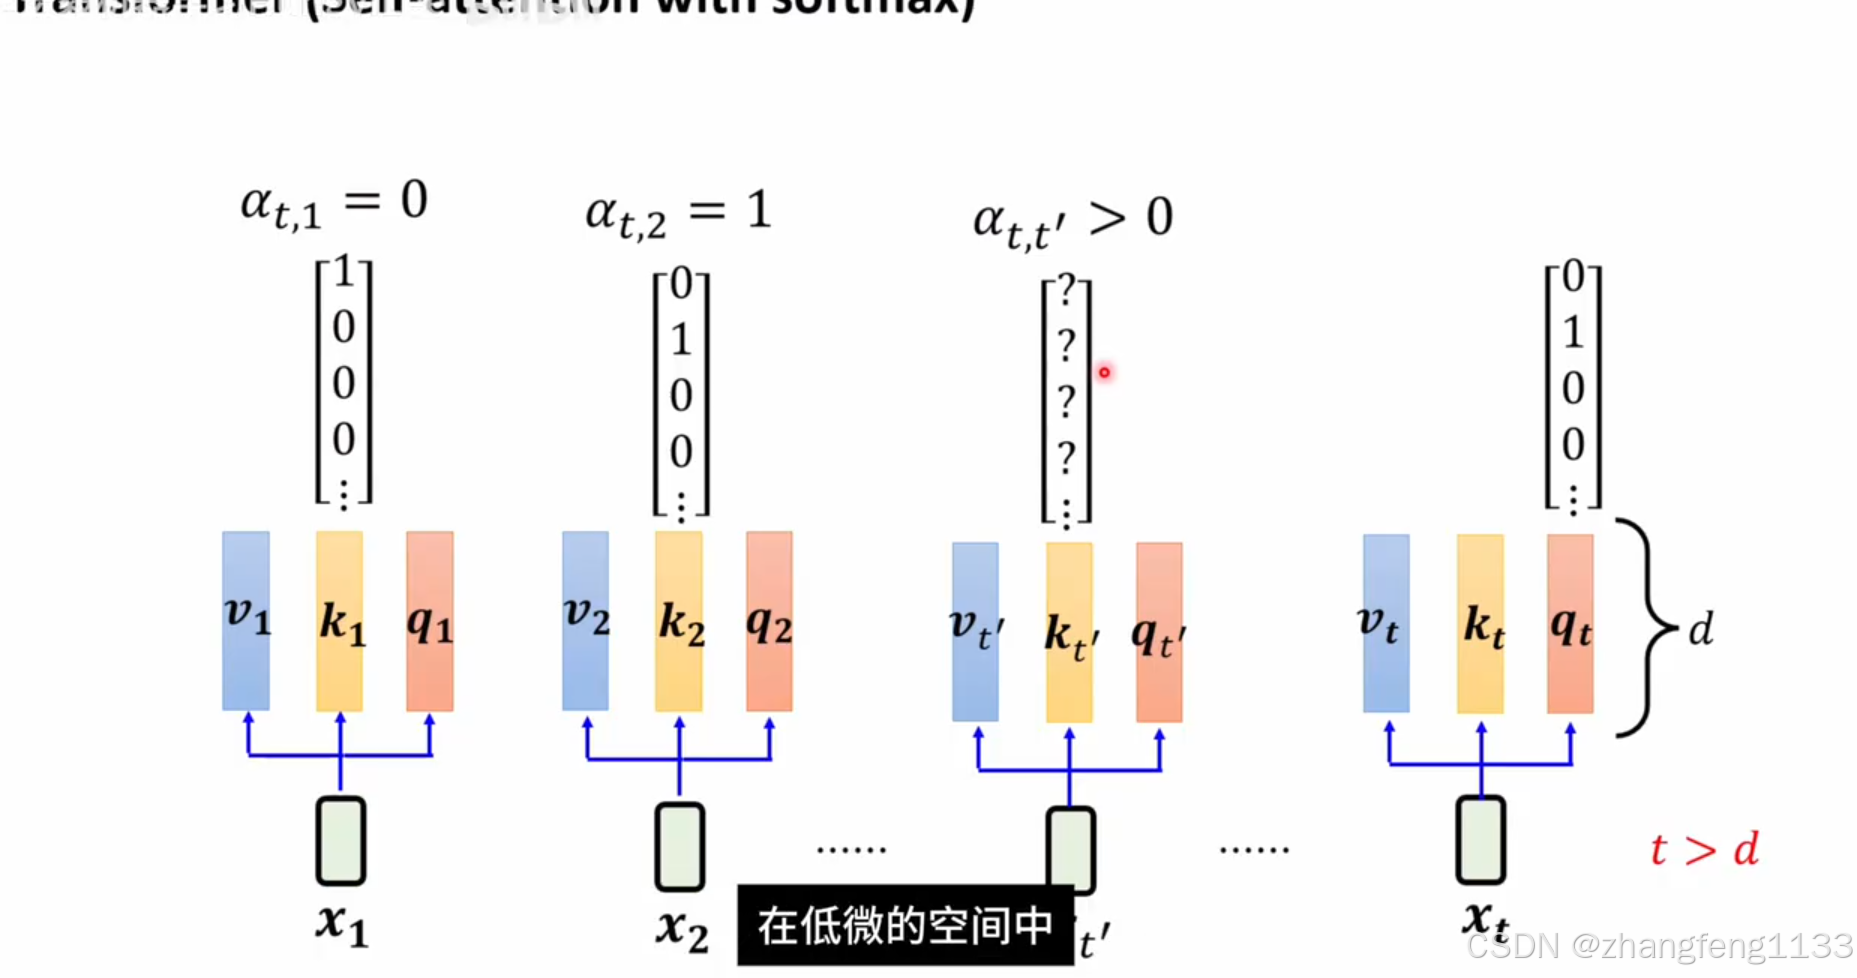
在低维空间中 ,只能找到第一个正交的向量

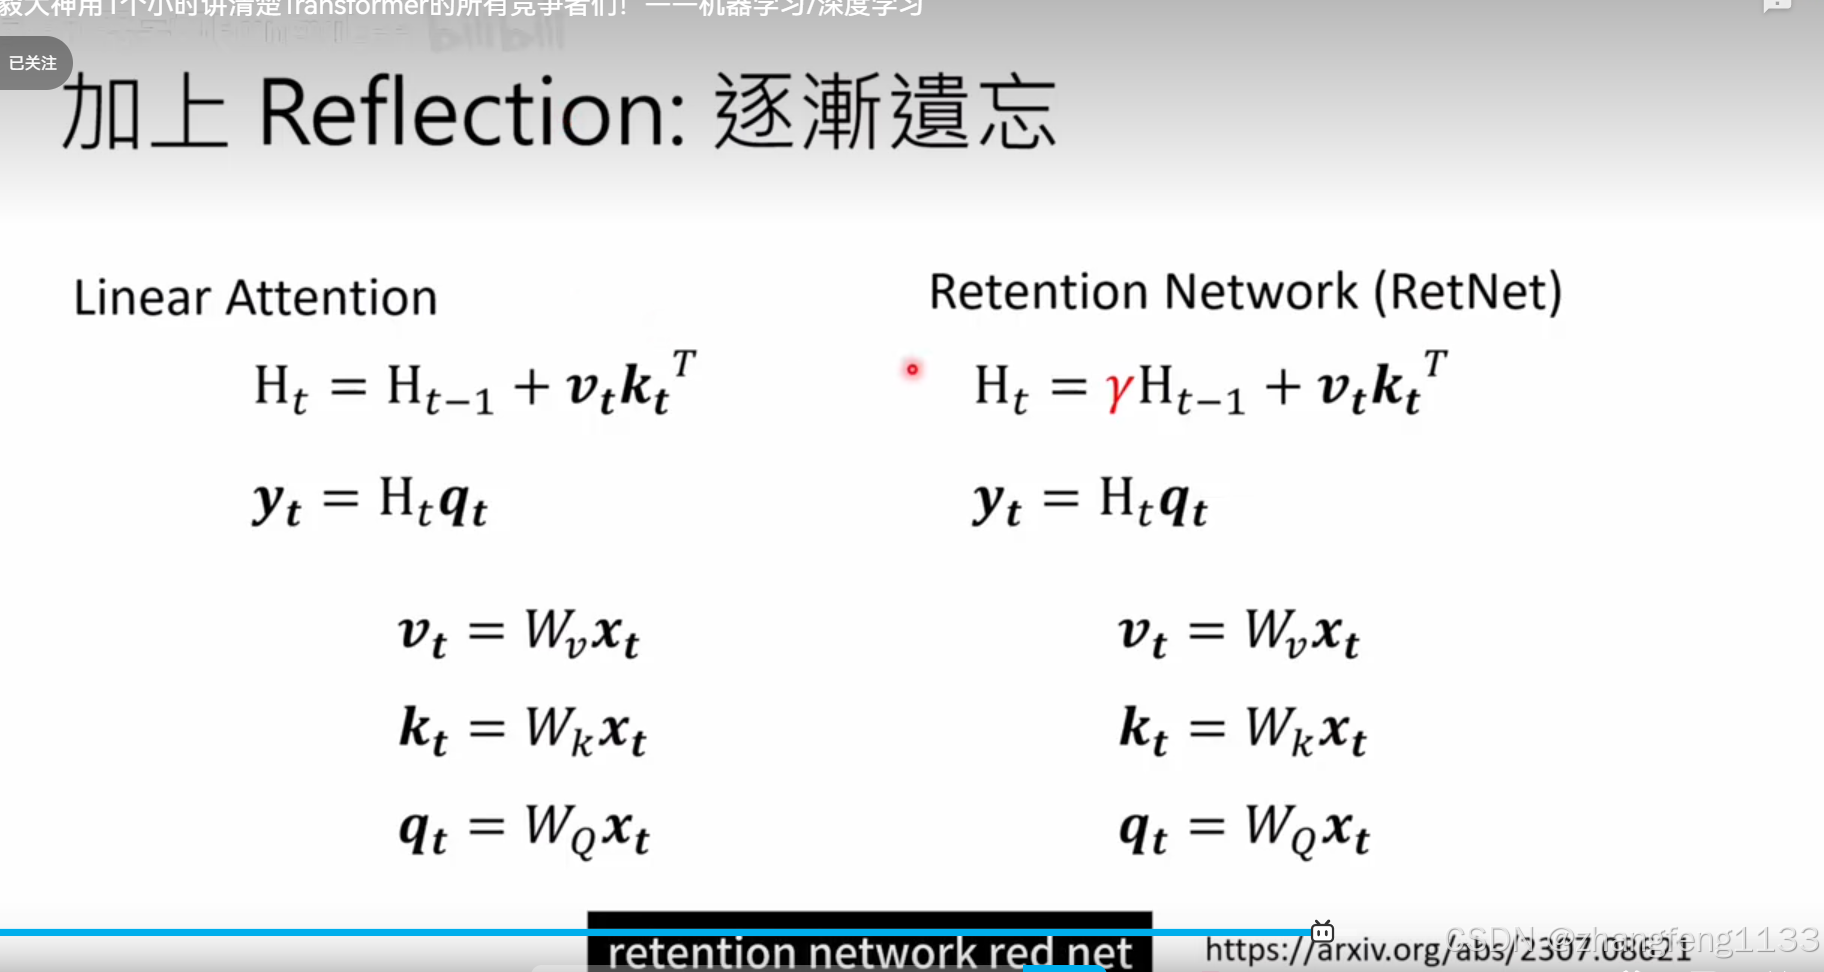
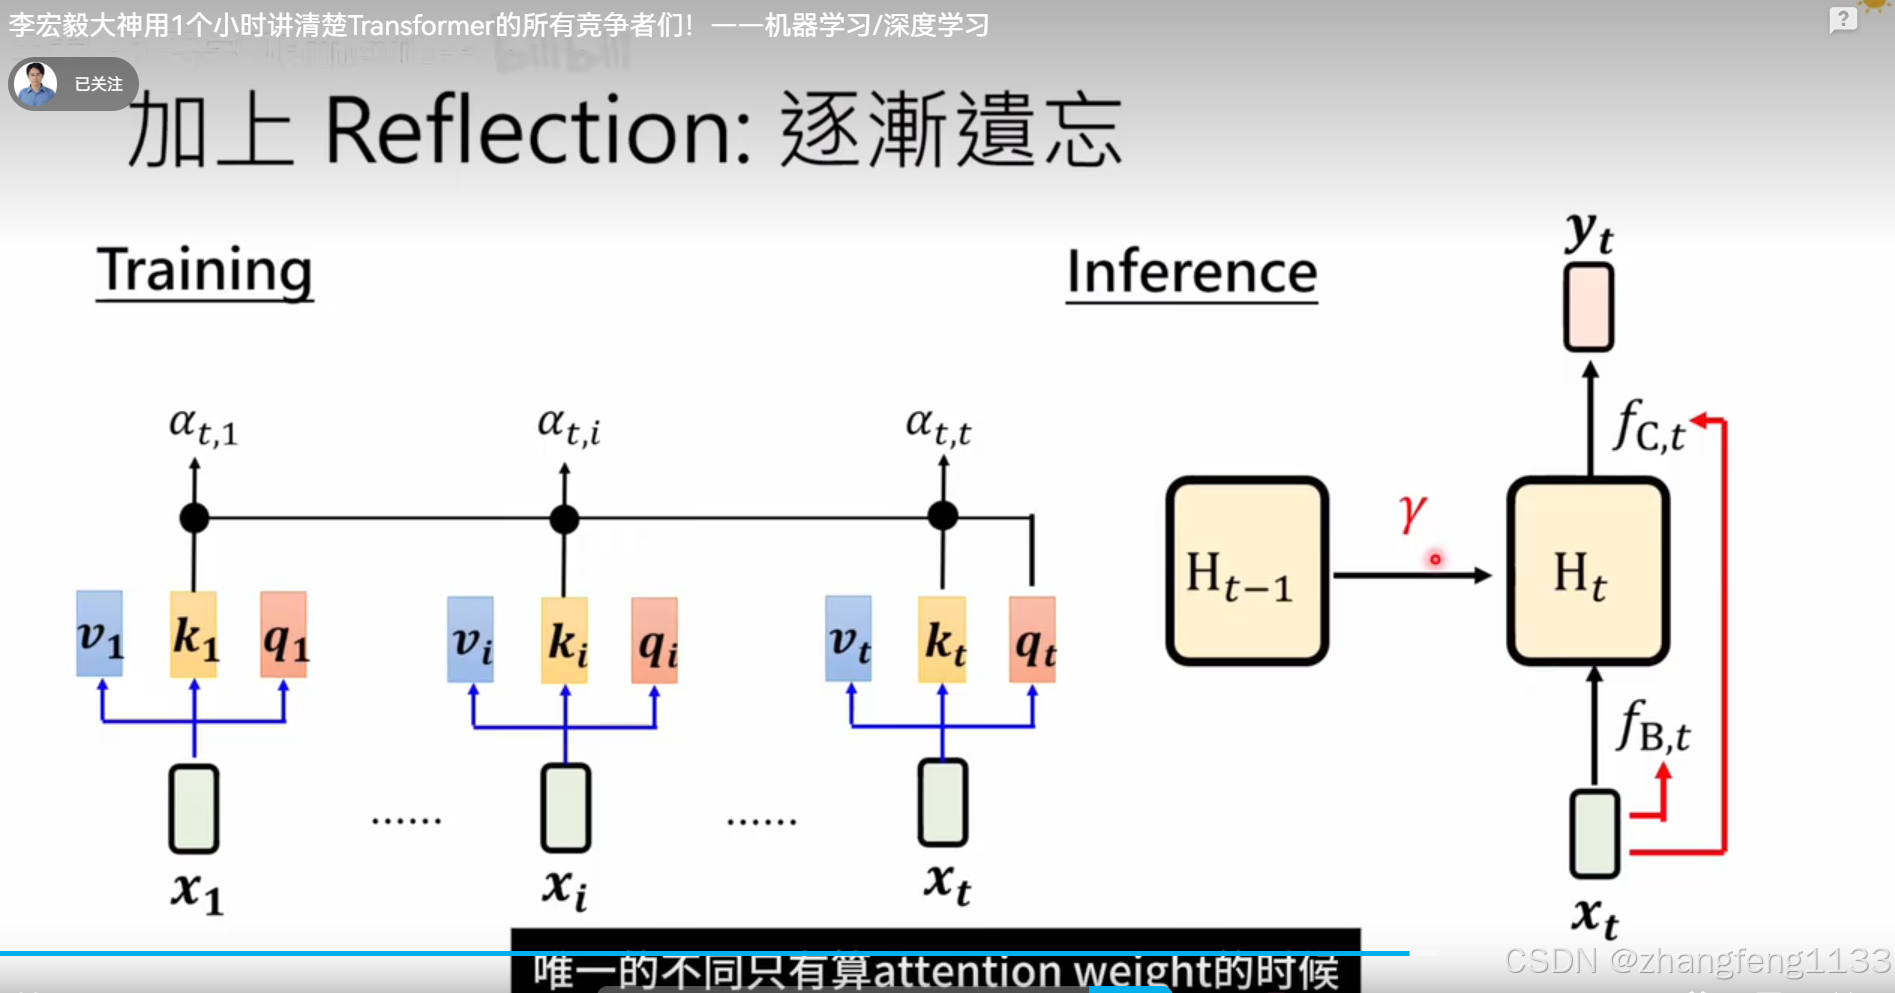
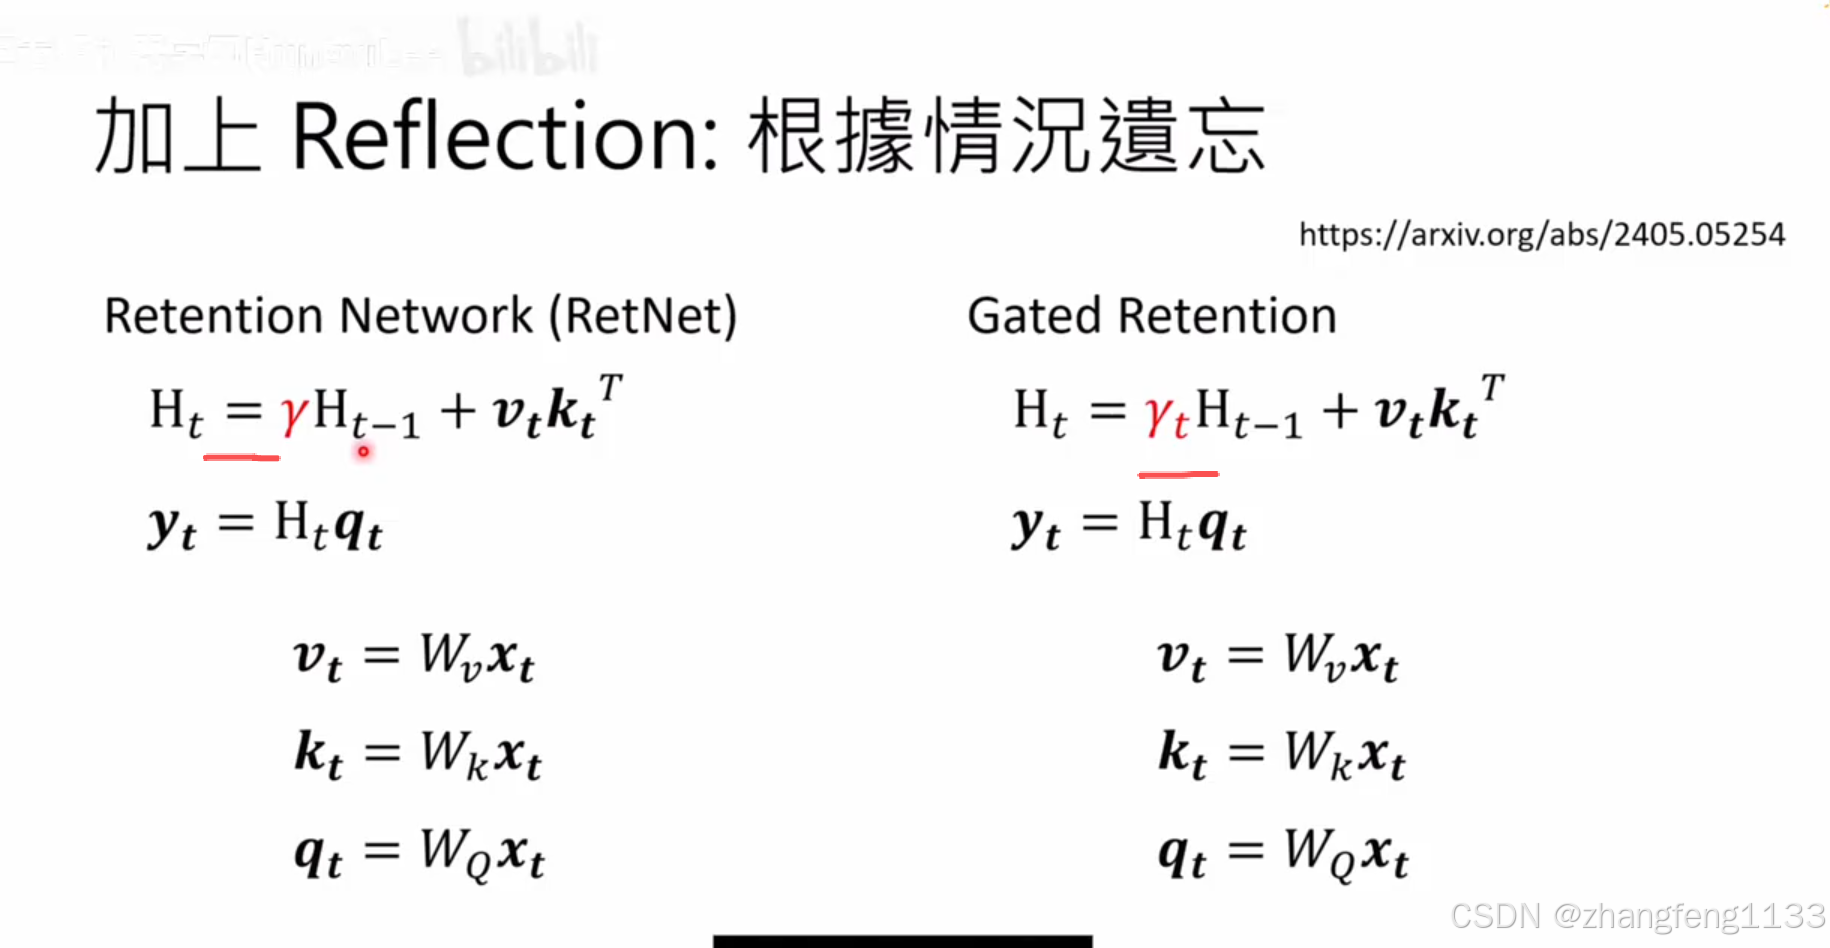
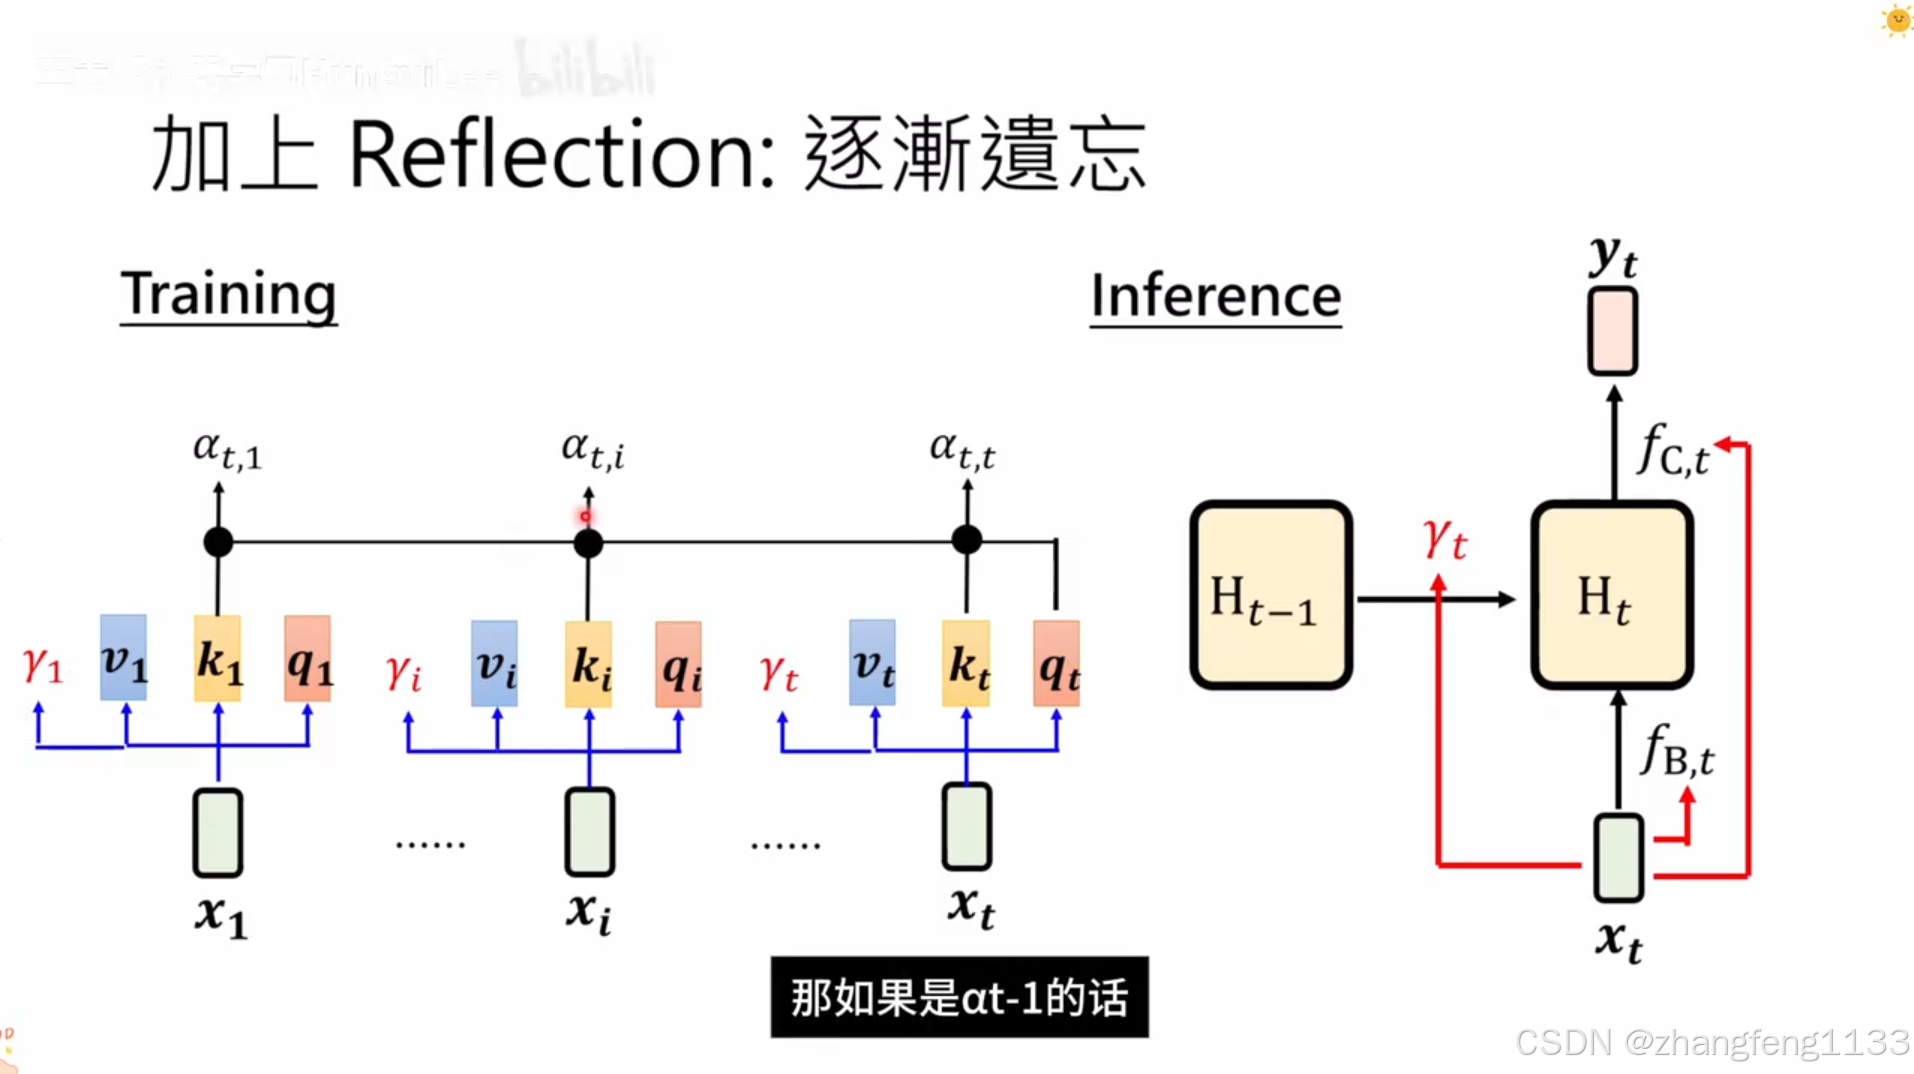
linear attteion 真正的问题,不会遗忘,固定
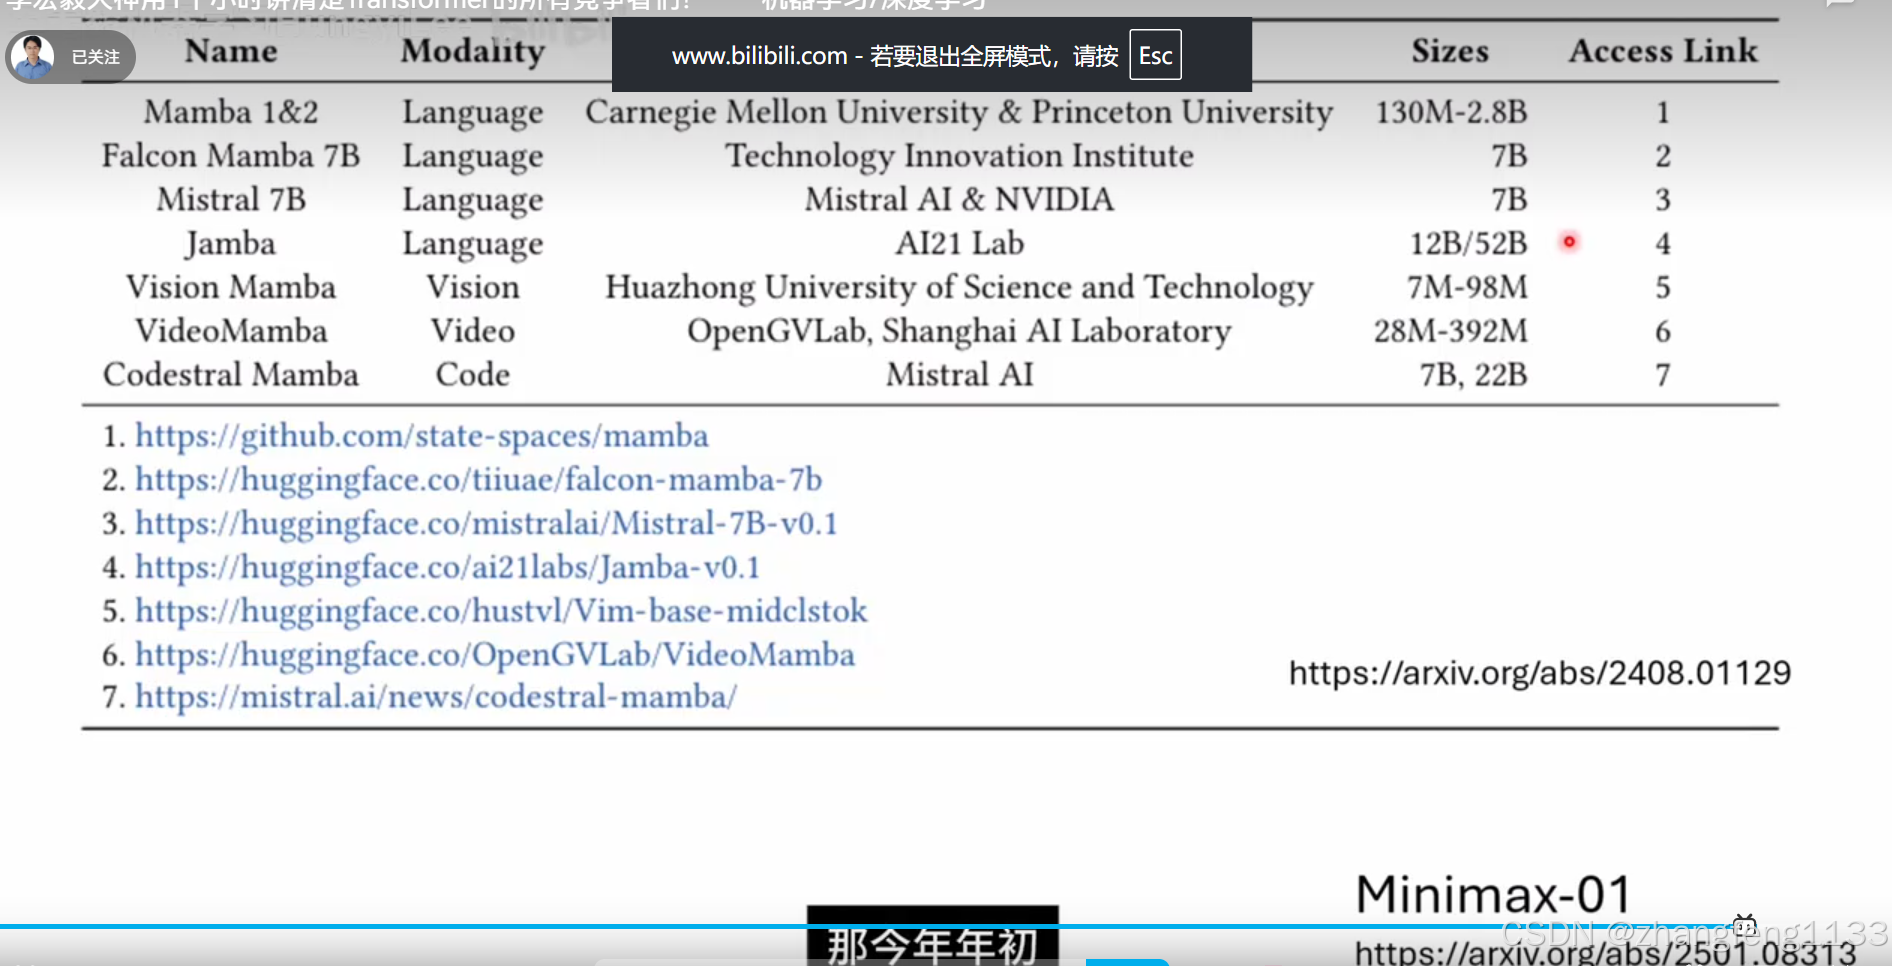
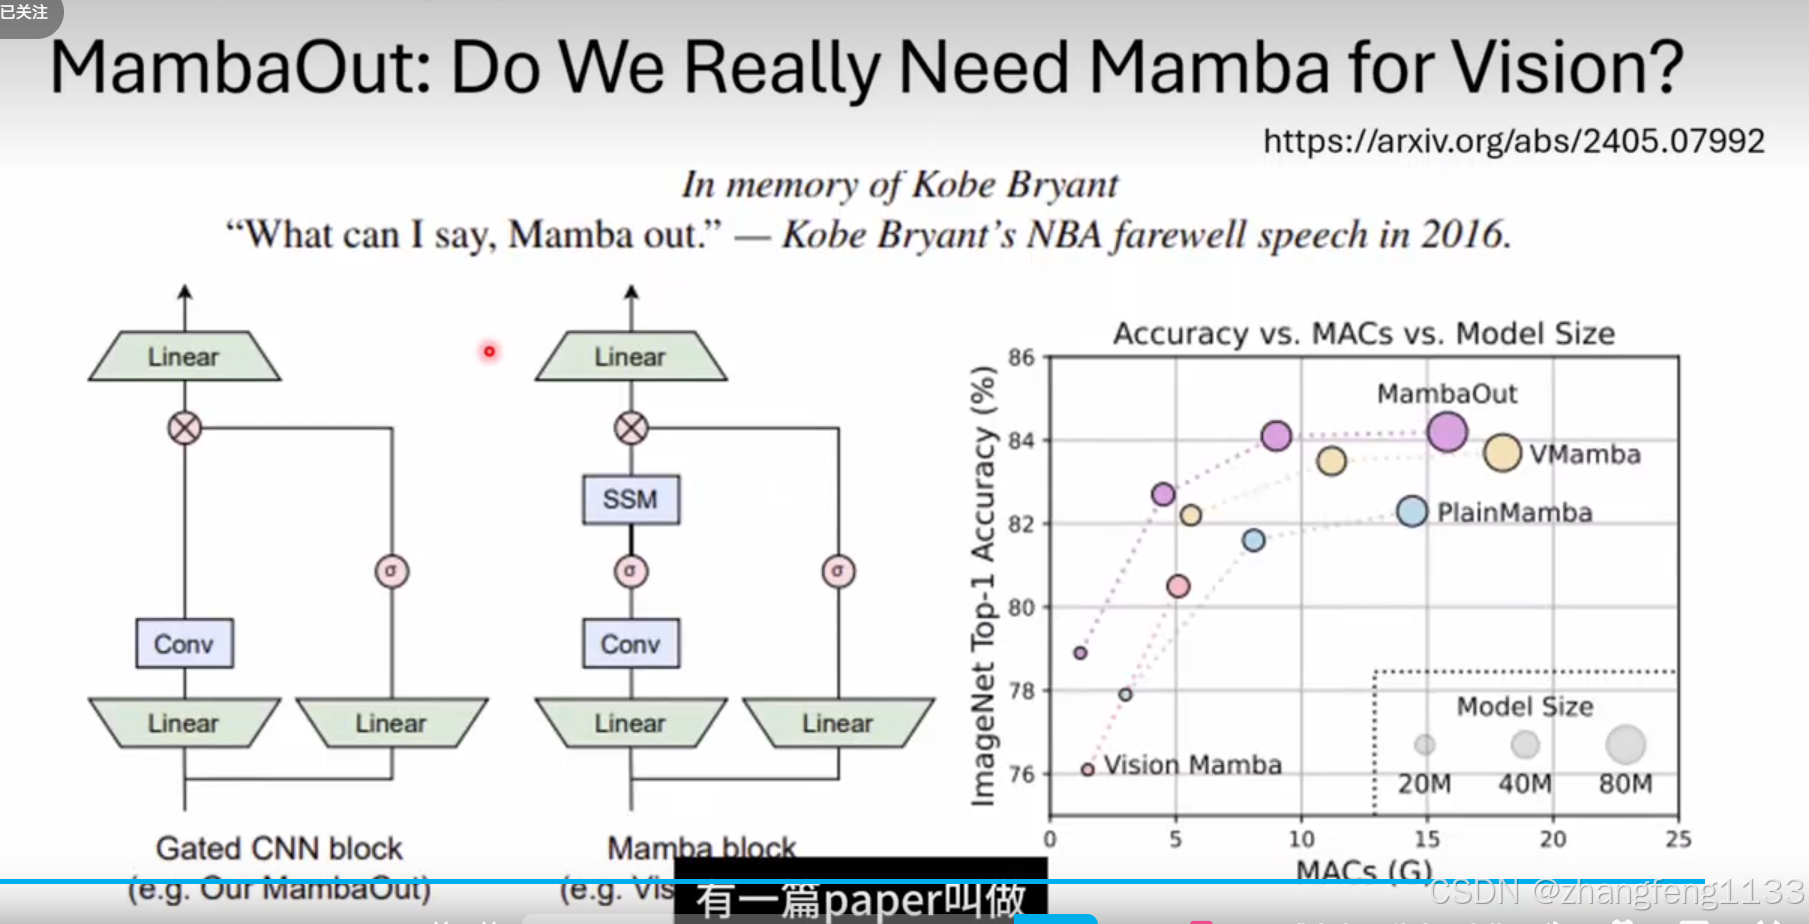
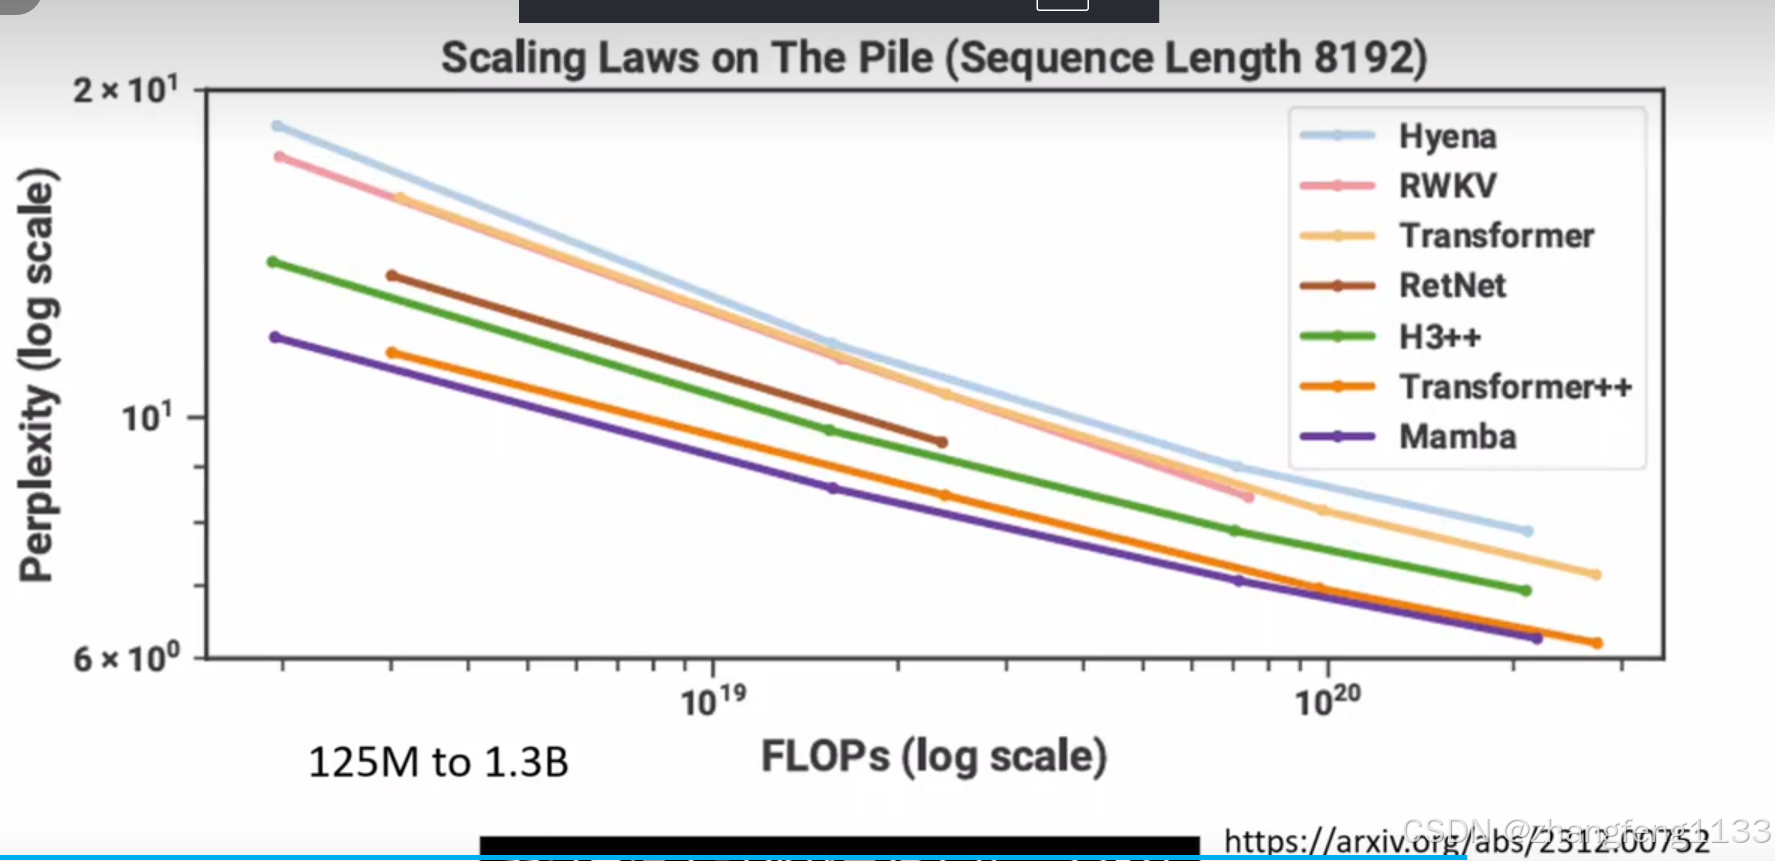
所有lineeare attention 模型列表
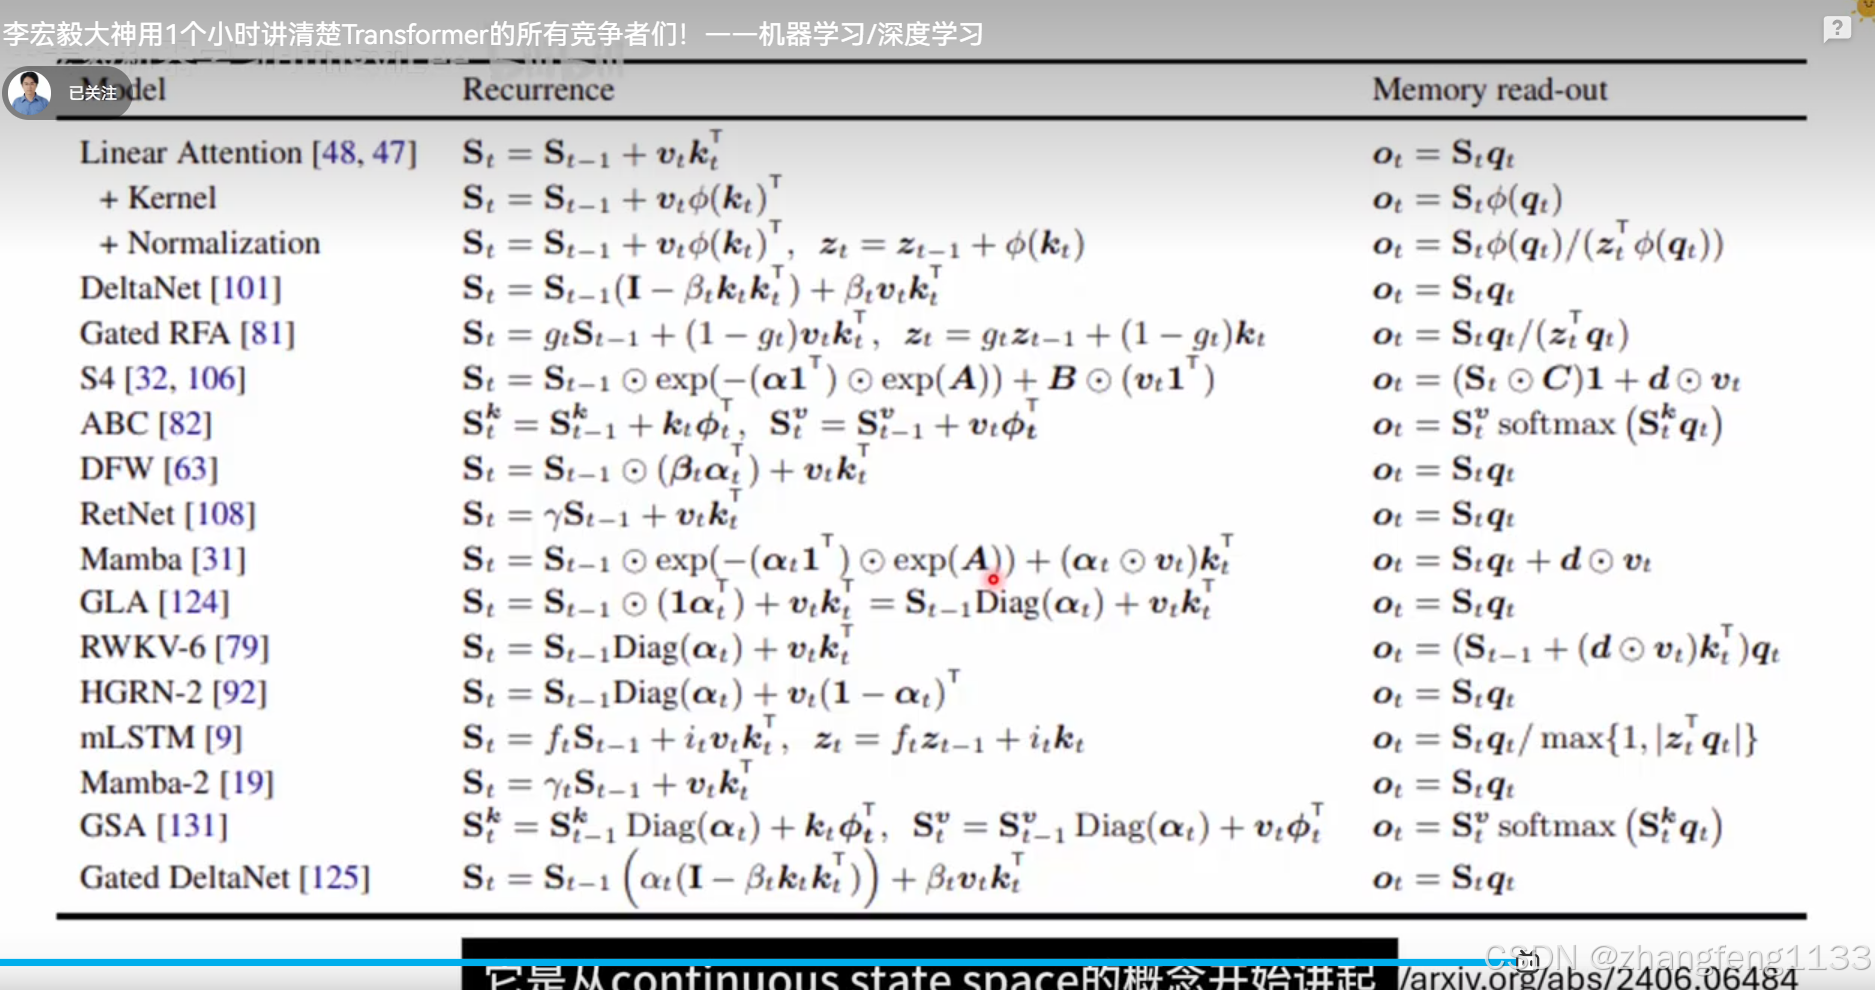
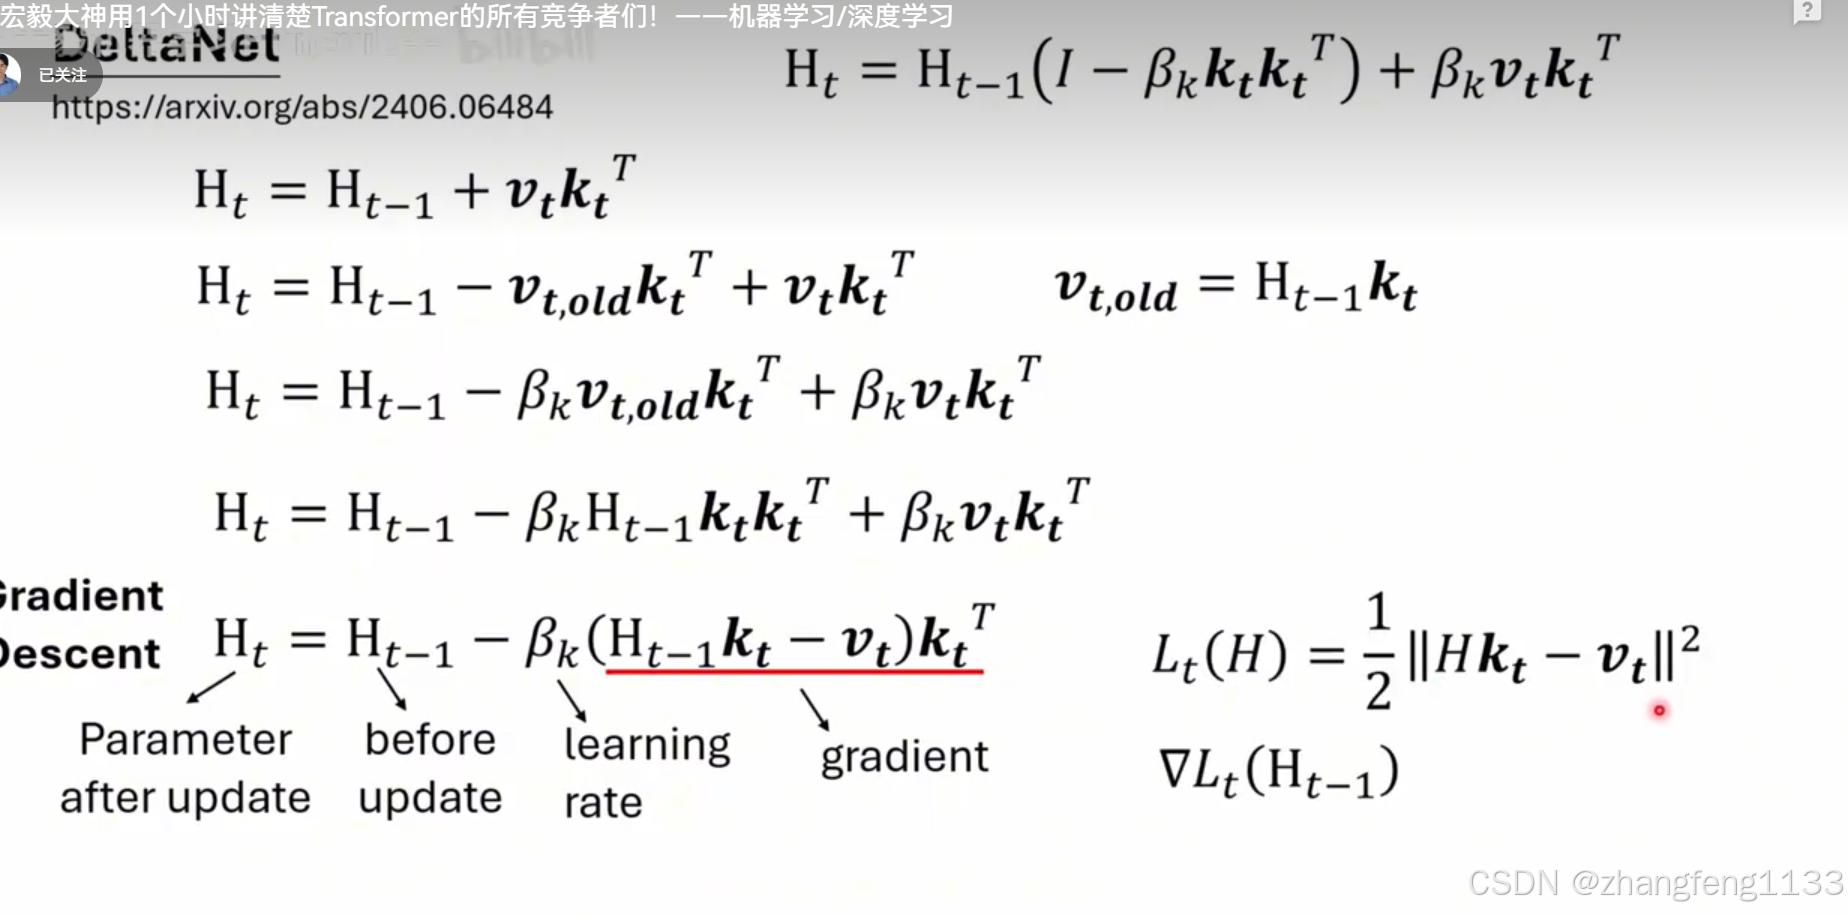
deltanet
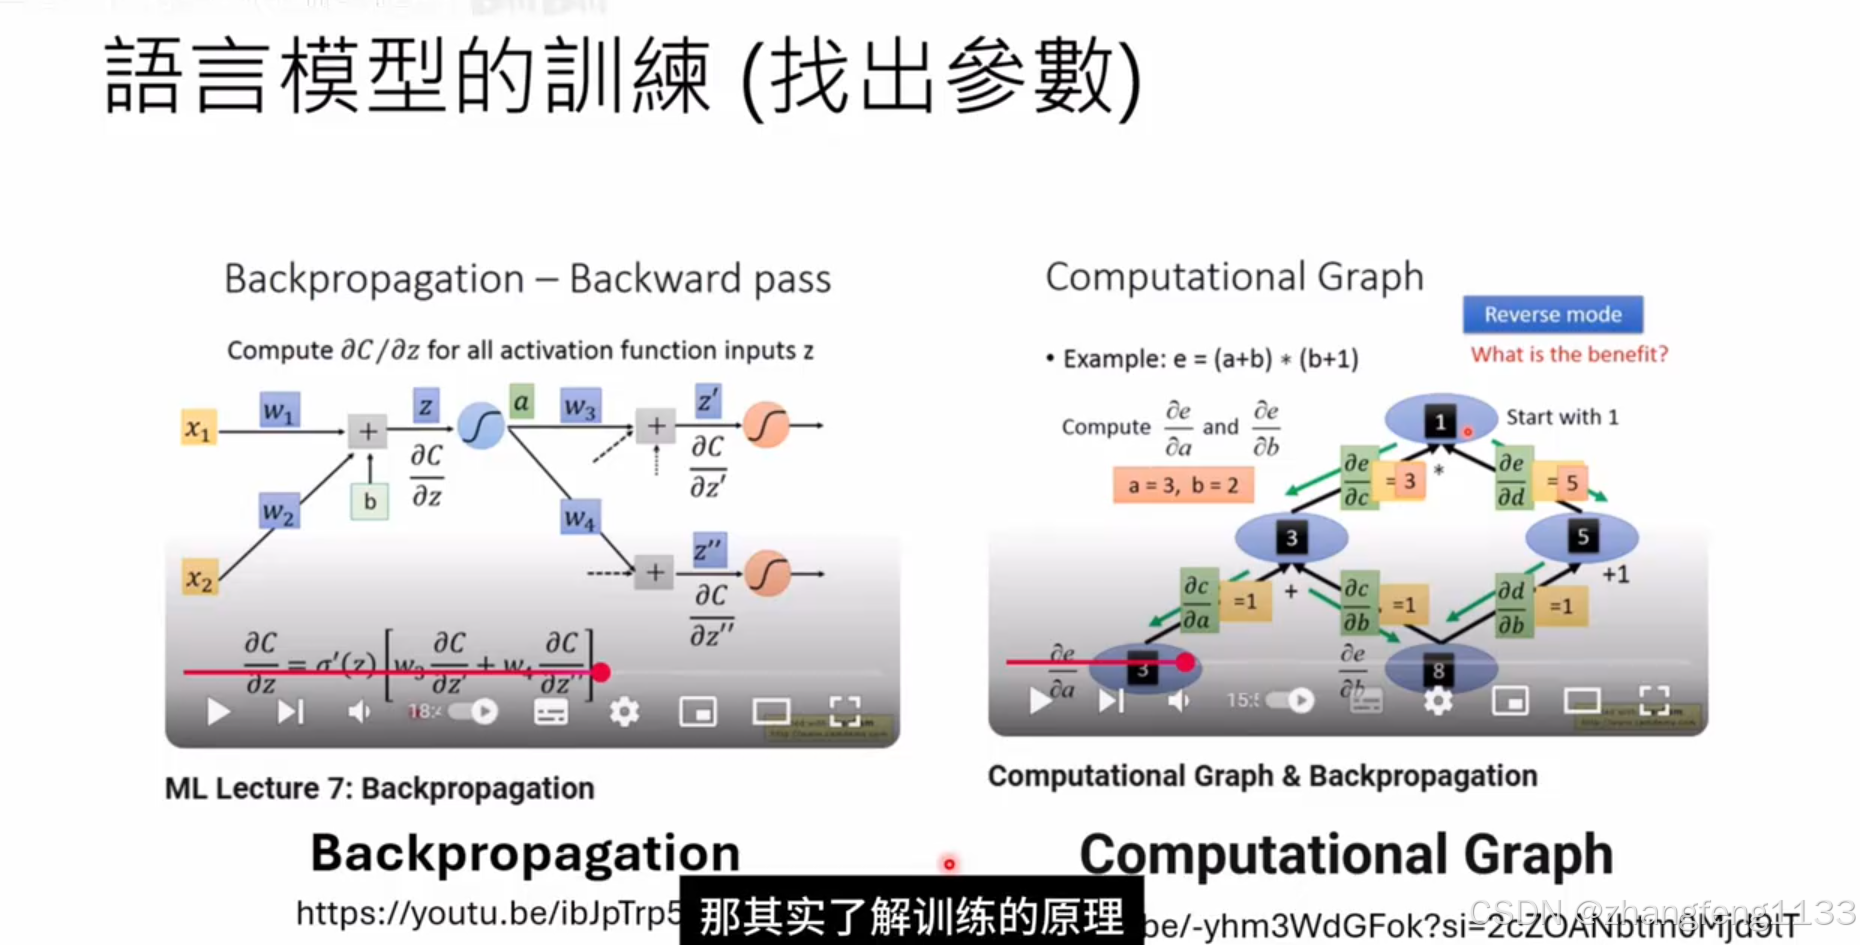
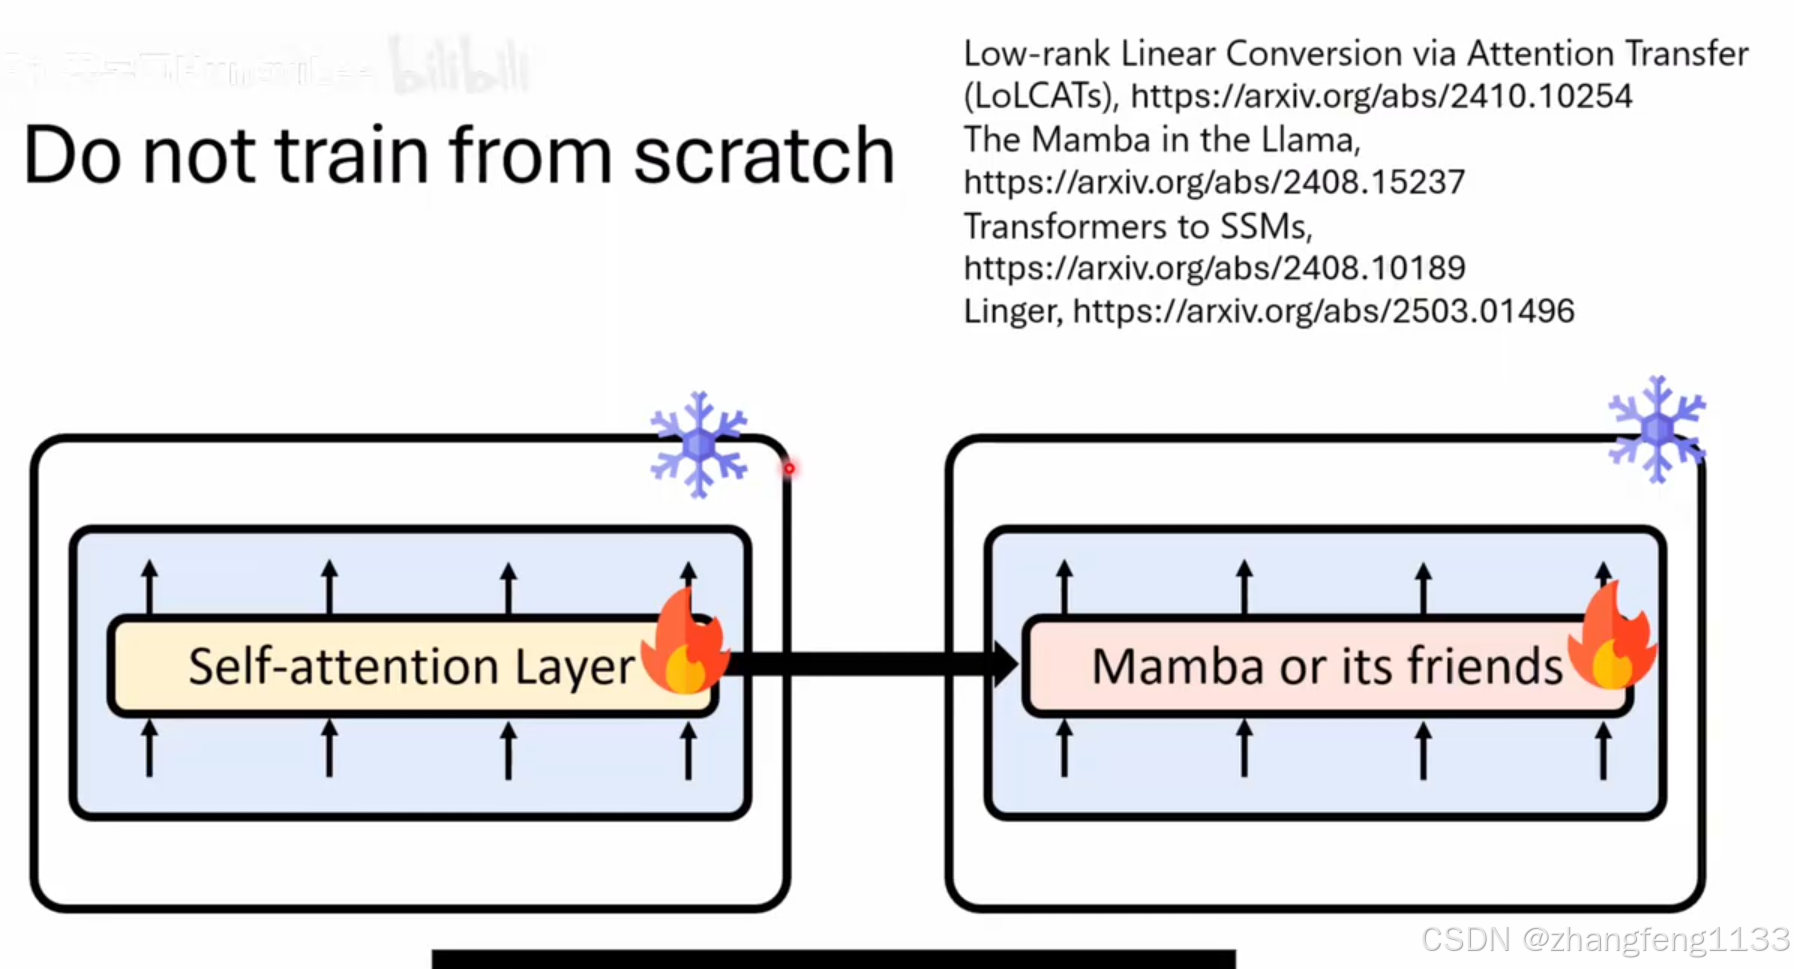
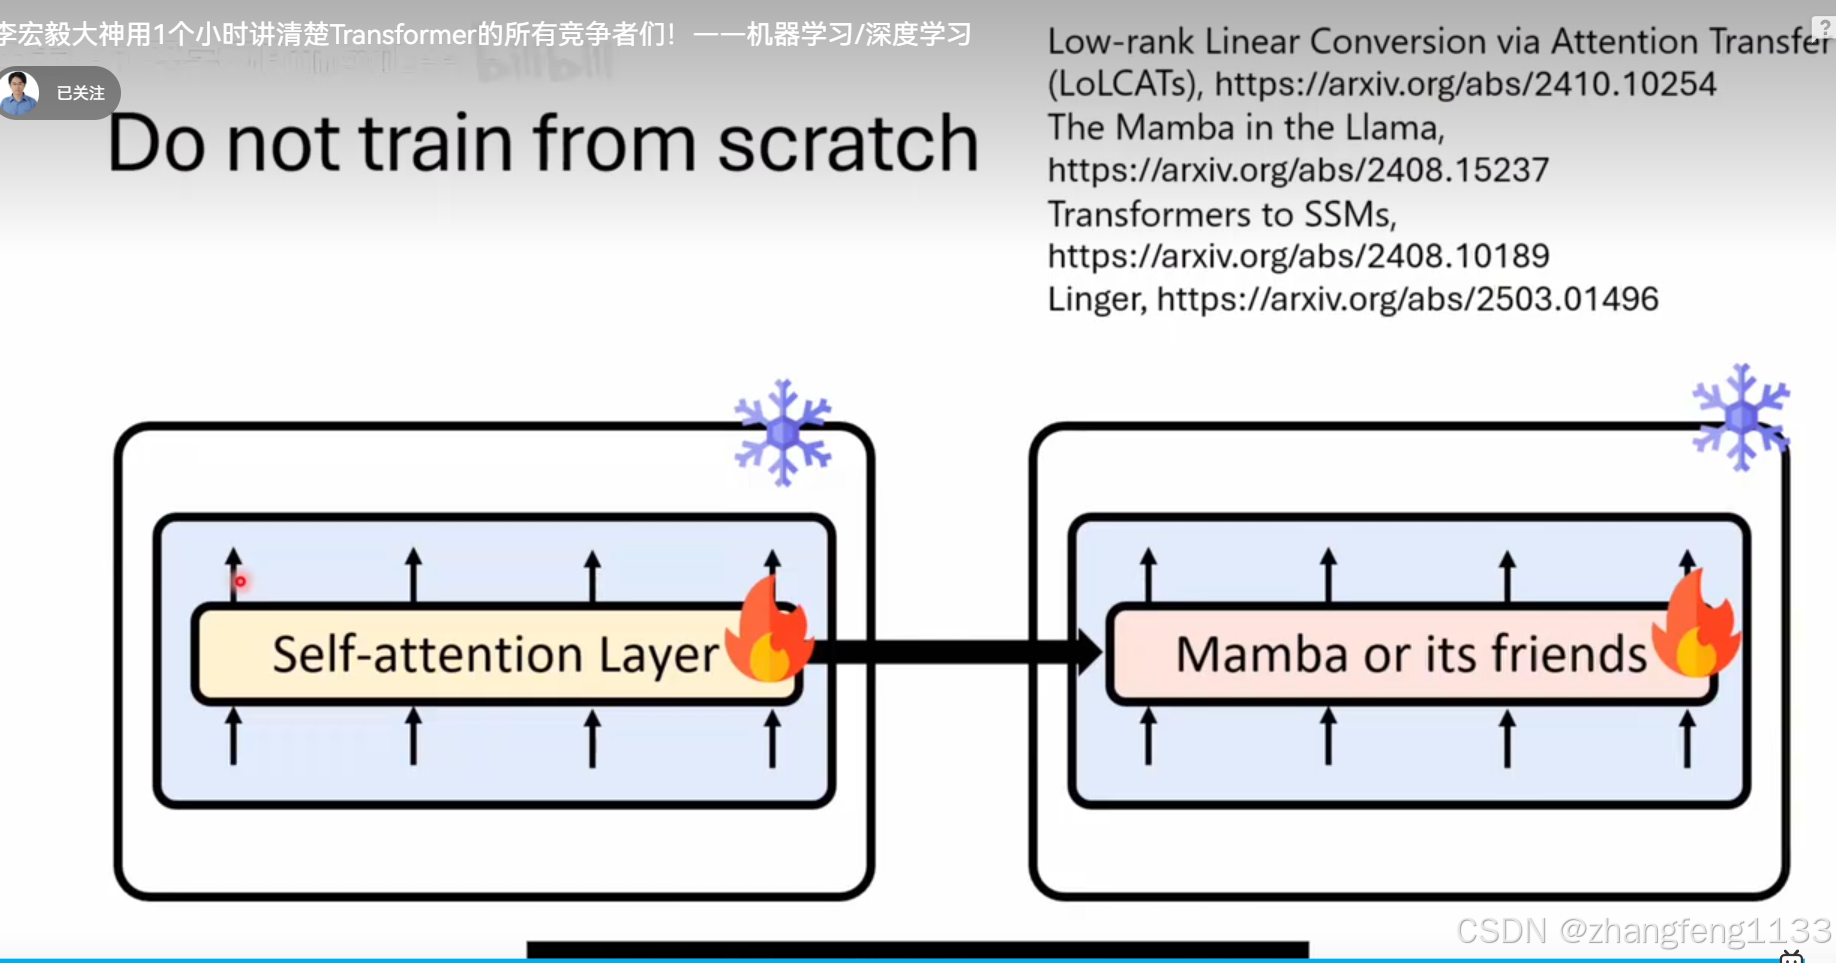
如何训练mamba 现有语言模型,去掉selft-attiion 。然后训练,或者不去掉selft-attention
du局
视频资料

https://www.bilibili.com/video/BV1XBe3zRE18/?spm_id_from=333.337.search-card.all.click\&vd_source=7d3841cb81fdca8b20a31fa9ee5ec8ef

l另外一个视频,

https://www.bilibili.com/video/BV1uEoXBgE7D/?spm_id_from=333.337.search-card.all.click\&vd_source=7d3841cb81fdca8b20a31fa9ee5ec8ef![在这里插入图片描述](https://i-blog.csdnimg.cn/direct/00fa12ae7db14d3da420ecf3600ac36c.png)

相关推荐
深圳老胡11 分钟前
STM32 开发中 Trae 内置模型怎么选:Seed、MiniMax、GLM、DeepSeek、Kimi、Qwen 全对比
笔记·stm32·单片机·嵌入式硬件·代码规范·1024程序员节
蒲公英eric20 分钟前
逻辑回归与信用违约预测:从S曲线到分类器
人工智能·数学建模·逻辑回归
坤坤子吖44 分钟前
C++继承:友元、静态成员、多继承与组合
开发语言·c++·笔记·学习·1024程序员节
安睿杰翻译(上海)有限公司1 小时前
AI 同传技术链路拆解:准确率、时延瓶颈、术语库工程化与会议落地选型方案
人工智能
不老刘1 小时前
异构双 Agent 协同:构建无人值守的长任务自动化研发流水线
运维·人工智能·自动化·ai编程·1024程序员节
迷途呀1 小时前
强化学习概念
人工智能·深度学习·机器学习·强化学习·1024程序员节
技术小甜甜1 小时前
【Cursor】Skill 被标黄色警告,怎么改成合格的 SKILL.md
开发语言·javascript·ai编程·cursor·1024程序员节·ai agent·skills
AI开源软件1 小时前
87.4%:OpenAI 让模型写出 20 种语言 SQLite
人工智能·ai·openai·fortran·cobol·技术翻译·银行核心系统
爱喝雪碧的可乐1 小时前
OpenAI Codex完成率
大数据·人工智能·1024程序员节
Solange__1 小时前
文旅景区怎么用AI生成3D导览?从航拍采集、地标重建到网页漫游的完整方案
人工智能·3d·语言模型·自然语言处理·材质·贴图·1024程序员节