最近写代码有种很诡异的感觉:在 26 年,手里的 AI 模型比以往任何时候都强,开源框架满天飞,但团队实际跑完一个项目的交付周期,反而越拉越长了?
前几天组内复盘,看着越堆越高的技术债,大家承认了一个事实:在所谓"AI 提效"的繁荣之下,我们的开发效率其实正在经历断崖式下跌。
1. 工具通胀:大家都沦为了"全栈 API 适配员"
以前觉得接入大模型就是调个接口的事。但现在每出一个新模型,就跟着来一套专门的 SDK。为了让系统效果更好,我们往往需要接入不同的服务。
如果你只接两三个模型,那还好说。但现在随便做一个稍微复杂点的多模态 Agent,动辄要跨平台调度 10 个以上的模型。这时候,系统复杂度的增长是指数级的。并发限制不一样、超时阈值不一样、连返回字段的语义都能给你玩出花来。结果就是,开发的大量时间全耗在了解决这些微小的"排异反应"上,天天在文档、Token 鉴权和 API 变更里打转。我们不再是写核心逻辑的工程师,全变成了给各种大模型擦屁股的"全栈 API 适配员"。
2. AI 开发变成了昂贵的体力活
早几年,大家觉得搞 AI 开发,核心竞争力是"会写牛逼的 Prompt"。放到今天来看,简直是个笑话。
现在的 AI 研发日常是什么样?你必须得是个架构师(搞定分布式并发任务),还得是运维(天天盯着 API 可用性和限流报警),甚至还得兼职成本分析师(精算各个模型的 Token 消耗和性价比),最后才是个写后端的。
这种极高的认知负载,把团队折磨得疲于奔命。每天一睁眼就是处理极其琐碎的底层调度和异常,这种精神内耗直接榨干了团队的创造力。再这么搞下去,AI 开发就不叫前沿科技了,这就是纯纯的高薪体力活。
3. 放弃"拼图模式"
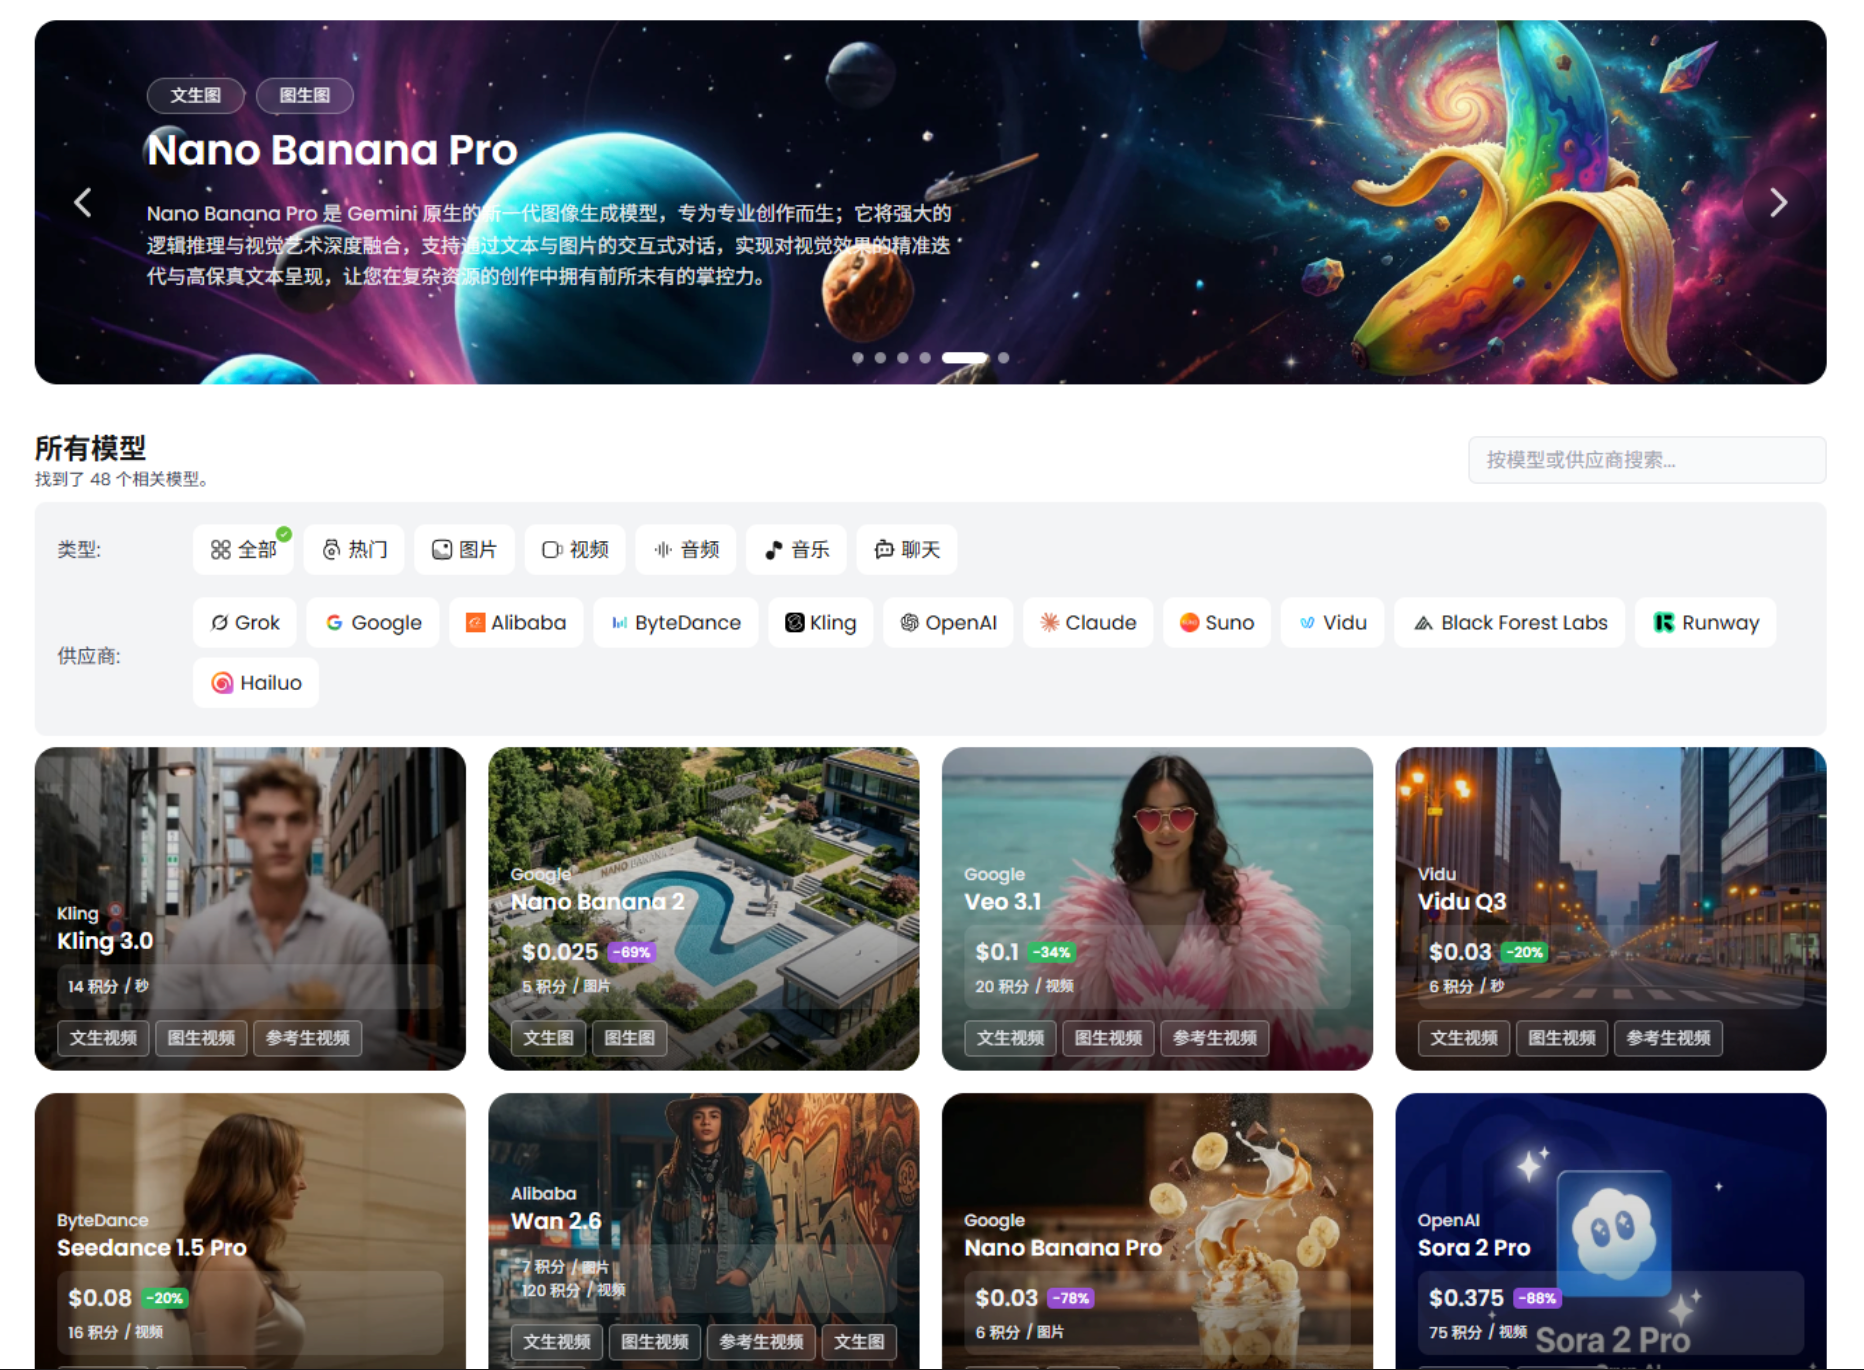
剖析我们现在烂摊子的根源,其实在于大部分团队还在用早期的"拼图模式"。 需要文本能力?接 OpenAI;需要视频?去调 Runway;要出图?弄个 Midjourney 或者 Flux 的接口。最后找个开源框架,硬生生把它们像缝合怪一样拼在一起。
这种"胶水架构"在本地跑个 Demo 看着很炫酷,一上生产环境立马原形毕露。一旦某个底层 API 翻新,整个调用链路全崩,后期的维护成本高到离谱。
真正的效率拐点
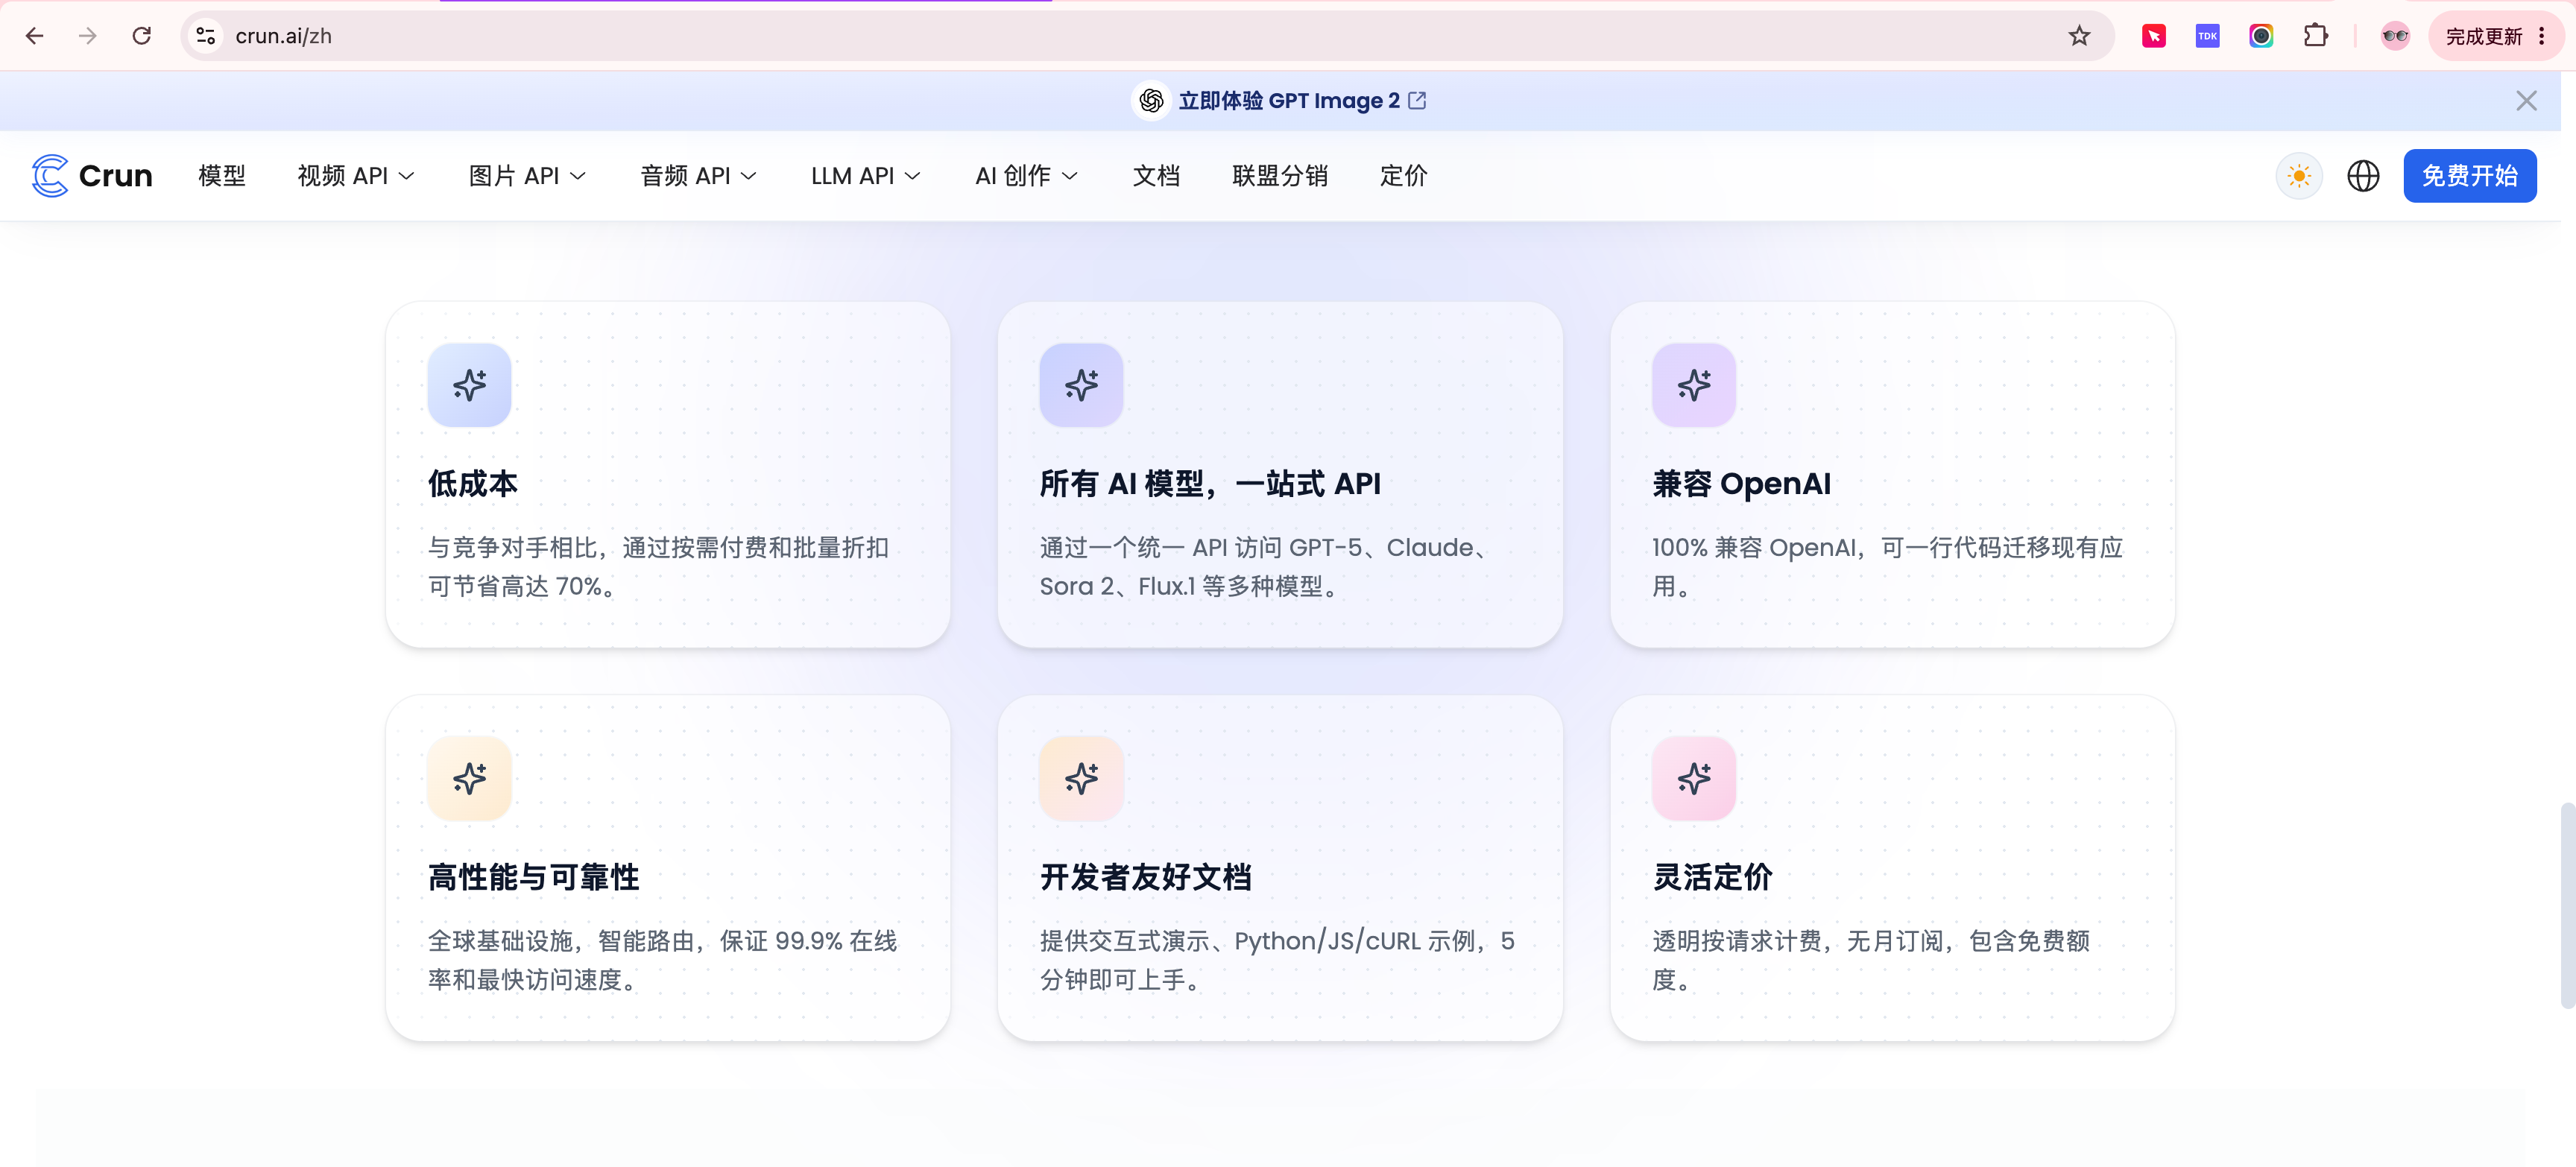
也是我们团队最近在技术选型上踩过无数坑后得出的血泪经验。我们后来放弃了自己"手搓"适配层,接入了 crun.ai 统一任务平台。
它的核心逻辑非常打动研发:强制降噪。crun.ai 在底层提供了一套唯一的、标准化的协议,把那些烂七八糟的模型调度、异常处理、API 翻新全部收拢到后台。这就好比给开发者提供了一个"无菌"的开发环境。无论未来的模型怎么神仙打架,底层接口怎么变,业务逻辑始终是跑在一个稳定的 Task 架构上。
当我们不再为"怎么搞定这个新模型的接入和并发"而掉头发时,团队才算是真正找回了写代码的纯粹感。把脏活累活丢给基座,把精力留给产品逻辑,这才是今年该有的研发姿势。