OpenCV-Python实战(26)------复杂场景下的实时物体检测与跟踪
-
- [0. 前言](#0. 前言)
- [1. 本节目标](#1. 本节目标)
- [2. 规划应用程序](#2. 规划应用程序)
- [3. 搭建应用程序](#3. 搭建应用程序)
-
- [3.1 运行应用程序------main() 函数例程](#3.1 运行应用程序——main() 函数例程)
- [3.2 显示结果](#3.2 显示结果)
- [4. 处理流程](#4. 处理流程)
- [5. 特征提取](#5. 特征提取)
-
- [5.1 特征检测](#5.1 特征检测)
- [5.2 使用SURF检测图像中的特征](#5.2 使用SURF检测图像中的特征)
- [5.3 使用 SURF 获取特征描述符](#5.3 使用 SURF 获取特征描述符)
- [6. 特征匹配](#6. 特征匹配)
-
- [6.1 使用 FLANN 跨图像匹配特征](#6.1 使用 FLANN 跨图像匹配特征)
- [6.2 剔除异常值](#6.2 剔除异常值)
- [6.3 可视化特征匹配](#6.3 可视化特征匹配)
- [6.4 单应性估计映射](#6.4 单应性估计映射)
- [6.5 图像变换](#6.5 图像变换)
- [7. 特征跟踪](#7. 特征跟踪)
-
- [7.1 早期异常值检测与剔除](#7.1 早期异常值检测与剔除)
- [8. 运行效果](#8. 运行效果)
- 小结
- 系列链接
0. 前言
我们已经学习了如何在高度受控的环境中检测并跟踪一个简单物体(手的轮廓)。更具体地说,我们指导应用的用户将手放在屏幕中央区域,然后对物体(手)的大小和形状做出了假设。在本节中,我们希望检测并跟踪任意大小的物体,这些物体可能从多个不同角度或部分遮挡的情况下被观察。
为此,我们将利用特征描述符,这是一种捕获感兴趣物体重要属性的方法。我们这样做是为了即使物体嵌入在复杂的视觉场景中,也能定位到它。我们将把算法应用于网络摄像头的实时视频流,并尽力保持算法的鲁棒性,同时使其足够简单以实时运行。
1. 本节目标
本节的目的是开发一个应用程序,能够在网络摄像头的视频流中检测并跟踪感兴趣的物体------即使该物体从不同角度、距离或部分遮挡的情况下被观察。这样的物体可以是一本书的封面图像、一幅画,或者任何具有复杂表面结构的东西。一旦提供了模板图像,该应用将能够检测到该物体,估计其边界,然后在视频流中对其进行跟踪。
在正式开始之前,需要说明的是,在安装 OpenCV 时需设置 OPENCV_ENABLE_NONFREE 和 OPENCV_EXTRA_MODULES_PATH 变量,以便安装加速鲁棒特征 (Speeded-Up Robust Features, SURF) 和快速最近邻逼近搜索库 (Fast Library for Approximate Nearest Neighbors, FLANN)。
该应用将分析每一帧捕获的图像,以执行以下任务:
- 特征提取:我们将使用
SURF来描述感兴趣的物体。SURF是一种用于在图像中寻找具有尺度不变性和旋转不变性的独特关键点的算法。这些关键点将帮助我们确保在多帧之间跟踪正确的物体,因为物体的外观可能会随时间变化。找到不依赖于物体观看距离或观看角度(因此需要尺度不变性和旋转不变性)的关键点非常重要 - 特征匹配:我们将使用
FLANN尝试建立关键点之间的对应关系,以判断一帧图像是否包含与感兴趣物体关键点相似的关键点。如果找到良好的匹配,我们将在每一帧上标记该物体 - 特征跟踪:我们将使用多种形式的早期异常值检测和异常值剔除方法,逐帧跟踪定位到的感兴趣物体,以加速算法运行
- 透视变换:通过透视变换对物体所经历的平移和旋转进行反向变换,使物体看起来直立地显示在屏幕中央。这能够产生一种酷炫的效果:物体仿佛被冻结在某个位置,而整个周围场景则围绕它旋转
前三个步骤(即特征提取、匹配和跟踪)的示例如下图所示:
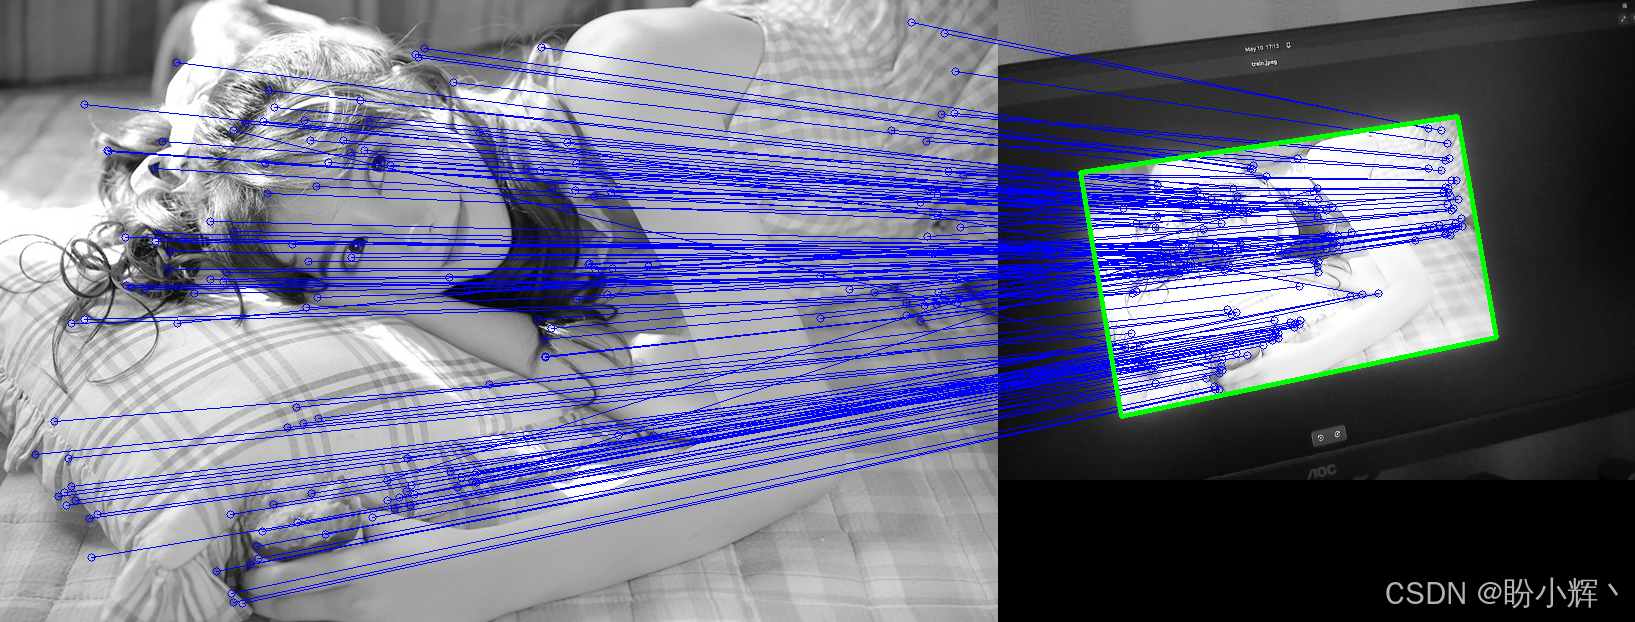
图中,左侧是我们感兴趣物体的模板图像,右侧是模板图像的手持打印件。两帧图像中匹配的特征点用蓝线连接,定位到的物体在右侧用绿色轮廓标出。
最后一步是对定位到的物体进行变换,使其投影到正面平面:
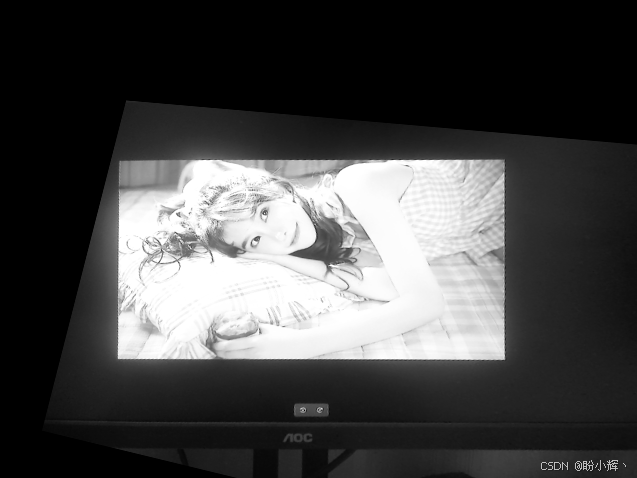
得到的图像大致看起来像原始的模板图像,呈现特写效果,而整个场景似乎在围绕它扭曲变形。
2. 规划应用程序
最终的应用程序将包含一个用于检测、匹配和跟踪图像特征的 Python 类,以及一个访问网络摄像头并显示每一帧处理后图像的脚本。
项目包含以下模块和脚本:
feature_matching:该模块包含特征提取、特征匹配和特征跟踪的算法。我们将此算法与应用程序的其他部分分离,以便它能够作为独立模块使用feature_matching.FeatureMatching:该类实现整个特征匹配的处理流程。它接受一帧BGR摄像头图像,并尝试在其中定位感兴趣的物体
finding_object_via_fm:这是本节的主要脚本finding_object_via_fm.main:主函数例程,用于启动应用程序、访问摄像头、将每一帧图像发送给FeatureMatching类的实例进行处理,以及显示结果
在深入特征匹配算法的细节之前,我们先来搭建应用程序。
3. 搭建应用程序
在我们深入研究特征匹配算法的细节之前,需要确保能够访问网络摄像头并显示视频流。
3.1 运行应用程序------main() 函数例程
要运行我们的应用程序,需要执行 main() 函数例程。以下步骤展示了 main() 例程的执行过程:
(1) 该函数首先通过 VideoCapture 方法访问网络摄像头,传入参数 0,该参数指向默认的网络摄像头。如果无法访问摄像头,应用程序将终止:
python
import cv2
from feature_matching import FeatureMatching

def main():
    capture = cv2.VideoCapture(0)
    assert capture.isOpened(), "Cannot connect to camera"
(2) 然后,设置视频流的目标帧尺寸和每秒帧数:
python
    capture.set(cv2.CAP_PROP_FPS, 10)
    capture.set(cv2.CAP_PROP_FRAME_WIDTH, 640)
    capture.set(cv2.CAP_PROP_FRAME_HEIGHT, 480)
(3) 接下来,初始化一个 FeatureMatching 类的实例,并传入一个模板(或训练)文件的路径,该文件描绘了感兴趣的物体:
python
    train_img = cv2.imread('train.jpeg', cv2.CV_8UC1)
    matching = FeatureMatching(train_img)
(4) 之后,为了处理来自摄像头的帧,我们从 capture.read 函数创建一个迭代器。当该函数无法返回帧时( (False, None) ),迭代器将终止:
python
    for success, frame in iter(capture.read, (False, None)):
        cv2.imshow("frame", frame)
match_succsess, img_warped, img_flann = matching.match(frame)在上面的代码块中,FeatureMatching.match 方法处理 BGR 图像( capture.read 返回的帧为 BGR 格式)。如果在当前帧中检测到物体,match 方法将返回 match_success=True,并输出经过透视变换的图像以及展示匹配结果的图像 img_flann。
接下来,我们继续介绍 match 方法将返回的结果。
3.2 显示结果
实际上,只有当 match 方法返回结果时,我们才能显示结果:
python
        if match_succsess:
            cv2.imshow("res", img_warped)
            cv2.imshow("flann", img_flann)
在 OpenCV 中显示图像很简单,通过 imshow 方法完成,该方法接受窗口名称和图像作为参数。此外,还设置了按 Esc 键退出的循环终止条件:
python
        if cv2.waitKey(1) & 0xff == 27:
            break
现在我们已经搭建好了应用程序,下一小节我们介绍处理流程。
4. 处理流程
特征提取、匹配和跟踪由 FeatureMatching 类完成,主要是通过公开的 match 方法。然而,在开始分析传入的视频流之前,我们还有一些准备工作要做。其中某些术语(包括 SURF 和 FLANN )将在后续学习中详细讨论。
现在,我们只需要关注初始化部分:
python
class FeatureMatching:
    def __init__(self, train_image: np.ndarray):
初始化过程包含以下步骤:
(1) 设置一个 SURF 检测器,我们将使用它从图像中检测和提取特征:
python
self.f_extractor = cv2.xfeatures2d_SURF.create(hessianThreshold=400)(2) 加载感兴趣物体的模板图像 (self.img_obj):
python
self.img_obj = train_image(3) 为了方便起见,我们还存储了图像的尺寸 (self.sh_train):
python
self.sh_train = self.img_obj.shape[:2]我们将模板图像称为训练图像,因为我们的算法将经过训练以找到这张图像;而将每一帧输入图像称为查询图像,因为我们将用这些图像来查询训练图像。下图是训练图像:
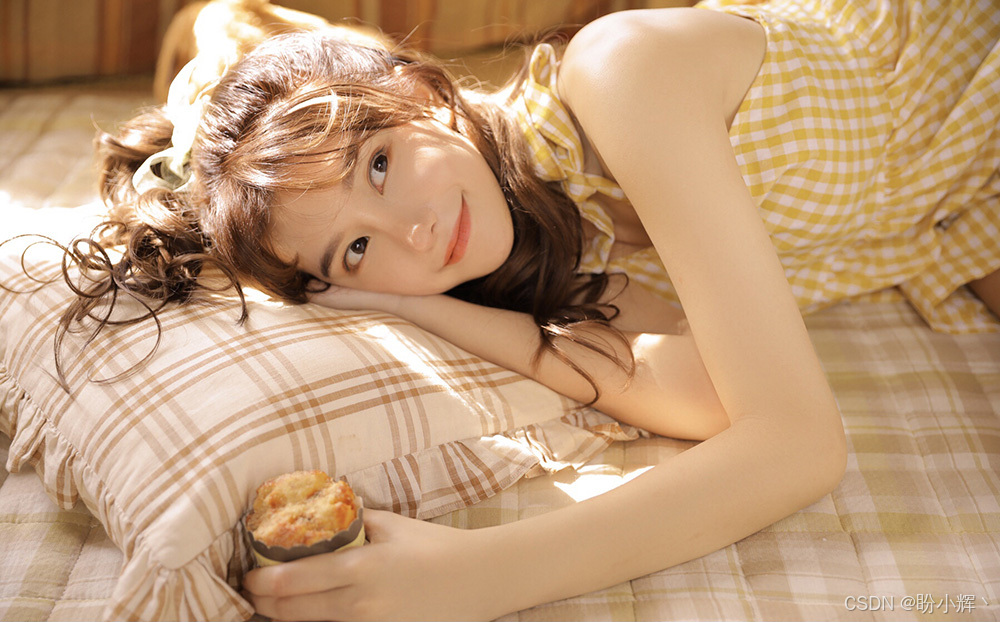
上图所示的训练图像尺寸为 1000×622 像素,将用于训练算法。
(4) 接下来,我们对感兴趣物体应用 SURF。这可以通过一个便捷的函数调用来完成,该函数返回关键点列表和描述符:
python
        self.key_train, self.desc_train = \
            self.f_extractor.detectAndCompute(self.img_obj, None)
我们对每一帧输入图像执行相同的操作,然后跨图像比较特征列表。
(5) 设置一个 FLANN 对象,用于匹配训练图像和查询图像的特征,这需要通过字典指定一些额外的参数,例如使用哪种算法:
python
        FLANN_INDEX_KDTREE = 0
        index_params = {"algorithm": 0, "trees": 5}
        search_params = {"checks": 50}
        self.flann = cv2.FlannBasedMatcher(index_params, search_params)
(6) 最后,初始化一些额外的记录变量。当我们希望使特征跟踪既更快又更准确时,这些变量将派上用场。例如,我们将跟踪最近计算得到的单应性矩阵,以及未定位到感兴趣物体所经过的帧数:
python
        self.last_hinv = np.zeros((3, 3))
        self.max_error_hinv = 50.
        self.num_frames_no_success = 0
        self.max_frames_no_success = 5
然后,大部分工作由 FeatureMatching.match 方法完成。该方法遵循以下详细流程:
- 从每一帧输入视频中提取有趣的图像特征
- 在模板图像和视频帧之间进行特征匹配。这通过
FeatureMatching.match_features完成。如果没有找到匹配,则跳至下一帧 - 在视频帧中找到模板图像的角点。这通过
detect_corner_points函数完成。如果任何一个角点(明显)位于帧范围之外,则跳至下一帧 - 计算四个角点所围成的四边形的面积。如果面积过小或过大,则跳至下一帧
- 在当前帧中勾勒出模板图像的角点
- 找到将定位到的物体从当前帧变换到正面平行平面所需的透视变换。如果结果与最近从先前帧获得的结果显著不同,则跳至下一帧
- 对当前帧进行透视变换,使感兴趣的物体呈现居中且直立的效果。
接下来,我们将详细讨论上述步骤。
首先,我们深入了解特征提取步骤。该步骤是我们算法的核心。它会在图像中找到信息丰富的区域,并将其表示为更低维度的形式,以便我们随后能够利用这些表示来判断两幅图像是否包含相似的特征。
5. 特征提取
一般来说,在机器学习中,特征提取是一个对数据进行降维的过程,其结果是对数据元素的信息化描述。
在计算机视觉中,特征通常是图像中一个有趣的区域。它是一种可测量的图像属性,能够非常有效地反映图像所表示的内容。通常,单个像素的灰度值(即原始数据)并不能告诉我们关于整幅图像的太多信息。相反,我们需要推导出更具信息量的属性。
例如,知道图像中存在看起来像眼睛、鼻子和嘴巴的区块,我们就能够推断出该图像代表一张脸的可能性有多大。在这种情况下,描述数据所需的资源量大大减少。这里的数据指的是例如"我们是否看到一张脸的图像"这样的信息。我们所需要的仅仅是图像中是否包含两只眼睛、一个鼻子或一张嘴?
更底层的特征,例如边缘、角点、斑点或脊线的存在,通常可能更具信息量。根据应用场景的不同,某些特征可能比其他特征更适用。
一旦我们确定了偏好的特征类型,首先需要想出一种方法来检查图像是否包含此类特征。此外,我们还需要找出这些特征的位置,然后创建该特征的描述符。下一小节中,我们学习如何检测特征。
5.1 特征检测
在计算机视觉中,在图像中寻找感兴趣区域的过程称为特征检测。在底层实现上,特征检测算法会对图像的每个点判断该点是否包含感兴趣的特征。OpenCV 提供了多种特征检测(和描述)算法。
在 OpenCV 中,这些算法的细节被封装起来,并且它们都具有相似的 API。主要包括以下算法:
Harris角点检测:我们知道边缘是各个方向上强度变化都很大的区域。Harris和Stephens提出了这种算法,这是一种快速寻找此类区域的方法。该算法在OpenCV中实现为cv2.cornerHarrisShi-Tomasi角点检测:Shi和Tomasi开发了一种角点检测算法,该算法通过寻找N个最强的角点,通常比Harris角点检测效果更好。该算法在OpenCV中实现为cv2.goodFeaturesToTrack- 尺度不变特征变换 (
Scale-Invariant Feature Transform,SIFT):当图像尺度发生变化时,仅靠角点检测是不够的。为此,David Lowe开发了一种描述图像中关键点的方法,这些关键点与方向和大小无关(因此称为尺度不变)。该算法在OpenCV2中实现为cv2.xfeatures2d_SIFT SURF:SIFT已被证明非常出色,但对于大多数应用来说速度不够快。这正是SURF的用武之地,它用盒式滤波器替代了SIFT中计算代价高昂的高斯拉普拉斯函数。该算法在OpenCV2中实现为cv2.xfeatures2d_SURFOpenCV还支持更多的特征描述符,例如加速分段特征检测 (Features from Accelerated Segment Test,FAST)、二元鲁棒独立基本特征 (Binary Robust Independent Elementary Feature,BRIEF) 和定向 FAST 与旋转 BRIEF (Oriented FAST and Rotated BRIEF,ORB),其中ORB是SIFT或SURF的一个开源替代方案
在下一小节中,我们将学习如何使用 SURF 检测图像中的特征。
5.2 使用SURF检测图像中的特征
在本节中,我们将使用 SURF 检测器。SURF 算法大致可以分为两个不同的步骤:检测感兴趣点和构造描述符。
SURF 依赖 Hessian 角点检测器来检测感兴趣点,这需要设置一个最小 Hessian 阈值 (minHessianThreshold)。该阈值决定了 Hessian 滤波器的输出必须多大,才能将一个点用作感兴趣点。
当该值较大时,获得的感兴趣点较少,但理论上这些点更加显著;反之亦然。我们可以尝试使用不同的值进行实验。
在本节中,我们将选择 400 作为该值,正如之前在 FeatureMatching.__init__ 中所做的那样:
python
self.f_extractor = cv2.xfeatures2d_SURF.create(hessianThreshold=400)图像中的关键点可以通过一步操作获得:
python
        key_query = self.f_extractor.detect(
img_query)其中,key_query 是一个 cv2.KeyPoint 实例的列表,其长度等于检测到的关键点数量。每个 KeyPoint 包含关于位置 (KeyPoint.pt)、大小 (KeyPoint.size) 以及其他关于感兴趣点的有用信息。
现在,我们可以使用以下函数绘制关键点:
python
        img_keypoints = cv2.drawKeypoints(img_query, key_query, None,
             (255, 0, 0), 4)
        cv2.imshow("keypoints",img_keypoints)
根据图像的不同,检测到的关键点数量可能非常大,可视化时会显得不清晰;我们可以通过 len(key_query) 来查看。如果只关心绘制关键点,可以尝试将 min_hessian 设置为一个较大的值,直到返回的关键点数量能够提供良好的可视化效果为止。
为了完成我们的特征提取算法,我们需要为检测到的关键点获取描述符,这将在下一小节中完成。
5.3 使用 SURF 获取特征描述符
使用 OpenCV 通过 SURF 从图像中提取特征也只需一步即可完成,通过特征提取器的 compute 方法实现。该方法接受图像和图像的关键点作为参数:
python
key_query, desc_query = self.f_extractor.compute(img_query, key_query)其中,desc_query 是一个 NumPy ndarray,形状为 (num_keypoints, descriptor_size)。可以看到,每个描述符都是一个 n 维空间中的向量(一个长度为 n 的数值数组)。每个向量描述对应的关键点,并提供关于整幅图像的一些有意义的信息。
至此,我们已经完成了特征提取算法,该算法需要以降维的形式提供关于图像的有意义信息。描述符向量中包含何种信息,由算法的创建者决定,但至少这些向量应满足:对于相似的关键点,它们之间的距离比对于看起来不同的关键点更近。
特征提取算法还有一个便捷的方法,可以将特征检测和描述符创建的过程合并在一起:
python
        key_query, desc_query = self.f_extractor.detectAndCompute(
            img_query, None)
该方法通过一步操作返回关键点和描述符,并接受一个感兴趣区域的掩码作为参数,在本节中,该掩码对应整幅图像。
提取完特征后,下一步是查询和训练包含相似特征的图像,这通过特征匹配算法来完成。因此,下一小节中我们来了解特征匹配。
6. 特征匹配
一旦我们从两幅(或更多)图像中提取了特征及其描述符,就可以开始查找其中某些特征是否同时出现在多幅图像中。例如,如果我们同时拥有感兴趣物体 (self.desc_train) 和当前视频帧 (desc_query) 的描述符,就可以尝试找出当前帧中与感兴趣物体相似的区域。
这一步通过以下方法完成,该方法利用了 FLANN:
python
good_matches = self.match_features(desc_query)寻找帧间对应关系的过程可以表述为:对于一组描述符中的每一个元素,在另一组描述符中寻找最近的邻居。
第一组描述符通常称为训练集,因为在机器学习中,这些描述符用于训练模型,例如我们想要检测的物体模型。在本节中,训练集对应于模板图像(我们感兴趣的物体)的描述符。因此,我们将模板图像称为训练图像 (self.img_train)。
第二组描述符通常称为查询集,因为我们持续询问它是否包含我们的训练图像。在本节中,查询集对应于每一帧输入图像的描述符。因此,我们将每一帧称为查询图像 (img_query)。
特征匹配可以通过多种方式进行,例如借助暴力匹配器 (cv2.BFMatcher),它会为第一组中的每个描述符尝试匹配第二组中的所有描述符,以找出最接近的那个(即穷举搜索)。
下一节中,我们将学习如何使用 FLANN 跨图像匹配特征。
6.1 使用 FLANN 跨图像匹配特征
另一种方法是使用近似的 k-近邻 (k-nearest neighbor, kNN) 算法来寻找对应关系,该算法基于快速的第三方库 FLANN。使用以下代码片段执行 FLANN 匹配,其中我们使用 k=2 的 kNN 匹配:
python
    def match_features(self, desc_frame: np.ndarray) -> List[cv2.DMatch]:
        # find 2 best matches (kNN with k=2)
        matches = self.flann.knnMatch(self.desc_train, desc_frame, k=2)
flann.knnMatch 的结果是一个对应关系列表,表示两组描述符之间的匹配,都包含在 matches 变量中。这两组分别是训练集(对应于我们感兴趣物体的模式图像)和查询集(对应于我们正在搜索感兴趣物体的图像)。
现在我们已经找到了特征的最近邻,接下来继续学习如何剔除异常值。
6.2 剔除异常值
找到的正确匹配越多(即模式与图像之间的对应关系越多),模式存在于图像中的可能性就越高。然而,某些匹配可能是误报。
一种著名的异常值剔除技术称为比值测试。由于我们使用 k=2 执行了 kNN 匹配,每个匹配会返回两个最近的描述符。第一个匹配是最近邻,第二个匹配是次近邻。
直观上,一个正确的匹配,其最近邻距离会远小于其次近邻距离。另一方面,对于一个错误的匹配,其两个最近邻的距离会相近。
因此,我们可以通过考察距离之间的差异来判断匹配的质量。比值测试表明:仅当第一个匹配与第二个匹配的距离比值小于某个给定数值(通常约为 0.5 )时,该匹配才是好的匹配。在本节中,这个数值选为 0.7。以下代码段可找到合适的匹配项:
python
        good_matches = [x[0] for x in matches
                        if x[0].distance < 0.7 * x[1].distance]
为了剔除所有不满足此要求的匹配,我们过滤匹配列表,并将好的匹配存储在 good_matches 列表中。
然后,我们将找到的匹配传递给 FeatureMatching.match,以便进一步处理:
python
return good_matches在详细阐述算法之前,让我们先在下一小节中可视化我们的匹配结果。
6.3 可视化特征匹配
在 OpenCV 中,我们可以使用 cv2.drawMatches 轻松绘制匹配结果。这里,我们创建自定义函数:
python
def draw_good_matches(img1: np.ndarray,
                      kp1: Sequence[cv2.KeyPoint],
                      img2: np.ndarray,
                      kp2: Sequence[cv2.KeyPoint],
                      matches: Sequence[cv2.DMatch]) -> np.ndarray:
该函数接受两幅图像------在本节中,分别是感兴趣物体的图像和当前视频帧。它还接受来自两幅图像的关键点以及匹配结果。该函数会将两幅图像并排绘制在一张输出图像上,在图像上绘制匹配连线,并返回该图像。后者通过以下步骤实现:
(1) 创建一张新的输出图像,其尺寸能够容纳两幅图像并排;将其设为三通道,以便在图像上绘制彩色线条:
python
    rows1, cols1 = img1.shape[:2]
    rows2, cols2 = img2.shape[:2]
    out = np.zeros((max([rows1, rows2]), cols1 + cols2, 3), dtype='uint8')
(2) 将第一幅图像放置在新图像的左侧,第二幅图像放置在第一幅图像的右侧:
python
    out[:rows1, :cols1, :] = img1[..., None]
    out[:rows2, cols1:cols1 + cols2, :] = img2[..., None]
在这些表达式中,我们使用了 NumPy 数组的广播规则------当数组形状不匹配但满足某些约束时,用于数组操作的规则。这里,img[..., None] 为二维灰度图像(数组)添加了一个通道(第三)维度。接着,当 NumPy 遇到一个不匹配但值为 1 的维度时,它会对该数组进行广播,这意味着所有三个通道都使用相同的数值。
(3) 对于两幅图像之间的每一对匹配点,我们希望在每幅图像上绘制一个蓝色的小圆点,并用一条线连接这两个圆点。为此,使用 for 循环遍历匹配关键点列表,从对应的关键点中提取中心坐标,并平移第二个中心的坐标以便绘制:
python
    for m in matches:
        c1 = tuple(map(int, kp1[m.queryIdx].pt))
        c2 = tuple(map(int, kp2[m.trainIdx].pt))
        c2 = c2[0] + cols1, c2[1]
关键点在 Python 中存储为元组,包含 x 和 y 坐标两个元素。每个匹配 m 存储了在关键点列表中的索引,其中 m.trainIdx 指向第一个关键点列表 (kp1) 中的索引,而 m.queryIdx 指向第二个关键点列表 (kp2) 中的索引。
(4) 在同一循环中,绘制半径为 4 像素、颜色为蓝色、线条粗细为 1 像素的圆点,然后用一条直线连接这两个圆点:
python
        radius = 4
        BLUE = (255, 0, 0)
        thickness = 1
        # Draw a small circle at both co-ordinates
        cv2.circle(out, c1, radius, BLUE, thickness)
        cv2.circle(out, c2, radius, BLUE, thickness)

        # Draw a line in between the two points
        cv2.line(out, c1, c2, BLUE, thickness)
(5) 最后,返回结果图像:
python
return out函数定义完成后,可以使用以下代码来展示匹配结果:
python
img_warp = cv2.warpPerspective(img_query, Hinv, (sh_query[1], sh_query[0]))蓝色线条将物体(左侧)中的特征与场景(右侧)中的特征连接起来,如下图所示:
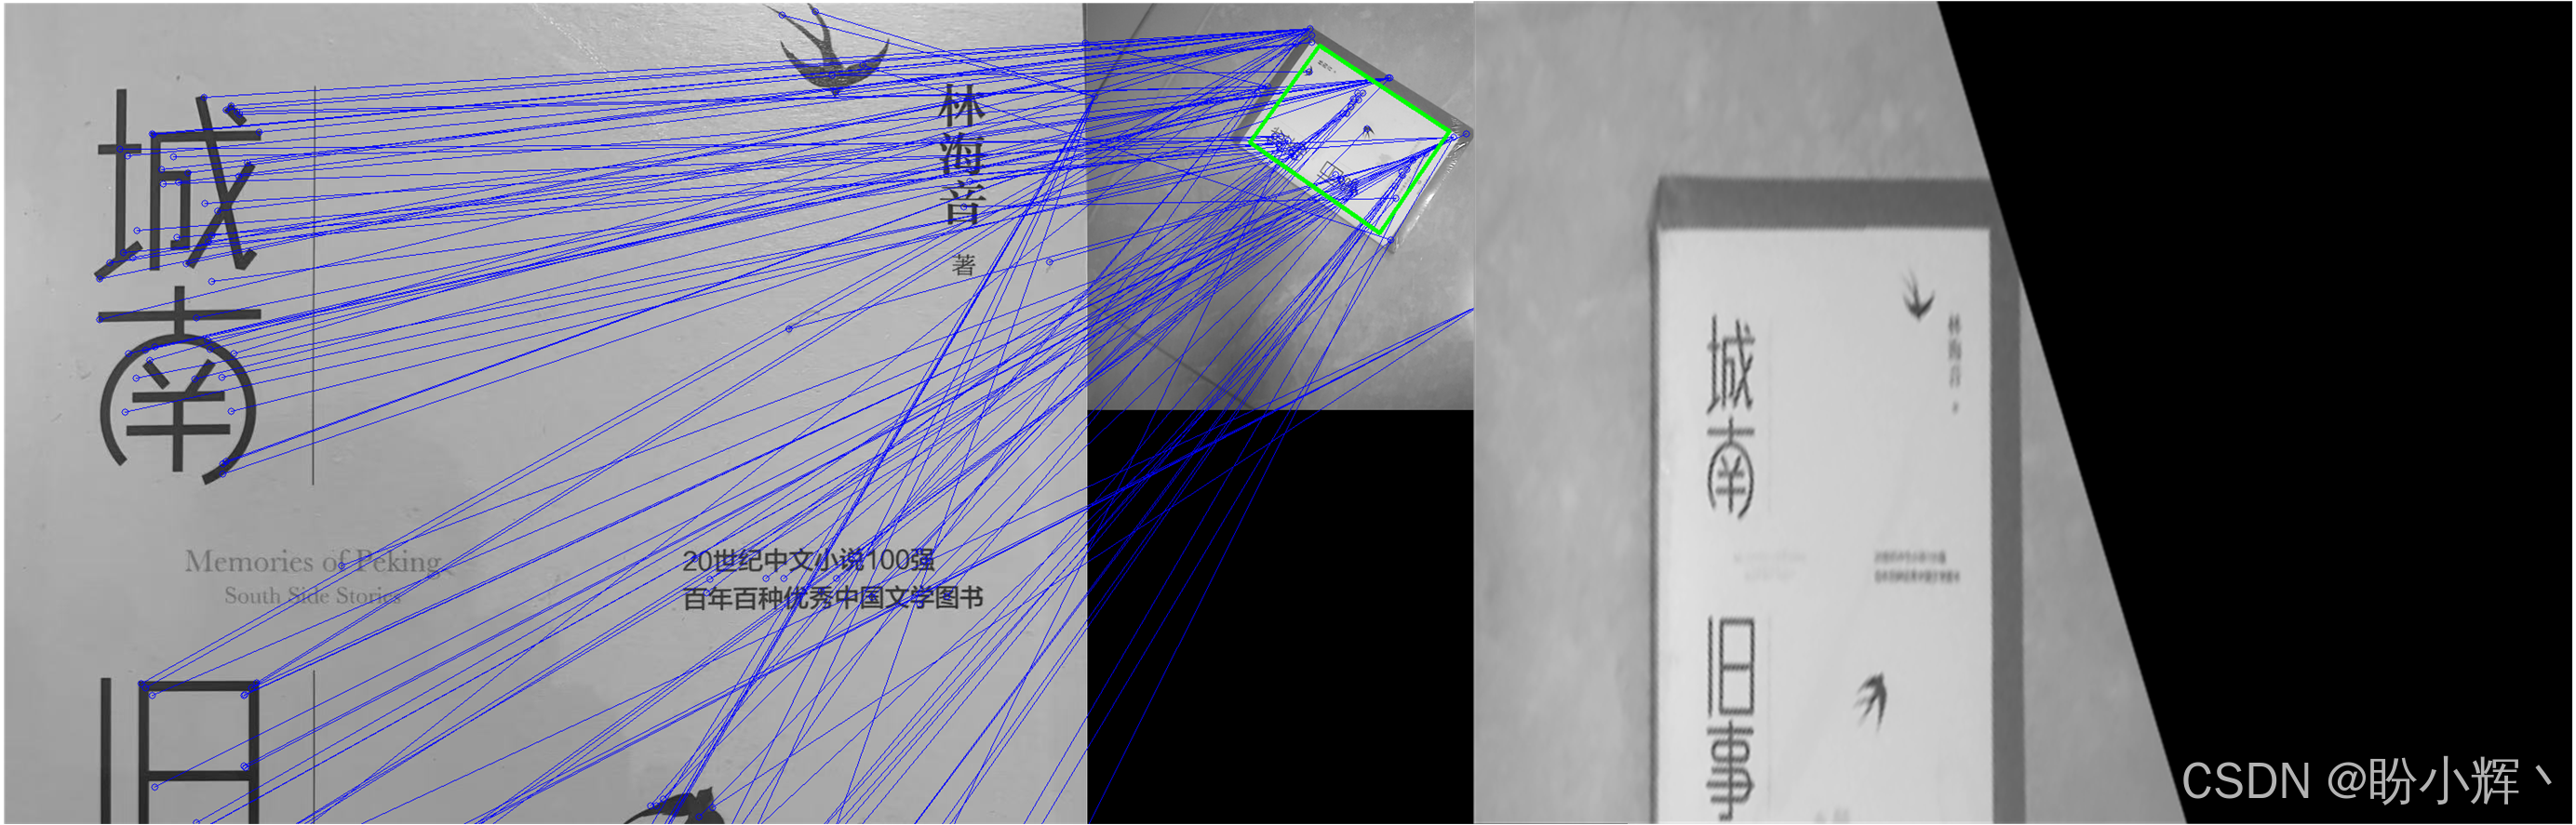
在本节示例中,算法运行良好。但是,当场景中存在其他物体时会发生什么呢?由于我们的物体包含一些看起来非常明显的文字,当场景中出现其他文字时,情况又会怎样?
事实证明,即使在这种条件下,算法仍然有效,如下图所示:
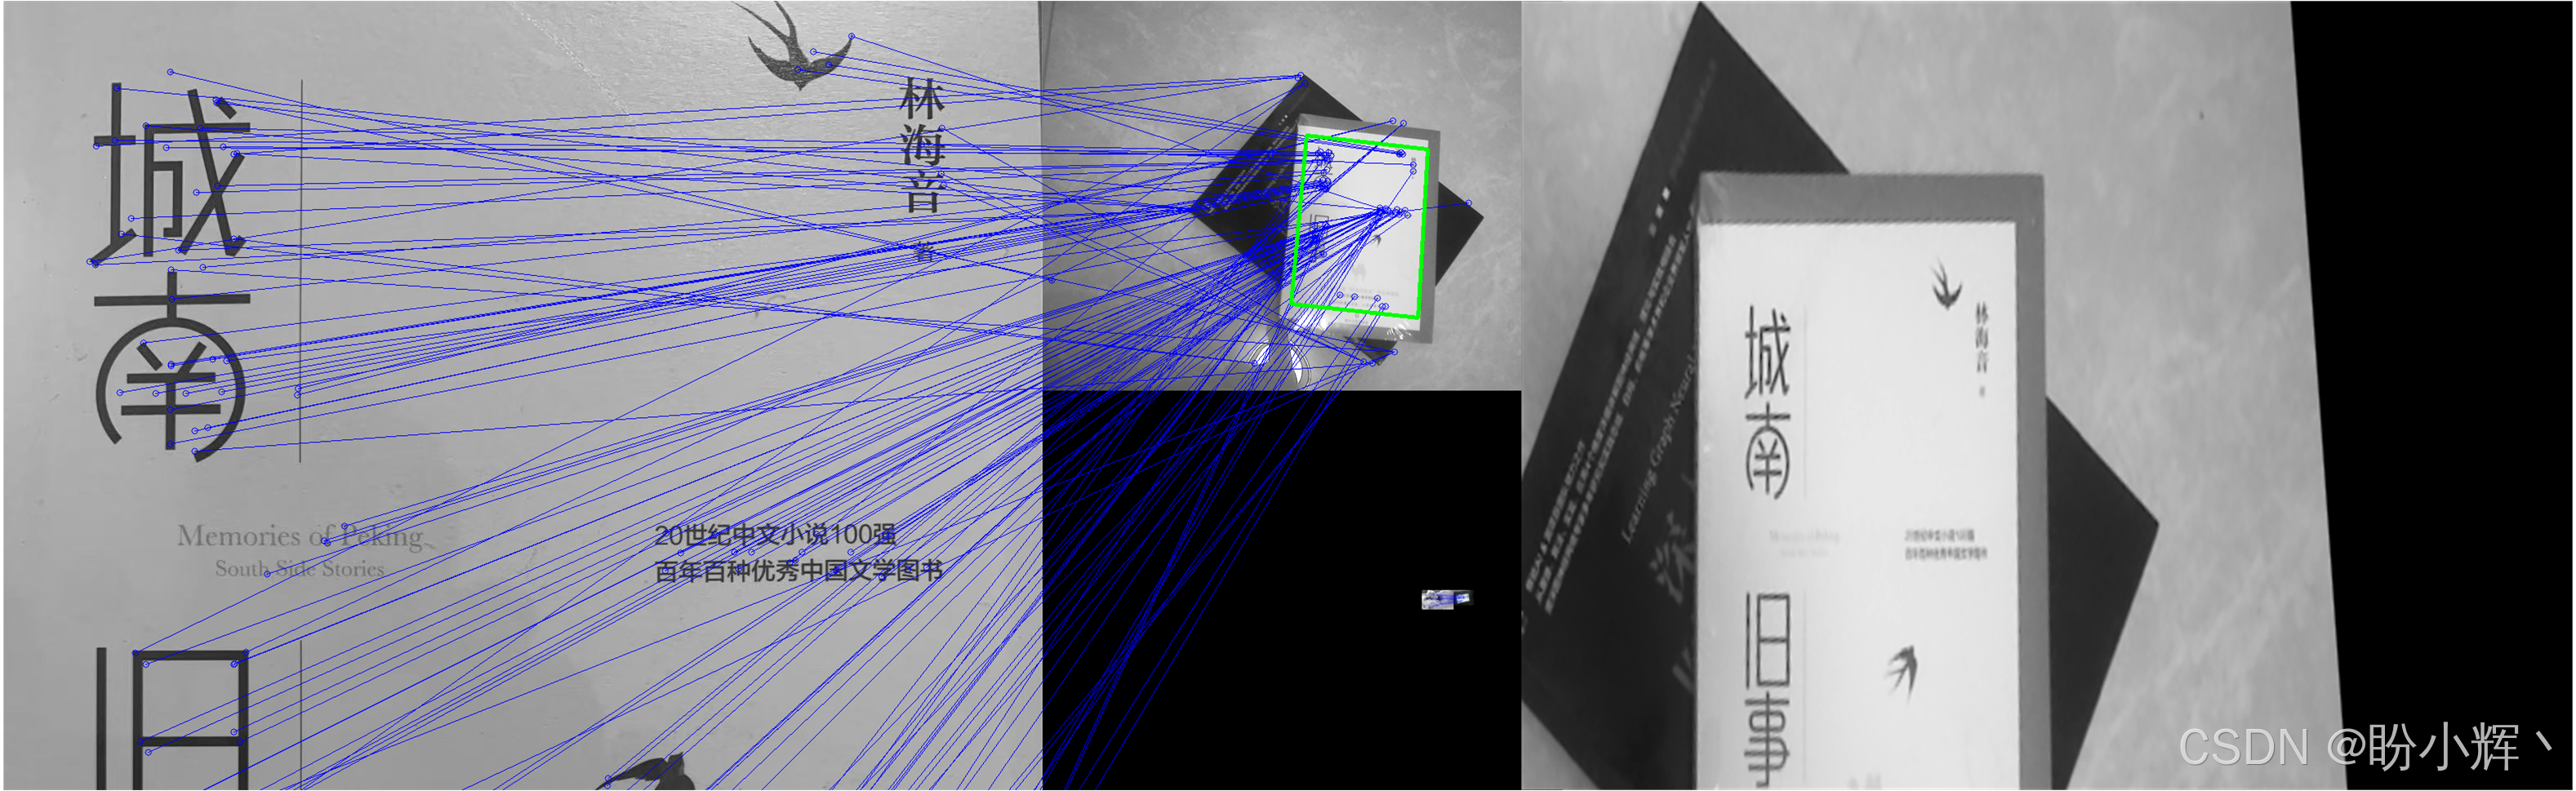
值的注意的是,算法并没有将两本书籍的文字混淆,这是因为该算法找到的物体描述并非纯粹依赖于灰度表示。另一方面,如果采用逐像素比较的算法,则很容易产生混淆。
现在我们已经完成了特征匹配,接下来继续学习如何利用这些结果来高亮显示感兴趣的物体------这将在下一小节中借助单应性估计来实现。
6.4 单应性估计映射
由于我们假设感兴趣的物体是平面(即图像)且刚性的,我们可以找到两幅图像特征点之间的单应性变换。以下步骤将探讨如何使用单应性来计算所需的透视变换,将物体图像 (self.key_train) 中的匹配特征点映射到当前图像帧 (key_query) 中对应特征点所在的同一平面:
(1) 为了方便,我们首先将所有良好匹配的关键点的图像坐标分别存储在列表中:
python
        train_points = [self.key_train[good_match.queryIdx].pt
                        for good_match in good_matches]
        query_points = [key_query[good_match.trainIdx].pt
                        for good_match in good_matches]
(2) 将角点检测的逻辑封装在一个单独的函数中:
python
def detect_corner_points(src_points: Sequence[Point],
                         dst_points: Sequence[Point],
                         sh_src: Tuple[int, int]) -> np.ndarray:
上述代码接收两个点序列以及源图像的尺寸作为参数,函数将返回这些点的角点位置,通过以下步骤实现:
(2.1) 对于给定的两个坐标序列,找到透视变换矩阵(单应性矩阵 H):
python
    H, _ = cv2.findHomography(np.array(src_points), np.array(dst_points),
cv2.RANSAC)为找到该变换,cv2.findHomography 函数将使用随机抽样一致性 (random sample consensus, RANSAC) 方法探测输入点的不同子集。
(2.2) 如果该方法未能找到单应性矩阵,则抛出一个异常,我们将在后续应用程序中捕获该异常:
python
    if H is None:
        raise Outlier("Homography not found")
(2.3) 根据源图像的尺寸,将其四个角点的坐标存储在一个数组中:
python
    height, width = sh_src
    src_corners = np.array([(0, 0), (width, 0),
                            (width, height),
                            (0, height)], dtype=np.float32)
(2.4) 单应性矩阵可用于将模板图像中的任意点变换到场景图像中,例如将训练图像中的一个角点变换到查询图像中的一个角点。换言之,这意味着我们可以通过变换训练图像中的角点,在查询图像中绘制出书籍封面的轮廓。为此,我们获取训练图像 (src_corners) 的角点列表,并通过透视变换将其投影到查询图像中:
python
return cv2.perspectiveTransform(src_corners[None, :, :], H)[0]结果会立即返回,即一个图像点数组(二维 NumPy ndarray)。
(3) 函数定义完成后,可以调用它来检测角点:
python
            dst_corners = detect_corner_points(
                train_points, query_points, self.sh_train)
(4) 接下来,我们只需在 dst_corners 中的每个点与下一个点之间绘制一条线段,就能在场景中看到一个轮廓:
python
            dst_corners[:, 0] += self.sh_train[1]
            cv2.polylines(
                img_flann,
                [dst_corners.astype(int)],
                isClosed=True,
                color=(0, 255, 0),
                thickness=3)
需要注意的是,为了绘制这些图像点,需要先将点的 x 坐标偏移模板图像的宽度(因为我们是将两幅图像并排显示)。然后,我们将这些图像点视为一个封闭的多边形,并使用 cv2.polylines 进行绘制。此外,为了绘图,我们还需要将数据类型转换为整数。
(5) 最终,书籍封面的轮廓绘制效果如下:
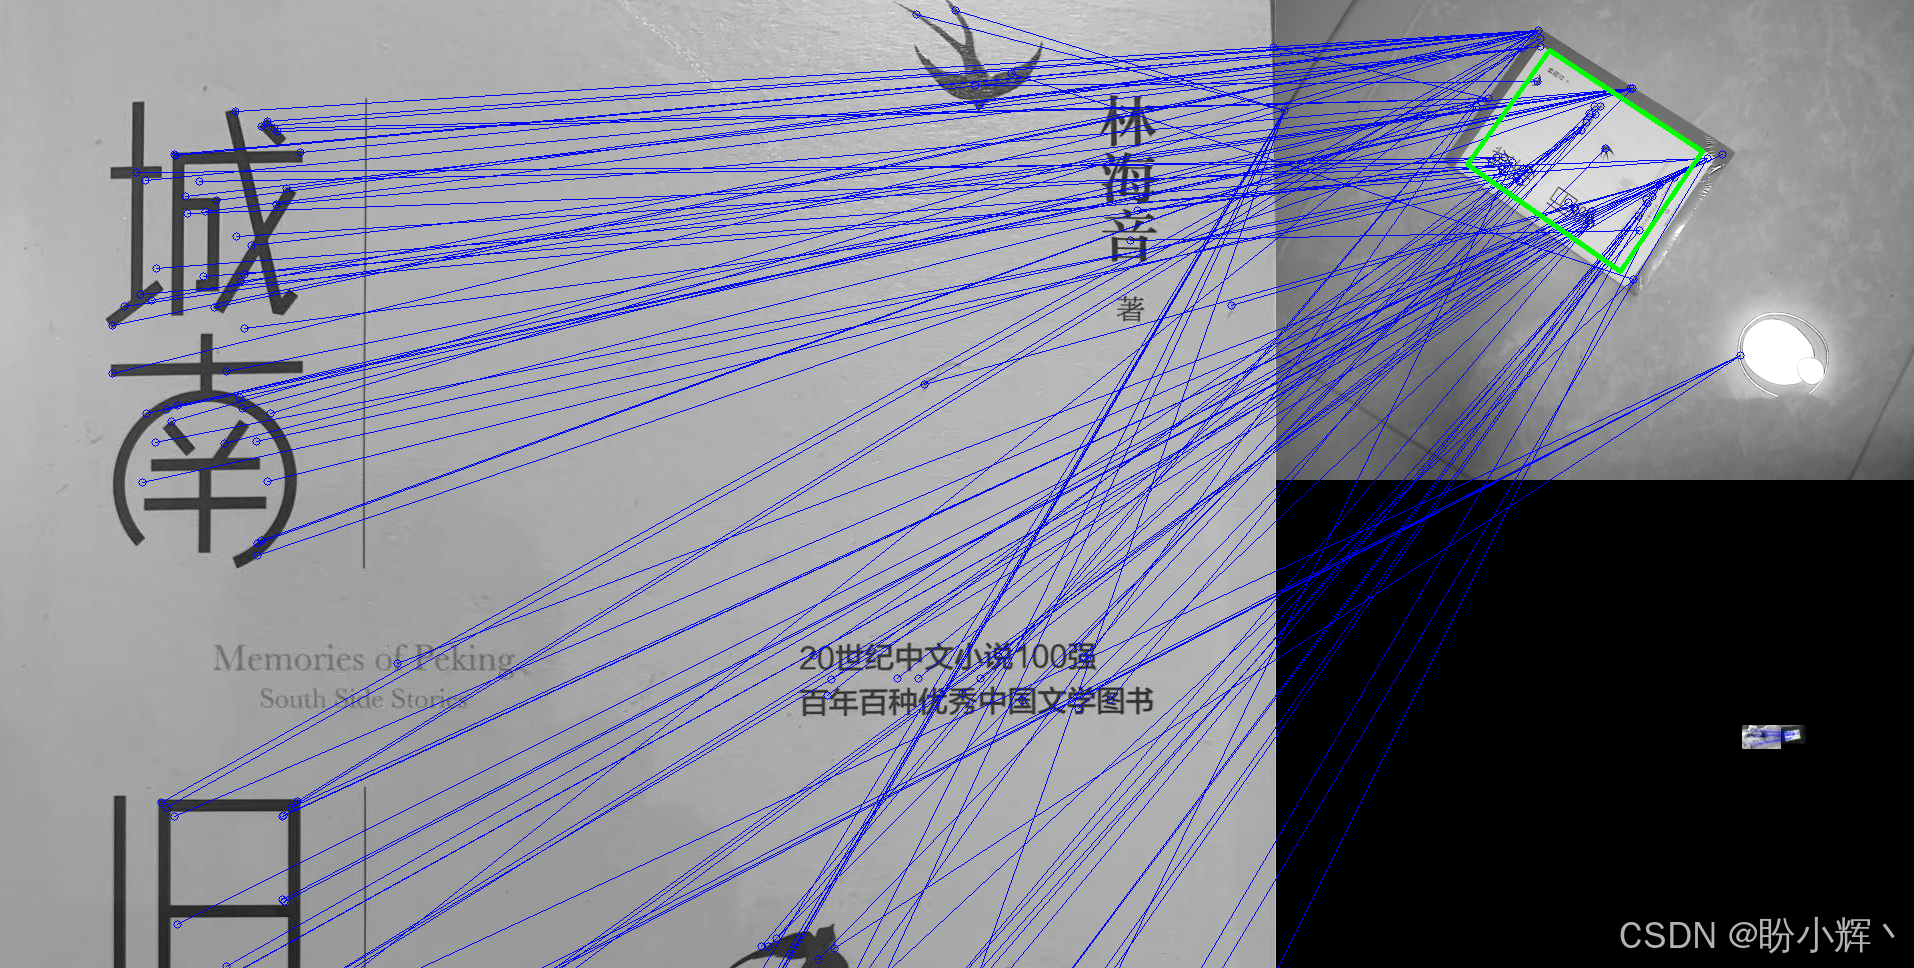
即使物体仅部分可见,该算法依然有效,如下图所示:
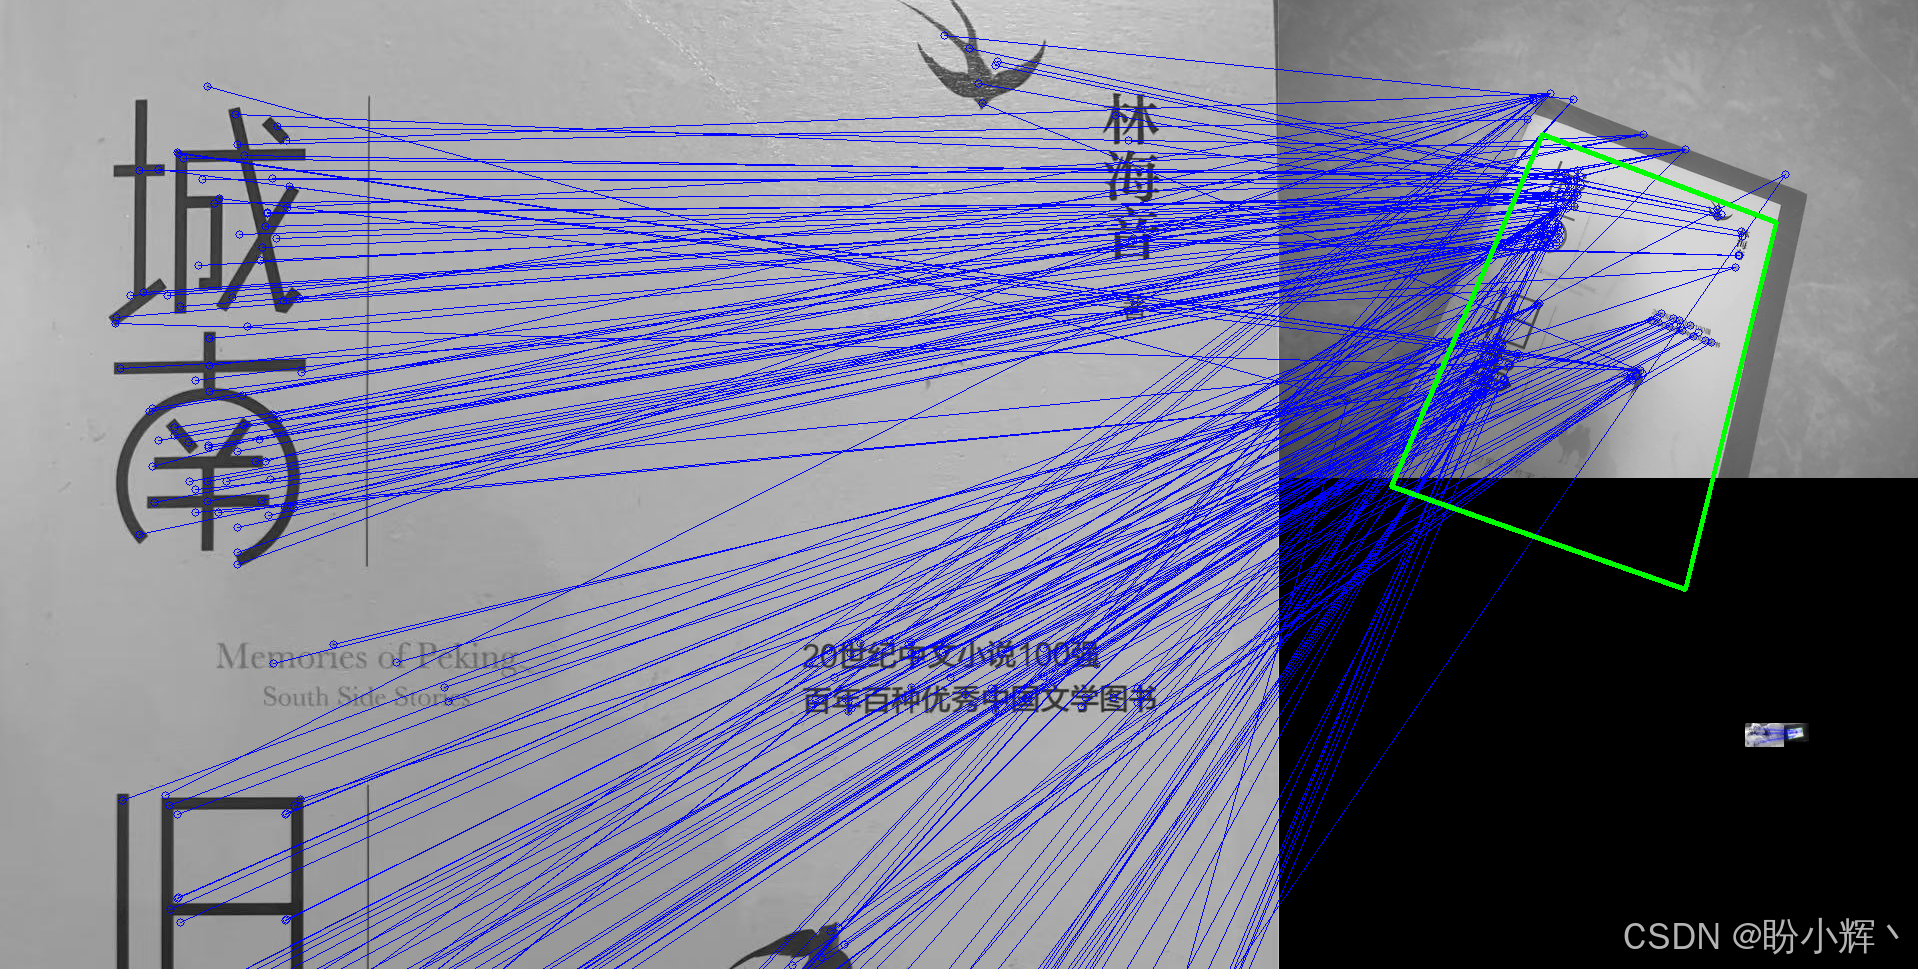
尽管书籍部分位于画面之外,但轮廓线仍能预测出超出画面边界的轮廓。下一小节中,让我们学习如何对图像进行变换,使其看起来更接近原始图像。
6.5 图像变换
我们也可以反向进行单应性估计/变换,即从探测到的场景图像变换回模板图像的坐标系。这使得书籍封面可以被映射到正面平面,就像我们直接从正上方观看它一样。为此,我们可以直接取单应性矩阵的逆矩阵,得到逆变换:
python
Hinv = cv2.linalg.inverse(H)然而,这会将书籍封面的左上角映射到新图像的原点,从而裁剪掉书籍封面左侧和上方的所有内容。相反,我们希望将书籍封面大致居中在新图像中。因此,我们需要计算一个新的单应性矩阵。
书籍封面应该大约占新图像尺寸的一半。因此,以下方法演示了如何变换点坐标,使其出现在新图像的中心,而不是直接使用训练图像的点坐标:
(1) 首先,找到缩放因子和偏移量,然后应用线性缩放并变换坐标:
python
    @staticmethod
    def scale_and_offset(points: Sequence[Point],
                         source_size: Tuple[int, int],
                         dst_size: Tuple[int, int],
                         factor: float = 0.5) -> List[Point]:
        dst_size = np.array(dst_size)
        scale = 1 / np.array(source_size) * dst_size * factor
        bias = dst_size * (1 - factor) / 2
        return [tuple(np.array(pt) * scale + bias) for pt in points]
(2) 作为输出,我们想要一张与查询图像尺寸相同的图像:
python
            train_points_scaled = self.scale_and_offset(
                train_points, self.sh_train, sh_query)
(3) 然后,我们可以找到查询图像中的点与训练图像变换后的点之间的单应性矩阵(确保将列表转换为 NumPy 数组):
python
            Hinv, _ = cv2.findHomography(
                np.array(query_points), np.array(train_points_scaled), cv2.RANSAC)
(4) 之后,我们可以使用该单应性矩阵来变换图像中的每一个像素(这也称为图像变换):
python
            img_warped = cv2.warpPerspective(
                img_query, Hinv, (sh_query[1], sh_query[0]))
结果如下图所示(左侧为匹配结果,右侧为变换后的图像):
透视变换得到的图像可能与正面平行平面存在一定的对齐偏差,因为单应性矩阵毕竟只是提供了一种近似。但在大多数情况下,我们的方法效果良好,如下图所示:
现在,我们已经对如何用若干图像完成特征提取与匹配有了相当清晰的认识。接下来,让我们继续完成应用程序,并在下一小节中学习如何进行特征跟踪。
7. 特征跟踪
既然我们的算法能够处理单帧图像,我们就需要确保在一帧中找到的图像也能在紧接着的下一帧中被找到。
在 FeatureMatching.__init__ 中,我们创建了一些记录变量,之前提到过这些变量将用于特征跟踪。其主要思想是在连续帧之间强制执行一定的连贯性。由于我们大约每秒捕获 10 帧,可以合理地假设相邻帧之间的变化不会过于剧烈。因此,我们可以确信当前帧得到的结果必须与前一帧得到的结果相似。否则,我们就丢弃该结果并继续处理下一帧。
但是,我们也要小心不要陷入一个看似合理但实际上是异常值的结果。为了解决这个问题,我们记录未找到合适结果所经过的帧数,使用 self.num_frames_no_success 来保存该计数值。如果该值小于某个阈值(比如 self.max_frames_no_success),我们就进行帧间比较。如果该值大于阈值,我们就认为距离上次获得结果已经过去了太久,此时进行帧间比较就不太合理了。接下来,我们学习早期的异常值检测与剔除。
7.1 早期异常值检测与剔除
我们可以将异常值剔除的思想扩展到计算的每一步。其目标是在最大化获得良好结果可能性的同时,最小化计算工作量。
由此产生的早期异常值检测与剔除流程被嵌入在 FeatureMatching.match 方法中。该方法首先将图像转换为灰度,并存储其形状:
python
    def match(self,
              frame: np.ndarray) -> Tuple[bool,
                                          Optional[np.ndarray],
                                          Optional[np.ndarray]]:
        img_query = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)
        sh_query = img_query.shape  # rows,cols
然后,如果在计算的任何步骤中检测到异常值,我们会抛出一个 Outlier 异常来终止计算。以下步骤展示了匹配过程:
(1) 首先,我们在模板图像和查询图像的特征描述符之间找到良好的匹配,然后存储来自训练图像和查询图像的对应点坐标:
python
        key_query = self.f_extractor.detect(
            img_query)
        key_query, desc_query = self.f_extractor.compute(img_query, key_query)
        good_matches = self.match_features(desc_query)
        train_points = [self.key_train[good_match.queryIdx].pt
                        for good_match in good_matches]
        query_points = [key_query[good_match.trainIdx].pt
                        for good_match in good_matches]
为了让 RANSAC 在下一步中能够正常工作,我们至少需要 4 个匹配点。如果找到的匹配点少于 4 个,我们就承认失败并抛出一个带有自定义消息的 Outlier 异常。我们将异常检测包装在一个 try 块中:
python
        try:
            # early outlier detection and rejection
            if len(good_matches) < 4:
                raise Outlier("Too few matches")
(2) 然后,我们在查询图像中找到模板图像的角点:
python
            dst_corners = detect_corner_points(
                train_points, query_points, self.sh_train)
如果这些点中有任何一个明显超出图像边界(在我们的示例中是超出 20 像素),这意味着要么我们看到的不是感兴趣的物体,要么感兴趣的物体没有完全在图像内。在这两种情况下,我们都不需要继续处理,而是抛出或创建一个 Outlier 实例:
python
            if np.any((dst_corners < -20) |
                      (dst_corners > np.array(sh_query) + 20)):
                raise Outlier("Out of image")
(3) 如果恢复出的四个角点没有围成一个合理的四边形(即四条边的多边形),这意味着我们可能看到的不是感兴趣的物体。四边形的面积可以通过以下代码计算:
python
            area = 0
            for prev, nxt in zip(dst_corners, np.roll(
                    dst_corners, -1, axis=0)):
                area += (prev[0] * nxt[1] - prev[1] * nxt[0]) / 2.
如果该面积过小或过大,我们就丢弃该帧并抛出一个异常:
python
            if not np.prod(sh_query) / 16. < area < np.prod(sh_query) / 2.:
                raise Outlier("Area is unreasonably small or large")
(4) 然后,我们对训练图像中的良好匹配点进行缩放,并找到将物体变换到正面平面的单应性矩阵:
python
            train_points_scaled = self.scale_and_offset(
                train_points, self.sh_train, sh_query)
            Hinv, _ = cv2.findHomography(
                np.array(query_points), np.array(train_points_scaled), cv2.RANSAC)
(5) 如果恢复出的单应性矩阵与我们上次恢复的矩阵 (self.last_hinv) 差异过大,这意味着我们可能看到的是不同的物体。然而,我们只在 self.last_hinv 是近期(例如,在最近的 self.max_frames_no_success 帧以内)获得的情况下才考虑它:
python
            similar = np.linalg.norm(
                Hinv - self.last_hinv) < self.max_error_hinv
            recent = self.num_frames_no_success < self.max_frames_no_success
            if recent and not similar:
                raise Outlier("Not similar transformation")
这有助于我们持续跟踪同一个感兴趣的物体。如果由于某种原因,我们超过 self.max_frames_no_success 帧未能跟踪到模板图像,我们就跳过这个条件,并接受到目前为止恢复出的任意单应性矩阵。这确保了我们不会卡在一个实际上是异常值的 self.last_hinv 矩阵上。
如果在异常值检测过程中检测到异常值,我们就增加 self.num_frame_no_success 并返回 False。我们可能还想打印一条关于异常值的消息,以便查看它具体在何时出现:
python
        except Outlier as e:
            self.num_frames_no_success += 1
            return False, None, None
否则,如果没有检测到异常值,我们就可以相当确信已经成功在当前帧中定位到了感兴趣的物体。在这种情况下,我们首先存储单应性矩阵并重置计数器:
python
        else:
            # reset counters and update Hinv
            self.num_frames_no_success = 0
            self.last_h = Hinv
以下代码行显示了用于展示的图像变换:
python
            img_warped = cv2.warpPerspective(
                img_query, Hinv, (sh_query[1], sh_query[0]))
最后,我们像之前一样绘制良好的匹配和角点,并返回结果:
python
            img_flann = draw_good_matches(
                self.img_obj,
                self.key_train,
                img_query,
                key_query,
                good_matches)
            dst_corners[:, 0] += self.sh_train[1]
            cv2.polylines(
                img_flann,
                [dst_corners.astype(int)],
                isClosed=True,
                color=(0, 255, 0),
                thickness=3)
            return True, img_warped, img_flann
在上述代码中,如前所述,我们将角点的 x 坐标偏移了训练图像的宽度,因为查询图像是显示在训练图像旁边的;同时我们将角点的数据类型转换为整数,因为 polylines 方法接受整数作为坐标。
8. 运行效果
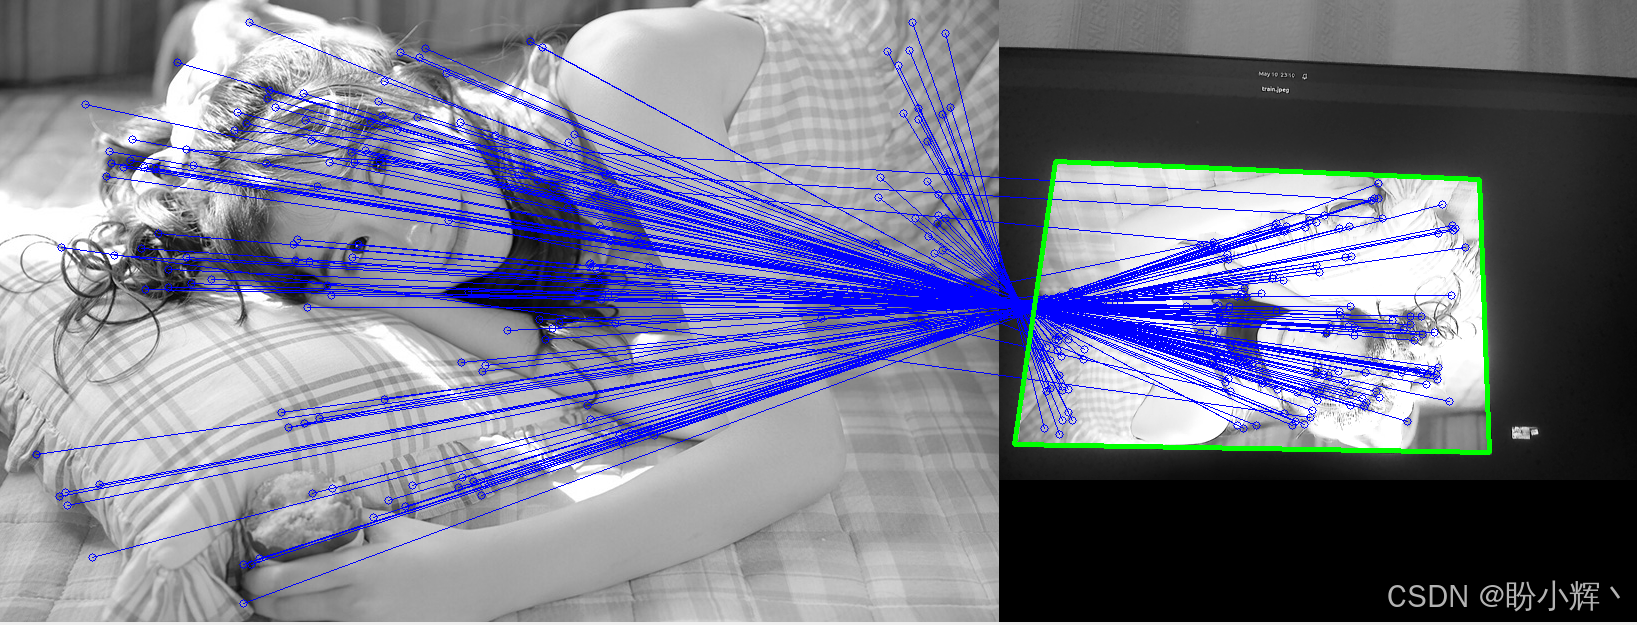
在实时视频流中,匹配过程的结果如下图所示:
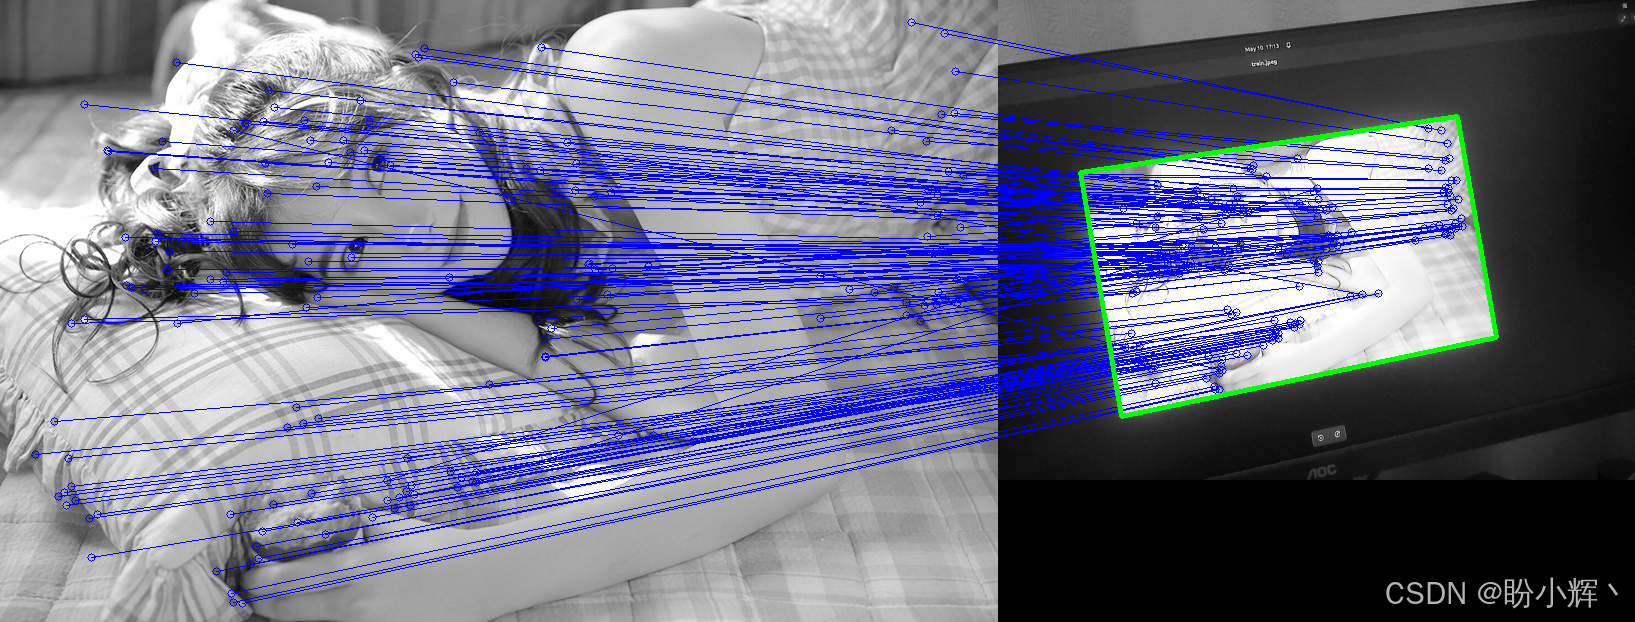
可以看到,模板图像中的大部分关键点都与右侧查询图像中的对应点正确匹配。现在,可以将打印出的模板图像缓慢地移动、倾斜和旋转。只要所有角点都保持在当前帧内,单应性矩阵就会相应更新,并且模板图像的轮廓也能正确绘制。
即使打印出的图像是倒置的,该算法也能正常工作,如下图所示::
在所有情况下,变换后的图像都能将模板图像校正为正面平行平面上的居中直立状态。这产生了一种酷炫的效果:模板图像仿佛被冻结在屏幕中央,而周围的场景则围绕它旋转扭曲,如下图所示:
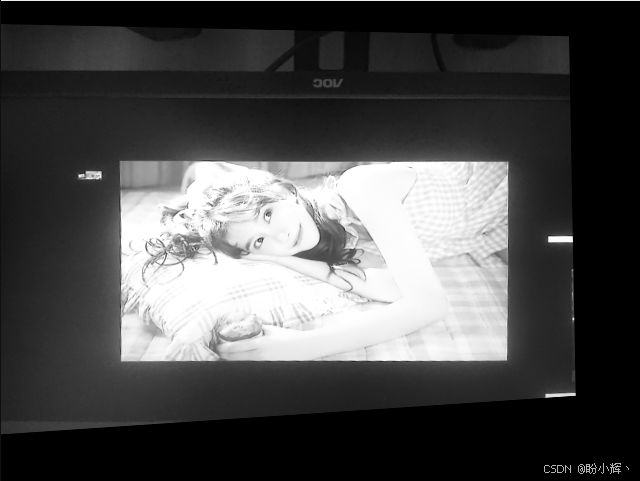
在大多数情况下,变换后的图像看起来相当准确,如上图所示。如果由于某种原因,算法接受了一个错误的单应性矩阵,导致变换后的图像不合理,那么算法将在半秒内(即在 self.max_frames_no_success 帧内)丢弃该异常值并恢复,从而实现准确且高效的持续跟踪。
小结
本节介绍了一种鲁棒的特征跟踪方法,该方法速度足够快,能够实时应用于网络摄像头的视频流。首先,算法展示了如何在一幅图像中提取和检测重要特征------无论是我们感兴趣的模板图像(训练图像),还是预期包含该物体的更复杂场景(查询图像),这些特征都具有视角和尺寸不变性。然后,通过使用快速版本的最近邻算法对关键点进行聚类,找到两幅图像中特征点之间的匹配。在此基础上,可以计算出一个将一组特征点映射到另一组的透视变换矩阵。利用这些信息,我们可以在查询图像中勾勒出训练图像的轮廓,并对查询图像进行透视变换,使感兴趣的物体以直立状态显示在屏幕中央。掌握了这些知识,我们就为设计特征跟踪、图像拼接或增强现实应用奠定良好的基础。
系列链接
OpenCV-Python实战(1)------OpenCV简介与图像处理基础
OpenCV-Python实战(2)------图像与视频文件的处理
OpenCV-Python实战(3)------OpenCV中绘制图形与文本
OpenCV-Python实战(4)------OpenCV常见图像处理技术
OpenCV-Python实战(5)------OpenCV图像运算
OpenCV-Python实战(6)------OpenCV中的色彩空间和色彩映射
OpenCV-Python实战(8)------直方图均衡化
OpenCV-Python实战(9)------OpenCV用于图像分割的阈值技术
OpenCV-Python实战(10)------OpenCV轮廓检测
OpenCV-Python实战(11)------OpenCV轮廓检测相关应用
OpenCV-Python实战(12)------一文详解AR增强现实
OpenCV-Python实战(13)------OpenCV与机器学习的碰撞
OpenCV-Python实战(14)------人脸检测详解
OpenCV-Python实战(15)------面部特征点检测详解
OpenCV-Python实战(16)------人脸追踪详解
OpenCV-Python实战(17)------人脸识别详解
OpenCV-Python实战(18)------深度学习简介与入门示例
OpenCV-Python实战(19)------OpenCV与深度学习的碰撞
OpenCV-Python实战(20)------OpenCV计算机视觉项目在Web端的部署
OpenCV-Python实战(21)------OpenCV人脸检测项目在Web端的部署
OpenCV-Python实战(22)------使用Keras和Flask在Web端部署图像识别应用
OpenCV-Python实战(23)------将OpenCV计算机视觉项目部署到云端