摘要 :SHWD 转 YOLO 后,用 YOLO26n 微调出 best.pt;本文不堆 SOTA,重点带读 Ultralytics predict------数据坑点、预训练 vs 微调一眼对比,以及图进 predict 后 preprocess→NMS→Results 全链路,并扣回安全帽 FastAPI demo。
0. 引子
Agent 风很大,这篇偏冷一点:AI 视觉 ------从老数据集转换,到训练,再到线上天天跑的 predict。
数据来自 Safety-Helmet-Wearing-Dataset(SHWD),2018 年前后的工业安全帽场景,VOC 标注。工业视觉需求一直在;原仓自带的老模型效果已经不错,我们要做的是 VOC→YOLO → 微调 → predict 落地 。训练只简述;正文主吃 predict 链------不通读 loss、不卷 mAP、不在这篇开调优 KPI。
产出:YOLO26n 微调后的 best.pt,以及已部署的安全帽 FastAPI demo(后文两三行)。这是专栏 「AI 视觉之路」 的第一块砖。闲言少叙。
1. 数据:SHWD 接到 YOLO
整条链就四步:
text
SHWD(VOC)→ voc_to_yolo_shwd.py(--limit 10 冒烟 → 全量)
→ images/ + labels/ + data.yaml
→ yolo train → best.pt
全量大约 3GB ;务必先 --limit 10 冒烟,再跑全量。脚本核心:读 VOC xml → 坐标换算 → 摆 YOLO 目录 → 写 data.yaml。细节见仓库 voc_to_yolo导读.md,正文只记坑。
| 坑 | 怎么踩、怎么避 |
|---|---|
| VOC 坐标 1-based | 中心点换算要 - 1 ,和 Ultralytics VOC.yaml 同源 |
| 类名必须对齐 | 脚本认 hat / person(0/1),xml 写 helmet 会被静默丢掉 |
| 冒烟再全量 | --limit 10 看 labels/*.txt 四列是否在 0~1 |
| train/val 划分 | 跟 SHWD 自带 ImageSets/Main/*.txt,脚本不随机切 |
| 线上 predict | 不要 data.yaml、不要 labels------只有 train 吃标注 |
数据篇只保证「能训」;真正线上跑的是 predict。
2. 训练与第一眼效果
底座 YOLO26n,在全量 SHWD 上微调:
bash
yolo train model=yolo26n.pt data=shwd_yolo/data.yaml epochs=... imgsz=640产出在 runs/detect/train/weights/best.pt。本篇 不贴 mAP、不贴训练曲线
只放一张同图上的两次 predict 效果图: yolo26n.pt、best.pt,框的差异一眼能看懂。
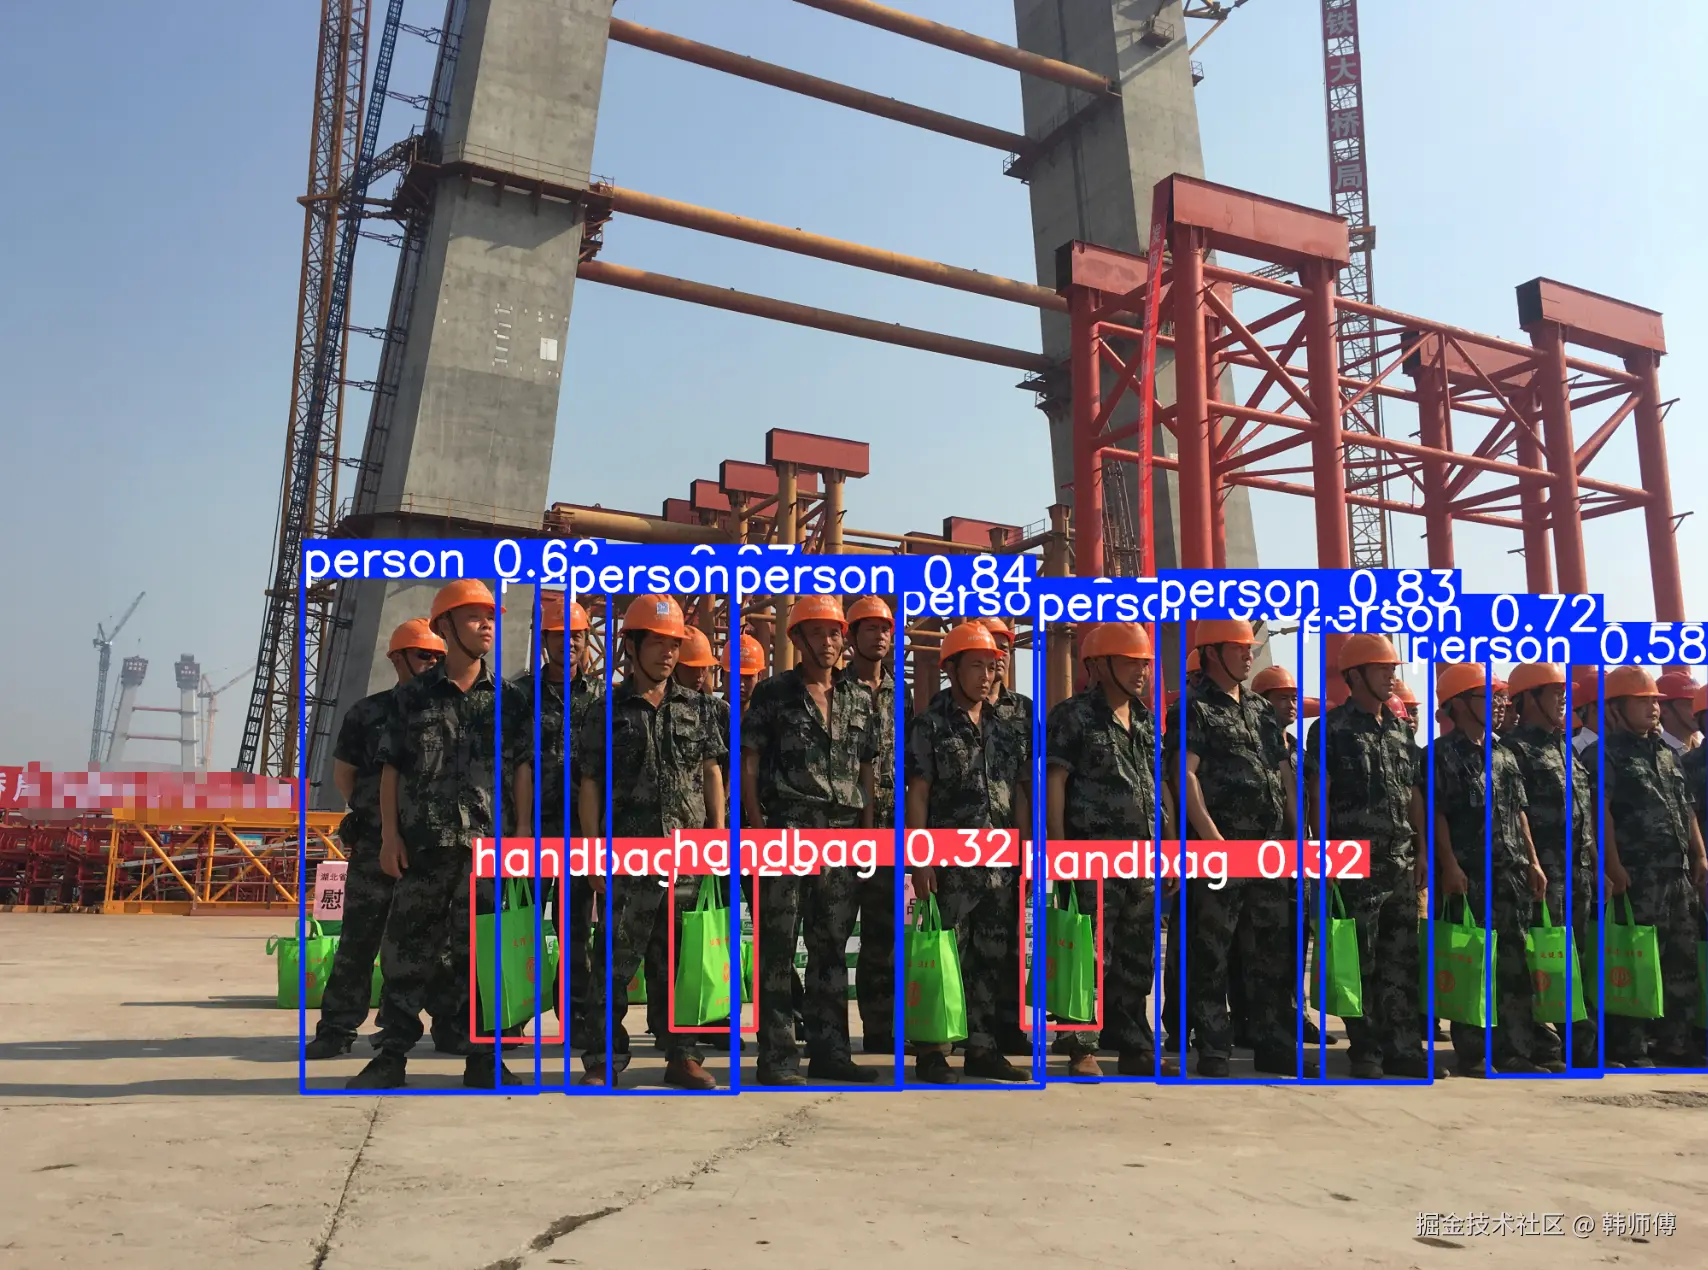
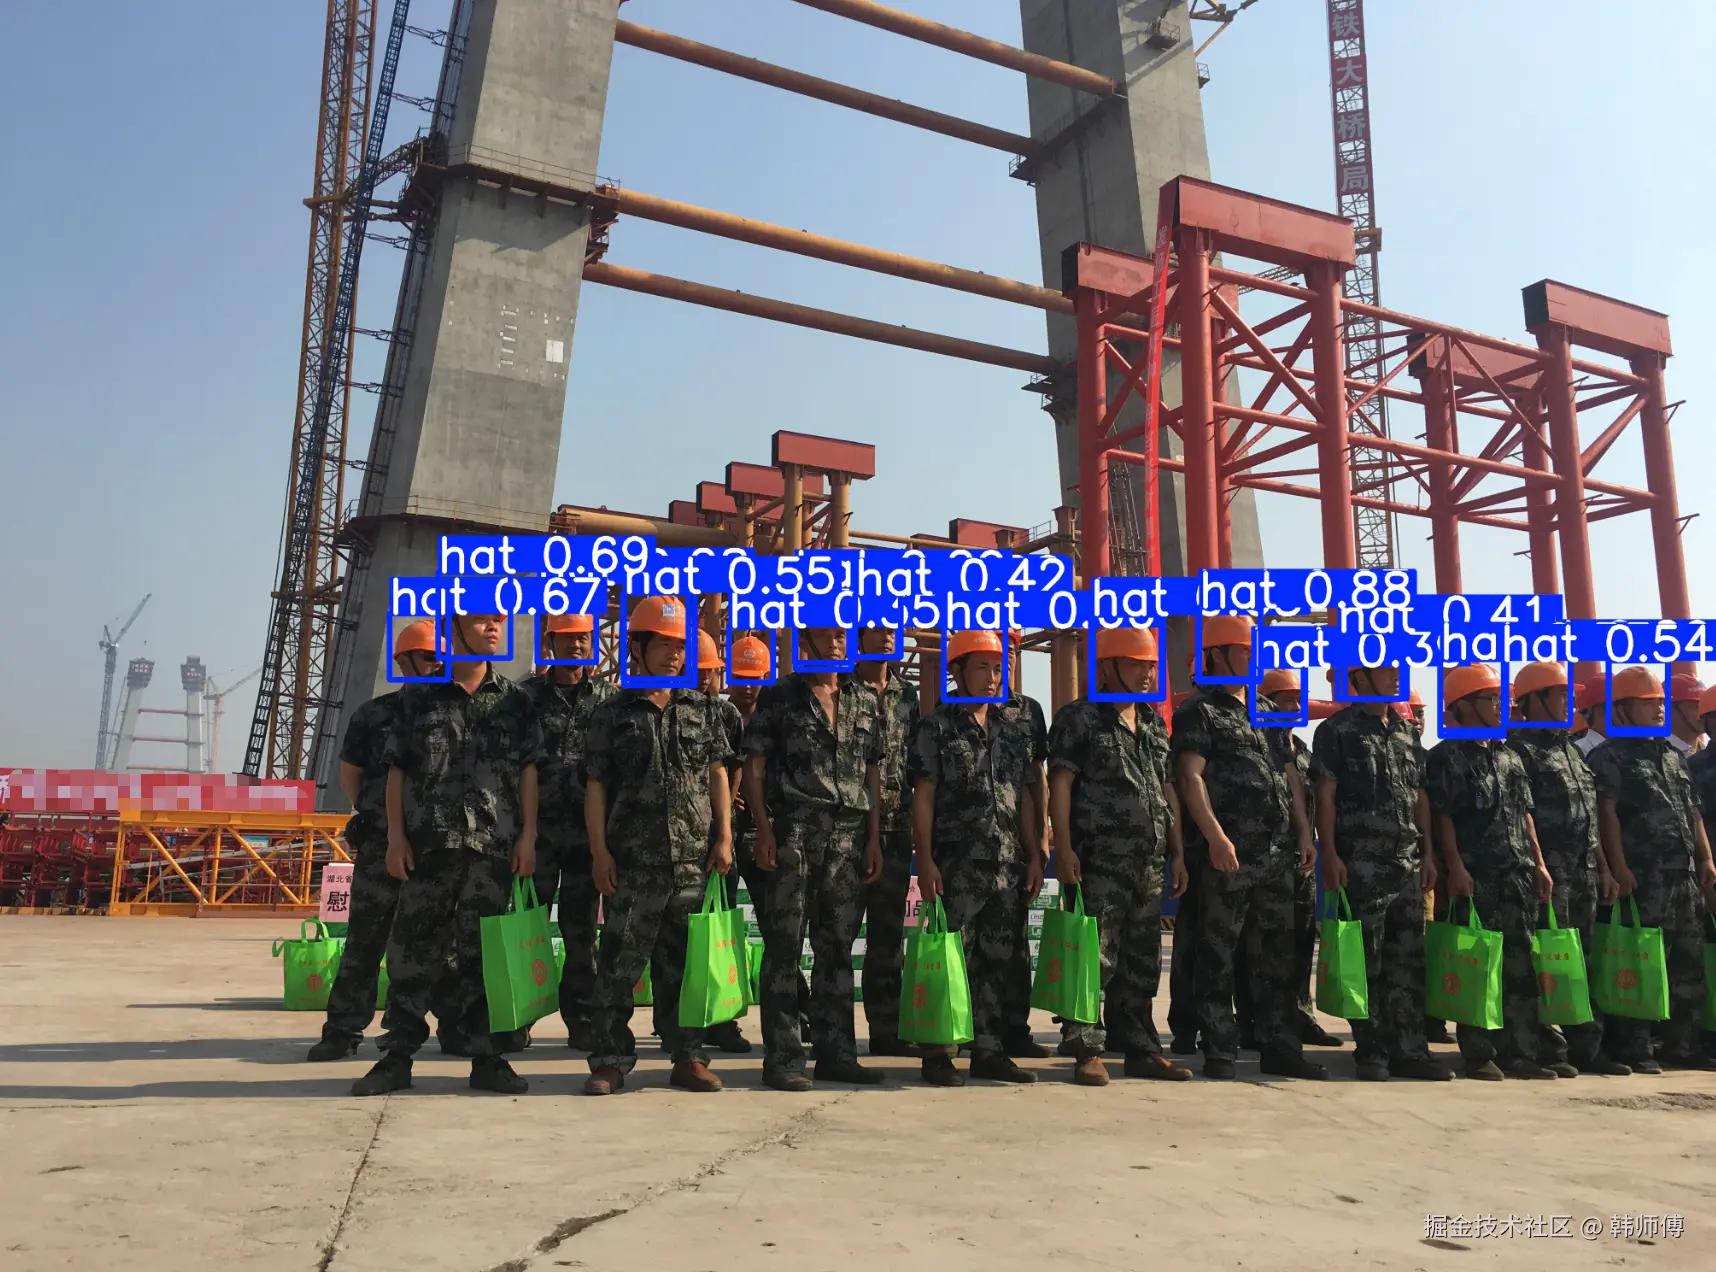
预训练 vs 微调 ------同一张图跑两次 predict:
yolo26n.pt |
best.pt |
|
|---|---|---|
| 框什么 | 只框 人(COCO 习惯) | 框 hat / person(安全帽业务) |
| 读者带走 | 预训练 ≠ 你的场景 | 微调换的是 检测目标 |
训练证明数据能学。半个安全帽在现版权重下不一定检出------多半是数据难例 / 标注覆盖不足,不是 predict 链 bug。补标(半帽、未戴帽的头部)和 OpenCV 辅助看图留系列后文,这篇不收工在这。
3. predict 链:图进来之后发生了什么
best.pt 到手之后,真正线上天天调用的是 predict。图片进入 predict 之后,都经历了什么?
先背四句话:合并参数 → 转成模型能吃的 → 各步吃不同参数 → 拼成 Results。
text
source → 合并 args → preprocess → inference → postprocess → Results[0].boxes和 train 的分界 :yolo train 要 data.yaml 和 images/ + labels/ 成对;predict 只要图、不要标注 。Python API 返回 list[Results] ;CLI yolo predict 走 predict_cli,默认写 runs/detect,不把 Results 还给 shell。
调用链(文件级,贴正文比 prose 省事):
text
yolo predict model=best.pt source=... conf=0.25
  │
  ▼
cfg/__init__.py :: entrypoint()
  ▼
engine/model.py :: Model.predict()     ← 拼 args,选 predictor
  │  CLI → predict_cli  |  API → list[Results]
  ▼
models/yolo/model.py :: task_map       ← detect → DetectionPredictor
  ▼
engine/predictor.py :: stream_inference()
  │  preprocess → inference → postprocess
  ▼
models/yolo/detect/predict.py :: postprocess()   ← NMS + scale_boxes
  ▼
engine/results.py :: Results / Boxes             ← FastAPI 吃这层
入口前先认门 :predict 能接的 source 类型很多------单张路径、目录、摄像头、URL、PIL、numpy ndarray 、tensor 都行;常见入参还有 conf(置信度阈值)、iou(NMS)、imgsz、device、save / show 等。完整列表以 Ultralytics Predict 官方文档 为准,别背参数表,需要时查。
我们安全帽 FastAPI 走的是 source=ndarray 那条:上传图解码成 BGR 数组,再 model.predict(source=ndarray, conf=0.25)。终端 yolo predict source=某.jpg 会先读文件,前面多一步「怎么拿到图」 ;进 stream_inference 之后,和 ndarray 走的是 同一套 preprocess → inference → postprocess。
参数合并 :model.predict(...) 里,conf、device、imgsz 等合成一份 args(右边 kwargs 覆盖左边)。detect 任务落到 DetectionPredictor,主循环在 stream_inference。
预处理 → 推理 → 后处理(三步拆开看,别挤一段):
| 步 | 干什么 | 谁吃哪些参数 | 安全帽线落在哪 |
|---|---|---|---|
| preprocess | 各种 source 统一收成 float tensor | imgsz(letterbox/resize) |
上传 ndarray → BGR → letterbox → RGB → BCHW → /255 |
| inference | self.model(im) forward |
augment 等 |
模型 只吃 tensor;前面读文件还是收 HTTP,都是为这一步备料 |
| postprocess | 先 conf 筛框 ,再 NMS(iou)去重合 ,最后 scale_boxes 还原原图 |
conf、iou(见下) |
DetectionPredictor:框坐标回到 原图像素 |
conf 和 iou 要认 :都在 postprocess,但 顺序是先 conf、后 iou 。forward 吐出一堆候选框之后,先用 conf(置信度阈值) 卡一刀------分数低于阈值的丢掉;阈值越低,放出来的框越多 (漏检少、误检可能多)。剩下来的框再做 NMS : iou 看两框重叠程度 (交并比),重叠太高的视为同一目标,留分高的、删重合的。所以 iou 不是「越大框越多」,而是 NMS 里判定『算不算同一个框』的门闩 ------通常 iou 阈值设得高,才更容易把重叠框并掉。最后再 scale_boxes,从 letterbox 尺寸映射回上传图的原尺寸。
补一句易混:像素 /255 是 tensor 归一化,不是 标签 txt 里框坐标的 0~1。面试可以这么说:模型吐候选框,conf 筛、iou 去重,NMS 留不相重的。
Results :Results / Boxes 官方说明 里字段和方法很多------plot()、save()、to_json()、summary() 等,检测线不必通读一千多行实现。我们服务化只摘 results[0].boxes 的 xyxy、conf、cls 转 JSON;照仓库 scripts/predict_batch.py 的 detection_to_dict 即可。
官方还支持 predict 回调(Callbacks)------在 on_predict_start、on_predict_batch_end 等钩子里插自己的处理或测试步骤,整条链是可扩展的。这篇没玩,后面系列可以试。
| 误区 | 正解 |
|---|---|
| predict 要吃 labels | 只有 train 要标注 |
| 基类 postprocess 没 NMS | DetectionPredictor 里写了 |
| BGR 直接进网络 | preprocess 里转 RGB |
图进来先 letterbox,模型出 raw box,NMS 去重叠,Results 包成可画可 JSON;FastAPI 只摘 results[0].boxes。
4. 扣回工程:predict 之后怎么用
带读 predict 链,是为了 接到自己的工程里 。这里面最值钱的一块是 best.pt------微调后的权重 ;data.yaml 和训练脚本可以留在训练机,线上推理只要权重 + Ultralytics 库。
思路很直:在自己的 FastAPI 项目里装 ultralytics,启动时 YOLO("path/to/best.pt") 加载一次;暴露 POST /detect,收上传图 → 解码成 ndarray → model.predict(source=ndarray) → 把 results[0].boxes 转成 JSON 返回。和 §3 是同一套 predict 链,不是另写一套推理。漏检、空检是模型/数据问题,不是 API 层 bug。
前端不用上复杂框架:一个 index.html + <canvas> 就够做演示------选图上传,拿回 xyxy / conf / cls,在 canvas 上画框、标类名,就是一个能给别人看的小工具。
5. 作者的话
AI出现之后,总感觉是放大了一些幻想。
能看到很多地方让AI跑所有的开发工作,200刀的套餐,就是全自动生产状态了。
很多在技术深耕多年的程序员,在看到贵价AI写的高质量代码之后,陷入了焦虑。
多年积攒下来的技术骄傲,好像瞬间粉碎了。
他们变得害怕错误,什么事情都交给AI。
我看着他们的自我意识逐渐被吞噬,只想一直向前游,游到海水变蓝。
真的还想继续深耕下去,我还不想放弃。