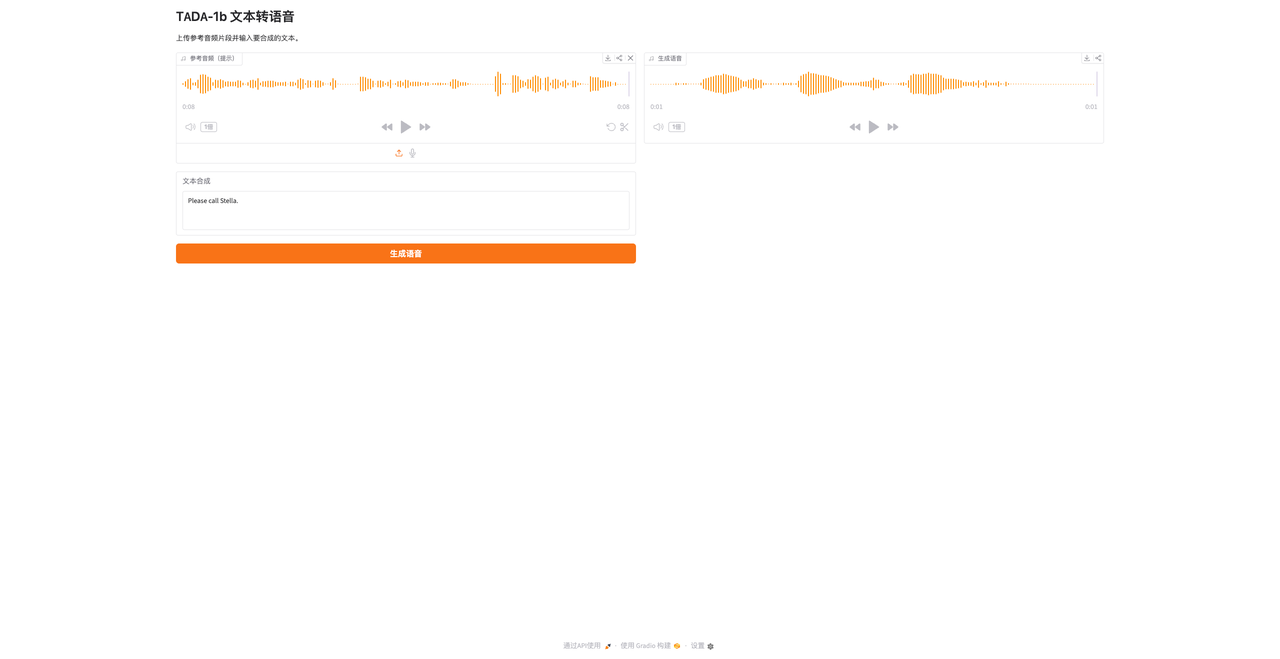
用 AI 进行语音合成时,常遇到几种割裂感:开头自然,越往后越像「机器人念经」;音色对了,语气节奏却走样。这是因为以往的 TTS 要么文本先跑再后续配音,导致语义韵律脱节;要么暴力堆参,长文本后半段对齐失焦,断层、吞字、机械感频出。
HumeAI 今年推出的 TADA-1b 打破了这一屏障。模型基于 Llama 3.2-1B 轻量底座,单卡即可承载,核心的革新点在于 Text-Acoustic Dual Alignment。它让模型不再「先阅读文本,再模仿声音」,而是在音频生成中让词义、语气、节奏、音色同步推进。这带来三个明显变化:
第一,零样本克隆更自然。无需多条干声或 LoRA 微调,几秒参考音频就能抓住音色特质与韵律习惯,生成带呼吸感、有断句逻辑的表达。
第二,长文本不再「越念越虚」。长序列对齐能力让长文档配音语气一致、重点突出,且支持语音续写,拼接几乎无痕。
第三,轻量可本地运行。1B 参数规模无需 A100 集群,消费级显卡即可流畅推理。
教程链接: https://go.openbayes.com/ymbOT 使用云平台: OpenBayes http://openbayes.com/console/signup?r=sony_0m6v
首先点击「公共教程」,找到「TADA-1b : 带文本-声学双重对齐的文本转语音系统」,单击打开。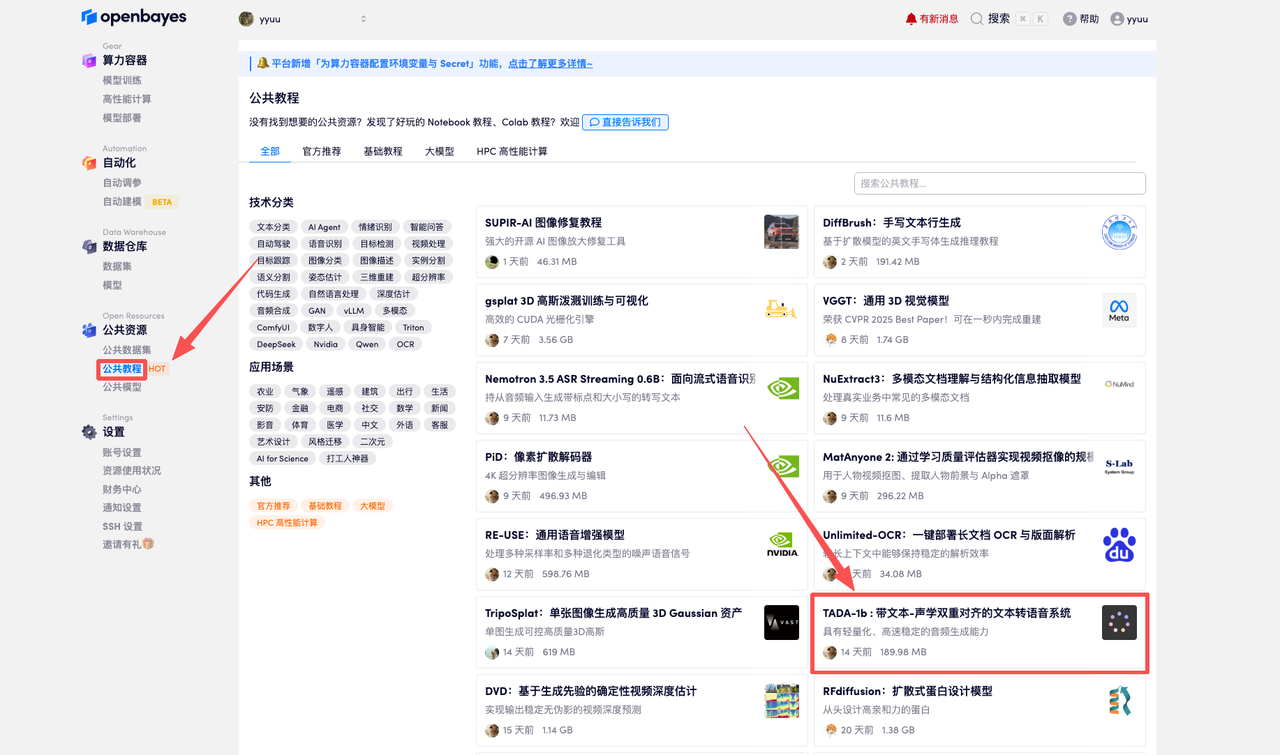
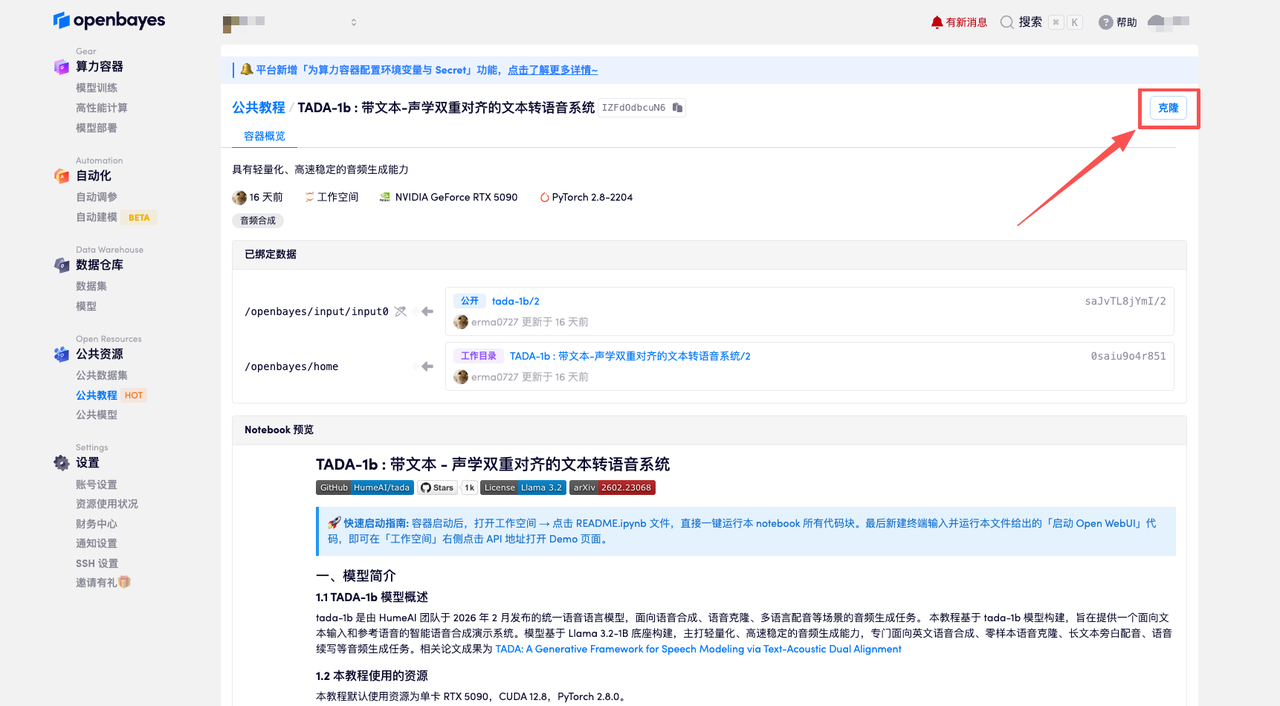
页面跳转后,点击右上角「克隆」,将该教程克隆至自己的容器中。
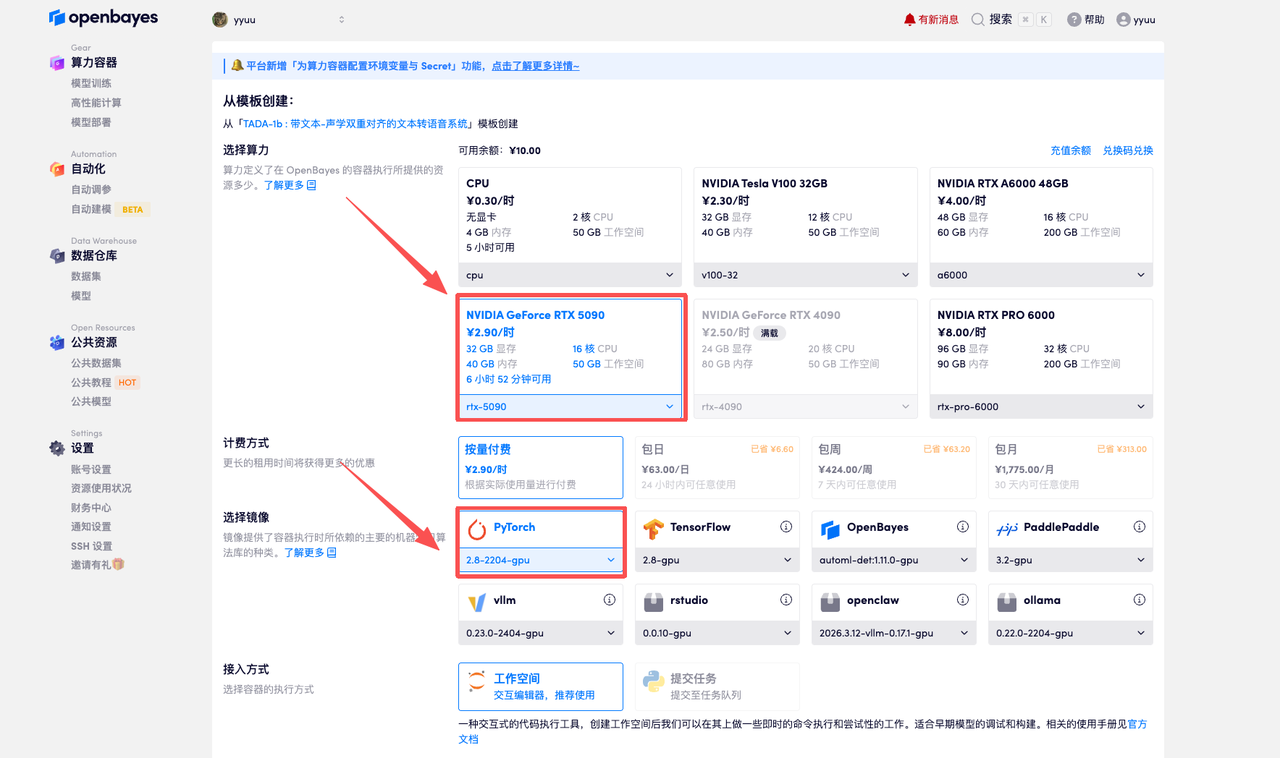
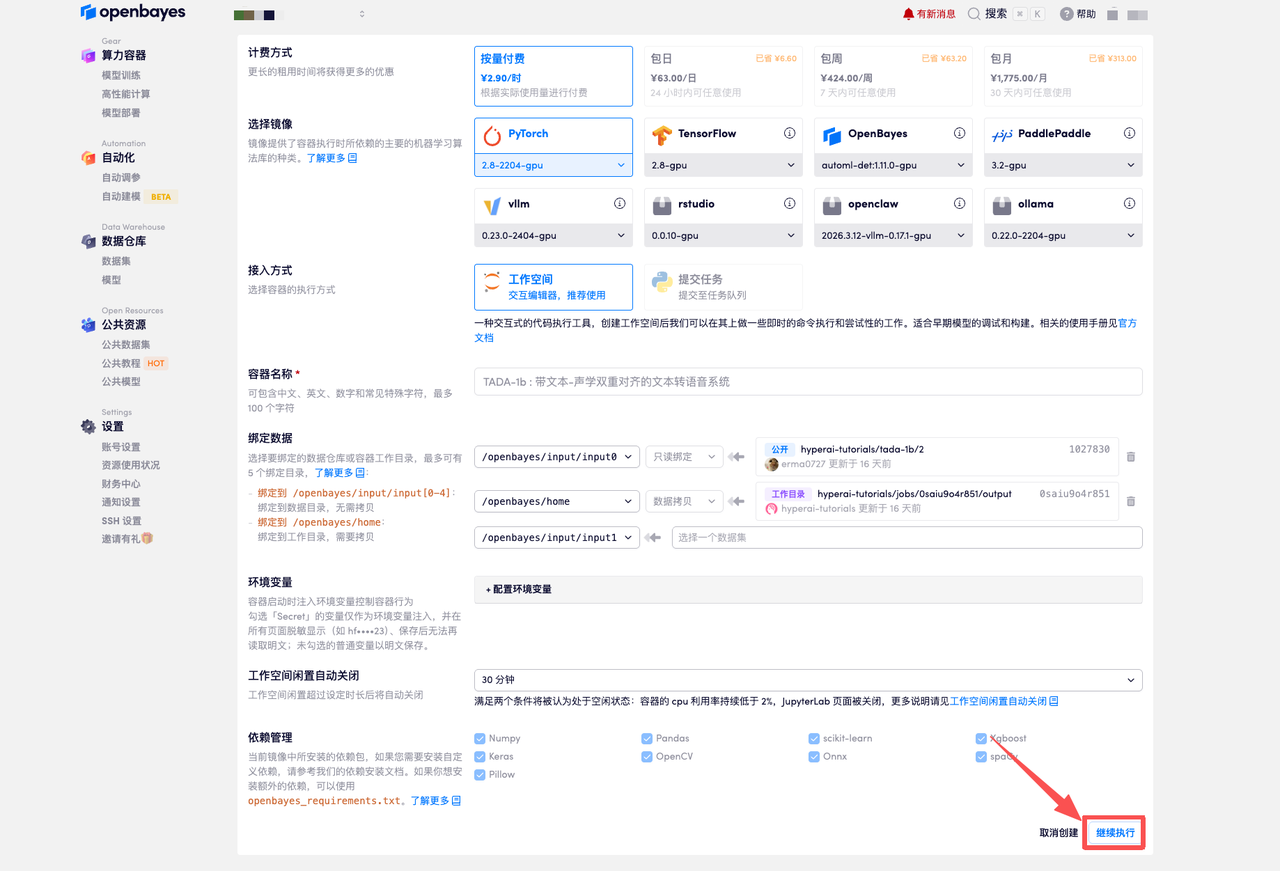
在当前页面中看到的算力资源均可以在平台一键选择使用。平台会默认选配好原教程所使用的算力资源、镜像版本,不需要再进行手动选择。点击「继续执行」,等待分配资源。
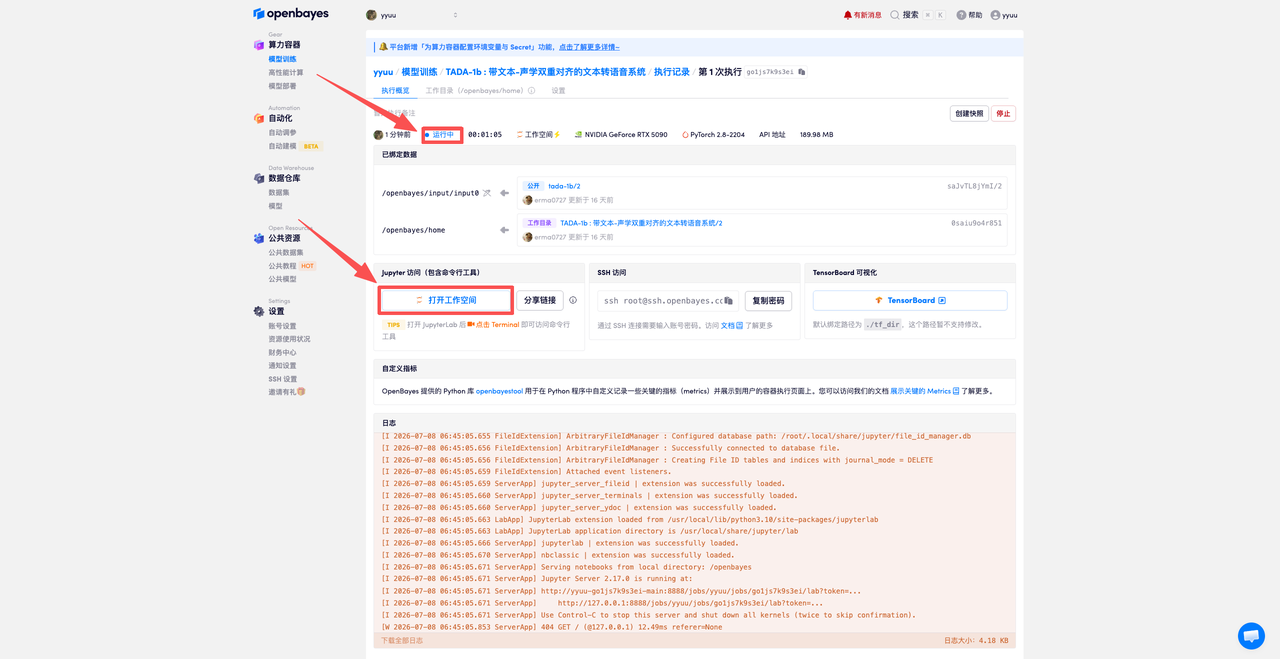
当状态变为「运行中」后,点击「打开工作空间」进入 Jupyter Workspace。
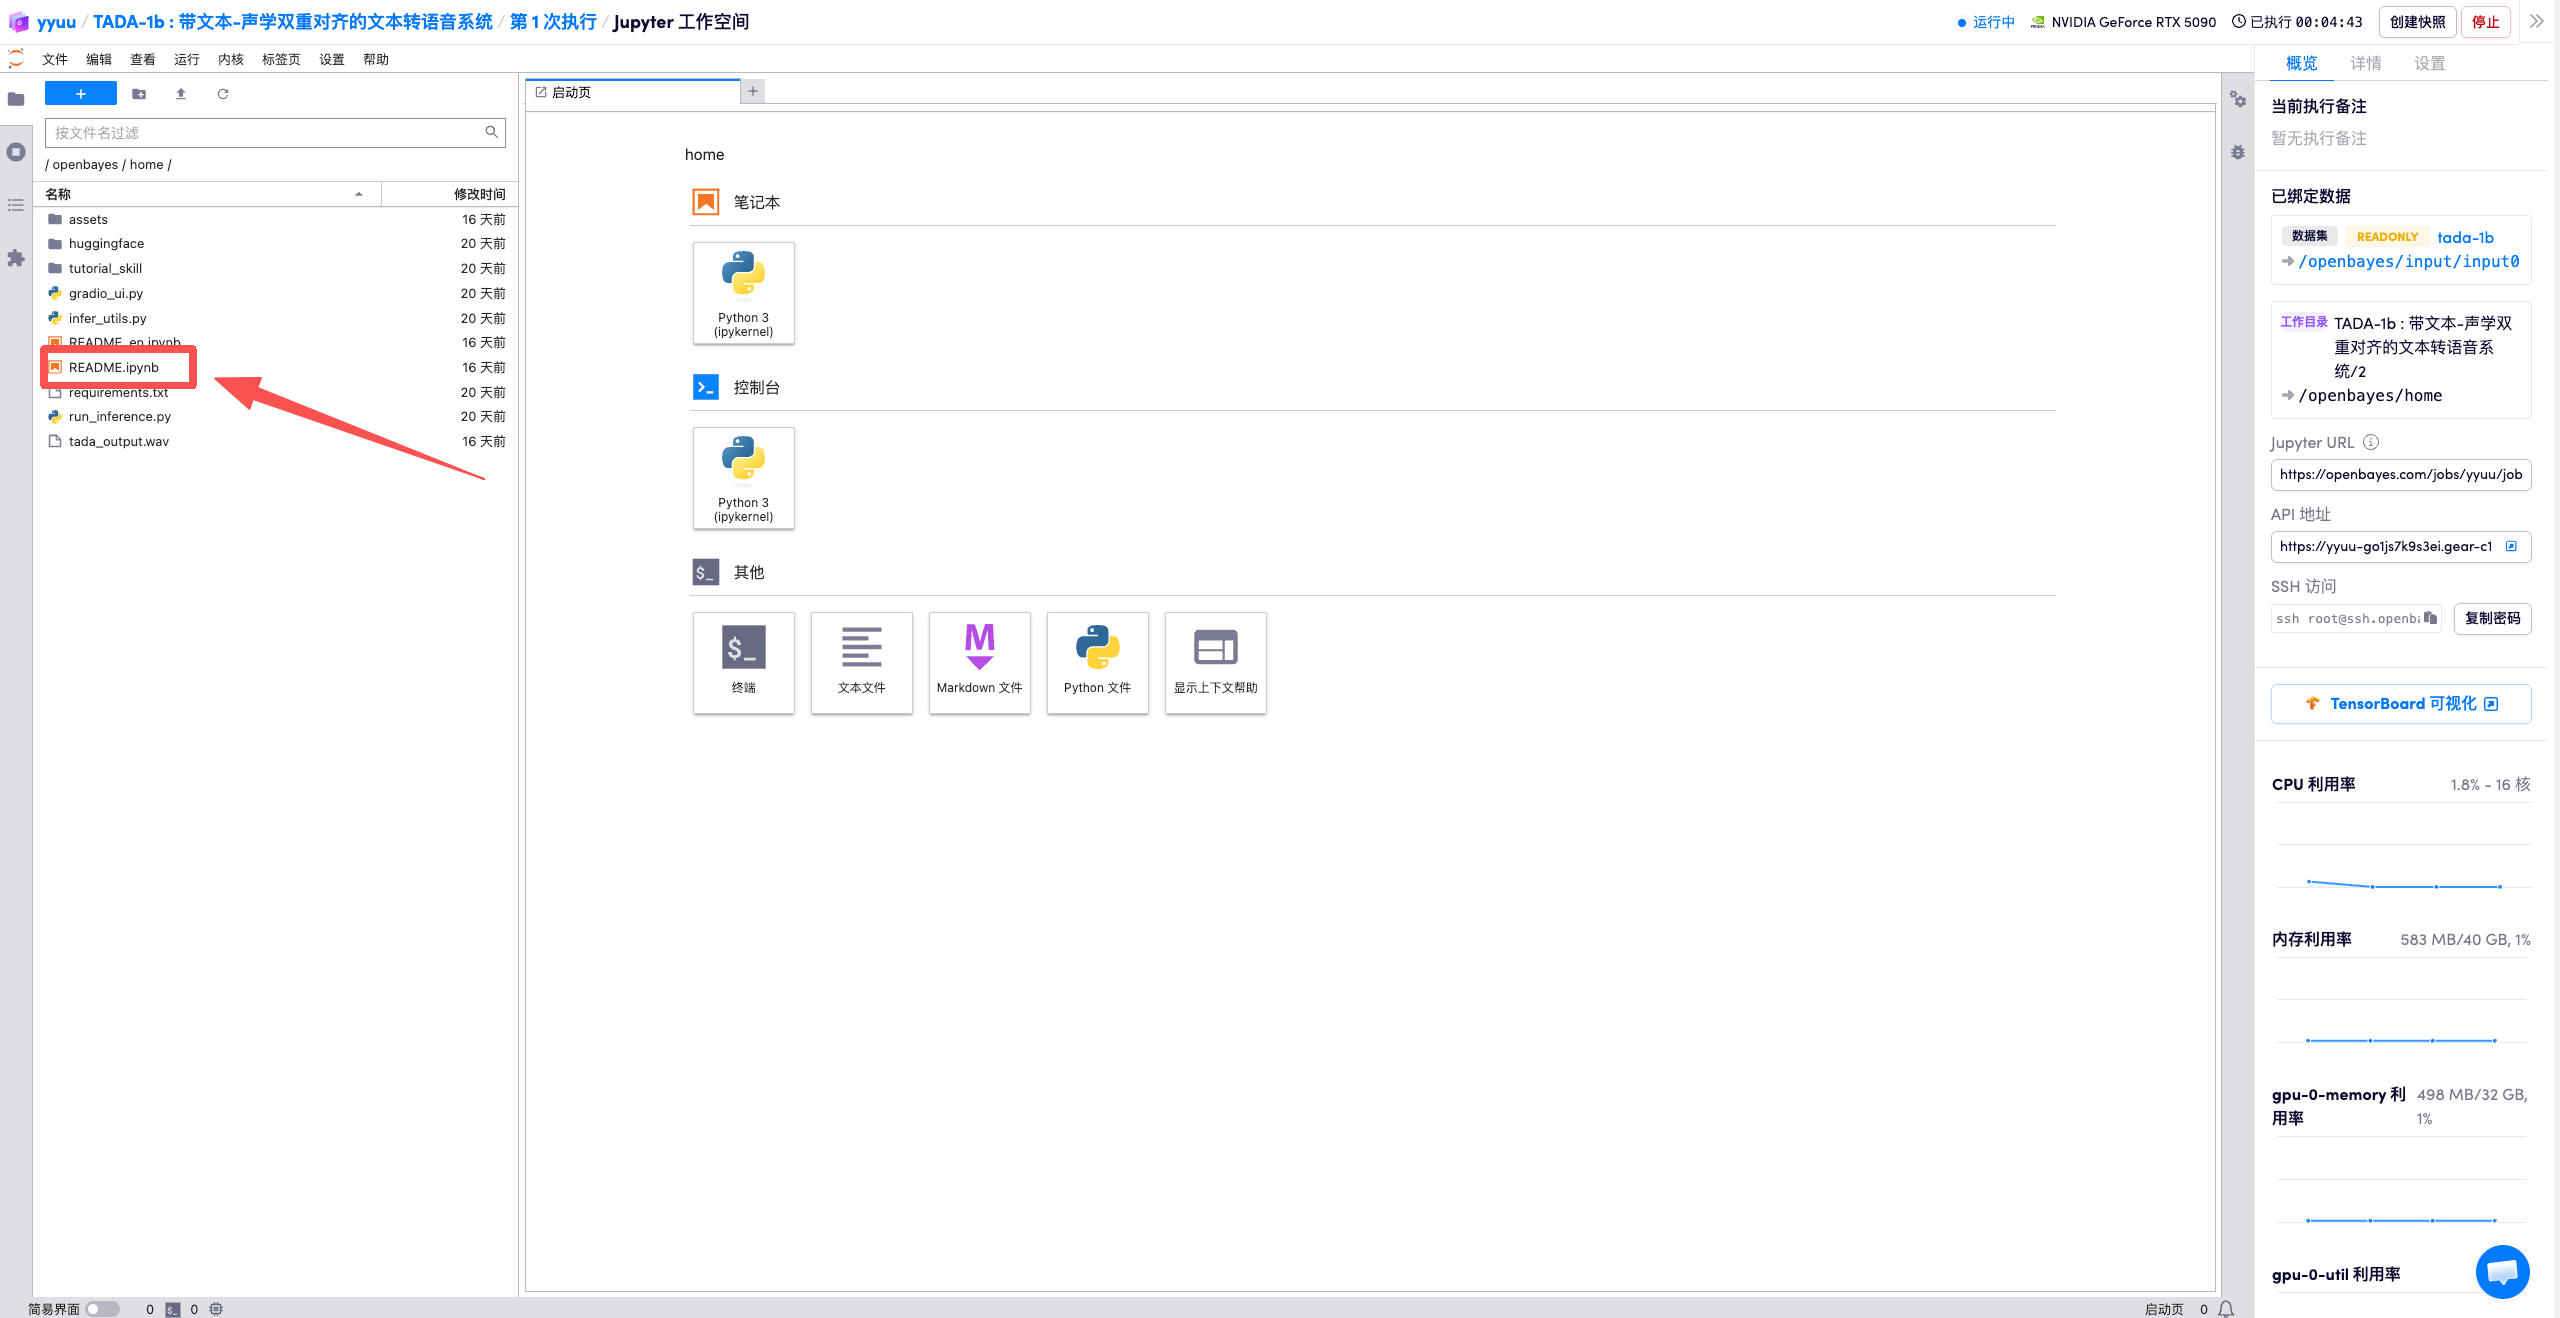
点击 README.ipynb 文件,直接一键运行本 notebook 所有代码块。
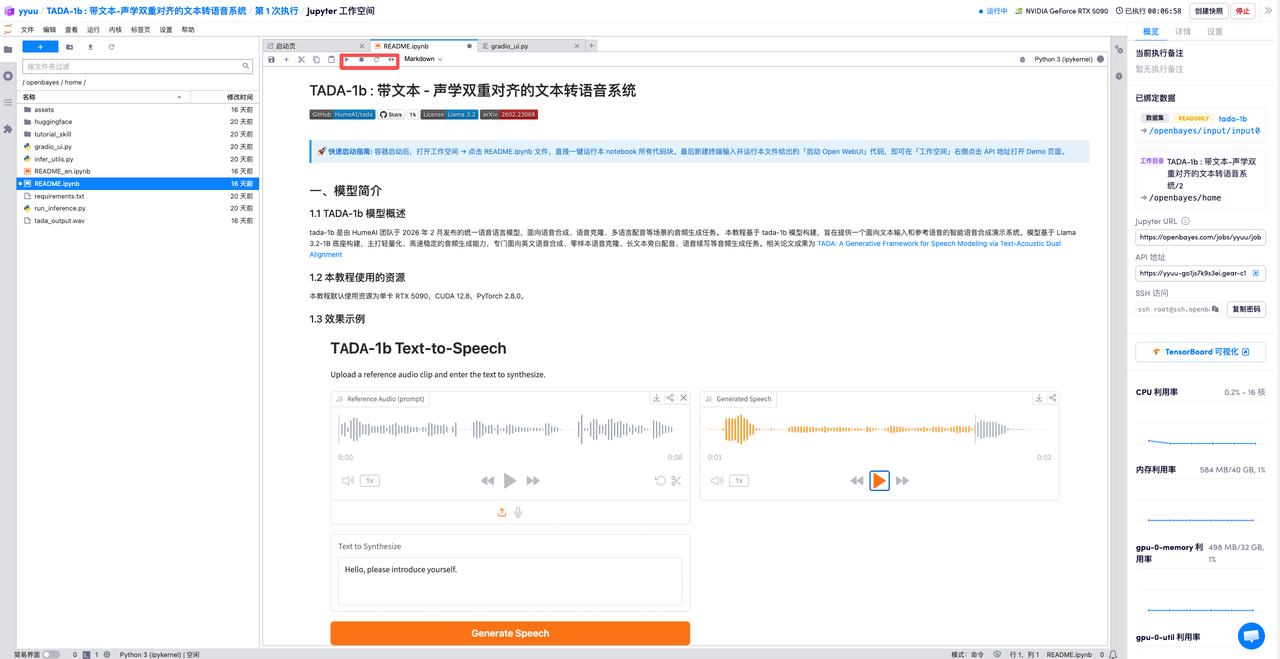
点击下方 Public URL 或者右侧 API 地址即可访问
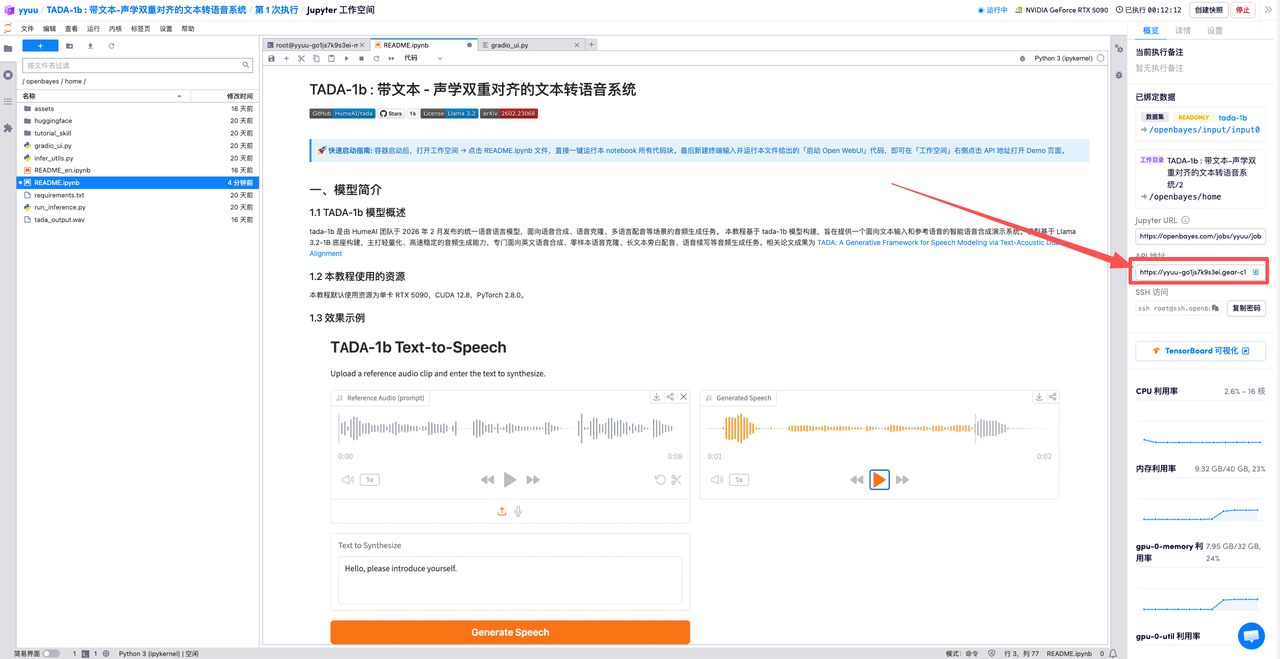
效果展示: