一、什么是Transformer
Transformer 是一种基于"注意力机制(Attention)"的深度神经网络架构,最初用于自然语言处理(NLP),后来成为大语言模型(如 GPT 系列)、机器翻译、语音、图像、多模态 AI 等领域的核心架构。
简单说:
Transformer 是一种能够理解序列中不同元素之间关系的神经网络。它通过 Self-Attention(自注意力)机制决定哪些信息更重要,而不是像传统网络那样依次处理数据。
二、Transformer 属于哪一类神经网络?
从分类上看:
-
深度神经网络(Deep Neural Network, DNN)
- ↓
-
人工神经网络(ANN)
- ↓
-
序列模型(Sequence Model)
- ↓
-
基于注意力机制的神经网络(Attention-based Neural Network)
- ↓
-
Transformer
它和以下模型属于不同路线:
| 模型 | 特点 |
|---|---|
| CNN(卷积神经网络) | 擅长图像、局部特征 |
| RNN(循环神经网络) | 擅长序列,但逐步处理,难并行 |
| LSTM/GRU | 改进版 RNN,解决长距离记忆问题 |
| Transformer | 用注意力机制直接捕捉长距离关系 |
三、Transformer 的核心:Self-Attention(自注意力)
假设一句话:
"小明把苹果放在桌子上,因为它很好吃。"
模型需要知道"它"指的是苹果,而不是桌子。
传统 RNN:
小明 → 把 → 苹果 → 放 → 在 → 桌子 → 上需要一步一步传递信息,距离越远越难记。
Transformer:
它会同时查看所有词:
小明   把   苹果   放   在   桌子   上
              ↑
          重点关注
通过 Attention 计算:
- 哪些词和当前词相关?
- 相关程度是多少?
- 应该分配多少"注意力"?
数学上通常表示为:
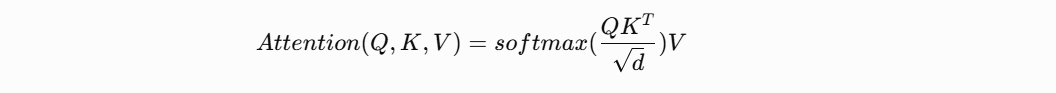
其中:
- Q(Query):我正在寻找什么信息
- K(Key):每个词提供什么标签
- V(Value):实际的信息内容
四、Transformer 的结构
经典 Transformer(2017 年论文 Attention Is All You Need)包括:
1、Encoder(编码器)
负责理解输入:
输入文本
 ↓
Embedding
 ↓
Self-Attention
 ↓
Feed Forward
 ↓
输出表示
例如:
输入:
"我喜欢机器学习"
Encoder 生成对这句话的理解。
2、Decoder(解码器)
负责生成输出:
已有文本
 ↓
Masked Attention
 ↓
Encoder Attention
 ↓
生成下一个词
例如:
输入:
"请翻译:Hello"
Decoder 输出:
"你好"
五、GPT 属于 Transformer 吗?
是。
但 GPT 使用的是 Transformer Decoder 部分。
大致关系:
Transformer
│
├── Encoder-only
│     └── BERT
│
├── Decoder-only
│     └── GPT、ChatGPT
│
└── Encoder-Decoder
      └── T5、原始机器翻译模型
六、为什么 Transformer 能支撑 ChatGPT 这种大模型?
主要有几个原因:
① 可以并行计算
RNN:
词1 → 词2 → 词3 → 词4必须按顺序。
Transformer:
词1
词2
词3
词4
 ↓
同时计算 Attention
训练速度大幅提升。
② 能处理长距离关系
例如:
"十年前我在北京认识的那位朋友,现在住在哪里?"
Transformer 可以直接关联:
朋友 ←→ 住在哪里不需要经过中间所有词。
③ 可以扩大规模
Transformer 很适合堆叠:
Transformer Layer
Transformer Layer
Transformer Layer
...
(几十到几百层)
参数可以达到:
- GPT-3:约 1750 亿参数
- GPT-4 级别模型:规模更大(具体参数未公开)
七、总结
Transformer 是一种以自注意力机制为核心的深度神经网络,它通过学习序列中不同元素之间的重要关系,实现对语言、图像、声音等复杂数据的理解和生成,是现代大模型(LLM)的基础架构。
如果把神经网络比作学习方法:
- CNN:像"看局部细节"
- RNN:像"按顺序读书"
- Transformer:像"一边读整本书,一边判断每句话和其他内容的关系"。
补充一下:
GPT 不是先学英文,再把英文翻译成其他语言;它是在同一个 Transformer 中同时学习多种语言的 token 关系,并逐渐形成一个跨语言的语义空间;但是英文效果最好。