高可用与扩展:一台 PostgreSQL 不够用之后怎么办?
前面讲 Redis 时提过,为什么有时需要多台 Redis 服务器。PostgreSQL 也是一样:一台机器刚开始完全够用,但业务变大后,问题通常会从两个方向冒出来。
一边是单点故障。机器硬件故障、数据库进程被 OOM 杀掉、磁盘写满,都可能让数据库暂时不可用;如果只有这一份数据,硬盘物理损坏时风险就更大。
另一边是性能上限。一台机器的 CPU、内存和磁盘 I/O 都有边界。当读请求从每秒一千涨到每秒十万,继续堆硬件总有顶到头的时候。
接下来这些机制,分别是在解决不同的问题:复制让数据有副本,分区让大表更好管理,连接池则是避免连接本身把数据库拖垮。
流复制:先有一台能接班的备库
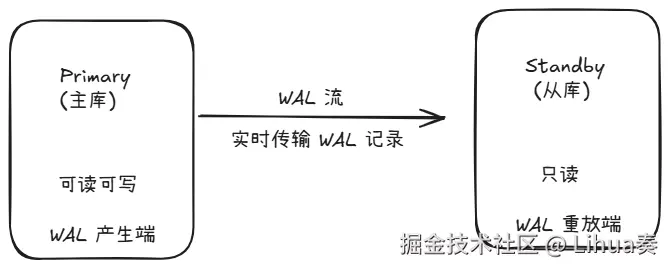
PostgreSQL 的流复制,可以简单理解为:主库持续把 WAL 传给备库,备库收到后不断重放这些修改,让自己的数据尽量跟上主库。
它和 Redis 的复制内容不太一样:
- PostgreSQL 传的是 WAL 中记录的物理变更,备库据此重放数据页的变化。
- Redis 的复制流更接近一系列对数据结构的操作命令,例如 SET key value。
流复制主要解决两个问题。
第一,故障切换。 主库挂掉后,可以把已经同步到数据的备库提升为新的主库,让它接着提供写服务。这里不是临时从备库"找 WAL 来恢复",而是备库在平时就一直接收并回放 WAL,所以才能接班。
第二,分担读请求。 备库处于热备状态时可以接收只读查询。把写请求继续发给主库、把一部分读请求发给备库,才真正形成读写分离,减轻主库压力。光是多出一台备库,并不会自动把请求分过去,应用或中间件还得负责路由。
还有一个需要知道的取舍:常见的异步复制会有一点延迟。如果主库刚提交完就立刻损坏,最后一小段还没传到备库的事务可能丢失;同步复制能降低这个风险,但提交速度和可用性会受到影响。
逻辑复制:我不想复制整个数据库
流复制复制的是整个数据库集簇的物理变化,不能随意说"我只要其中几张表"。如果需求是跨系统同步某些业务表,或者只迁移一部分数据,就可以用逻辑复制。
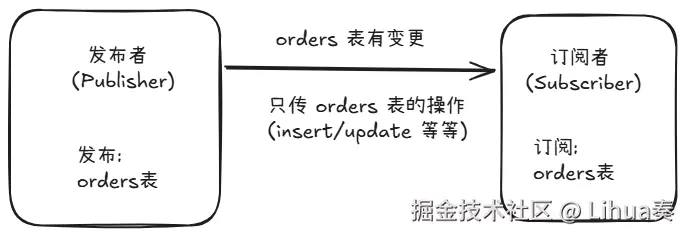
逻辑复制同样以 WAL 为基础,但它会先把 WAL 解码成"哪张表新增、修改或删除了什么数据"这样的逻辑变更记录,再发送给订阅端。
和流复制放在一起看会更清楚:
- 传输内容:流复制传物理变更;逻辑复制传解码后的逻辑变更。
- 复制粒度:流复制面向整个数据库集簇;逻辑复制可以选择指定的表。
- 订阅端写入:流复制的热备库只能读;逻辑复制的订阅端通常还能写自己的数据,但不要随意和复制流同时修改同一批数据,否则可能产生冲突。
- 典型场景:流复制更适合高可用和读写分离;逻辑复制更适合跨系统同步、部分数据迁移。
分区:不是多台机器,而是把一张大表拆开
分区解决的不是"多台机器一起扛请求",而是一张表太大的问题。
假设订单表三年积累了五亿行数据。即使有索引,维护、查询和清理这样一张超大的表也会越来越麻烦。这时可以按时间把它拆成多个分区,例如按年或按月存放订单。
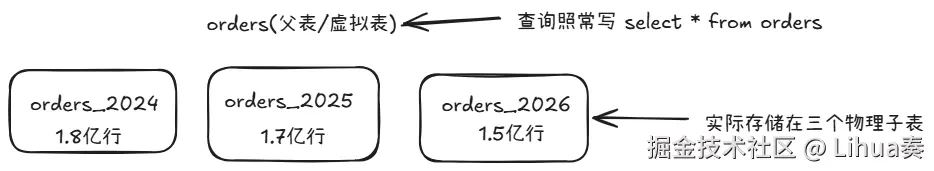
当查询条件里带着分区键时,PostgreSQL 就能做分区裁剪,直接跳过不可能有结果的分区。
sql
SELECT *
FROM orders
WHERE created_at >= '2026-07-01';

-- 可以跳过 2024、2025 等旧分区,
-- 只在可能包含结果的 2026 分区中继续查找。
这里要注意,分区并不是魔法:它不会自动把数据分到多台机器,也不是所有查询都会变快。只有查询条件能用上分区键,才能有效跳过无关分区。
连接池:别让连接数先把数据库压垮
PostgreSQL 通常会为每个客户端连接维护一个独立的服务端进程。连接太多时,进程、内存和上下文切换本身就会成为负担。
text
没有连接池:
App(500 个连接) ─> PostgreSQL(500 个服务端进程) → 内存和调度压力很大

有连接池:
App(500 个客户端连接) -> PgBouncer(复用 50 个数据库连接) ─> PostgreSQL(50 个服务端进程) → 更稳定
连接池并没有让 500 个客户端凭空消失,而是让它们复用更少的 PostgreSQL 连接。像 PgBouncer 这样的工具负责把暂时空闲的连接借给下一个请求,数据库就不用为每个应用连接都长期保留一个进程。
总结
如果只用一句话理解高可用与扩展,那就是:复制是在给数据库准备副本和读能力,分区是在管理超大的表,连接池是在控制连接带来的资源消耗。
它们并不是同一种方案,也不能互相替代。主库挂了,靠备库接班;读压力大,靠读写分离分流;表太大,靠分区减少无效扫描;连接太多,靠连接池复用。把问题拆开,才能知道该用哪一种工具。