本文摘要 :普通
CREATE INDEX阻塞写入,业务请求在构建期成排等待。改用CONCURRENTLY后写入不被挡,却换成三类等待。旧快照持有者最难查,失败会留无效索引,仅适合无长事务的表。
一、问题与结论
CI 迁移在 200 万行的 t_idx_lab 上执行 CREATE INDEX idx_lab_pad ON t_idx_lab(pad);:ShareLock 与 INSERT/UPDATE/DELETE 的 RowExclusiveLock 冲突,写事务成排等待,连接池打满后上游超时重试,队列越积越长。换成 CREATE INDEX CONCURRENTLY 后写入不再排队,构建却停住不动,最终被 statement_timeout 取消,pg_index 里留下 indisvalid=false 的残骸索引。
结论:问题不在索引定义,而在建法与当时的事务环境。CONCURRENTLY 把挡写换成三类等待,其中旧快照等待的持有者往往只是一个 idle in transaction 会话。残骸索引更棘手:indisvalid=false 让查询不使用它,indisready=true 时写入仍在维护它,"查询依旧慢"和"写入继续变慢"同时出现。
二、排查与选择依据
先分清是被锁挡,还是在等事务:
pg_locks联pg_stat_activity:有无granted=false的关系锁、wait_event_type='Lock'。pg_stat_progress_create_index:卡在哪个phase(取值随大版本变化,先\d核对)。pg_stat_activity中backend_xmin非空且xact_start很旧的会话:旧快照持有者,query常为空。pg_index的indisvalid/indisready:有无残骸索引、写入是否仍在维护它。pg_stat_user_tables的n_dead_tup与last_autovacuum:构建期autovacuum是否被长期挡在外面。
sql
SELECT pid, state, xact_start, backend_xid, backend_xmin,
       left(coalesce(query, '<NULL>'), 48) AS q
FROM pg_stat_activity
WHERE datname = current_database() AND backend_xmin IS NOT NULL
ORDER BY xact_start;

SELECT c.relname, i.indisready, i.indisvalid, pg_relation_size(i.indexrelid) AS bytes
FROM pg_index i JOIN pg_class c ON c.oid = i.indexrelid
WHERE i.indrelid = 't_idx_lab'::regclass;
替代方案与取舍
| 方案 | 选择条件 | 代价 | 边界 |
|---|---|---|---|
普通 CREATE INDEX |
有维护窗口、表可控 | 全程挡写 | 窗口短于构建时长即不可用 |
CREATE INDEX CONCURRENTLY |
无窗口、可容忍分钟级构建 | 两次全表扫描、WAL 翻倍、挡 vacuum/DDL、失败留残骸 | 不能在事务块内执行 |
REINDEX CONCURRENTLY |
已有索引需重建 | 全程不挡写 | 较新大版本才有;系统目录、排他约束索引不可用 |
逐分区构建 + ATTACH PARTITION |
分区表 | 单分区影响 | 分区多时运维复杂,父索引状态需手工对齐 |
写入密集、maintenance_work_mem 不足导致溢写临时文件、或目标表有未收尾长事务时,先清理事务、补足内存、规划低峰窗口,再决定是否用 CONCURRENTLY。
三、关键原理
| 建法 | 持有锁 | 与 RowExclusiveLock |
写入 |
|---|---|---|---|
普通 CREATE INDEX |
ShareLock |
冲突 | 排队 |
CREATE INDEX CONCURRENTLY |
ShareUpdateExclusiveLock |
不冲突 | 照常 |
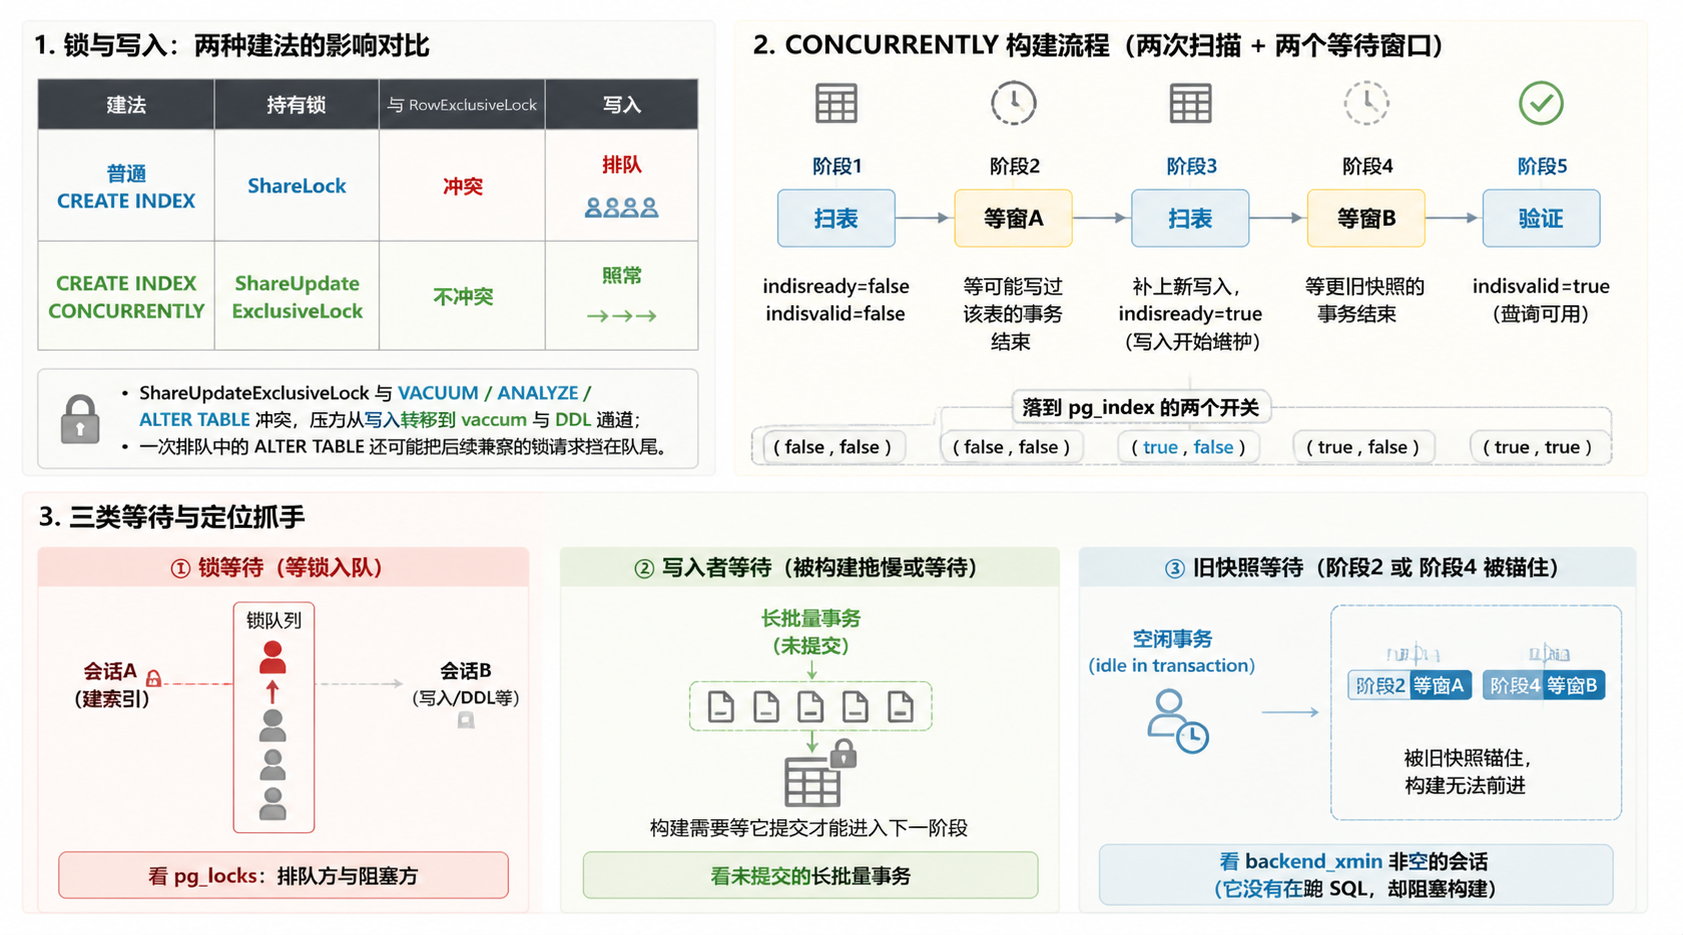
ShareUpdateExclusiveLock 与 VACUUM/ANALYZE/ALTER TABLE 冲突,压力从写入转移到 vacuum 与 DDL 通道;一次排队中的 ALTER TABLE 还可能把后续兼容的锁请求挡在队尾。
构建是两次全表扫描加两个等待窗口,落到 pg_index 的两个开关上:
text
阶段1 扫表       → indisready=false / indisvalid=false
阶段2 等待窗口A  → 等可能写过该表的事务结束
阶段3 扫表       → 补上新写入,indisready=true(写入开始维护)
阶段4 等待窗口B  → 等更旧快照的事务结束
阶段5 验证       → indisvalid=true(查询可用)
三类等待的抓手不同:① 锁等待看 pg_locks 排队方;② 写入者等待看未提交的长批量事务;③ 旧快照等待看 backend_xmin 非空的 idle in transaction 会话,它没有在跑 SQL,却把构建锚在阶段 2 或阶段 4。
四、可运行示例
环境:目标大版本的空闲实例,PGURL 指向目标库。pg_stat_progress_create_index 是较新大版本才有的视图,旧版本改用 pg_locks 与 pg_stat_activity,列名以 \d 为准。
bash
#!/usr/bin/env bash
# PGURL=postgres://u:p@host:5432/db ./lab.sh setup|demo_wait|demo_invalid|cleanup
set -euo pipefail
: "${PGURL:?need PGURL}"

setup() {
psql "$PGURL" -v ON_ERROR_STOP=1 <<'SQL'
DROP TABLE IF EXISTS t_idx_lab CASCADE;
CREATE TABLE t_idx_lab (id bigint, h text, pad int);
INSERT INTO t_idx_lab
SELECT x, md5(x::text), x % 97 FROM generate_series(1, 2000000) x;
ALTER TABLE t_idx_lab ADD PRIMARY KEY (id);
ANALYZE t_idx_lab;
SQL
}

# 终端A:BEGIN; SELECT count(*) FROM t_idx_lab;  (不要 COMMIT)
# 终端B:CREATE INDEX CONCURRENTLY idx_lab_pad ON t_idx_lab(pad);
demo_wait() {
  psql "$PGURL" -P pager=off -c "
   SELECT pid, phase, blocks_done, blocks_total
   FROM pg_stat_progress_create_index
   WHERE relid = 't_idx_lab'::regclass;"
  psql "$PGURL" -P pager=off -c "
   SELECT pid, state, xact_start, backend_xmin
   FROM pg_stat_activity
   WHERE datname = current_database() AND backend_xmin IS NOT NULL
   ORDER BY xact_start;"
}

demo_invalid() {
psql "$PGURL" -v ON_ERROR_STOP=0 <<'SQL'
INSERT INTO t_idx_lab(id, h, pad)
SELECT 3000000 + id, h, 0 FROM t_idx_lab WHERE id <= 100;
CREATE UNIQUE INDEX CONCURRENTLY idx_lab_h ON t_idx_lab(h);
SELECT c.relname, i.indisready, i.indisvalid
FROM pg_index i JOIN pg_class c ON c.oid = i.indexrelid
WHERE i.indrelid = 't_idx_lab'::regclass AND NOT i.indisvalid;
SQL
}

cleanup() {
  psql "$PGURL" -v ON_ERROR_STOP=0 <<'SQL'
DROP INDEX IF EXISTS idx_lab_h;
DROP TABLE IF EXISTS t_idx_lab CASCADE;
SQL
}

case "${1:-}" in
  setup) setup ;;
  demo_wait) demo_wait ;;
  demo_invalid) demo_invalid ;;
  cleanup) cleanup ;;
  *) echo "用法: $0 setup|demo_wait|demo_invalid|cleanup" ;;
esac
预期输出 :demo_wait 的第一条查询应停在等待类 phase(字符串随版本变化),第二条列出终端 A 的 pid、远早于当前的 xact_start 与非空的 backend_xmin;demo_invalid 输出一行 idx_lab_h,indisvalid 为 f,indisready 是否为 t 取决于失败发生的阶段。
实际输出 :在终端 A 执行 ROLLBACK 前后各跑一次 demo_wait,比较 phase 是否推进;用 EXPLAIN SELECT * FROM t_idx_lab WHERE h = 'abc'; 确认计划仍是 Seq Scan,说明 indisvalid=false 的索引不参与查询。耗时、行数与 phase 具体取值以目标环境实测和版本文档为准。
常见失败:唯一索引撞重复键,报 could not create unique index,留下 indisvalid=false 索引,indisready=true 时写入仍维护它。修复:DROP INDEX idx_lab_h;(需 ACCESS EXCLUSIVE,会短暂挡写)后重新 CREATE INDEX CONCURRENTLY;版本支持且索引类型允许时用 REINDEX CONCURRENTLY 原子替换,注意它不适用于系统目录与排他约束索引。
五、成本与边界
采用 CONCURRENTLY 的成本:两次全表扫描慢于普通建法,WAL 量翻倍;构建期 autovacuum 进不去,长构建等于长期不 vacuum;必须接入进度视图,否则卡住不可诊断;迁移工具要支持非事务迁移(Flyway 关闭迁移事务、Alembic 用 autocommit_block()、Django 设 atomic = False、Rails 用 disable_ddl_transaction!);失败后要有人负责清残骸。
超时参数是双刃剑:statement_timeout 会取消构建并留下无效索引,lock_timeout 只管锁获取阶段,idle_in_transaction_session_timeout 能兜住第三类等待但会误伤合法长事务,上线前需与业务对齐。200 万行这个量级,普通 CREATE INDEX 的挡写通常是秒级到几十秒(请在目标环境实测),真正要防的是构建期被挡住的 vacuum 与随后的残骸索引。phase 取值、错误文案、参数默认值请回到部署大版本的官方文档逐条核对,文档 URL 中的版本段也请替换为你的大版本。
思考
- 上线前主动扫描并结束
idle in transaction会话,还是只靠idle_in_transaction_session_timeout兜底? - 失败残留的 invalid 索引先
DROP再重建,还是用REINDEX CONCURRENTLY原子替换?