一个真实工况:某团队把 20TB 备份和日志丢进一家 S3 兼容云,月底账单是当初按"存储单价 × 容量"算出来的 3 倍。复盘下来,多出来的钱几乎都不在存储单价里------出网流量、请求次数、一条忘了配的生命周期规则,每一项单独看都不大,叠起来就失控了。IDrive 刚发的 2026 性能报告把各家吞吐比得明明白白,可没哪家把"你实际要付多少"讲清楚。这篇把那些不在计算器里的钱,一项项算给你看。
坑一:出网流量(Egress)才是账单大头
存储单价通常每 GB 每月几分钱,看着便宜。但数据要被读出来、被下载、被别的区域拉走,每一次出网都按 GB 计费。对读多写少、或对外部用户分发内容的业务,egress 经常超过存储费本身。
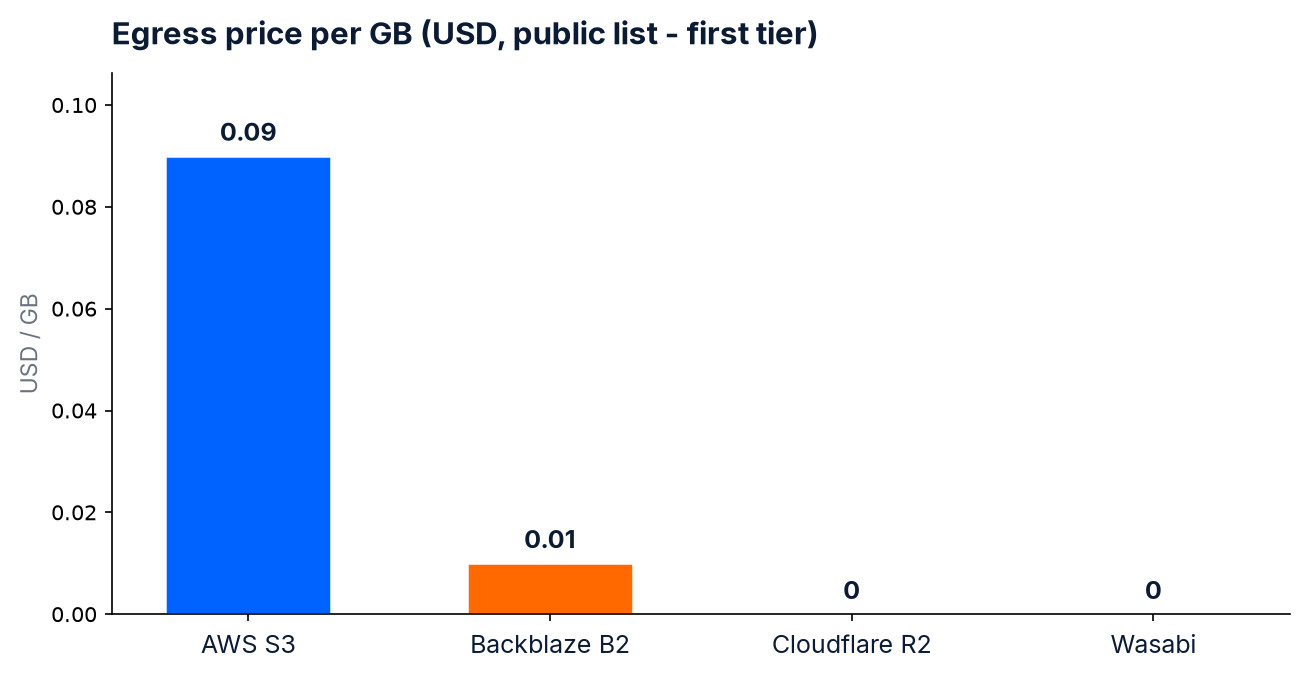
公开标价(首档、us-east-1,仅示意):AWS S3 约 0.09/GB,Backblaze B2 约 0.01/GB(在 3 倍存储额度内),Cloudflare R2 和 Wasabi 标 0 出网费------但 Wasabi 有"1:1 规则"(月出网量不超过当月存储量),B2 有"3 倍带宽联盟"额度,超出部分照收。别只盯那行 0。
粗估一下月 egress 成本:
bash
# 假设 20TB 数据,月均被读 2 次 → 40TB 出网
# AWS S3 : 40,000 GB × $0.09 ≈ $3,600
# B2     : 40,000 GB × $0.01 ≈ $400(额度内)
# R2/Wasabi: $0(额度内)
差距几十倍。第一步永远是先把自己真实的出网量量出来,而不是盯存储单价。
坑二:请求 / 操作费,在小文件场景会爆
PUT、GET、LIST、DELETE 不是免费的,按每千次计费。大对象场景请求数少,无所谓;但如果你拿对象存储当小文件库------每一条日志、每一张缩略图都是一个对象------请求数能轻松冲到上亿,费用比存储费还高。
先量再优化:
bash
# 对象总数
rclone lsjson --recursive s3:bucket-name | wc -l
# 总字节数(注意:list-objects 对海量对象很慢,大桶请用桶的访问日志统计)
aws s3api list-objects-v2 --bucket bucket-name \
  --query 'sum(Contents[].Size)' --output json
两个动作立竿见影:把海量小文件打包成更大的对象(比如按小时聚合日志),以及用 CDN 或本地缓存挡掉重复 GET。少一次请求就是真金白银。
坑三:孤儿 multipart 分片,在偷偷计费
大文件上传走 multipart,失败或中断的分片不会自动消失。它们占着存储、持续计费,你甚至不知道它们存在。很多团队月月为"看不见的数据"买单。
用一条生命周期规则把这些未完成的分片在 7 天后清理掉(几乎所有 S3 兼容实现都支持,但默认不开):
xml
<LifecycleConfiguration>
  <Rule>
    <ID>abort-incomplete-mpu</ID>
    <Status>Enabled</Status>
    <Filter></Filter>
    <AbortIncompleteMultipartUpload>
      <DaysAfterInitiation>7</DaysAfterInitiation>
    </AbortIncompleteMultipartUpload>
  </Rule>
</LifecycleConfiguration>
bash
aws s3api put-bucket-lifecycle-configuration \
  --bucket bucket-name --lifecycle-configuration file://lifecycle.json
不开这条规则,就是持续的隐性支出。
坑四:版本控制和跨区复制,会"翻倍"你的存储
开了版本控制(Versioning)很安全,但每次覆盖写都留一个旧版本,半年后存储量可能是你以为的两倍。更狠的是跨区复制(Replication):开启后存储直接翻倍,出网还要再付一次。
我的做法:版本控制只开在真正需要防误删的桶,并配一条"30 天后过期旧版本"的规则;跨区复制除非有合规或容灾硬性要求,否则别默认开。
坑五:最低存储时长,提前删也照样收
某些 tier 有最短计费周期------比如 Wasabi 的 90 天最低存储时长,提前删除仍按 90 天收费。还有"最小计费对象"(小对象按某个下限字节计费)。把短期、会频繁删除的数据丢进这种桶,等于白交钱。
热数据才放按量计费的标准层,冷数据直接走归档层(或生命周期自动降级),别让短期数据踩进最低时长陷阱。
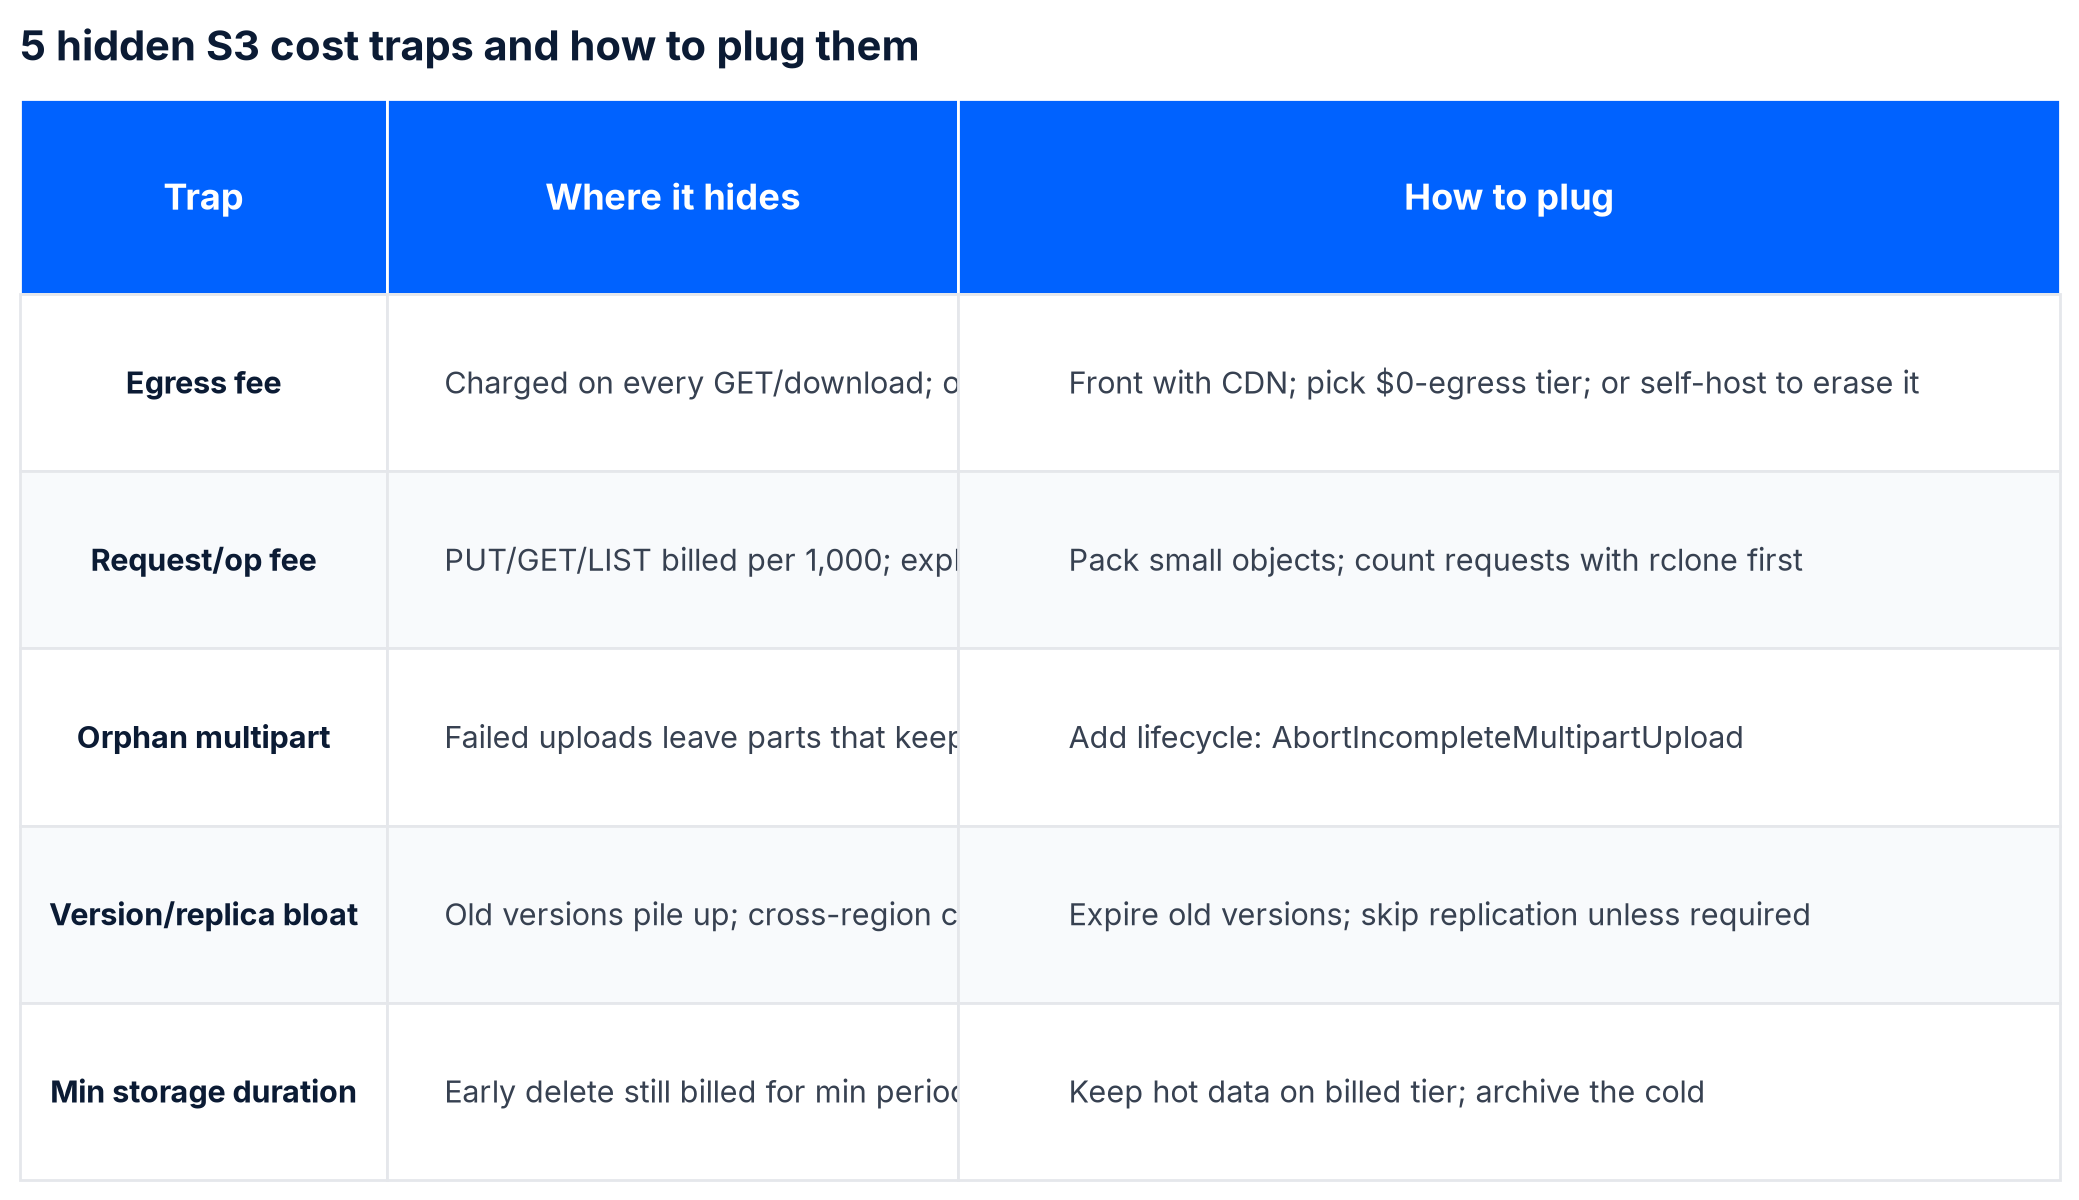
一张表,把 5 个坑收口
收尾:先审计,再决定去哪
别急着换厂商。先做一次成本审计,按这个顺序:
- 拉最近一个月的明细账单,拆成 存储费 / 请求费 / 出网费 三块,看谁最大;
- 用上面的 rclone / list-objects 命令量出对象总数和请求规模;
- 给所有桶补上
AbortIncompleteMultipartUpload和过期旧版本的生命周期; - 把读多写少的内容前置 CDN,压掉重复出网;
- 重算一遍,再决定是调配置还是换方案。
如果你受够了按出网和请求逐项计费、想要成本可预测,自建一套 S3 兼容存储值得认真考虑------把 egress 和请求费从账面彻底抹掉,成本退化成一次性的机器加电费。
RustFS 这类 Apache 2.0 的 S3 兼容方案,部署模型和 MinIO 几乎一致,GitHub 上可以直接拉起来,先在小流量上验证。