文章目录
-
- 一、前言
- 二、概念对齐:为什么"回灌"能让模型记住
-
- [2.1 回顾:模型为什么失忆](#2.1 回顾:模型为什么失忆)
- [2.2 回灌历史:从"一句话"到"完整历史"](#2.2 回灌历史:从"一句话"到"完整历史")
- [2.3 一张表看清三期演进](#2.3 一张表看清三期演进)
- [2.4 本期的"组装公式"](#2.4 本期的"组装公式")
- 三、动手做:从金鱼记忆到短期记忆
-
- [3.1 维护一个 messages 列表](#3.1 维护一个 messages 列表)
- [3.2 上下文长度限制:历史不能无限长](#3.2 上下文长度限制:历史不能无限长)
- [3.3 reset 和 history 命令](#3.3 reset 和 history 命令)
- [3.4 自动演示:对比第 02 期的"金鱼记忆"](#3.4 自动演示:对比第 02 期的"金鱼记忆")
- 四、跑起来:短期记忆的实际体验
-
- [4.1 为什么回灌历史能让模型"记住"?](#4.1 为什么回灌历史能让模型"记住"?)
- [4.2 token 增长可视化](#4.2 token 增长可视化)
- [4.3 调用流程(与前两期一致)](#4.3 调用流程(与前两期一致))
- 五、执行脚本
- 六、总结
一、前言
第 02 期你跑通了循环对话,但模型有"金鱼记忆"------你上一句说"我叫张三",下一句问"我姓什么",它答不上来。明明刚说过,转头就忘。
根本原因:每次调用 messages 里只传当前这一句,模型看不到历史。这不是模型笨,是你没把历史喂给它。
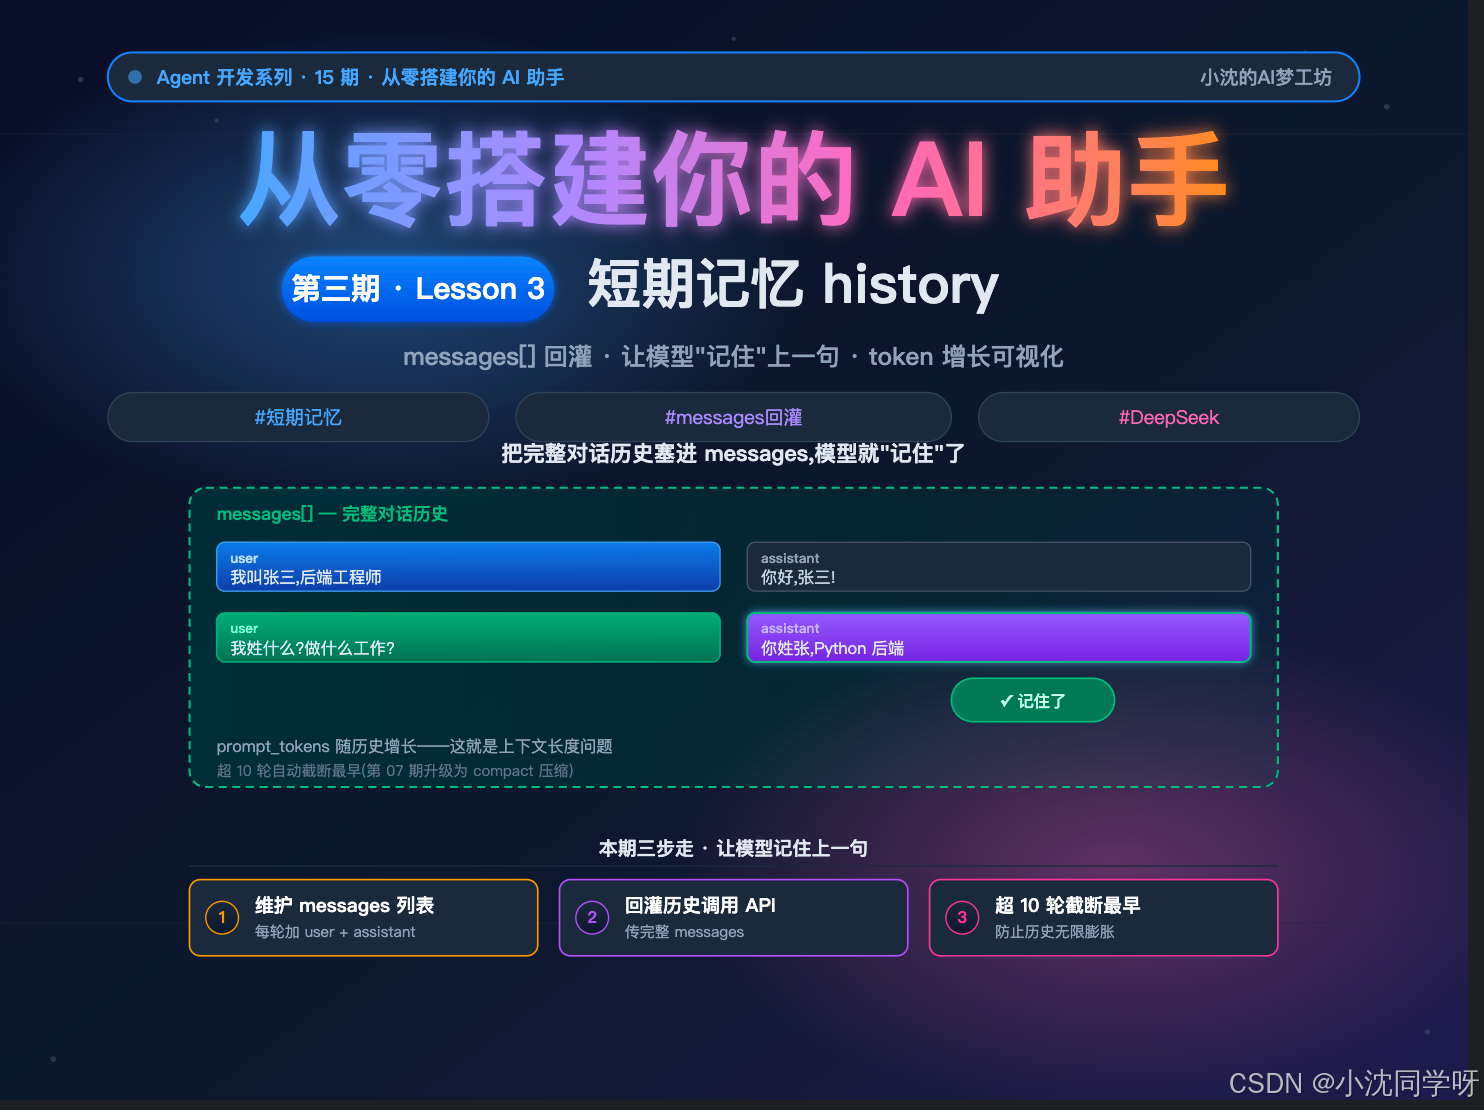
这一期我们就动手维护一份 messages 列表,每次调用把完整对话历史回灌进去,让模型真正"记住"上一句。同时引入上下文长度限制------历史不能无限长,这是个新问题。看完你就能:
- 用 messages 列表维护完整对话历史
- 理解"回灌历史"为什么能让模型"记住"
- 用 token 计数直观看到上下文在增长
- 加一个最简单的上下文长度限制,防止历史无限膨胀
本文是 Agent 教学系列第 03 期的实战笔记,干货为主,偶尔自嘲,各位看官将就着看。
二、概念对齐:为什么"回灌"能让模型记住
2.1 回顾:模型为什么失忆
上一期讲过,模型 API 是无状态的------每次请求都被当成全新对话,服务器不保存任何上下文。所以"连续对话"的幻觉,是客户端伪造出来的:你自己维护一份历史,每次请求把整段历史一起发过去。
但第 02 期我们故意没这么做------messages 里永远只有当前这一句,专门让你踩一脚"金鱼记忆"。这一期补上。
2.2 回灌历史:从"一句话"到"完整历史"
核心改动就一处:把 chat() 的入参从"一句话"变成"完整 messages 列表"。
python
def chat(messages: list[dict]) -> tuple[str, int, int]:
    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,  # ← 完整历史,不再只传当前一句
        max_tokens=1000,
    )
    ...
每次对话的流程:
- 用户输入 →
{"role": "user", "content": 输入}加入 messages - 调用 API,把完整 messages 发过去
- 模型回复 →
{"role": "assistant", "content": 回复}也加入 messages - 下一次调用,messages 里已经带着之前的全部问答
这样模型每次都能"看到"完整上下文,"金鱼记忆"问题解决。
2.3 一张表看清三期演进
| 第 01 期 | 第 02 期 | 第 03 期 | |
|---|---|---|---|
| 调用方式 | 单次一问一答 | while 循环 | while 循环 + 历史回灌 |
| messages 数组 | 只传当前一句 | 只传当前一句 | 完整对话历史 |
| 记忆能力 | 无 | 无(故意暴露痛点) | 有(短临记忆) |
| token 观察 | 无 | 每次 prompt 都很小 | prompt 随历史增长 |
2.4 本期的"组装公式"
短期记忆 = messages[] 回灌 + 上下文长度限制把历史塞进去,模型就"记住"了;但历史不能无限长,得加个上限。
三、动手做:从金鱼记忆到短期记忆
3.1 维护一个 messages 列表
用一个 list 在内存里维护对话历史,角色严格按 user / assistant 交替:
python
messages: list[dict] = []

# 用户输入
messages.append({"role": "user", "content": user_input})

# 调用 API(传完整历史)
answer, p, c = chat(messages)

# 模型回复也加回历史
messages.append({"role": "assistant", "content": answer})
这样下一次调用时,messages 里已经带着之前的全部问答,模型能"看到"上下文。
3.2 上下文长度限制:历史不能无限长
历史一直累积,prompt_tokens 会越滚越大,最终触发模型的上下文长度上限(DeepSeek 通常 64K token)。
本期用最简单的截断策略:
python
MAX_ROUNDS = 10  # 1 轮 = 1 user + 1 assistant

def trim_history(messages: list[dict]) -> list[dict]:
    rounds = sum(1 for m in messages if m["role"] == "user")
    if rounds <= MAX_ROUNDS:
        return messages
    excess_rounds = rounds - MAX_ROUNDS
    cut = excess_rounds * 2  # 每轮 2 条
    return messages[cut:]
超过 10 轮时,删掉最早的一轮,保留最近 10 轮。简单粗暴,但有边界。
第 07 期会升级为 compact 压缩策略(把旧对话摘要成一段,而非直接删),本期先解决"有没有"的问题。
3.3 reset 和 history 命令
reset:清空 messages 列表,重新开始(第 02 期埋的伏笔,这期兑现)history:打印当前 messages 列表,直观看到[user, assistant, user, assistant, ...]的结构
这两个命令不是花架子,是帮你调试和理解"历史是怎么组织的"。
3.4 自动演示:对比第 02 期的"金鱼记忆"
程序跑起来会先自动问两个问题(和第 02 期一模一样):
- "我叫张三,是一名 Python 后端工程师" ------ 告诉模型信息
- "我姓什么?我是做什么工作的?" ------ 看它能否接住
这次模型应该能答上来------因为 messages 里带着上一轮的问答。同时你会看到第 2 轮的 prompt_tokens 比第 2 期大,因为历史一起发了过去。
四、跑起来:短期记忆的实际体验
4.1 为什么回灌历史能让模型"记住"?
模型本身是无状态的,但每次调用都会读到你传入的完整 messages。只要历史在 messages 里,模型就能"看到"之前说过什么。
第 1 轮:
  messages = [user: "我叫张三"]
  → 模型回复 "你好,张三!"
  messages = [user: "我叫张三", assistant: "你好,张三!"]

第 2 轮:
  messages = [user: "我叫张三", assistant: "你好,张三!", user: "我姓什么?"]
  → 模型能看到前两条,答 "你姓张"
4.2 token 增长可视化
对比第 02 期,本期的 prompt_tokens 会明显更大,因为历史一起发了过去:
| 轮次 | 第 02 期 prompt_tokens | 第 03 期 prompt_tokens |
|---|---|---|
| 第 1 轮 | ~10(一句话) | ~10(一句话) |
| 第 2 轮 | ~10(还是一句话) | ~30(含第 1 轮的问答) |
| 第 5 轮 | ~10 | ~150(含前 4 轮) |
这就是上下文长度问题的由来------历史越多,token 越贵,也越容易触顶。
4.3 调用流程(与前两期一致)
你的代码 → openai SDK → HTTPS 请求(带完整 messages) → DeepSeek → 推理 → 返回 JSON + usage相比第 02 期,唯一的差异是:请求体里的 messages 从一句话变成了完整历史。
五、执行脚本
python
#!/usr/bin/env python3
"""step03_history.py --- 第 03 期:短期记忆 history

本期目标:
1. 维护一个 messages 列表,每次调用把完整对话历史回灌进去
2. 让模型真正"记住"上一句,解决第 02 期的"金鱼记忆"
3. 引入上下文长度限制,历史不能无限长------超限时做最简单的截断

累积式:step03 = step02 + messages[] 回灌 + 上下文长度限制
(尚未做记忆压缩/长期记忆,后续第 07 期解决)

运行:
    python code/step03_history.py
"""
import os
from dotenv import load_dotenv
from openai import OpenAI
from prompt_toolkit import prompt
from prompt_toolkit.history import InMemoryHistory

load_dotenv()

# ============ 1. 初始化客户端(与第 01/02 期一致)============
client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url=os.environ.get("DEEPSEEK_BASE_URL", "https://api.deepseek.com"),
)
MODEL = os.environ.get("DEEPSEEK_MODEL", "deepseek-chat")

# 上下文长度上限(轮数,1 轮 = 1 user + 1 assistant)
MAX_ROUNDS = 10


def chat(messages: list[dict]) -> tuple[str, int, int]:
    """带历史回灌的对话:传入完整 messages 列表,返回 (回答, prompt_tokens, completion_tokens)。"""
    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=1000,
    )
    answer = response.choices[0].message.content
    usage = response.usage
    return answer, usage.prompt_tokens, usage.completion_tokens


def trim_history(messages: list[dict]) -> list[dict]:
    """上下文长度限制:超过 MAX_ROUNDS 轮时,从最早的一轮开始截断。"""
    rounds = sum(1 for m in messages if m["role"] == "user")
    if rounds <= MAX_ROUNDS:
        return messages
    excess_rounds = rounds - MAX_ROUNDS
    cut = excess_rounds * 2
    return messages[cut:]


def main():
    print("=" * 60)
    print("第 03 期:短期记忆 history ------ 让模型记住上一句")
    print("=" * 60)
    print(f"当前模型: {MODEL}")
    print(f"API 地址: {client.base_url}")
    print(f"上下文上限: {MAX_ROUNDS} 轮(超出自动截断最早)")
    print("=" * 60)

    # ============ 2. 自动演示:对比第 02 期的"金鱼记忆" ============
    demo_questions = [
        "我叫张三,是一名 Python 后端工程师",
        "我姓什么?我是做什么工作的?",
    ]
    print("\n[自动演示] 同样两个问题,这次模型能否记住上一句:\n")

    messages: list[dict] = []
    for i, q in enumerate(demo_questions, 1):
        print(f"[问题 {i}] {q}")
        messages.append({"role": "user", "content": q})
        try:
            answer, p, c = chat(messages)
            print(f"[回答] {answer}")
            print(f"[token] prompt={p}  completion={c}  total={p + c}")
            print(f"[历史] 当前 messages 共 {len(messages)} 条")
            messages.append({"role": "assistant", "content": answer})
        except Exception as e:
            print(f"[出错] {e}")
            return
        print("-" * 60)

    print(
        "\n💡 对比第 02 期:这次模型答上来了------"
        "因为 messages 里带着上一轮的问答,模型"看到"了完整上下文。\n"
        "   但注意 prompt_tokens 比第 02 期大,因为历史一起发了过去。\n"
    )

    # ============ 3. 交互式对话(带历史回灌)============
    print("=" * 60)
    print("现在进入自由对话(有记忆,但超过 10 轮自动截断最早)")
    print("输入 quit 退出  /  输入 reset 清空历史  /  输入 history 查看历史")
    print("←/→ 移动光标,↑/↓ 翻历史,Ctrl-C 作废当前行重输")
    print("=" * 60)

    total_prompt = 0
    total_completion = 0
    cli_history = InMemoryHistory()

    while True:
        try:
            user_input = prompt("\n你: ", history=cli_history).strip()
        except (EOFError, KeyboardInterrupt):
            print("  (本行作废,重新输入)")
            continue
        if user_input.lower() in ("quit", "exit", "q"):
            print(f"\n[本次会话 token 汇总] prompt={total_prompt}  "
                  f"completion={total_completion}  total={total_prompt + total_completion}")
            print(f"[历史] 退出时共 {len(messages)} 条消息")
            print("再见!")
            break
        if user_input.lower() == "reset":
            messages.clear()
            total_prompt = 0
            total_completion = 0
            print("[提示] 历史已清空,重新开始对话。")
            continue
        if user_input.lower() == "history":
            print(f"[历史] 共 {len(messages)} 条消息:")
            for idx, m in enumerate(messages):
                role = m["role"]
                content = m["content"][:50] + ("..." if len(m["content"]) > 50 else "")
                print(f"  {idx:2d}. [{role:9s}] {content}")
            continue
        if not user_input:
            continue

        messages.append({"role": "user", "content": user_input})
        messages = trim_history(messages)
        try:
            answer, p, c = chat(messages)
            total_prompt += p
            total_completion += c
            messages.append({"role": "assistant", "content": answer})
            print(f"Alex: {answer}")
            print(f"[token] 本次 prompt={p}  completion={c}  "
                  f"累计 total={total_prompt + total_completion}")
            print(f"[历史] 当前 {len(messages)} 条消息"
                  f"({sum(1 for m in messages if m['role'] == 'user')} 轮)")
        except Exception as e:
            messages.pop()
            print(f"[出错] {e}")


if __name__ == "__main__":
    main()
六、总结
一句话回顾:模型本身无记忆,记忆是你用 messages 列表"喂"给它的。
三个关键动作记牢:
- 维护 messages 列表 → 每轮把 user + assistant 都加进去
- 回灌历史 → 调用时传完整 messages,模型就能"看到"上下文
- 上下文限制 → 历史不能无限长,超限时截断最早(下期升级为压缩)
一行代码记住本期:
python
messages.append({"role": "assistant", "content": answer}) # ← 回复也加回历史把模型回复也加入 messages,下一轮调用时它就"记住"了。
适用场景:这篇适合刚跑通第 02 期、想让模型真正"记住"对话的人。
下一期预告:第 04 期------System Prompt 人设。我们用 templates/SOUL.md 给 Agent 设定"技术助理 Alex"的角色,对比有无 system prompt 时的行为差异。同时 system prompt 会成为 messages 列表的第一条,进一步影响上下文。
感谢各位看官的一路陪伴,大家都再接再厉!