之前的传统指标
之前NLP的传统指标都是检测字面重叠的,比如BLEU,ROUGE,这些指标只能衡量字面重叠,无法衡量语义上的相似度。
针对RAG的评测
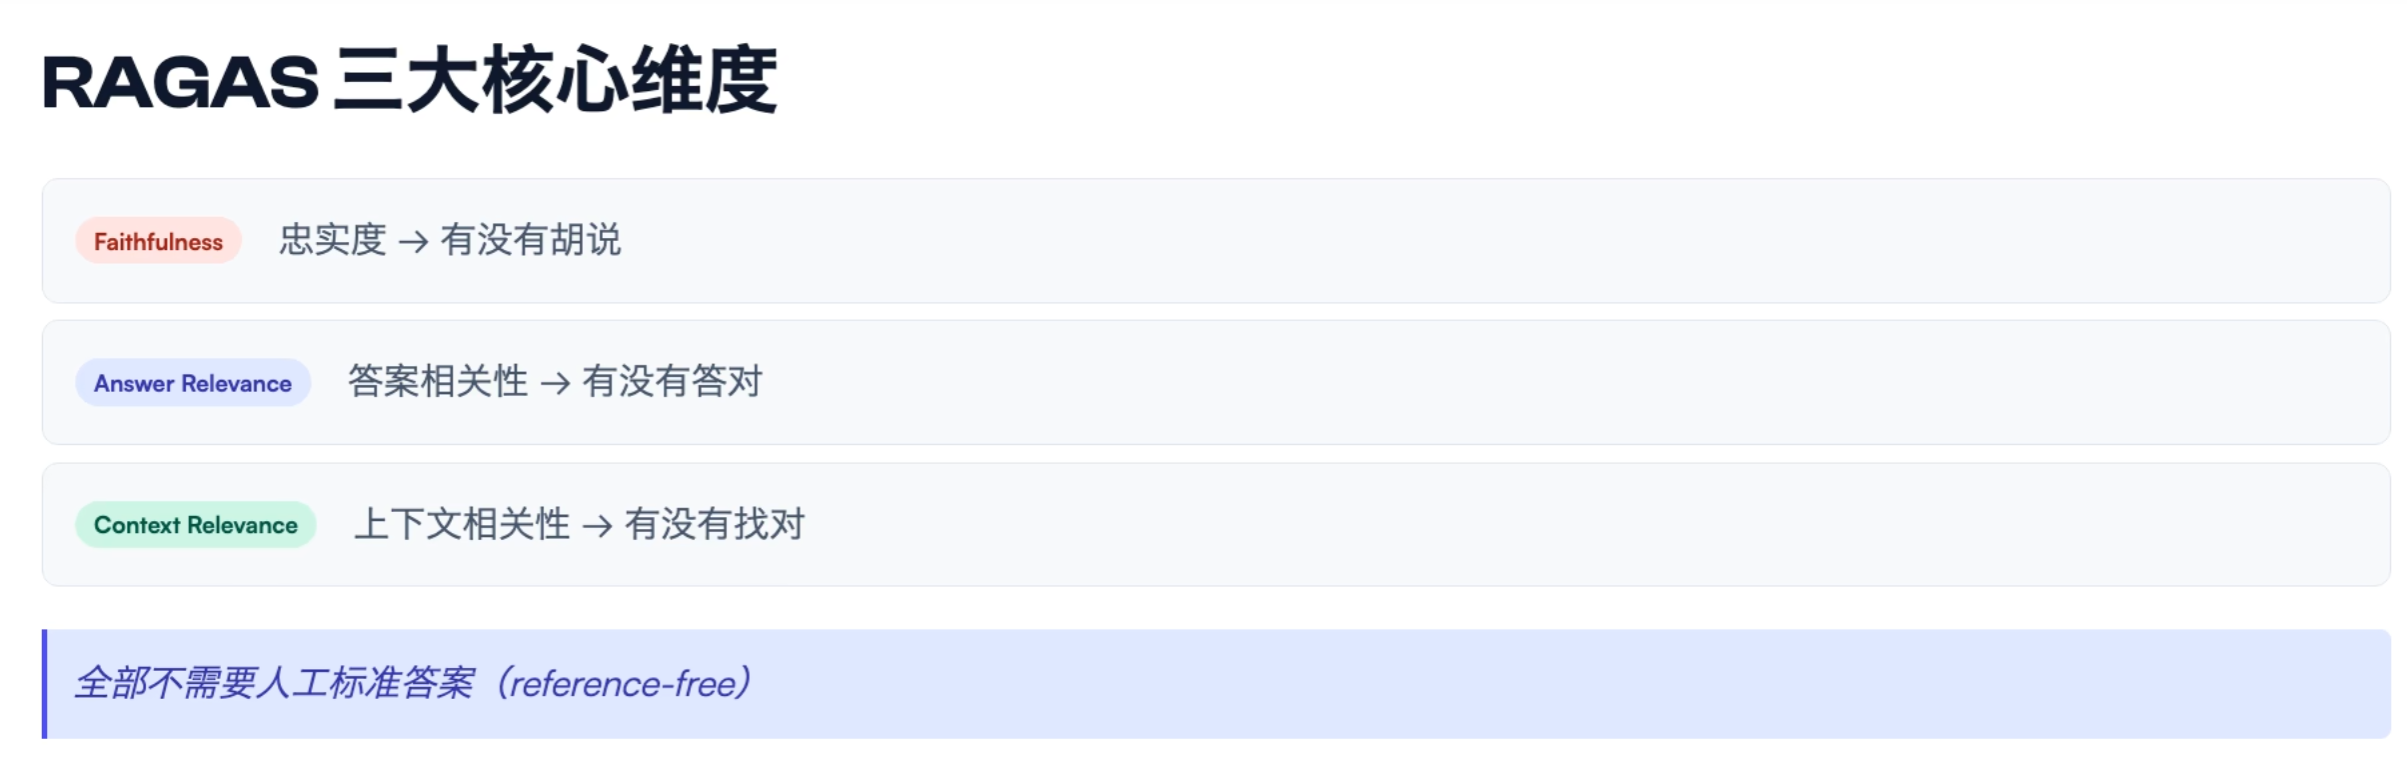
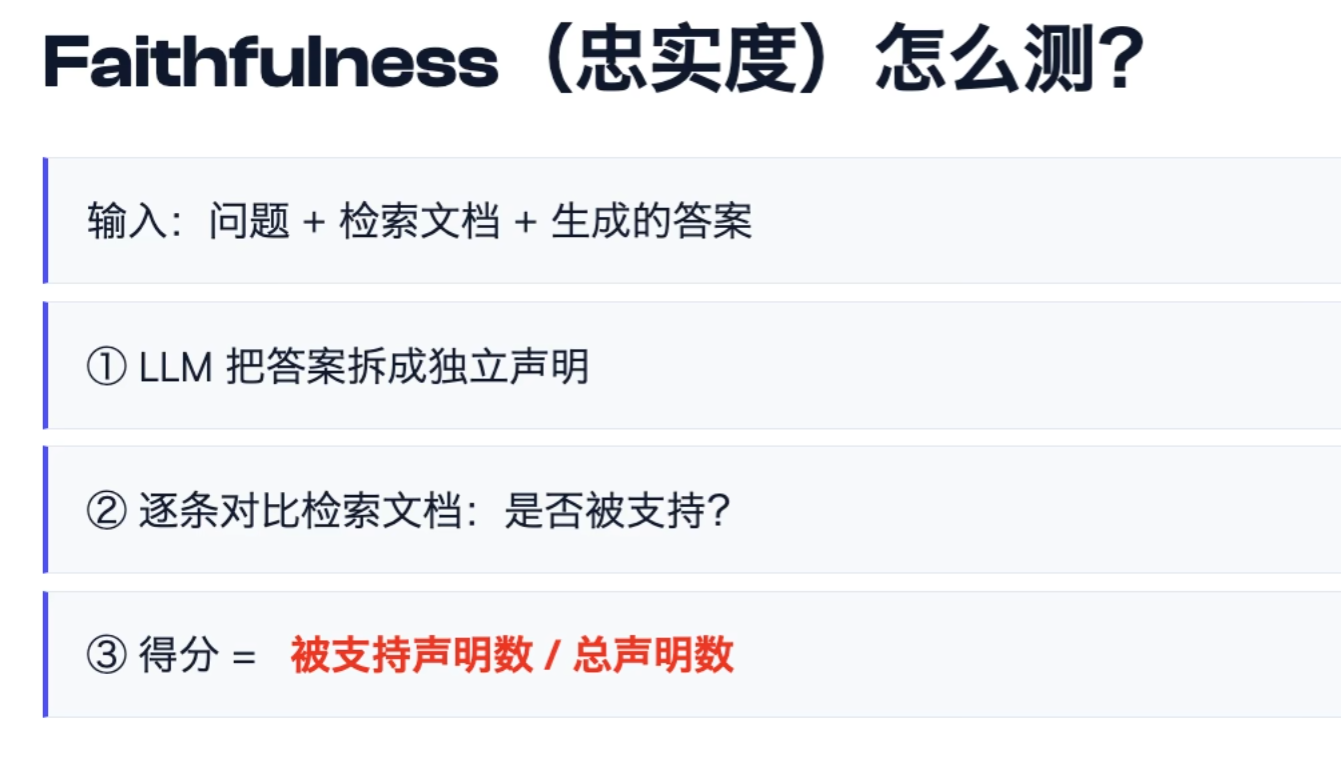
忠诚度是检查大语言模型有没有胡说,将输出的答案拆解成独立的声明,然后将每一条声明都去被检索到的文档中找,看能够被检索文档支持的声明占总共声明的多少条。
忠诚度这个指标只管答案是不是和检索到的文档相匹配,不管检索到的文档是不是对的。
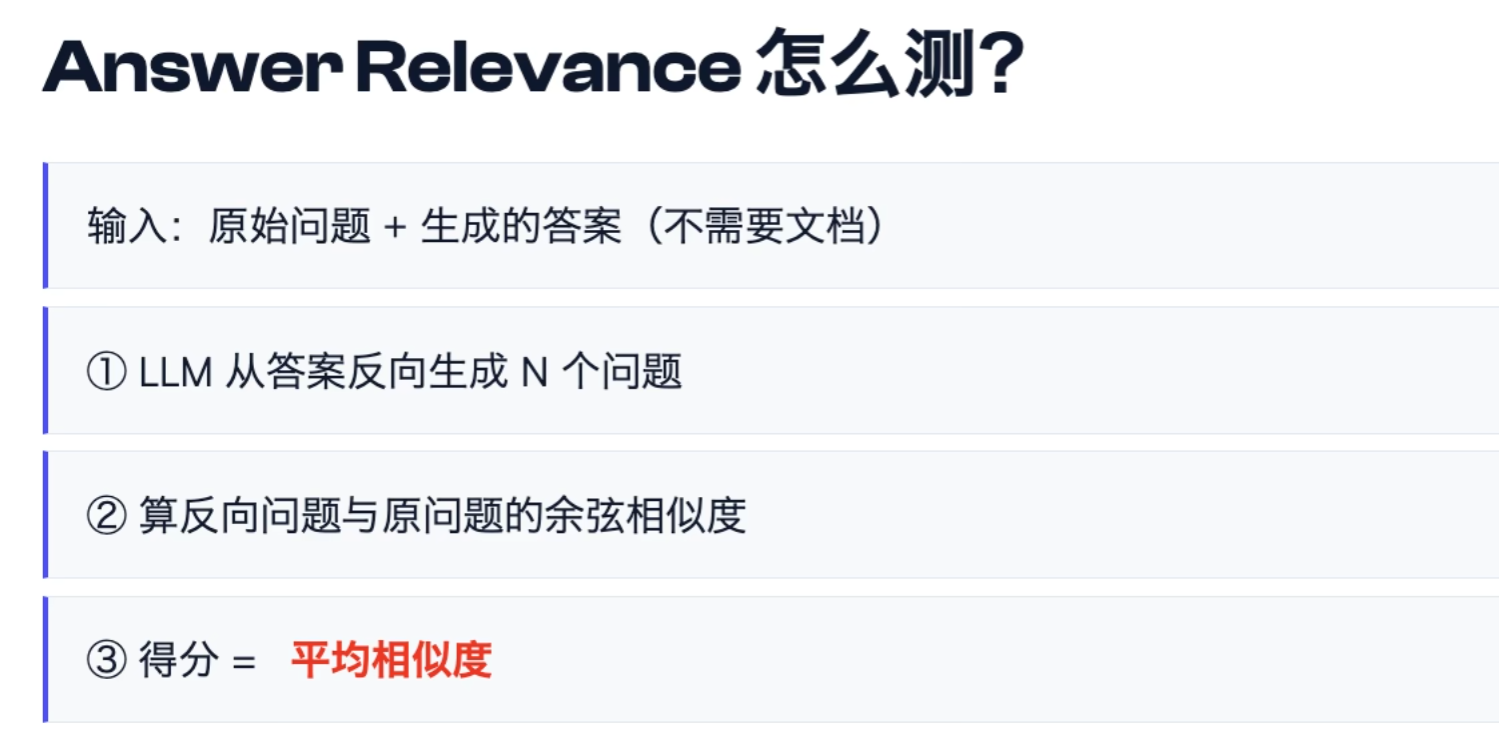
Answer Releance 是答案相关性,这个环节不需要参考答案,将输出的答案给大语言模型要求它反向生成问题,然后将这些反向问题去和原始答案做相似度匹配。
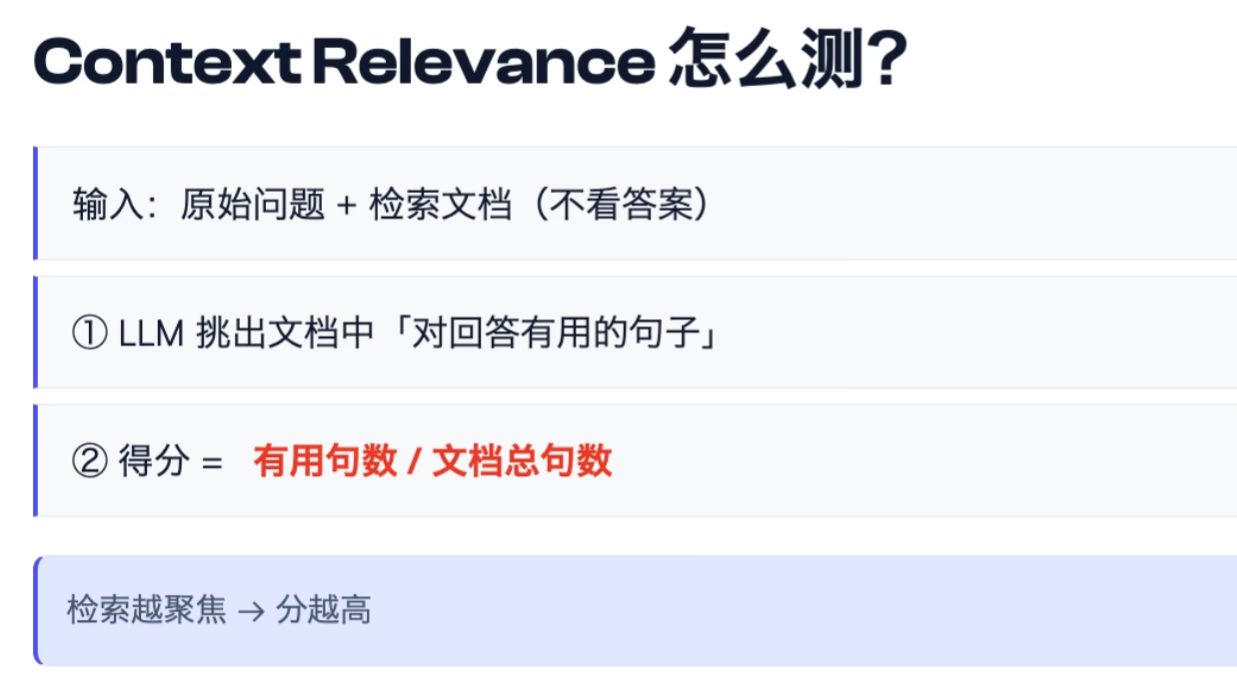 Context Relevance 需要问题和检索到的文档,然后让 LLM 挑出检索文档中对问题有用的句子,这个指标是衡量的检索的效率。
RAG 评测中存在的已知偏差
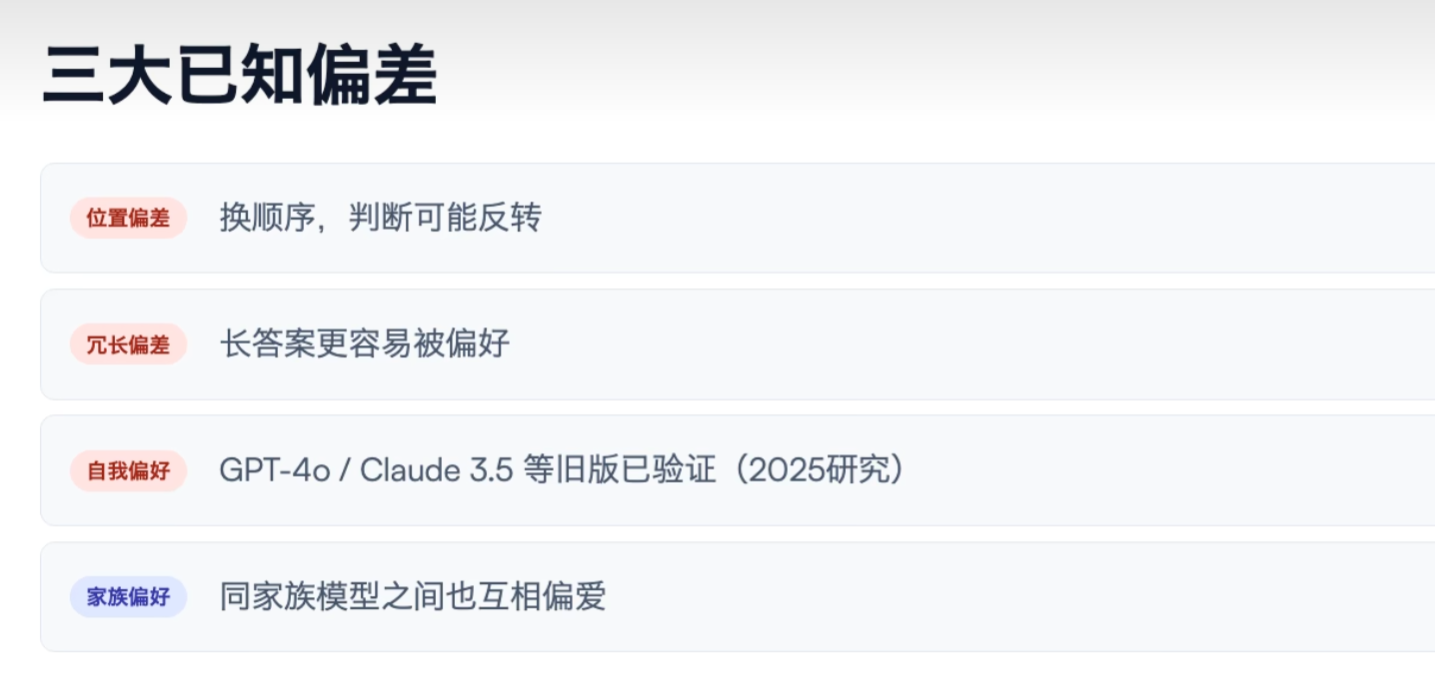
三大偏差是位置偏差,冗长偏差和自我偏好。
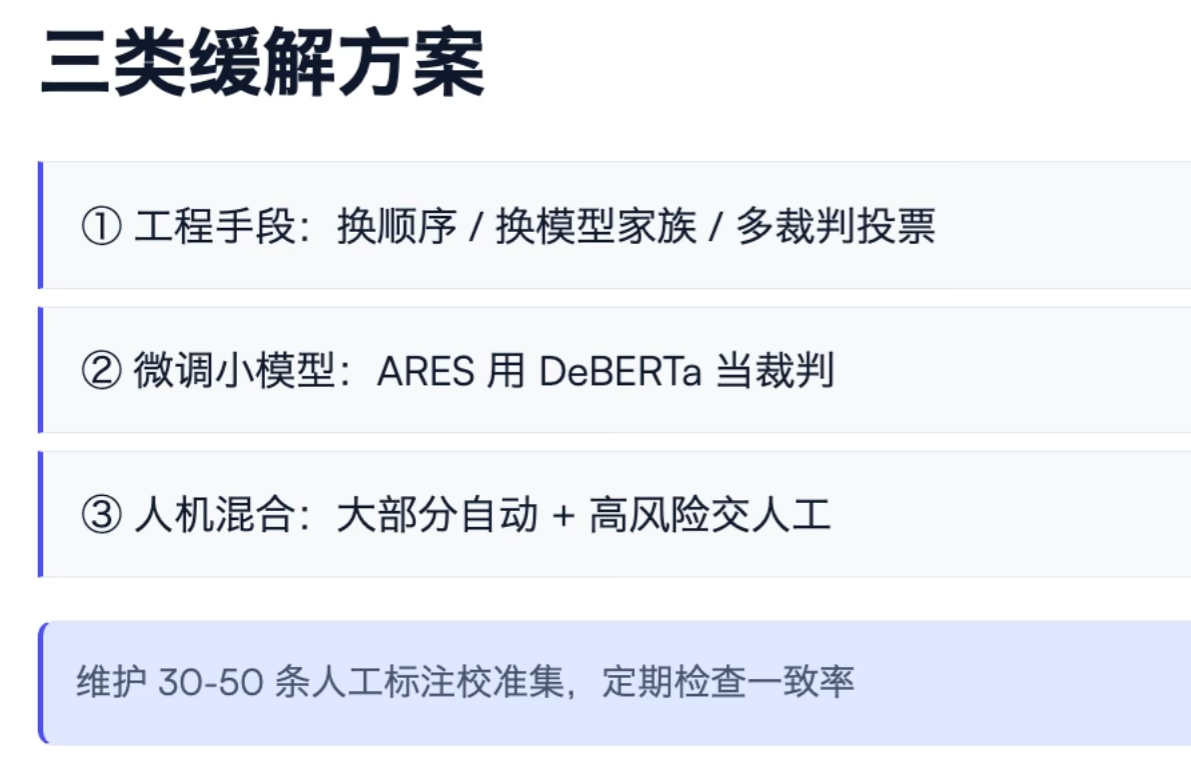
实际工程中的缓解方案
具体执行中应该如何评估
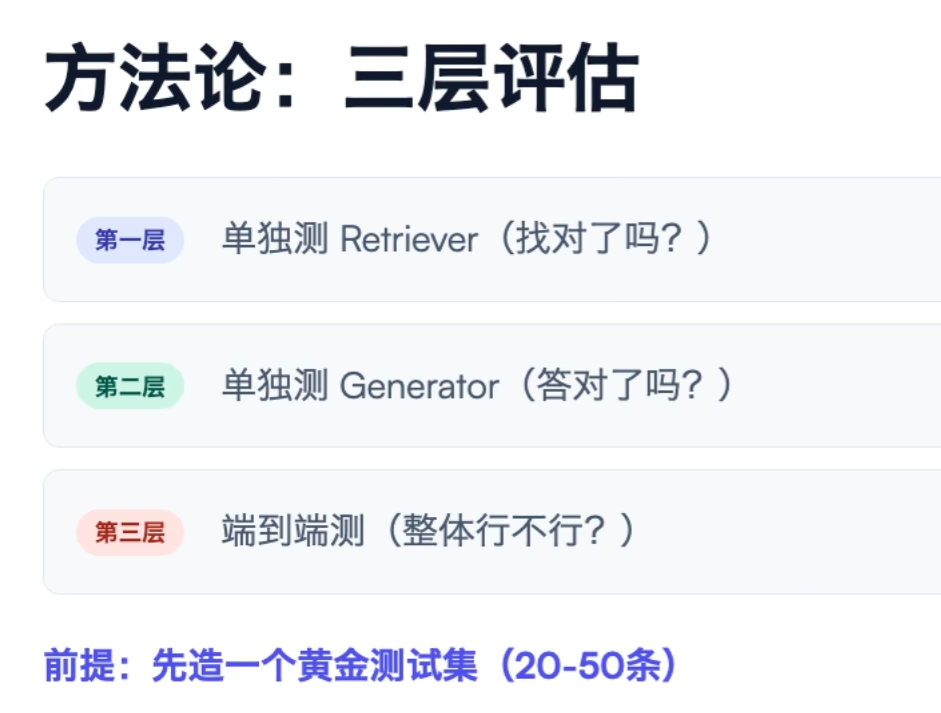
针对Retriever进行评估,要先人工做一个数据集。
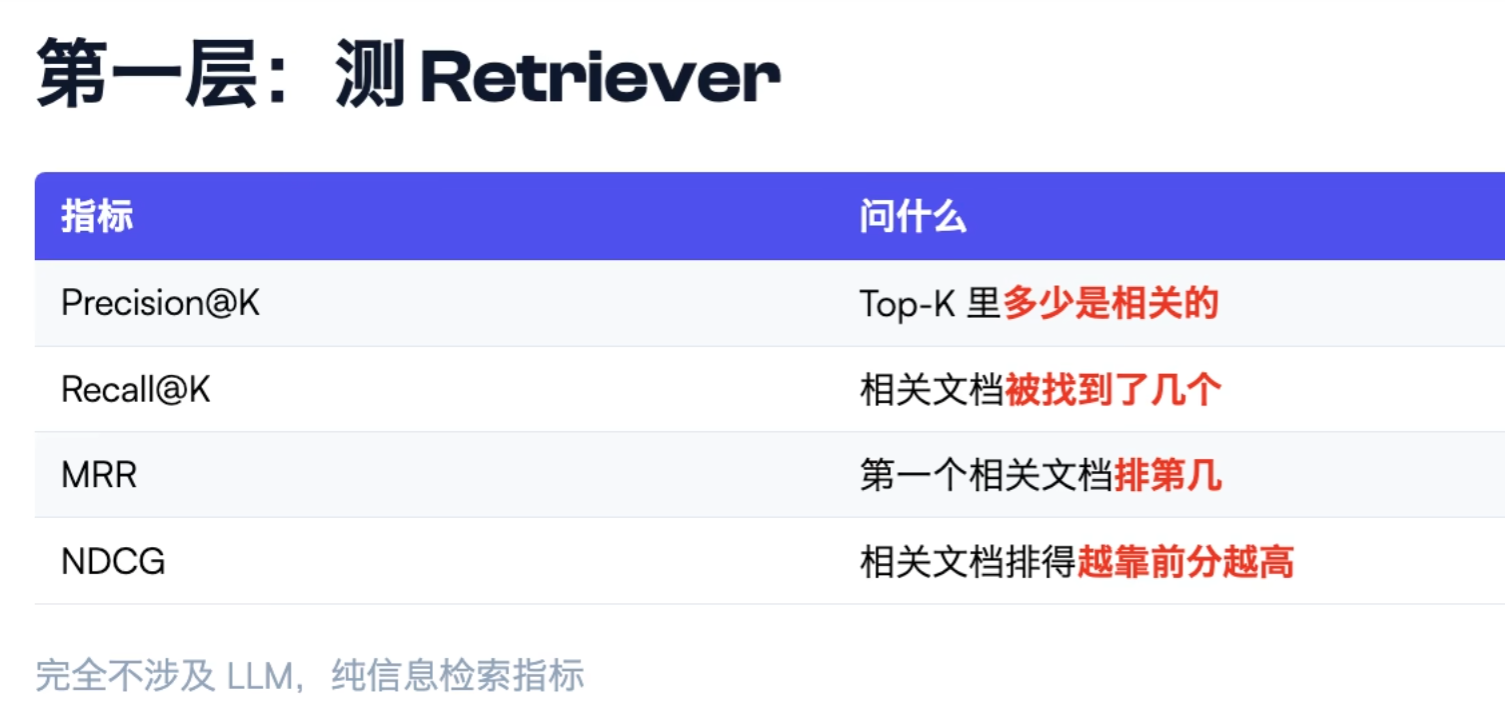 精确度就是在前k个指标中,比如说前 5 个指标,有多少个是和答案相关的。召回率是指在整个文档中和这个问题有关的有多少个,比如说20个,你能够将多少个检索出来。MRR 是衡量排序能力的,计算第一个相关文档排第几。举个例子比如现在找出了20个文档,第一个真正相关的文档可能排在第4. NDCG 则能够衡量整体的排序效果。它引入了更细粒度的打分,而且计算时加入了排序惩罚,排在最后面的会除以一个系数导致天然地就更小。
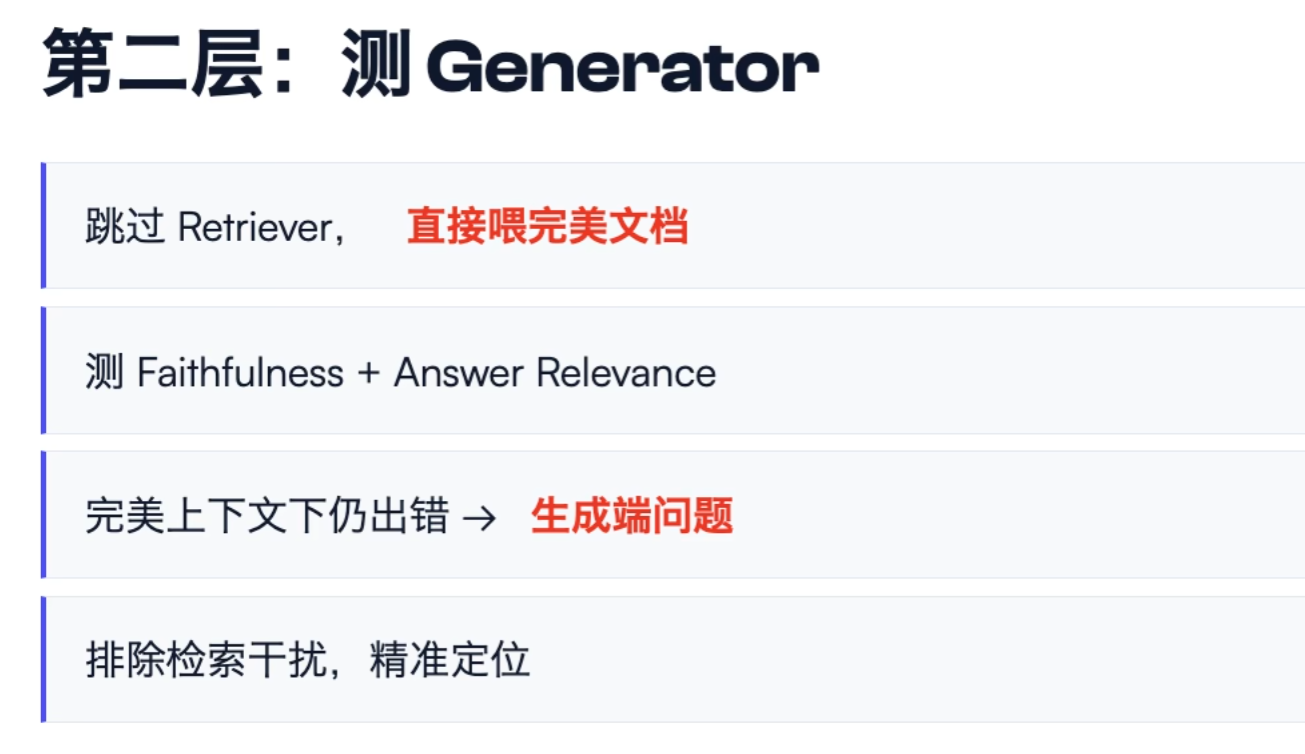
针对 Generator,我们先给定完美检索文档,看在完美文档下能够达到什么效果,用的三个评价指标,也就是忠诚度那三个。
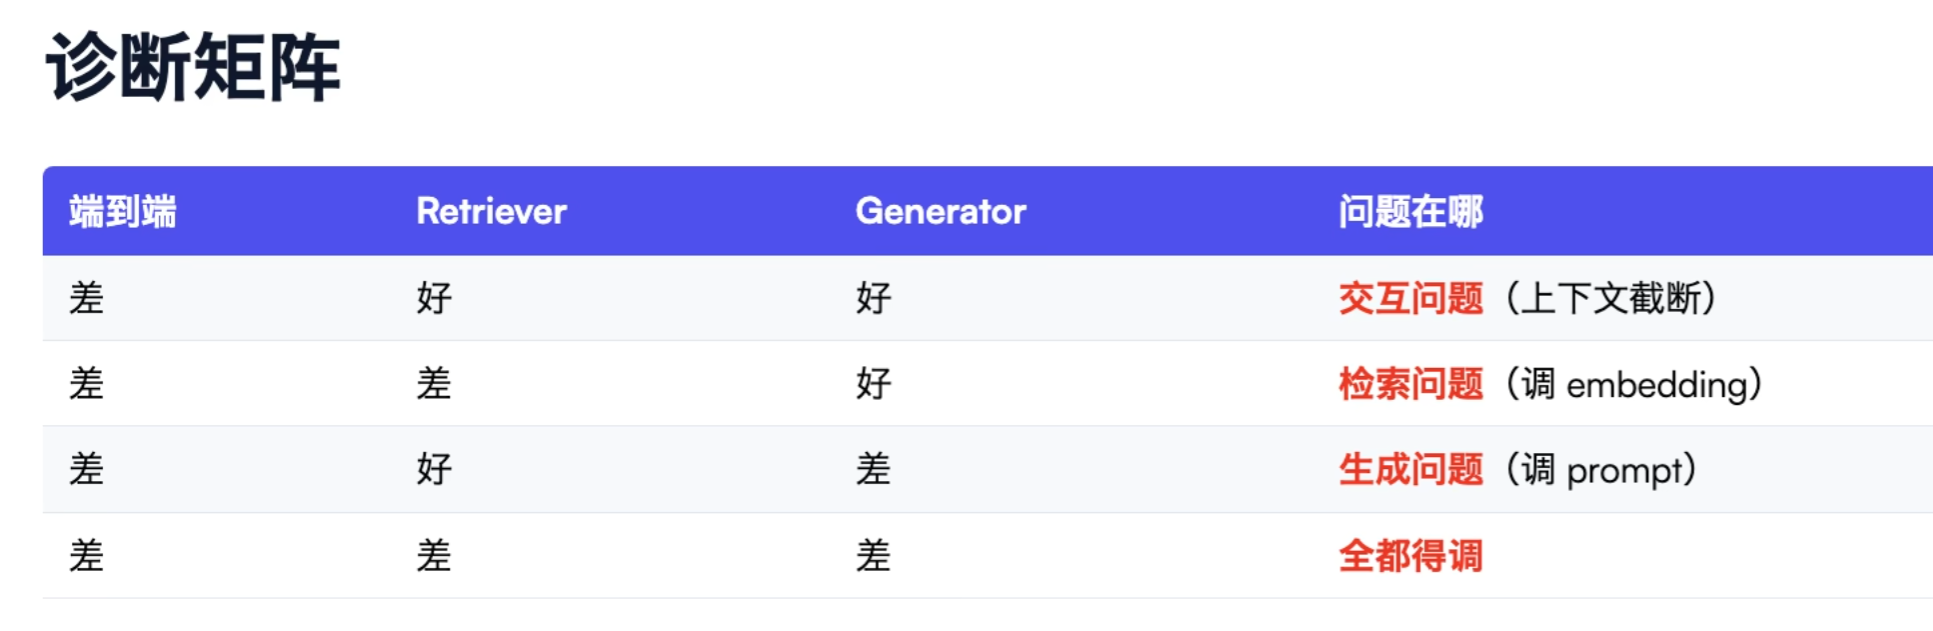
诊断矩阵如下:
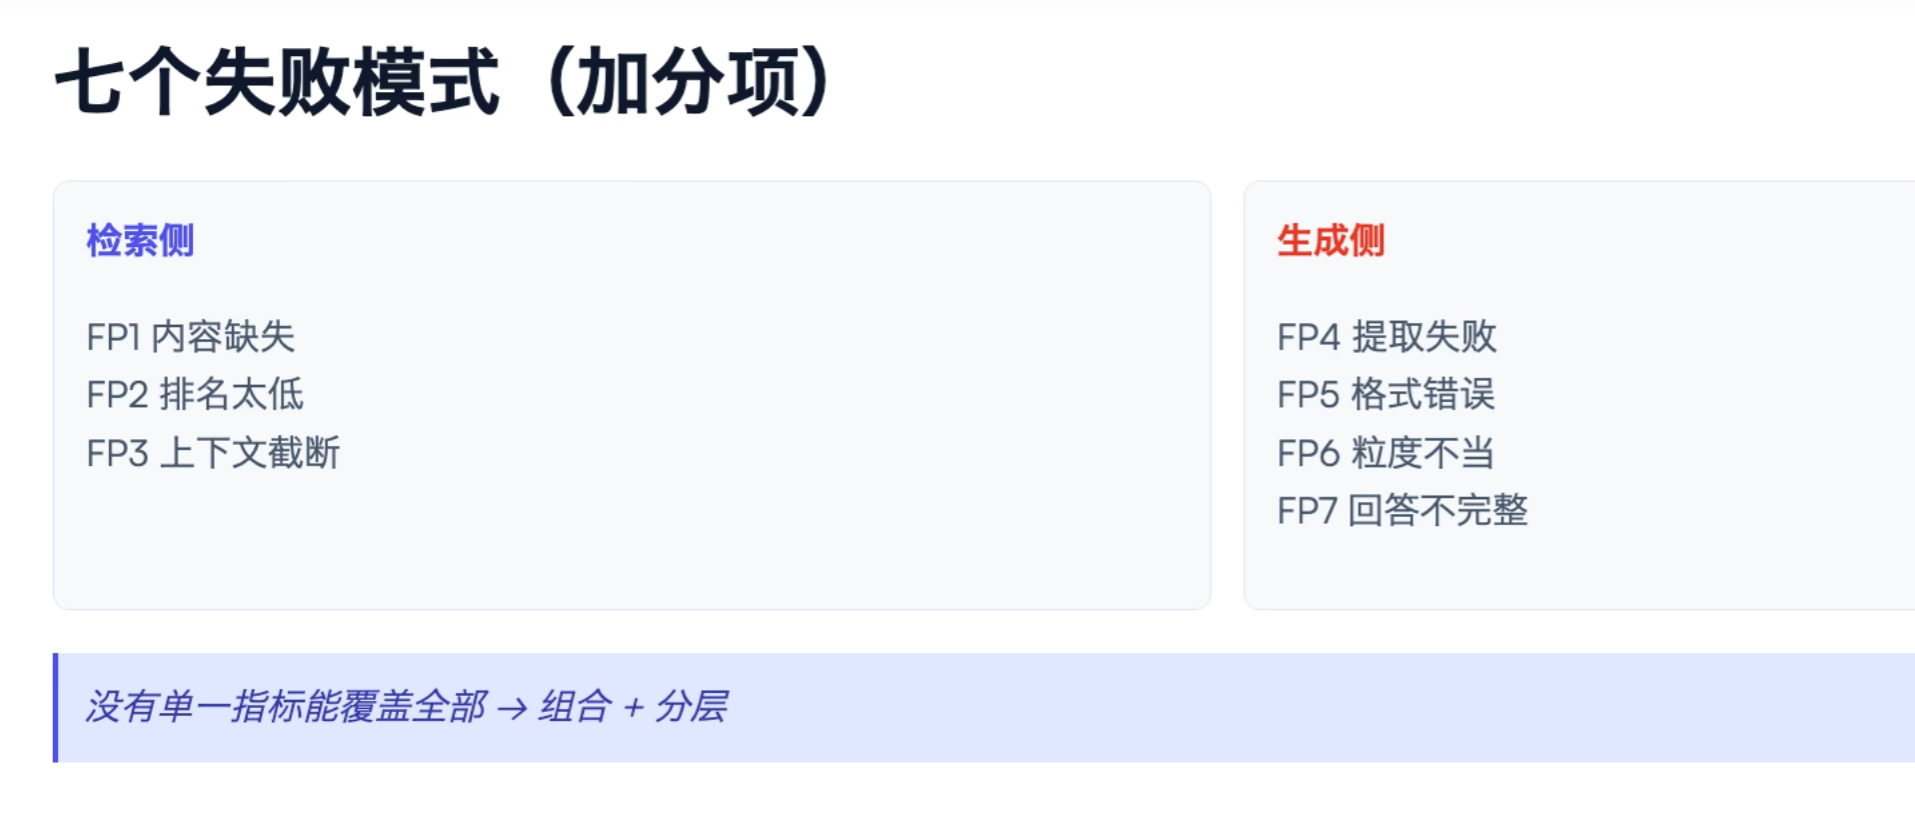
常见的7个问题