文章目录
前言
本专栏文章为《LeetCode 热题 100》的刷题题解,相关内容如有侵权,立即删除。
一、题目
1、原题链接
2、题目描述
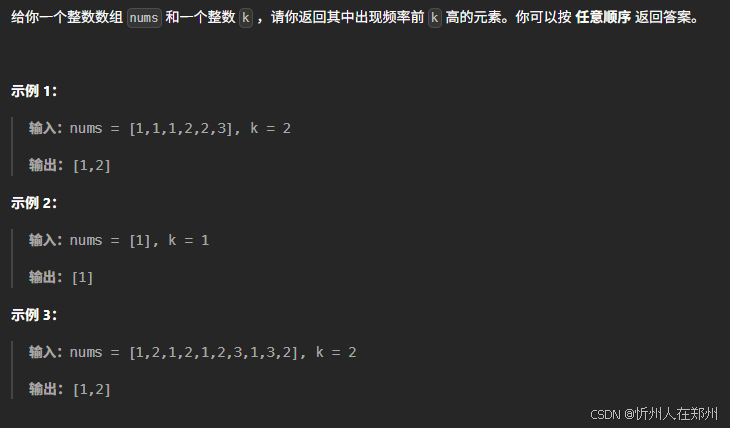
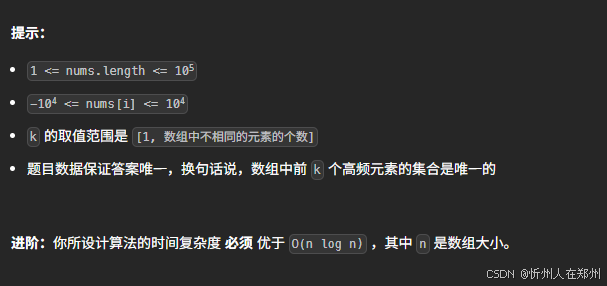
二、个人思路整理
1、思路分析
思路1:小顶堆
- 核心思路:维护一个大小为 k k k 的小顶堆。
- 遍历哈希表中的每个
(元素, 频次)对并压入堆中。 - 当堆内元素个数超过 k k k 时,弹出堆顶元素(即当前堆中频次最低的那个)。
- 遍历结束后,堆里剩下的 k k k 个元素就是频次最高的前 k k k 个。
- 遍历哈希表中的每个
思路2:桶排序
- 核心思路:任何元素的最高频次不会超过数组总长度 n n n。
- 建立一个大小为 n + 1 n + 1 n+1 的桶数组
buckets,其中索引i代表频次,buckets[i]存放所有出现次数为i的元素集合。 - 从后向前(频次由高到低)遍历桶,依次收集元素,直到凑齐 k k k 个为止。
- 建立一个大小为 n + 1 n + 1 n+1 的桶数组
2、解题代码
思路1:小顶堆
cpp
class Solution {
public:
    vector<int> topKFrequent(vector<int>& nums, int k) {
        // 1. 统计每个元素出现的频次:key 为元素数值,value 为出现次数
        unordered_map<int, int> count;
        for (int num : nums) {
            count[num]++;
        }

        // 2. 建立小顶堆:pair<频次, 元素值>
        // greater 会按照 pair 的 first(频次)升序排列,即堆顶始终是当前堆中频次最小的元素
        using pii = pair<int, int>;
        priority_queue<pii, vector<pii>, greater<pii>> min_heap;

        for (const auto& [val, freq] : count) {
            min_heap.emplace(freq, val);
            // 保持堆的大小不超过 k,超出时弹出频次最小的顶堆
            if (min_heap.size() > k) {
                min_heap.pop();
            }
        }

        // 3. 收集堆中留存的前 k 个高频元素
        vector<int> result;
        result.reserve(k);
        while (!min_heap.empty()) {
            result.push_back(min_heap.top().second);
            min_heap.pop();
        }

        return result;
    }
};
复杂度分析
- 时间复杂度: O ( n log k ) O(n \log k) O(nlogk)。哈希表最多有 n n n 个不同元素,向容量为 k k k 的堆中插入元素耗时 O ( log k ) O(\log k) O(logk)。
- 空间复杂度: O ( n ) O(n) O(n)。用于哈希表与堆。
思路2:小顶堆
cpp
class Solution {
public:
    vector<int> topKFrequent(vector<int>& nums, int k) {
        // 1. 统计每个元素的出现频次
        unordered_map<int, int> count;
        for (int num : nums) {
            count[num]++;
        }

        // 2. 将元素按频次分桶
        // 频次最多为 nums.size(),因此开辟大小为 n + 1的桶数组
        // buckets[i] 存放所有出现次数恰好为 i 的元素
        int n = nums.size();
        vector<vector<int>> buckets(n + 1);
        for (const auto& [val, freq] : count) {
            buckets[freq].push_back(val);
        }

        // 3. 从大到小倒序遍历桶,贪心收集前 k 个高频元素
        vector<int> result;
        result.reserve(k);
        for (int freq = n; freq > 0 && result.size() < k; freq--) {
            for (int val : buckets[freq]) {
                result.push_back(val);
                if (result.size() == k) {
                    break;
                }
            }
        }

        return result;
    }
};
复杂度分析
- 时间复杂度: O ( n ) O(n) O(n)。遍历数组统计频次、填充桶和逆序收集结果均在线性时间内完成。
- 空间复杂度: O ( n ) O(n) O(n)。开辟一维数组统计频次。
三、知识风暴
小顶堆 是本题的核心数据结构。它能在 O ( log k ) O(\log k) O(logk) 时间内完成插入与弹出,始终维护「当前频次最高的前 k k k 个元素」,是解决「前 K 大/小元素」类问题的经典做法。理解堆的维护过程与边界控制,对掌握本题至关重要。
算法核心思想:
- 固定容量 :维护一个大小为 k k k 的小顶堆,堆顶始终是堆中频次最低的元素。
- 淘汰机制 :每压入一个新元素,若堆大小超过 k k k,立即弹出堆顶,保证堆内始终是「已遍历元素中频次最高的前 k k k 个」。
- 与排序的区别 :完整排序需要 O ( n log n ) O(n \log n) O(nlogn);而小顶堆只需 O ( n log k ) O(n \log k) O(nlogk),当 k ≪ n k \ll n k≪n 时优势明显,且无需一次性排序全部元素。
常见对比:小顶堆 vs 桶排序
- 小顶堆 :时间复杂度 O ( n log k ) O(n \log k) O(nlogk),空间复杂度 O ( k ) O(k) O(k)。适合数据量极大、无法一次性载入内存的流式场景,或需要多次查询前 K 大元素时。
- 桶排序 :时间复杂度 O ( n ) O(n) O(n),空间复杂度 O ( n ) O(n) O(n)。适合频次范围已知(不超过数组长度)且内存充足的场景,线性时间即可完成。
- 共同点:两者都能在不必完整排序的前提下找到前 K 个高频元素。区别在于小顶堆不修改原数组、可应对流式数据;桶排序需要额外开辟与数组长度等价的桶空间。
"小顶堆"设计思想:
- 核心思想 :利用堆「堆顶最小」的特性,让频次最低的元素始终暴露在堆顶,一旦堆超容就将其弹出,从而让堆内始终沉淀频次最高的 k k k 个元素。
- 与本题的联系 :本题要求「前 K 个高频元素」,恰好对应堆的「淘汰低频、保留高频」过程。遍历完哈希表后,堆中剩下的 k k k 个元素即为答案。
- 注意事项 :堆中存储的是
(频次, 元素值)的二元组,比较器按频次升序排列,才能保证堆顶是频次最低者;弹出时取second才是元素值本身。
使用要点:
- 二元组入堆 :
priority_queue默认按pair的first升序,因此把频次放第一位、元素值放第二位,即可实现「按频次维护小顶堆」。 - 容量控制 :每插入一个元素后判断
size() > k,超出即pop(),保证堆大小始终不超过 k k k。 - 结果收集 :循环弹出堆顶,取
top().second存入结果数组,即可得到前 k k k 个高频元素。 - 复杂度权衡 :当 k k k 接近 n n n 时, O ( n log k ) O(n \log k) O(nlogk) 会退化为 O ( n log n ) O(n \log n) O(nlogn),此时可考虑改用桶排序获得线性复杂度。
算法变体与扩展:
- 数组中的第K个最大元素(LeetCode 215) :维护大小为 k k k 的小顶堆,堆顶即为第 K 大元素,是本题的姊妹题。
- 数据流中的第 K 大元素(LeetCode 703):动态数据流场景,用小顶堆维护前 K 大,是堆解法的进阶应用。
- 最小的K个数(剑指 Offer 40):改用大顶堆维护最小的 K 个数,思路完全对称。
- 前 K 个高频单词(LeetCode 692):在本题基础上增加字典序比较,堆的比较器需自定义。
相关 LeetCode 例题:
- 215. 数组中的第K个最大元素(小顶堆 + 快速选择)
- 703. 数据流中的第K大元素(小顶堆 + 动态数据流)
- 剑指 Offer 40. 最小的k个数(大顶堆 + 区间划分)
- 692. 前K个高频单词(小顶堆 + 自定义比较)
代码语法点:using pii = pair<int, int>;
- 作用 :这是 C++11 引入的「类型别名」声明,等价于
typedef pair<int, int> pii;。它给pair<int, int>起了一个更简短的名字pii,后续代码中写pii就等同于写pair<int, int>。 - 为什么用 :本题的堆中要存储
(频次, 元素值)二元组,类型是pair<int, int>。若每次都写全称,代码会显得冗长;用using起别名后,priority_queue<pii, vector<pii>, greater<pii>>读起来更清爽,也便于统一修改类型。 - 与
typedef的区别 :using语法更直观(别名在左、原类型在右),且支持模板别名等更高级的用法,是 C++11 之后更推荐的方式;typedef是 C 语言时代的旧写法,两者在本题场景下效果完全一致。 - 本题中的实际含义 :
pii的first存频次、second存元素值。配合greater<pii>比较器,堆会按first(频次)升序排列,从而保证堆顶始终是频次最低的元素,实现「小顶堆」的淘汰逻辑。