摘要:如果说 Job 是 Spark 的"任务单",Stage 就是"施工阶段",Task 就是每个工人的"具体活"。一个 Job 被 DAGScheduler 沿 Shuffle 边界切分为多个 Stage------前面的全是 ShuffleMapStage,最后一个必须是 ResultStage。每个 Stage 的 Partition 数决定了 Task 数量,ShuffleMapStage 产生 ShuffleMapTask(写 Shuffle 文件),ResultStage 产生 ResultTask(直接返回结果)。本文从 Stage 类型体系、DAG → Stage 切分源码、Task 生成与序列化、两种 Task 执行差异四个维度,配合 1 张原创深色架构图 + 完整源码分析,带你彻底看懂 Spark 最核心的执行引擎。
关键词:Spark Stage, ShuffleMapStage, ResultStage, ShuffleMapTask, ResultTask, DAGScheduler, Task 序列化, MapOutputTracker
一、开篇:Stage 和 Task 是什么关系?
先说结论:
ini
Job = 用户的一个 Action 操作
  ├── Stage 0: ShuffleMapStage → 2 个 ShuffleMapTask
└── Stage 1: ResultStage → 3 个 ResultTask| 概念 | 定义 | 数量 |
|---|---|---|
| Stage | Shuffle 边界切分的计算阶段 | 每个 Job 可有多个 |
| Task | 处理一个 Partition 的最小计算单元 | 每个 Stage 可有多个 |
| ShuffleMapStage | 输出 Shuffle 中间文件的 Stage | Job 中除最后一个外的所有 |
| ResultStage | 输出最终结果的 Stage | 每个 Job 有且仅有一个 |
二、Stage 与 Task 全景图
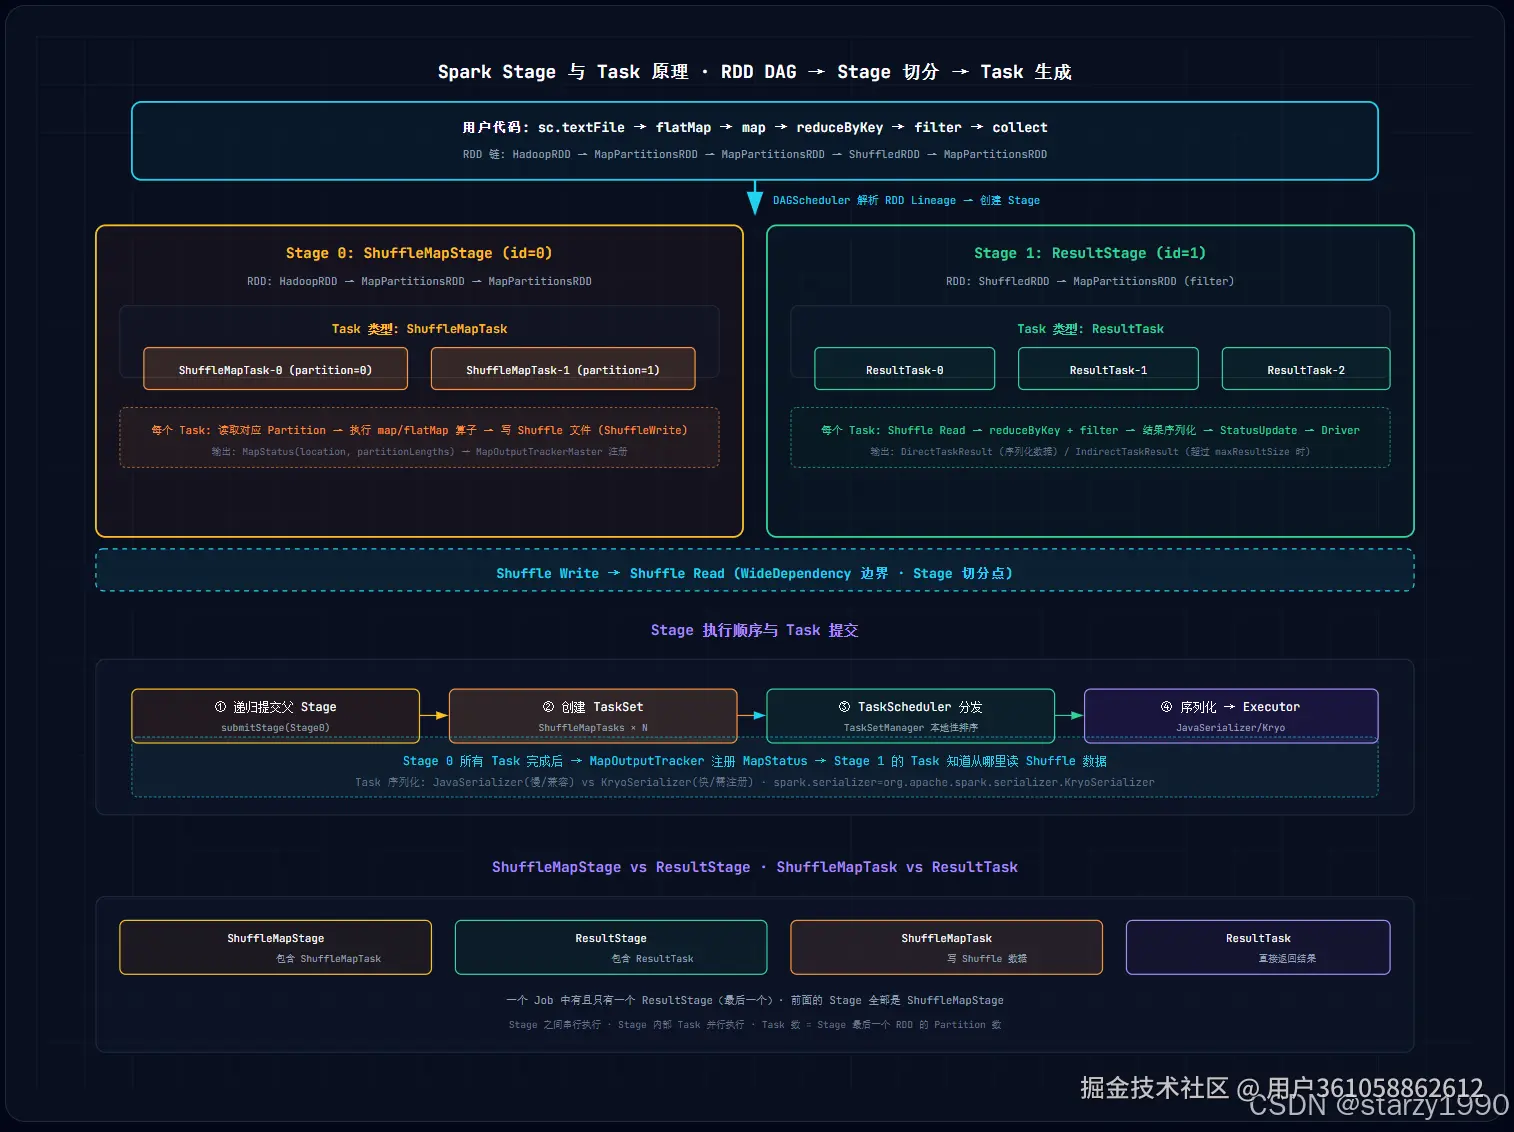
三、Stage 切分:从 RDD DAG 到 Stage
3.1 核心源码
scala
// 源码:DAGScheduler.scala - 创建 ResultStage
private def createResultStage(finalRDD: RDD[_], func: (TaskContext, Iterator[_]) => _,
    partitions: Array[Int], jobId: Int, callSite: CallSite): ResultStage = {
  // 从 finalRDD 回溯 → 遇到 ShuffleDep → 创建 ShuffleMapStage
  val parents = getOrCreateParentStages(finalRDD, jobId)
  val id = nextStageId.getAndIncrement()
  new ResultStage(id, finalRDD, func, partitions, parents, jobId, callSite)
}

// 递归获取父 Stage
private def getOrCreateParentStages(rdd: RDD[_], firstJobId: Int): List[Stage] = {
  rdd.dependencies.flatMap {
    case shufDep: ShuffleDependency[_, _, _] =>
      getOrCreateShuffleMapStage(shufDep, firstJobId) :: Nil
    case _ => Nil  // NarrowDep 不切分
  }.toList
}
3.2 Stage 提交顺序
scala
// 递归提交:先父后子
private def submitStage(stage: Stage): Unit = {
  val missing = getMissingParentStages(stage).sortBy(_.id)
  if (missing.isEmpty) {
    submitMissingTasks(stage, jobId.get)  // 无缺失父 Stage → 执行
  } else {
    for (parent <- missing) submitStage(parent)  // 递归提交父 Stage
  }
}
四、Task 生成:从 Stage 到 TaskSet
scala
// 源码:DAGScheduler.scala - submitMissingTasks()
private def submitMissingTasks(stage: Stage, jobId: Int): Unit = {
  // 计算需要计算的 Partition(跳过已完成的)
  val partitionsToCompute = stage.findMissingPartitions()

  // 为每个 Partition 创建一个 Task
  val tasks: Seq[Task[_]] = stage match {
    case stage: ShuffleMapStage =>
      partitionsToCompute.map { id =>
        new ShuffleMapTask(stage.id, stage.rdd, stage.shuffleDep, ...)
      }
    case stage: ResultStage =>
      partitionsToCompute.map { id =>
        new ResultTask(stage.id, stage.rdd, stage.func, id, ...)
      }
  }

  // 封装为 TaskSet,提交给 TaskScheduler
  taskScheduler.submitTasks(new TaskSet(tasks.toArray, stage.id, ...))
}
Task 数量 = Stage 最后一个 RDD 的 Partition 数量。
五、两种 Stage 与两种 Task 对比
5.1 ShuffleMapStage + ShuffleMapTask
scala
// ShuffleMapTask.runTask() --- 执行逻辑
override def runTask(context: TaskContext): MapStatus = {
  val writer = new ShuffleWriter(partition, shuffleDep)
  // ① 执行 RDD 算子链(map/flatMap/filter...)
  val iter = rdd.iterator(partition, context)
  // ② 将结果写入 Shuffle 文件
  writer.write(iter)
  // ③ 返回 MapStatus(文件位置 + 分区长度)
  writer.stop(success = true).get
}
5.2 ResultStage + ResultTask
scala
// ResultTask.runTask() --- 执行逻辑
override def runTask(context: TaskContext): U = {
  // ① 执行 RDD 算子链
  val iter = rdd.iterator(partition, context)
  // ② 将最终结果应用 func(如 collect 的收集逻辑)
  func(context, iter)
  // ③ 序列化结果 → StatusUpdate → Driver
}
5.3 对比表
| 维度 | ShuffleMapStage | ResultStage |
|---|---|---|
| Task 类型 | ShuffleMapTask | ResultTask |
| 输出 | Shuffle 中间文件 | 最终计算结果 |
| 返回类型 | MapStatus | U (泛型) |
| 一个 Job 中的数量 | 0~N | 1(唯一) |
六、Task 序列化
bash
# 推荐 Kryo 序列化(比 Java 快 10 倍)
--conf spark.serializer=org.apache.spark.serializer.KryoSerializer
--conf spark.kryo.registrationRequired=true  # 强制注册
scala
// 代码中注册 Kryo 类
val conf = new SparkConf()
  .set("spark.serializer", "org.apache.spark.serializer.KryoSerializer")
  .registerKryoClasses(Array(classOf[MyDataClass], classOf[MyModel]))
为什么需要序列化? Driver 端的 Task 对象(包含 RDD 算子闭包)需要跨网络发送到 Executor,必须序列化为字节流。
七、总结
| 要点 | 总结 |
|---|---|
| Stage 切分 | 遇到 ShuffleDependency 即切分,递归提交(先父后子) |
| Task 生成 | 每个 Partition → 一个 Task,类型由 Stage 决定 |
| 两种 Stage | ShuffleMapStage(写 Shuffle) + ResultStage(返回结果) |
| 序列化 | Task 闭包必须可序列化,推荐 Kryo |
金句:Stage 是 Spark 的"流水线工位",Task 是每个工位上的"工人"。Shuffle 就是工位之间的传送带------上一个工位写完,下一个工位才能开始。
作者:starzy | AI Data Engineer / 大数据技术实践者
博客:blog.starzy.cn | GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践