✍✍计算机毕设指导师**
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
⚡⚡有什么问题可以在主页上或文末下联系咨询博客~~
⚡⚡Java、Python、小程序、大数据实战项目集](https://blog.csdn.net/2301_80395604/category_12487856.html)
⚡⚡文末获取源码
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
WTA职业网球赛事演变与竞技格局数据分析系统-简介
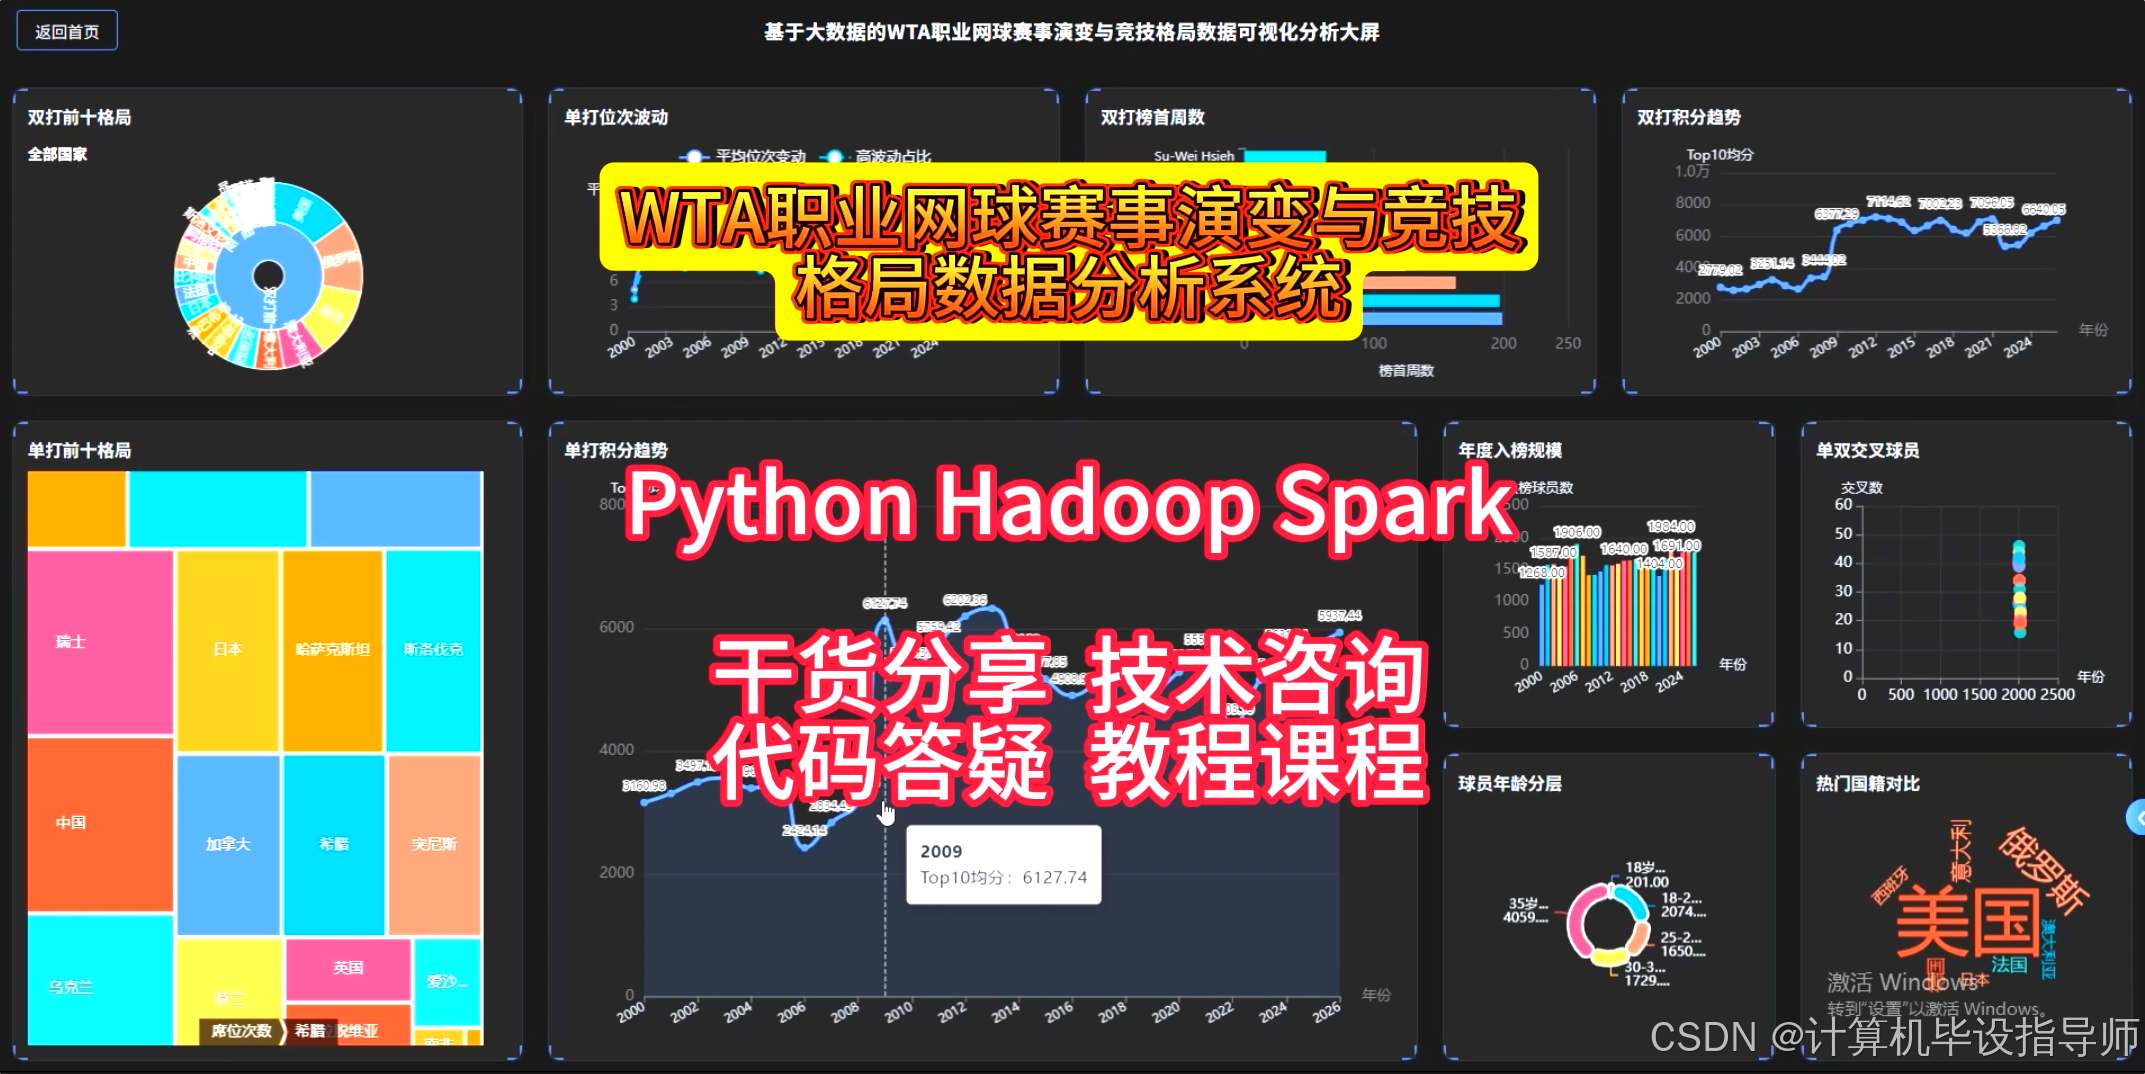
本系统是一个基于Spark的WTA职业网球赛事演变与竞技格局数据分析系统,采用Python语言进行开发,后端依托Django框架提供数据接口支撑。系统在大数据处理层面充分发挥了Hadoop与Spark的协同优势,利用HDFS进行底层赛事数据的分布式存储,通过Spark与Spark SQL对海量WTA历史比赛记录、球员信息及积分榜单进行高效清洗与聚合计算。在核心功能层面,系统划分为球员画像、单打演变和双打格局三大分析维度。球员画像模块通过Pandas和NumPy对国籍分布、出生年代及年龄分层进行统计,并引入K-Means聚类算法对球员生涯特征进行分群,识别出顶尖常驻与边缘入榜等不同类型的球员。单打演变模块不仅追踪了顶尖球员的积分趋势和榜首更迭情况,还利用Isolation Forest算法对单打积分异常和位次剧烈波动进行检测,精准定位赛季异常冲击点。双打格局模块则对比了单双打积分通胀情况,并统计了单双打双线作战的共现球员数量。整个系统将复杂的算法逻辑封装在后端,前端结合Echarts将分析结果以多维图表形式直观展示,实现了从数据采集清洗到分析展示的完整闭环。
WTA职业网球赛事演变与竞技格局数据分析系统-技术
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
数据库:MySQL
WTA职业网球赛事演变与竞技格局数据分析系统-背景
这几年女子网球赛事的商业化程度和竞技水平都在不断拔高,WTA作为顶尖的女子职业网球组织,积累了海量的比赛数据。不管是球员的个人资料、历史排名变化,还是各种赛事的积分演变,这些数据背后其实藏着很多有价值的竞技规律。但是,平时我们看比赛或者查资料,很多时候只能看到一些表层的比分或者简单的排名,这些海量的历史数据并没有被很好地串联起来做整体的格局分析。对于计算机专业的学生来说,怎么把这些看起来杂乱无章的体育赛事数据用起来,把它们变成能反映真实竞技格局的图表,是个很值得琢磨的事儿。这也正是这个课题的实际由来,想着借助现在流行的大数据处理技术,把WTA的历史数据好好理一理,看看能不能找出点平时注意不到的门道。
做这个基于Spark的WTA赛事数据分析系统,其实主要图个能把学过的技术真正落到实地。从练手的角度看,拿真实的体育赛事数据来跑Spark和Hadoop,能让咱们把K-Means聚类和孤立森林这些算法怎么用在真实业务里摸个透底。从实际应用的角度来说,系统整理出来的球员画像和单双打格局对比,能给关注网球的人提供个不一样的参考视角,不用再一个个翻历史榜单对数据了。虽然它只是个毕业设计,没法跟商业级的体育数据平台比,但好歹走通了一条从数据清洗到后端逻辑处理再到前端展示的完整路子。它算是给咱们在尝试拿大数据剖析具体行业现象时,提供了一个稍微能落地的参考样例,顺便检验一下自己的学习成果。
WTA职业网球赛事演变与竞技格局数据分析系统-视频展示
基于Spark的WTA职业网球赛事演变与竞技格局数据分析系统
WTA职业网球赛事演变与竞技格局数据分析系统-图片展示
WTA职业网球赛事演变与竞技格局数据分析系统-代码展示
python
spark = SparkSession.builder \
    .appName("WtaTourPatternAnalysis") \
    .config("spark.sql.shuffle.partitions", "4") \
    .getOrCreate()
players_df = spark.read.csv("hdfs://localhost:9000/wta/players.csv", header=True, inferSchema=True)
rankings_single_df = spark.read.csv("hdfs://localhost:9000/wta/rankings_single.csv", header=True, inferSchema=True)
agg_features = rankings_single_df.groupBy("playerId").agg(
    F.max("ranking").alias("best_rank"),
    F.max("points").alias("highest_points"),
    F.count("rankedAt").alias("weeks_listed"),
    F.avg("points").alias("avg_points")
)
player_features = agg_features.join(players_df, "playerId").na.drop(subset=["best_rank", "highest_points", "weeks_listed", "avg_points"])
assembler = VectorAssembler(inputCols=["best_rank", "highest_points", "weeks_listed", "avg_points"], outputCol="features")
feature_vectors = assembler.transform(player_features)
scaler = StandardScaler(inputCol="features", outputCol="scaledFeatures", withStd=True, withMean=True)
scaled_data = scaler.fit(feature_vectors).transform(feature_vectors)
kmeans = KMeans(k=4, seed=42, featuresCol="scaledFeatures", predictionCol="cluster_id")
model = kmeans.fit(scaled_data)
clustered_df = model.transform(scaled_data)
cluster_result = clustered_df.groupBy("cluster_id").count().orderBy("count", ascending=False)
cluster_result.coalesce(1).write.mode("overwrite").csv("output/player_career_cluster")
singles_rdd = rankings_single_df.select("rankedAt", "points", "movement", "ranking").na.drop().rdd
singles_data = singles_rdd.map(lambda row: (row['rankedAt'].year, float(row['points']), abs(int(row['movement'])), int(row['ranking'])))
pandas_df = pd.DataFrame(singles_data.collect(), columns=['year', 'points', 'abs_movement', 'ranking'])
feature_matrix = pandas_df[['points', 'abs_movement', 'ranking']].values
iso_forest = IsolationForest(contamination=0.05, random_state=42)
iso_forest.fit(feature_matrix)
pandas_df['is_anomaly'] = iso_forest.predict(feature_matrix)
anomaly_df = pandas_df[pandas_df['is_anomaly'] == -1]
anomaly_stats = anomaly_df.groupby('year').size().reset_index(name='anomaly_count')
spark.createDataFrame(anomaly_stats).coalesce(1).write.mode("overwrite").csv("output/singles_points_anomaly")
rankings_doubles_df = spark.read.csv("hdfs://localhost:9000/wta/rankings_doubles.csv", header=True, inferSchema=True)
singles_top50 = rankings_single_df.filter(F.col("ranking") <= 50).withColumn("year", F.year("rankedAt")).select("playerId", "year").dropDuplicates()
doubles_top50 = rankings_doubles_df.filter(F.col("ranking") <= 50).withColumn("year", F.year("rankedAt")).select("playerId", "year").dropDuplicates()
singles_year_best = singles_top50.groupBy("year", "playerId").agg(F.min("ranking").alias("best_singles_rank")).filter(F.col("best_singles_rank") <= 50)
doubles_year_best = doubles_top50.groupBy("year", "playerId").agg(F.min("ranking").alias("best_doubles_rank")).filter(F.col("best_doubles_rank") <= 50)
crossover_players = singles_year_best.join(doubles_year_best, ["year", "playerId"], "inner")
crossover_count = crossover_players.groupBy("year").agg(F.countDistinct("playerId").alias("crossover_count")).orderBy("year")
crossover_count.coalesce(1).write.mode("overwrite").csv("output/singles_doubles_crossover")
WTA职业网球赛事演变与竞技格局数据分析系统-结语
这篇毕设项目的分享就到这儿啦。做大数据毕设确实容易卡壳,要是你在跑环境或者写代码时遇到啥问题,欢迎来主页找我交流。觉得内容对你有点帮助的话,别忘了点个赞给个一键三连支持一下,也欢迎在评论区聊聊你的选题想法,大家一起顺利通关毕业季!
实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
如果遇到具体的技术问题或其他需求,你也可以问我,我会尽力帮你分析和解决问题所在,支持我记得一键三连,再点个关注,学习不迷路!~~