✍✍计算机毕设指导师**
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
⚡⚡有什么问题可以在主页上或文末下联系咨询博客~~
⚡⚡Java、Python、小程序、大数据实战项目集](https://blog.csdn.net/2301_80395604/category_12487856.html)
⚡⚡文末获取源码
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
AI应用对就业与收入增长的区域差异分析系统-简介
本系统是一个基于Spark与Hadoop生态构建的大数据分析平台,后端采用Python语言搭配Django框架,前端融合Vue与ElementUI实现数据可视化展现。系统聚焦AI应用对就业与收入增长带来的区域差异,利用Spark强大的分布式计算能力,结合Spark SQL对海量数据进行高效清洗与多维聚合。功能上涵盖了区域就业损失与收入增长的均值对比、行业级就业与收入演进趋势分析,还引入了K-Means算法对区域和行业进行多维画像聚类,识别相似群体类型。针对工具落地组合,系统运用FP-Growth算法挖掘行业、工具与监管状态之间的频繁项集与关联规则,并在异常识别模块利用Isolation Forest算法精准定位高损低增等离群组合。数据底层依赖HDFS提供可靠存储,MySQL负责管理结构化基础数据,Pandas与NumPy在局部数据预处理环节发挥灵活作用。前端通过Echarts将复杂的数据分析结果转化为直观的柱状图、折线图及散点图,帮助使用者清晰洞察不同区域与行业在AI浪潮下的真实影响差异,整个系统从数据接入到分析展现形成了一套完整的业务闭环。
AI应用对就业与收入增长的区域差异分析系统-技术
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
数据库:MySQL
AI应用对就业与收入增长的区域差异分析系统-背景
这几年人工智能发展得特别快,各种大模型和自动化工具不断冒出来,大家都在讨论AI到底会不会抢饭碗,或者能不能帮大家多赚钱。实际上,不同地方和不同行业受AI的影响差别挺大的。有些地方可能很快用上了AI,大家收入跟着涨;但在有些地方或者传统行业,可能就业就受到了挺大冲击。现在网上关于这个话题的讨论很多,但大多停留在主观感觉上,缺乏比较客观的数据支撑去分析这种区域和行业上的差异到底长什么样。作为一个计算机专业的学生,就想能不能用学过的大数据技术,把相关的数据收集起来,去算一算、看一看这种差异到底是个什么情况。所以就有了做这个系统的想法,想通过实际的数据去还原AI应用在各地带来的真实影响,给那些想了解这方面情况的人提供一个直观的数据参考。
这个课题的意义其实挺朴实的。从实际应用角度看,系统通过对各项指标的聚合和对比,能把AI对不同区域和行业的就业、收入影响直观展示出来,给那些想了解AI实际冲击力的人提供一点客观数据参考。而且系统里用到的聚类和关联规则挖掘,能把复杂的数据分个类、找找规律,比如哪些行业属于高收益低冲击类型,这对理解行业转型也有点帮助。从学习层面来说,做这个系统能把Spark、Hadoop这些大数据框架真正用起来跑数据,不再是纸上谈兵,对于提升自己的动手能力很有好处。当然啦,这毕竟只是个毕业设计,数据量和算法深度都比较有限,没法跟那些大型商业分析平台比,主要还是为了完成学业要求,同时给自己大学四年学的东西做个小结,如果能顺带给看的人提供一点点启发,那就算额外收获了。
AI应用对就业与收入增长的区域差异分析系统-视频展示
基于Spark的AI应用对就业与收入增长的区域差异分析系统
AI应用对就业与收入增长的区域差异分析系统-图片展示
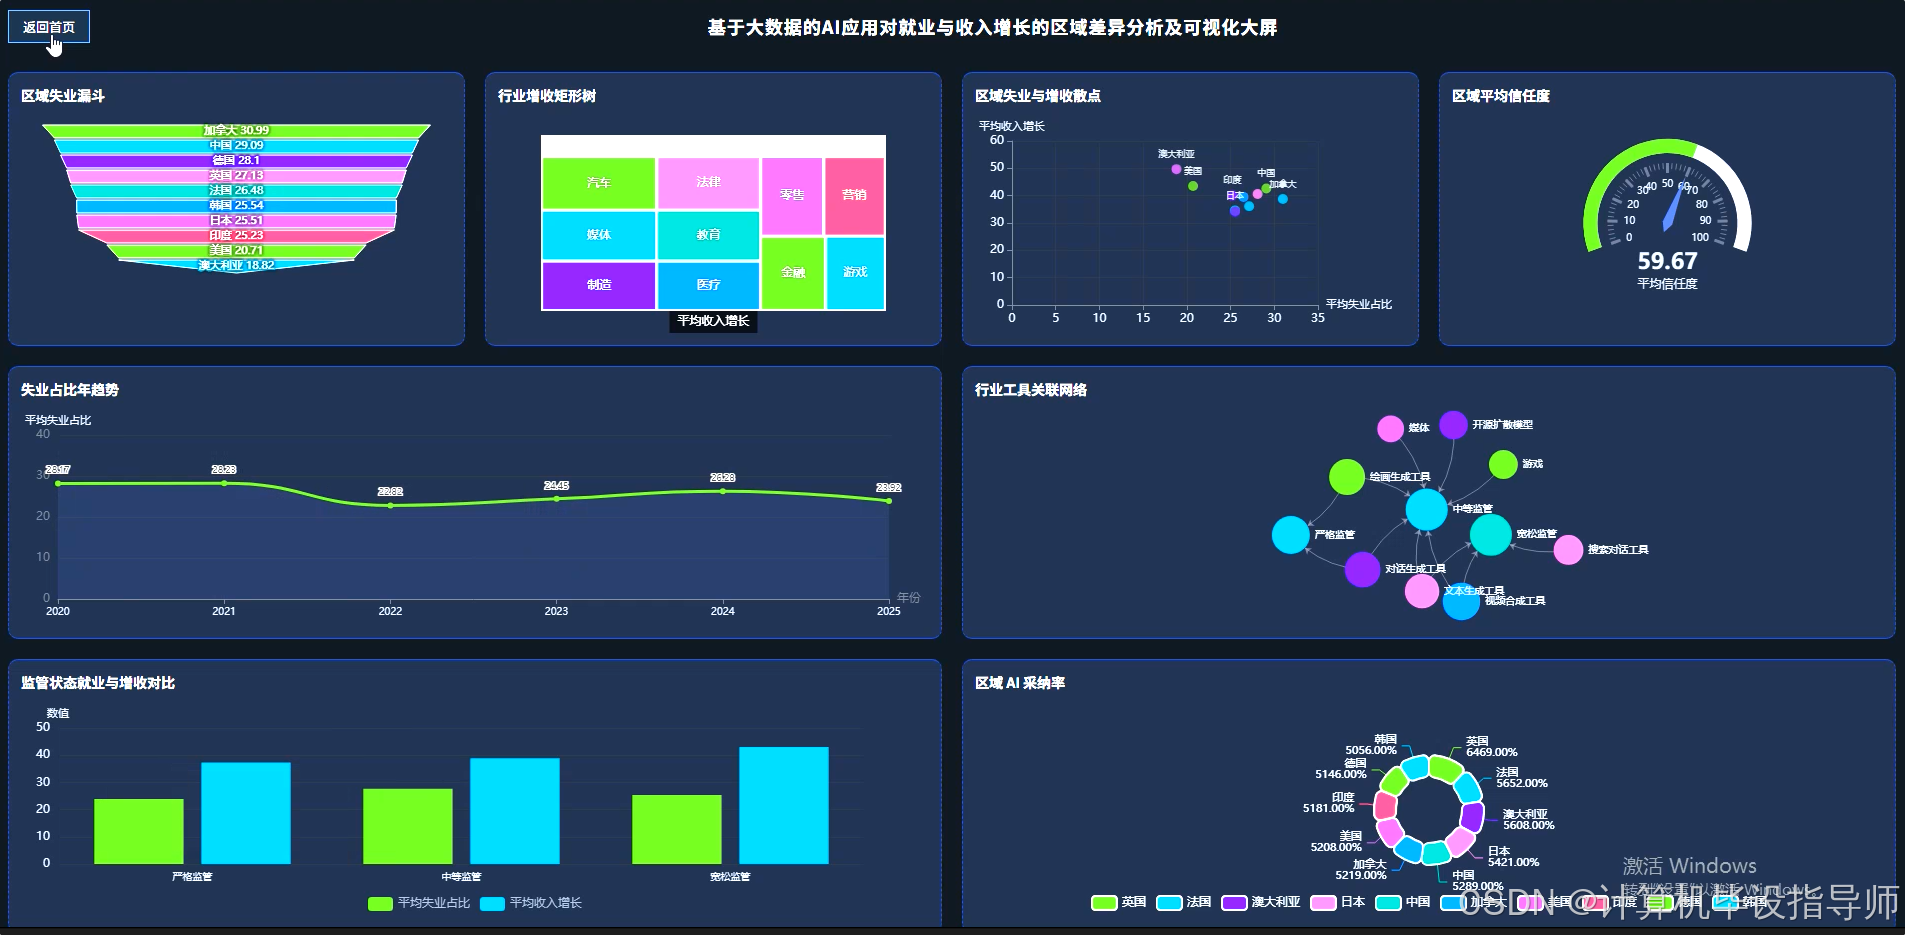
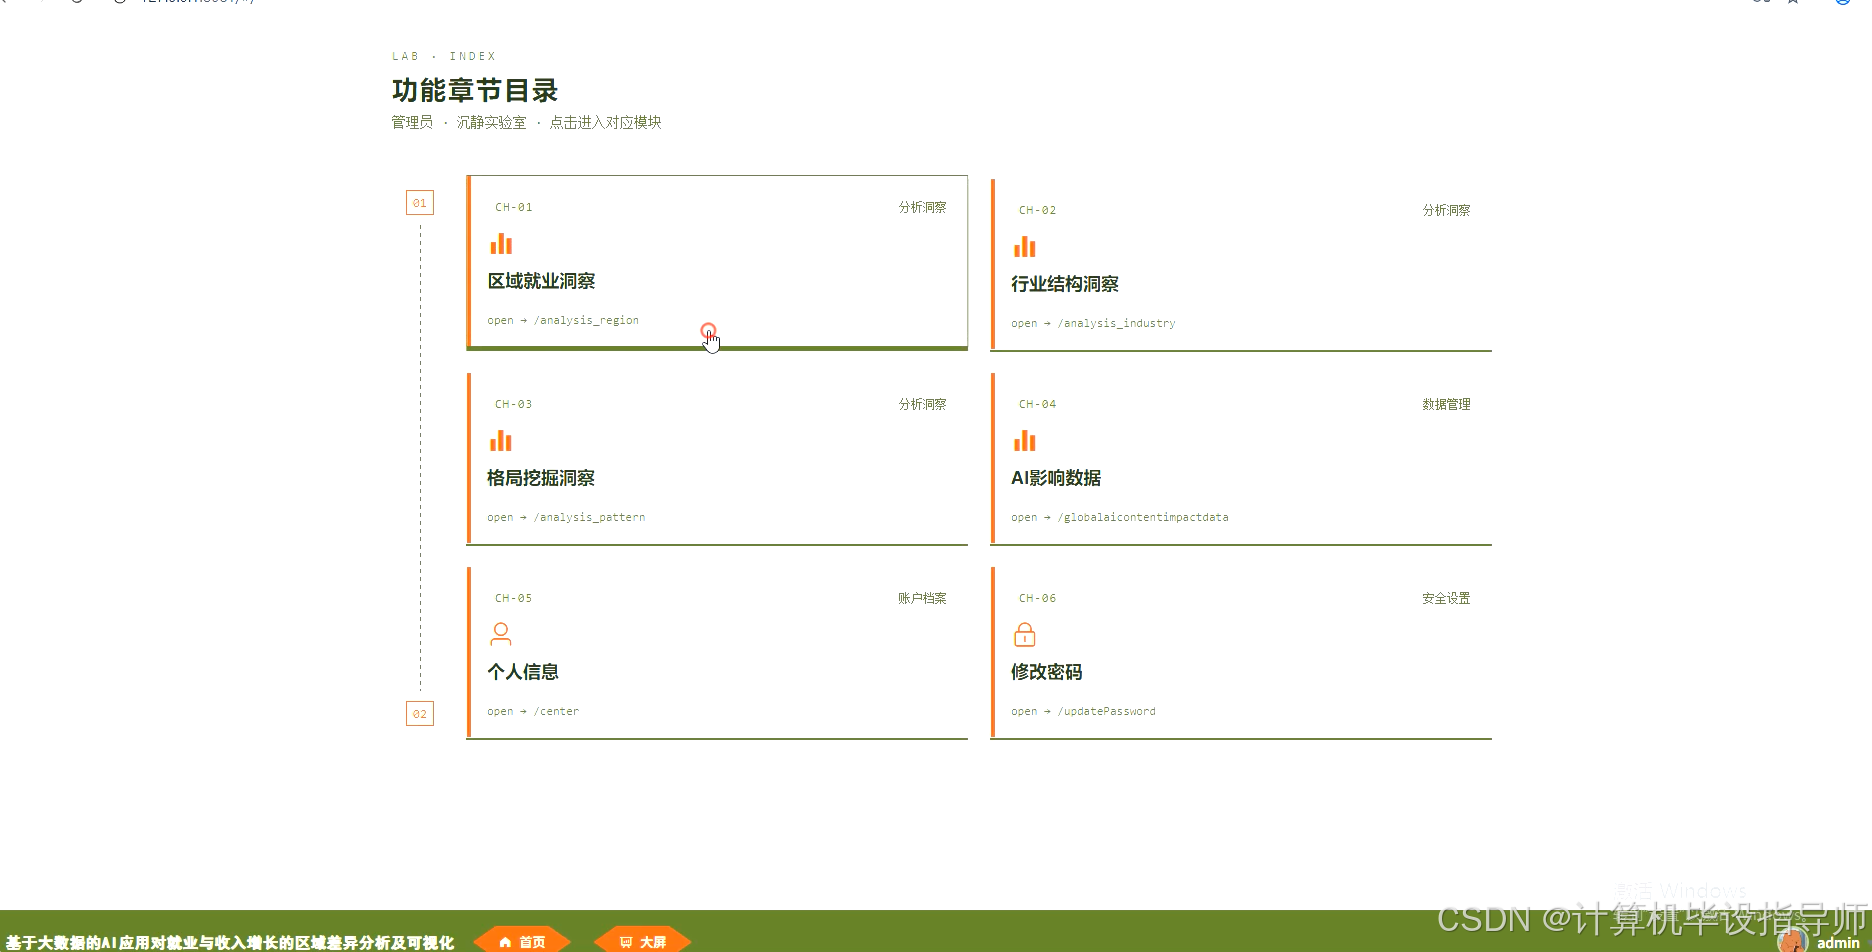
AI应用对就业与收入增长的区域差异分析系统-代码展示
python
spark = SparkSession.builder.appName("AiEmploymentIncomeAnalysis").master("local[]").getOrCreate()
def analyze_region_job_loss_and_revenue(df):
    df.createOrReplaceTempView("ai_impact_data")
    region_stats = spark.sql("""
        SELECT Country, AVG(Job Loss Due to AI (%)) as avg_job_loss,
               AVG(Revenue Increase Due to AI (%)) as avg_revenue_increase, COUNT() as record_count
        FROM ai_impact_data
        WHERE Country IS NOT NULL AND Job Loss Due to AI (%) IS NOT NULL
        GROUP BY Country ORDER BY avg_job_loss DESC
    """)
    pandas_df = region_stats.toPandas()
    result = []
    for index, row in pandas_df.iterrows():
        result.append({
            'country': row['Country'], 'avg_job_loss': round(float(row['avg_job_loss']), 2),
            'avg_revenue_increase': round(float(row['avg_revenue_increase']), 2),
            'record_count': int(row['record_count'])
        })
    return result
def perform_region_kmeans_clustering(df):
    feature_cols = ['AI Adoption Rate (%)', 'Job Loss Due to AI (%)', 'Revenue Increase Due to AI (%)', 'Human-AI Collaboration Rate (%)', 'Consumer Trust in AI (%)', 'Market Share of AI Companies (%)']
    agg_df = df.groupBy("Country").agg(*[F.avg(c).alias(c) for c in feature_cols])
    agg_df = agg_df.na.drop(subset=feature_cols)
    assembler = VectorAssembler(inputCols=feature_cols, outputCol="features")
    feature_data = assembler.transform(agg_df)
    scaler = StandardScaler(inputCol="features", outputCol="scaledFeatures", withStd=True, withMean=True)
    scaled_data = scaler.fit(feature_data).transform(feature_data)
    kmeans = KMeans(k=3, seed=42, featuresCol="scaledFeatures", predictionCol="cluster_id")
    model = kmeans.fit(scaled_data)
    clustered_data = model.transform(scaled_data)
    pandas_clustered = clustered_data.select("Country", "cluster_id", *feature_cols).toPandas()
    cluster_summary = pandas_clustered.groupby('cluster_id')[feature_cols].mean().to_dict('index')
    return {'data': pandas_clustered.to_dict('records'), 'summary': cluster_summary}
def detect_multidim_anomalies(df):
    numerical_cols = ['AI Adoption Rate (%)', 'Job Loss Due to AI (%)', 'Revenue Increase Due to AI (%)', 'Human-AI Collaboration Rate (%)', 'Consumer Trust in AI (%)', 'Market Share of AI Companies (%)']
    pandas_df = df.select('Country', 'Industry', 'Year', *numerical_cols).dropna(subset=numerical_cols).toPandas()
    scaler = StandardScaler()
    scaled_features = scaler.fit_transform(pandas_df[numerical_cols])
    iso_forest = IsolationForest(n_estimators=100, contamination=0.05, random_state=42)
    iso_forest.fit(scaled_features)
    pandas_df['anomaly_score'] = iso_forest.decision_function(scaled_features)
    pandas_df['is_anomaly'] = iso_forest.predict(scaled_features)
    pandas_df['is_anomaly'] = pandas_df['is_anomaly'].apply(lambda x: 1 if x == -1 else 0)
    abnormal_records = pandas_df[pandas_df['is_anomaly'] == 1].sort_values(by='anomaly_score')
    return abnormal_records.to_dict('records')
AI应用对就业与收入增长的区域差异分析系统-结语
整体而言,这个系统能把Spark大数据技术真正落地跑通,功能上也涵盖了从数据清洗到可视化展示的完整链路。虽然作为一个毕业设计还有很多不够成熟的地方,但希望能给同样在准备计算机毕设的同学提供一点思路,在应对大数据分析类课题时少走点弯路。
做计算机毕设卡壳了不知道怎么搞?主页有联系方式可以找我聊聊。觉得这套Spark大数据分析系统对你有帮助的同学,记得一键三连支持一下,也欢迎在评论区交流你们遇到的问题或者想看什么类型的系统,一起把毕设顺顺利利搞完!
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
⚡⚡如果遇到具体的技术问题或其他需求,你也可以问我,我会尽力帮你分析和解决问题所在,支持我记得一键三连,再点个关注,学习不迷路!~~