机器学习增加数据-数据增强

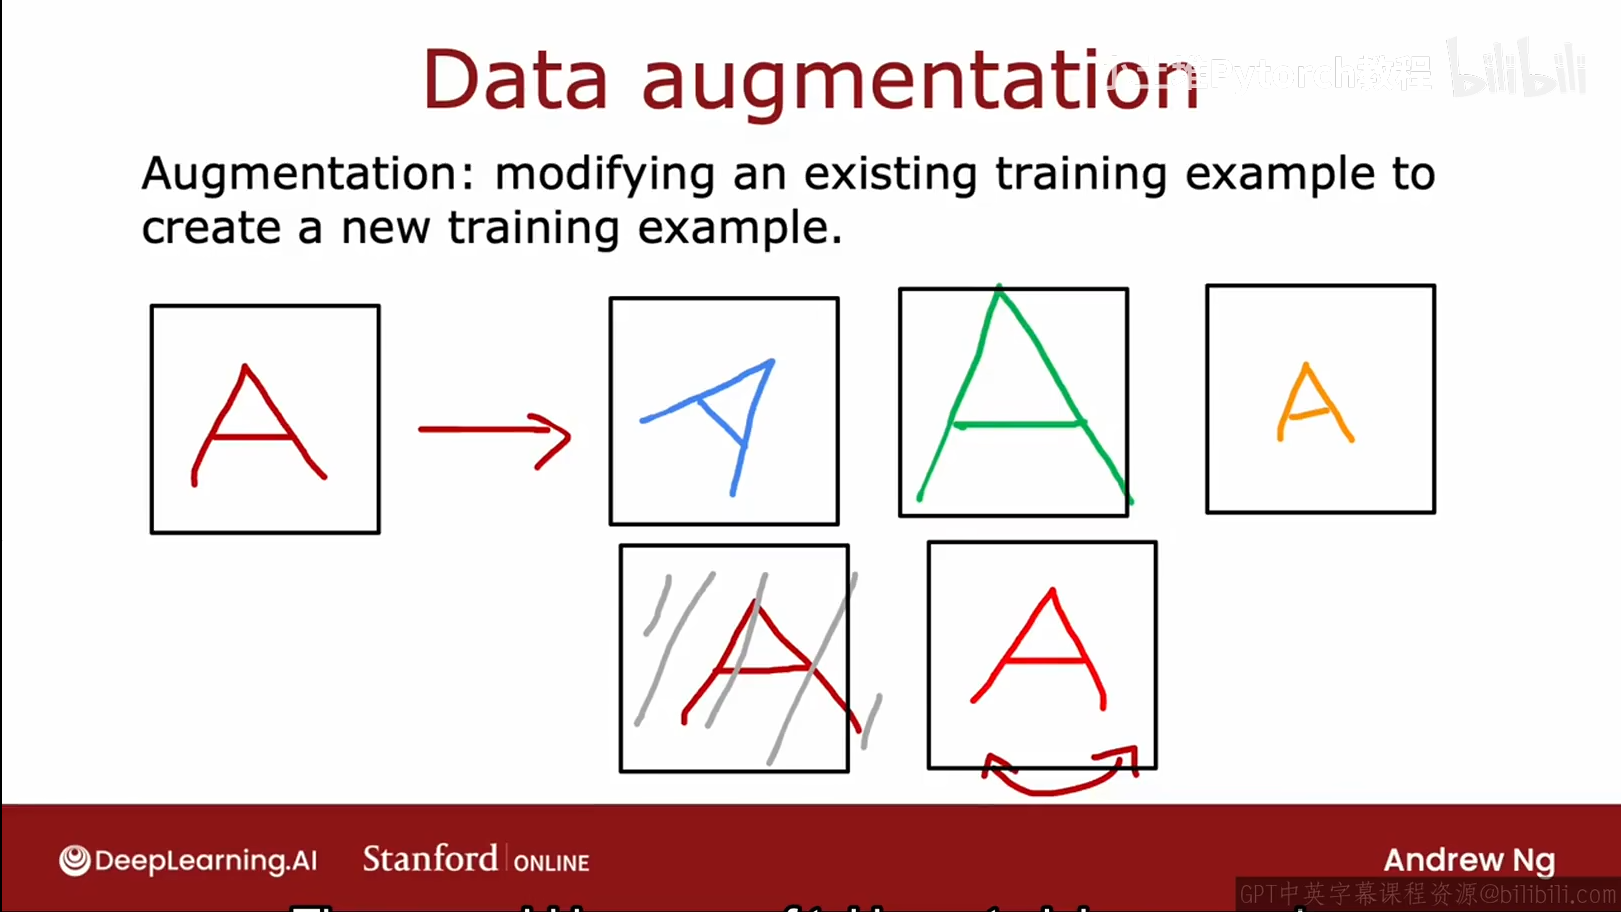
利用现有的训练样本创建新的训练样本

在字母识别的项目中
例如可以通过对字母A记性旋转,放大缩小变换,改变图像对比度,还有部分的字母可以镜像这些都一个创造一个新的数据,但是最终还是可以看的出来是A

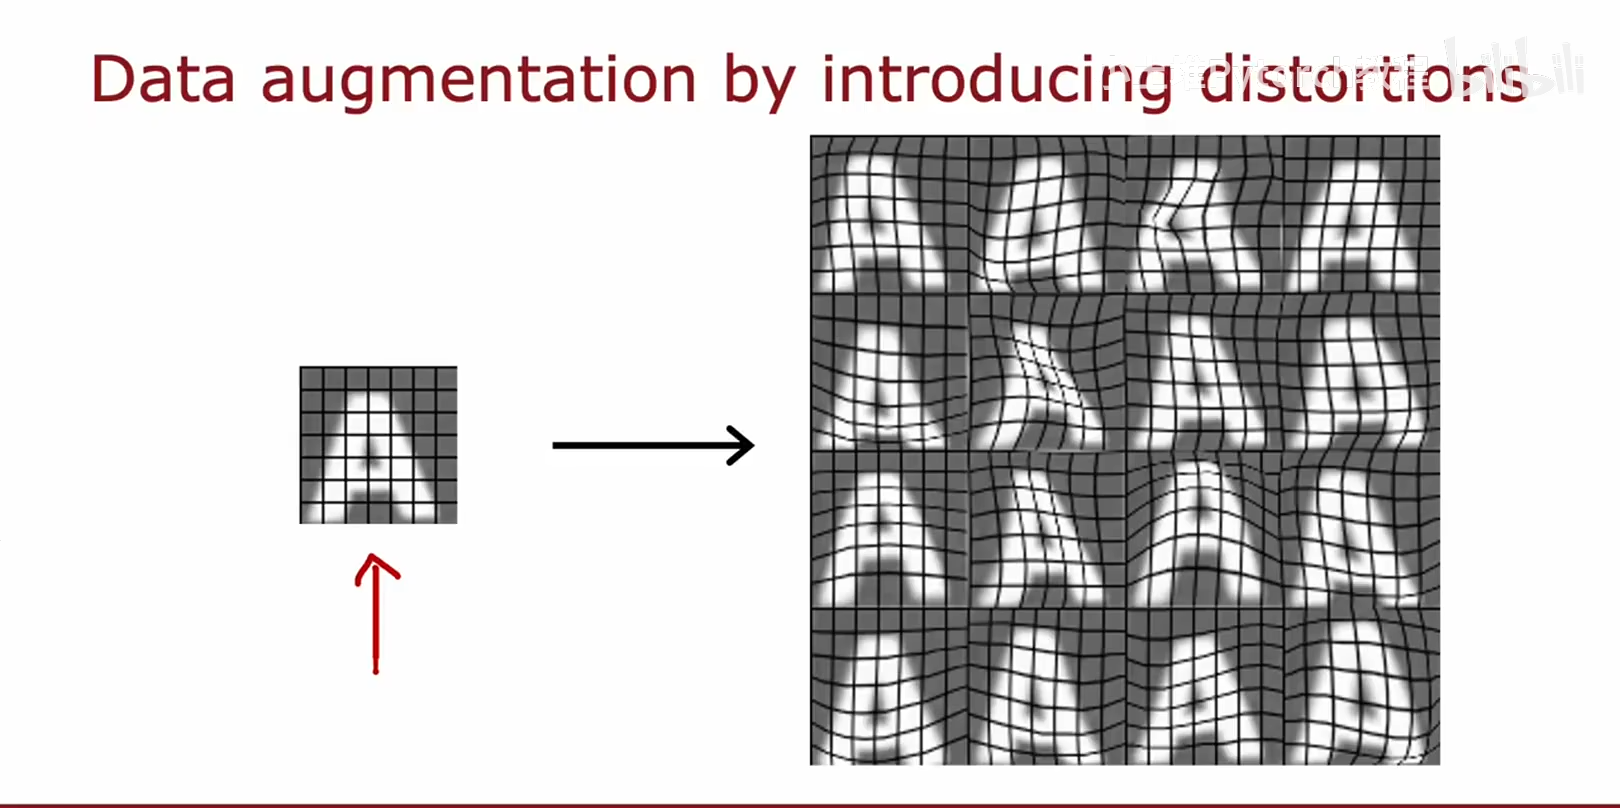
高阶一点的对图像A进行变换,我们就得到了一组A的训练数据

通过这一点可以告诉算法,旋转了一点,或者放大缩小变换换,这个依然是A

对于音频我们可以叠加白噪音,
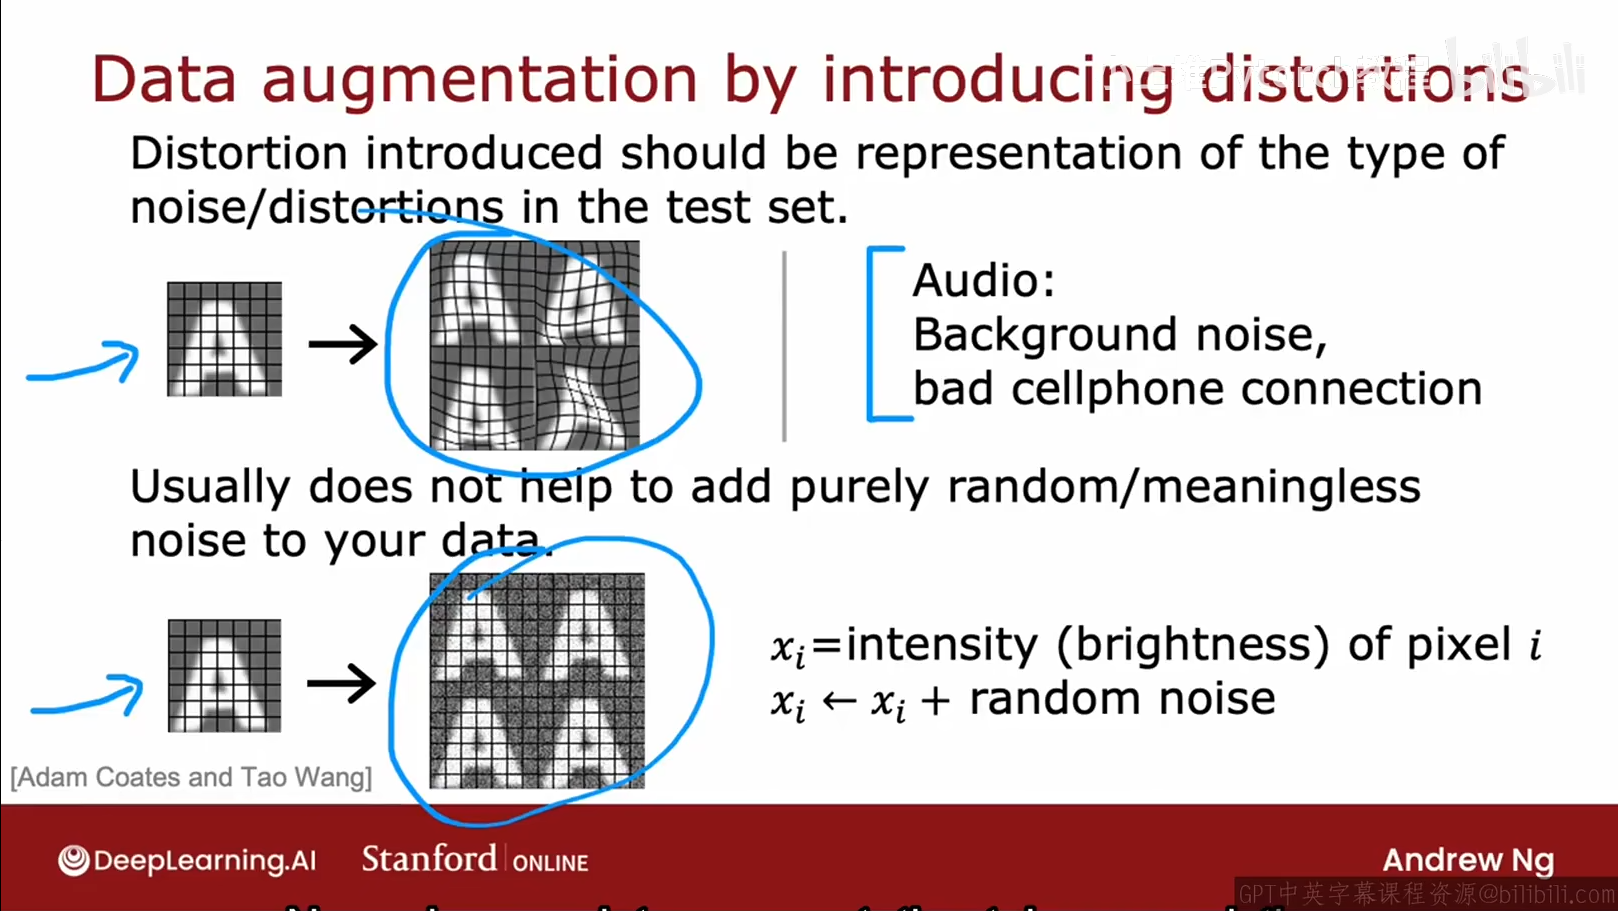
但是也不是什么数据都增加的,如果我们在图片中增加白噪点,几乎没什么,现实问题中,也不会遇到这种情况的问题,

还有一种技术是数据合成,从头开始从0到1的创建全新的样本,不是修改现有的样本,而是创建全新的样本,
相关推荐
泯泷31 分钟前
别再傻傻地喂文件了,大厂都在偷偷给AI建这种“专属图书馆”
人工智能
oak隔壁找我1 小时前
一款运行在 DSH(DeepSeek Harness)中的类 Postman HTTP 接口调试插件
人工智能·程序员
高洁011 小时前
数字孪生与计算机视觉:让机器看懂现场
人工智能·python·机器学习·transformer·迁移学习
Csvn2 小时前
如果明天供应商涨价 3 倍?三层解耦,换模型只改一行配置(C05)
人工智能·aigc·agent
在所不辞兄2 小时前
为什么数字孪生驱动的产线标定需要在线更新机制,而不能一次标定后长期沿用?
人工智能·神经网络·其他·算法·机器学习
锋行天下3 小时前
langgraph 全栈项目(三)
前端·人工智能·后端
黄啊码3 小时前
【黄啊码】最近面了十几个想转 FDE 的程序员,一个都没招
人工智能
锋行天下4 小时前
langgraph 全栈项目(二)
前端·人工智能·后端
大模型真好玩4 小时前
用 Seedance 2.5 Flash 实现1分钟AI短剧,满足孩子的超级英雄对战梦
人工智能·aigc·deepseek
FengY_HYY4 小时前
从人类组织到人类&大模型组织,我的位置在哪里?
人工智能·程序员·llm