目录
- [1 RAG 完整原理与优缺点](#1 RAG 完整原理与优缺点)
-
- [1.1 大模型原生三大缺陷](#1.1 大模型原生三大缺陷)
- [1.2 RAG 概念](#1.2 RAG 概念)
- [1.3 RAG 优缺点](#1.3 RAG 优缺点)
- [1.4 RAG 两大阶段](#1.4 RAG 两大阶段)
- [2 文档加载器 Loader](#2 文档加载器 Loader)
-
- [2.1 Markdown 加载](#2.1 Markdown 加载)
- [2.2 Word Docx 加载](#2.2 Word Docx 加载)
- [2.3 PDF 专业解析 MinerU](#2.3 PDF 专业解析 MinerU)
- [3 文本切分 RecursiveCharacterTextSplitter](#3 文本切分 RecursiveCharacterTextSplitter)
-
- [3.1 为什么必须切片](#3.1 为什么必须切片)
- [3.2 切分策略对比](#3.2 切分策略对比)
- [3.3 代码实战](#3.3 代码实战)
- [4 Embedding 文本嵌入](#4 Embedding 文本嵌入)
-
- [4.1 嵌入模型作用](#4.1 嵌入模型作用)
- [4.2 主流开源嵌入模型](#4.2 主流开源嵌入模型)
- [4.3 LangChain 本地嵌入调用](#4.3 LangChain 本地嵌入调用)
- [5 本章小结](#5 本章小结)
1 RAG 完整原理与优缺点
1.1 大模型原生三大缺陷
1 知识截止,无法获取实时 / 私有资料 2 专业领域知识缺失,容易幻觉编造 3 长文本输入效果衰减,上下文利用率低
1.2 RAG 概念
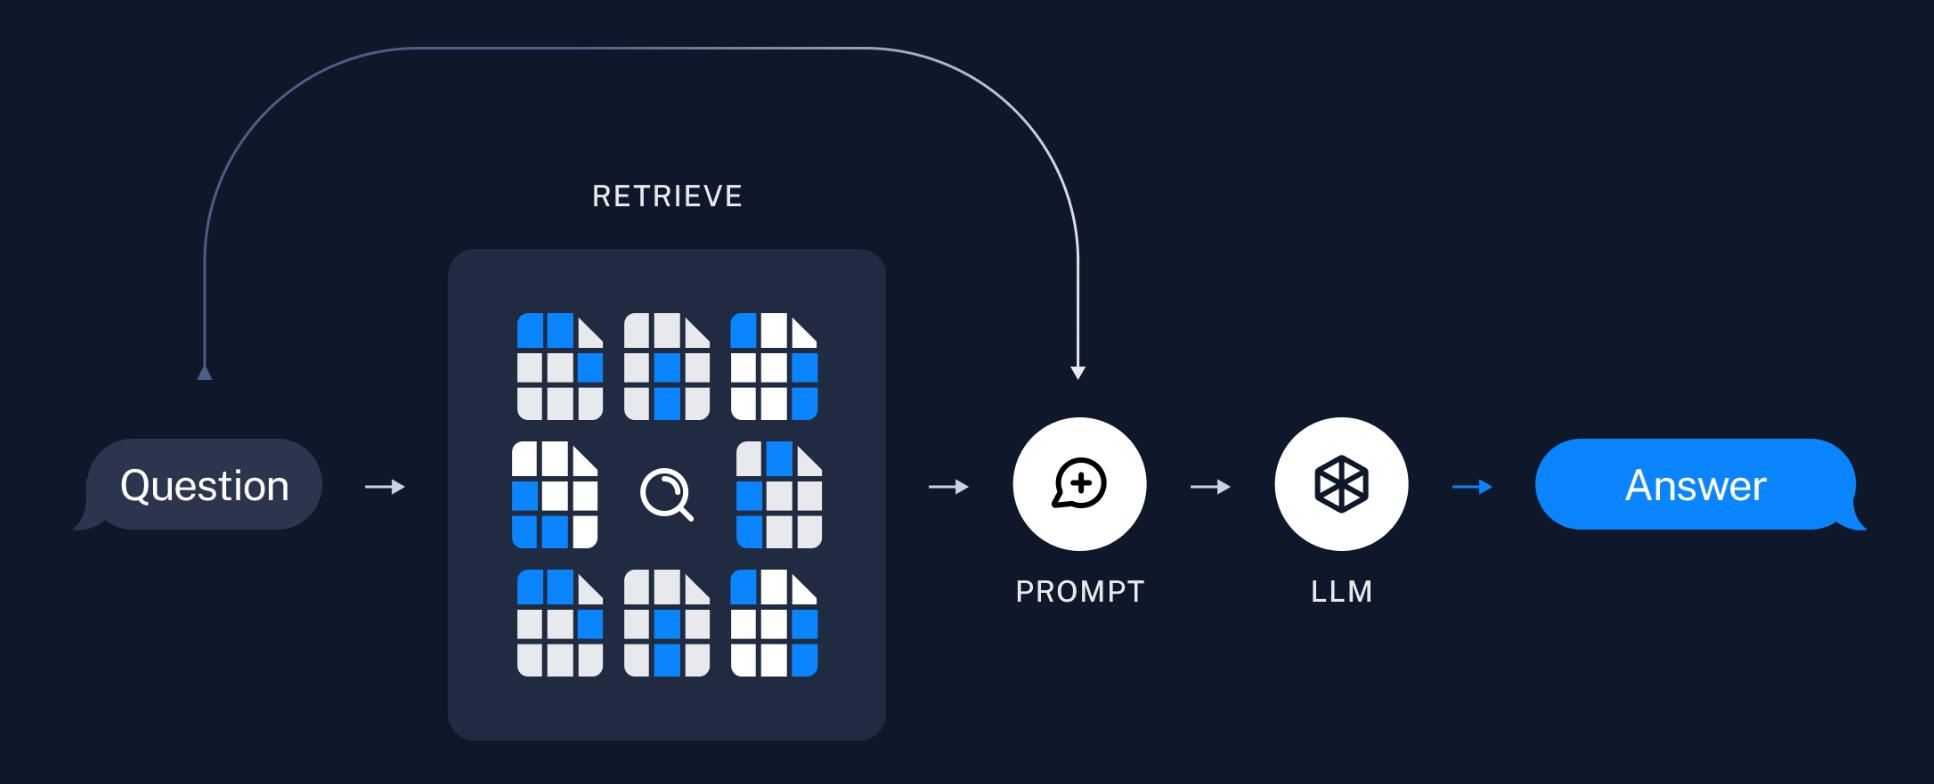
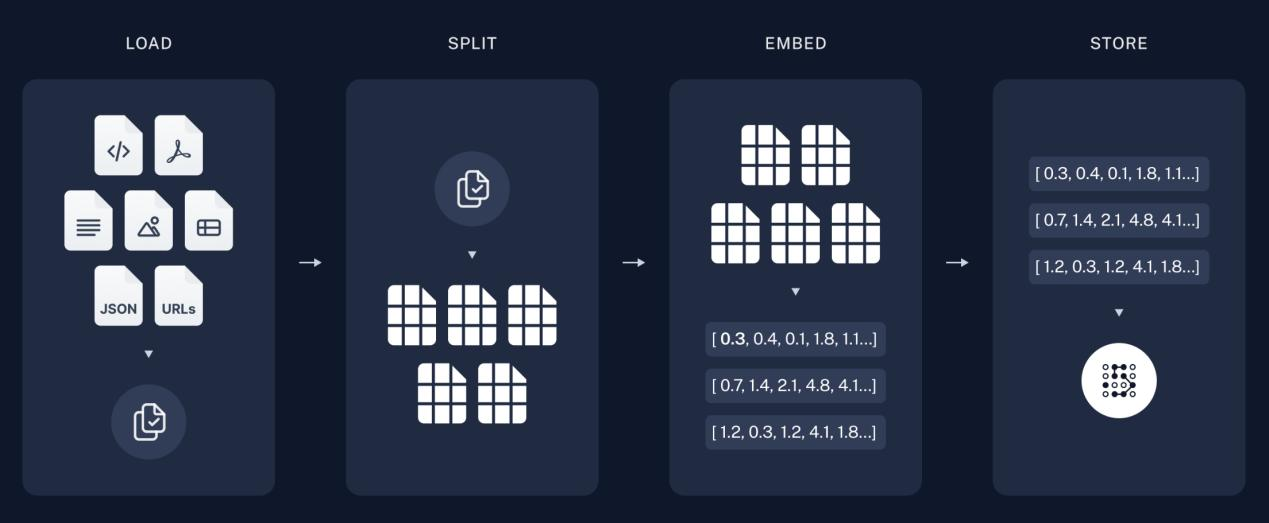
检索增强生成:先检索私有文档,把相关片段塞进 Prompt 再交给 LLM 回答
1.3 RAG 优缺点
优点: 1 不用微调,低成本更新知识库 2 答案可溯源,大幅降低幻觉 3 数据不用送入模型训练,保护隐私 缺点: 1 多一步检索,接口延迟升高 2 检索质量直接决定回答准确性
1.4 RAG 两大阶段
1 索引阶段:加载文档 → 切片 → 向量化 → 存入向量库 2 问答阶段:问题向量化 → 相似检索 → 拼接上下文 → LLM 生成
2 文档加载器 Loader
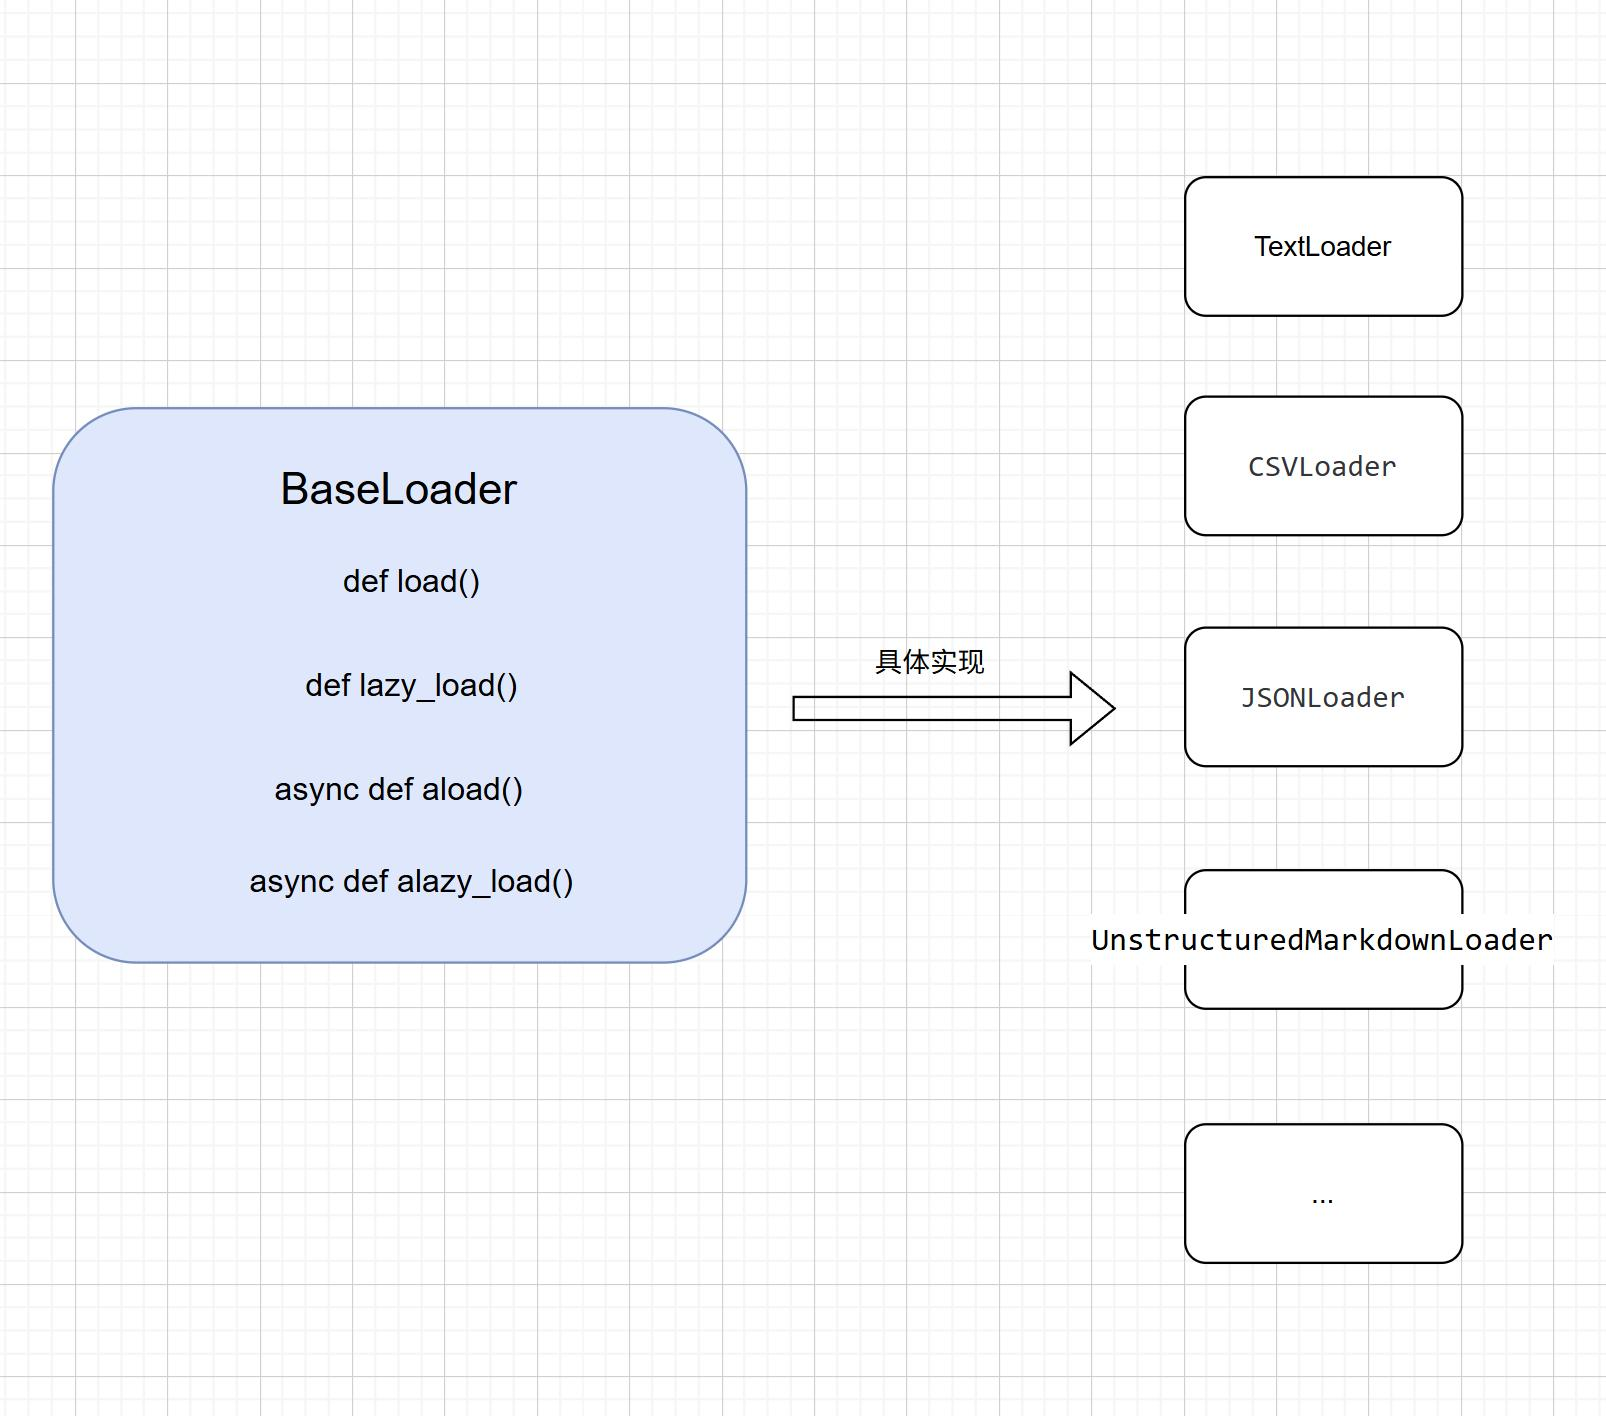
所有加载器统一接口load()/lazy_load(),输出 Document 对象(page_content 文本 + metadata 元数据)
2.1 Markdown 加载
python
pip install unstructured[md]
from langchain_community.document_loaders import UnstructuredMarkdownLoader
loader = UnstructuredMarkdown("./test.md",mode="elements")
docs = loader.load()
2.2 Word Docx 加载
python
from langchain_community.document_loaders import UnstructuredWordDocumentLoader
loader = UnstructuredWordDocument("demo.docx",mode="elements")
2.3 PDF 专业解析 MinerU
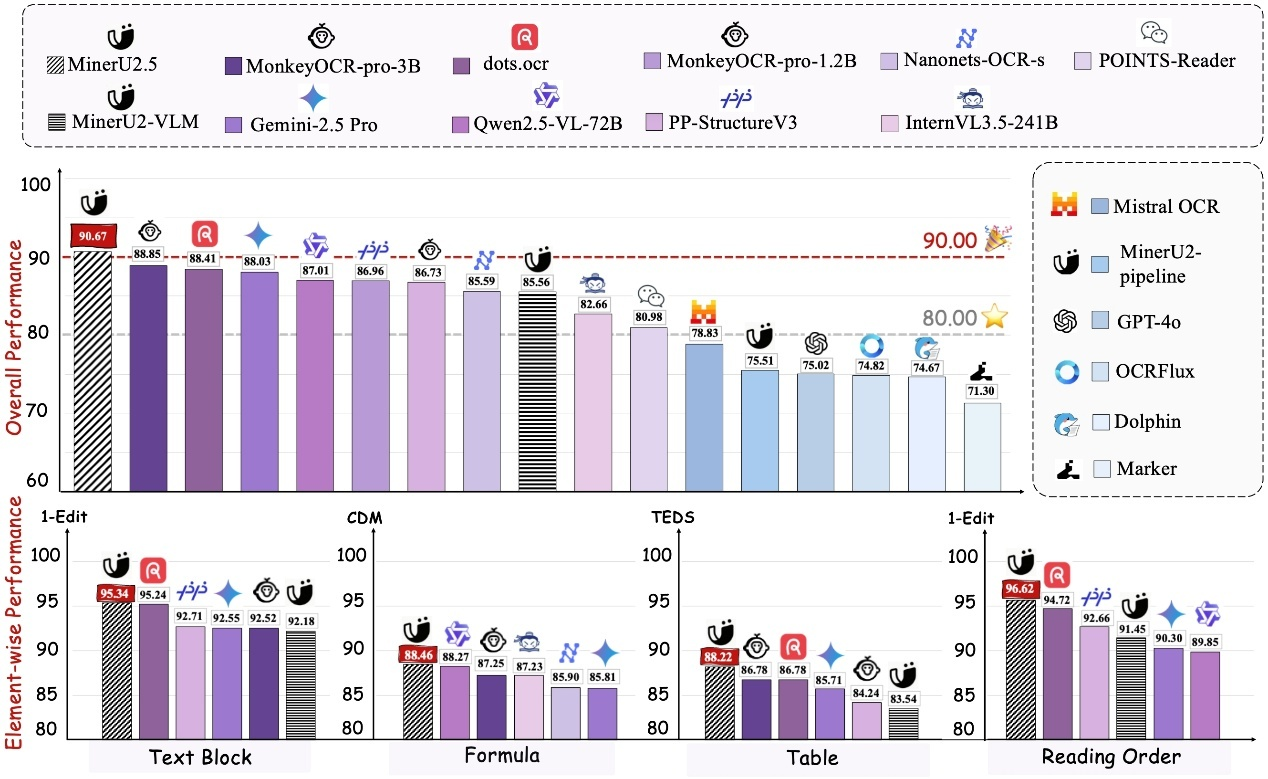
普通加载器无法识别表格、公式、双栏 PDF,MinerU 转为标准 Markdown 1 调用官方 API 上传 PDF 2 获取解析后 MD 文本再切片
3 文本切分 RecursiveCharacterTextSplitter
3.1 为什么必须切片
1 模型有最大 token 限制,超长文本截断丢失信息 2 完整文档噪声多,检索无关内容干扰答案
3.2 切分策略对比
1 固定字符切分:容易切断句子,语义断裂 2 递归分隔符切分(推荐):优先按段落、句号分割,保证语义完整 3 语义切分:按向量距离分割,效果好但速度慢
3.3 代码实战
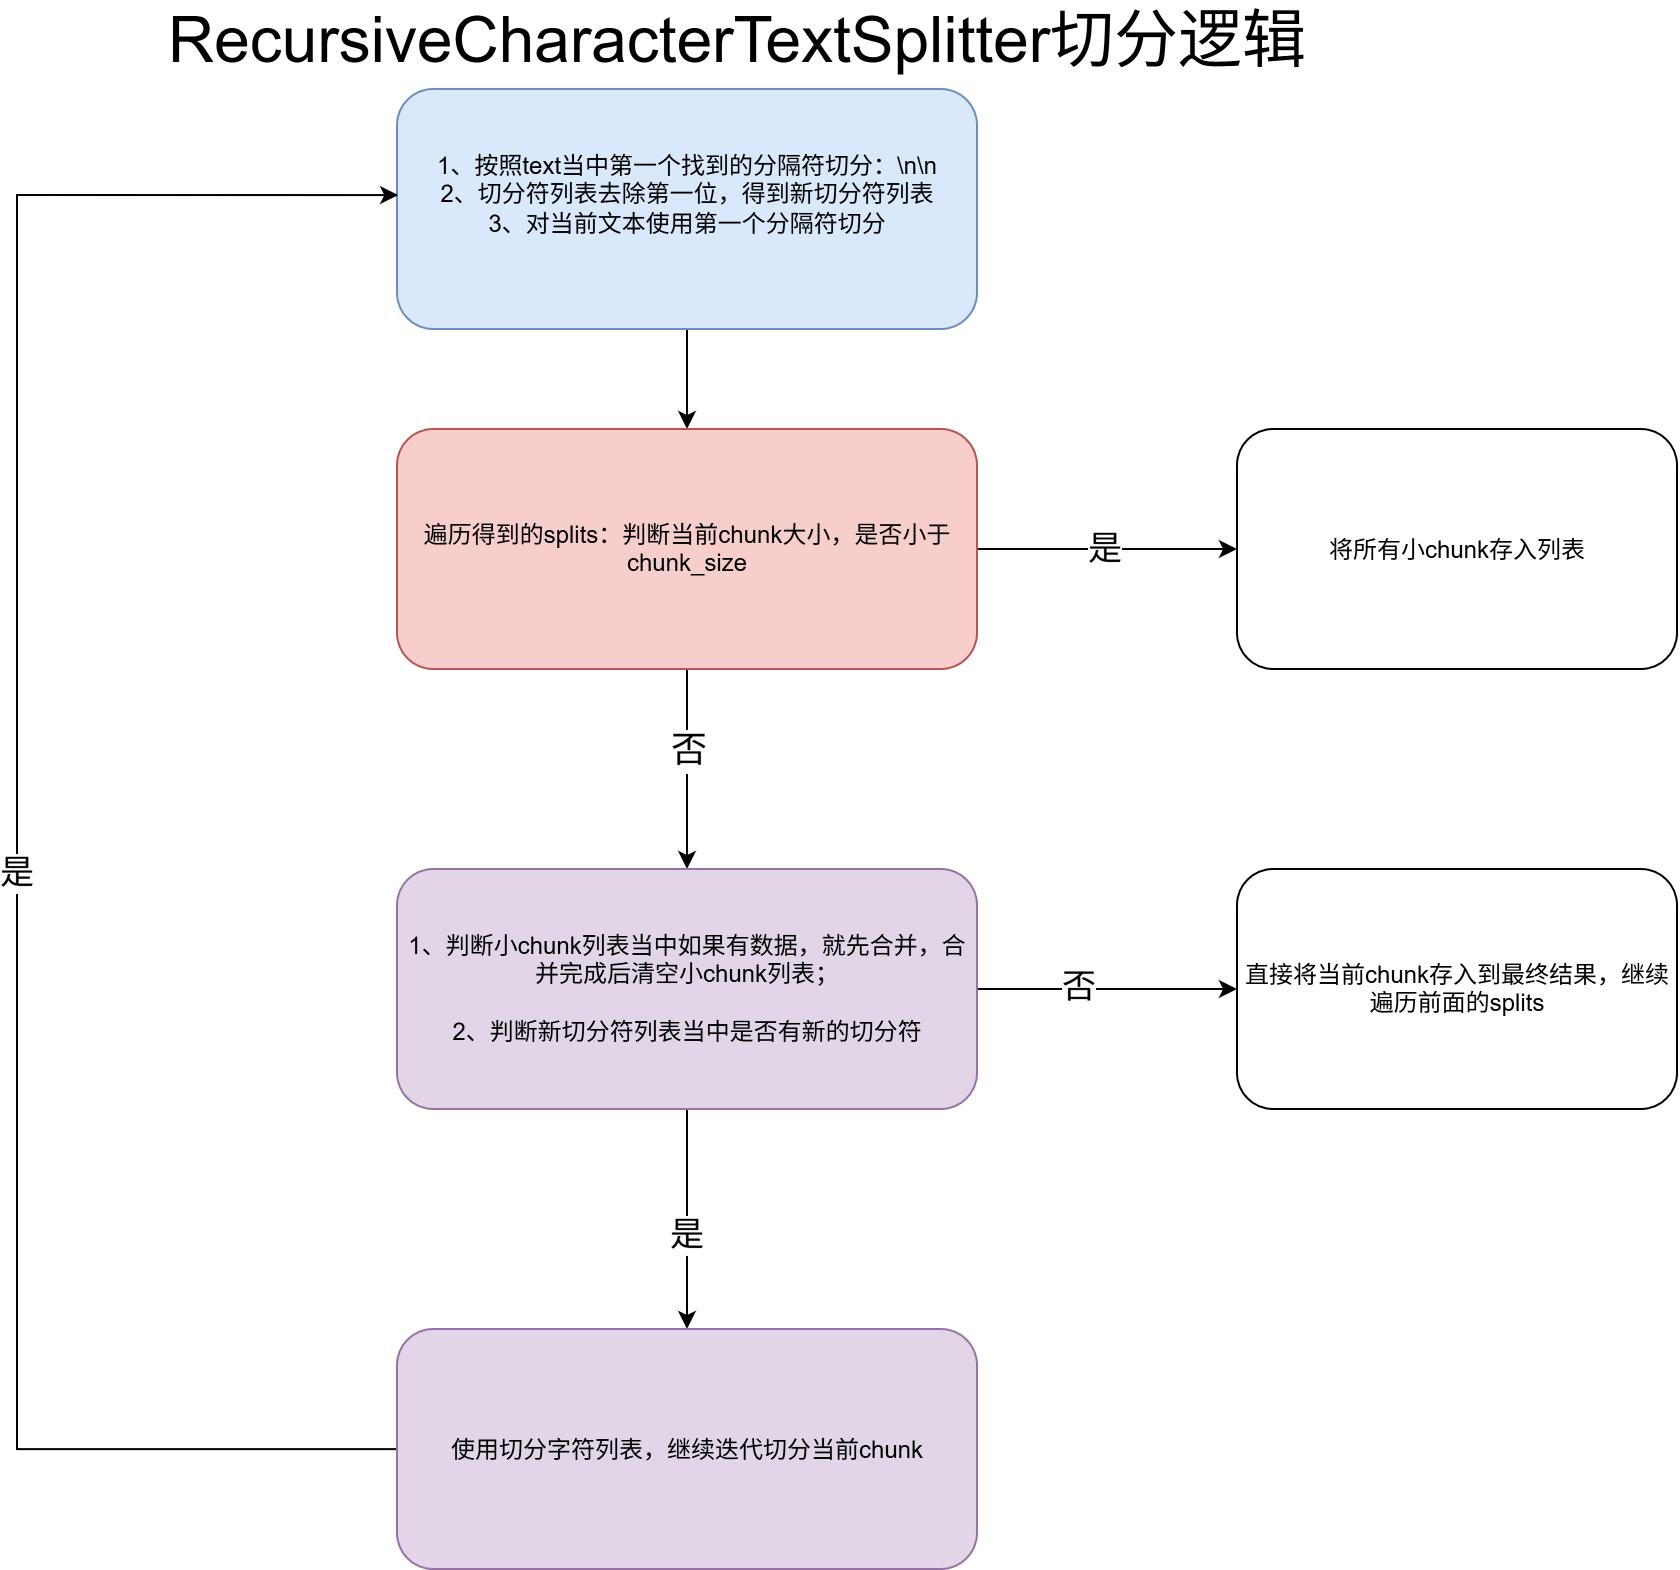
python
from langchain_text_splitters import RecursiveCharacterTextSplitter
splitter = RecursiveCharacterTextSplitter(
    separators=["\n\n","\n","。","!","?"],
    chunk_size=400,
    chunk_overlap=50 # 块重叠,解决段落分割丢失上下文
)
chunks = splitter.split_documents(docs)
4 Embedding 文本嵌入
4.1 嵌入模型作用
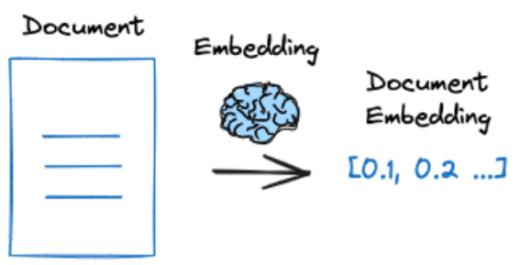
文本转为多维浮点向量,语义相近向量距离近,用于相似度检索
4.2 主流开源嵌入模型
表格
| 模型 | 特点 |
|---|---|
| BGE-small/base/large-zh | 中文最优轻量模型 |
| BGE-M3 | 支持稠密 + 稀疏双向量 |
| text-embedding 系列 | OpenAI 付费向量 |
4.3 LangChain 本地嵌入调用
python
pip install langchain-huggingface sentence-transformers
from langchain_huggingface import HuggingFaceEmbeddings
embed = HuggingFaceEmbeddings(model_name="./bge-base-zh-v1.5")
vec = embed.embed_query("大模型RAG")
5 本章小结
1 RAG 分为「建索引」和「问答」两大流程 2 Loader 支持 MD/DOCX/PDF,复杂 PDF 优先 MinerU 3 RecursiveCharacterTextSplitter 是工业标准切片工具,chunk_overlap 防止语义断裂 4 Embedding 将文本转为向量,是向量检索基础