我是饼干哥哥,我的十年数据分析经验又派上用场了。
我把这些经验打包进 4 个 VOC Skill,用 Codex 自动跑完从抓取、打标、统计到出报告的全流程:
以「宠物安神咬胶」为例,从 Amazon、Reddit、X 甚至加上 TikTok、YouTube、Facebook 等多平台,抓取了 4185 条真实评论,打一次标就能回答选品、竞品、卖点、内容、复盘、跨市场六种业务场景的问题。
我可爱吗?
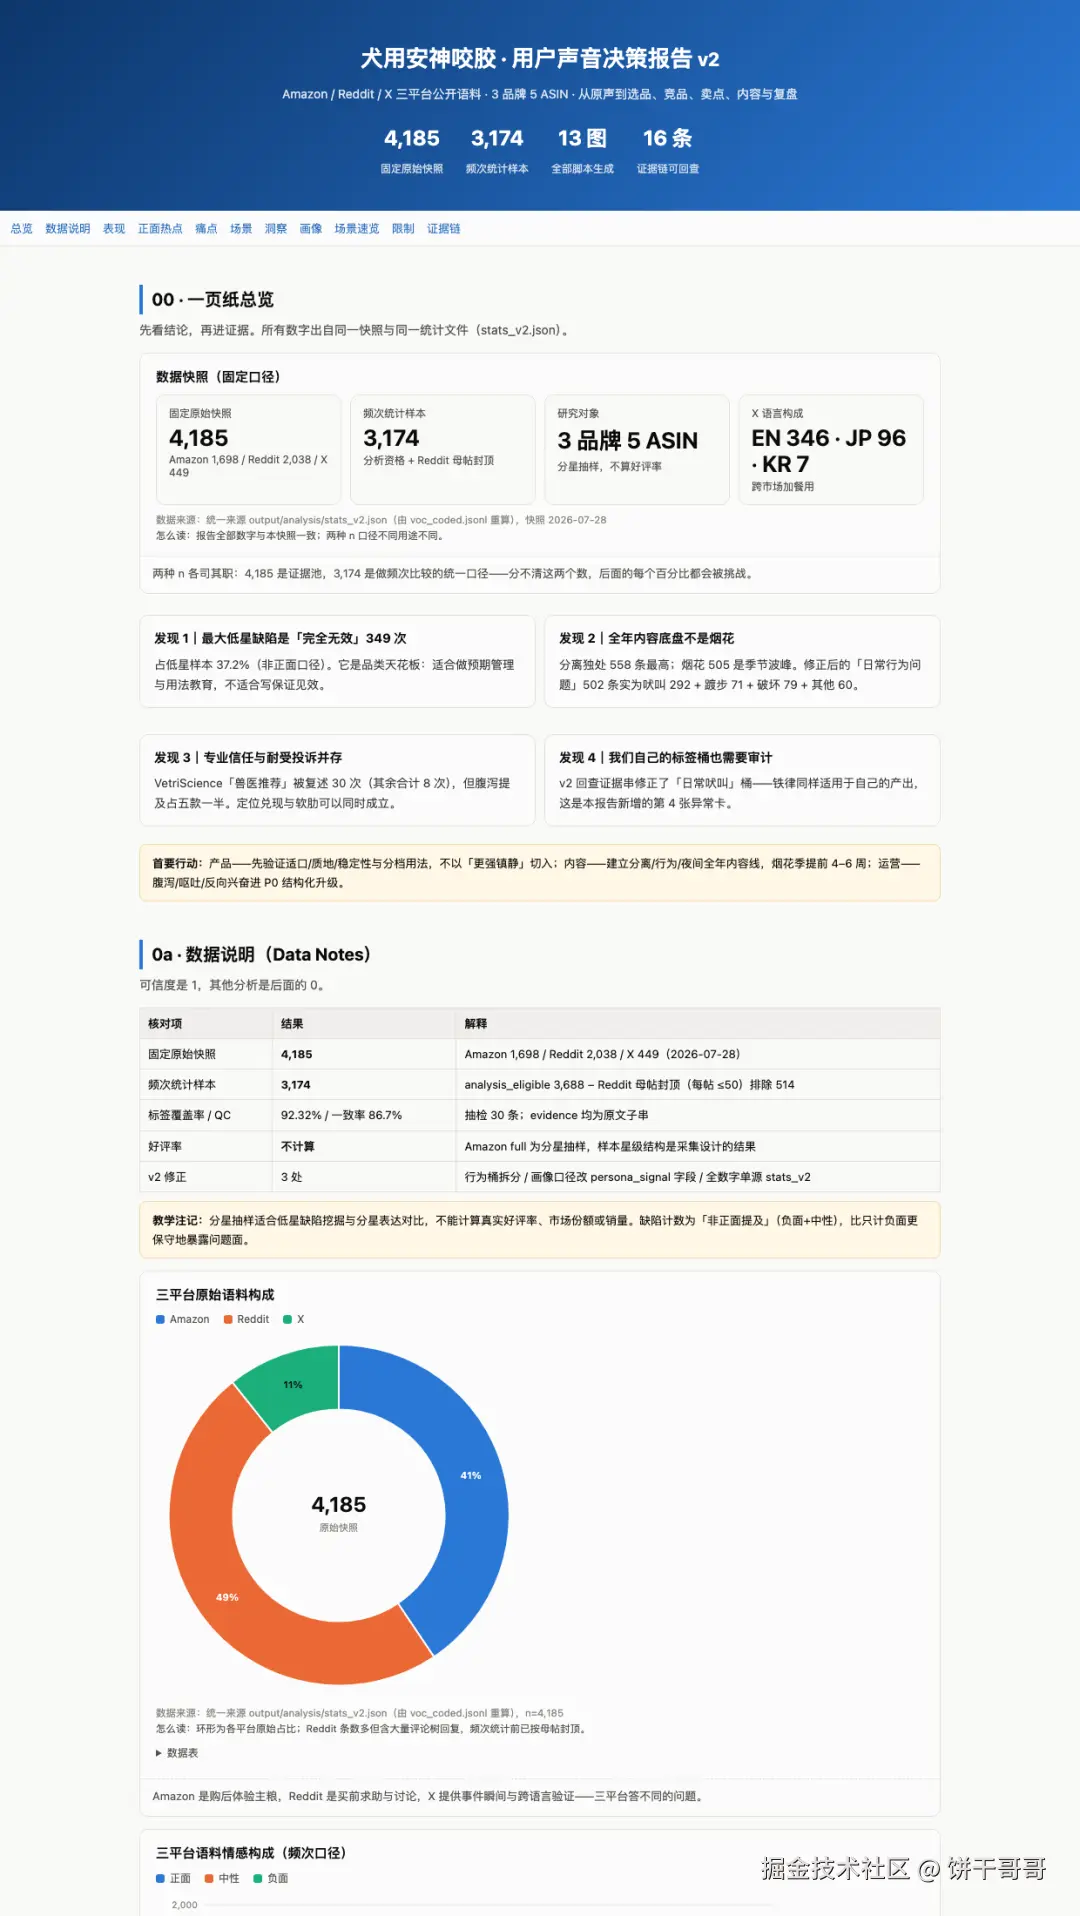
报告首屏
这已经是 3.0 版本了。
之前出过VOC 分析的1.0、2.0 教程,很多人一落地就出问题:流程没法复用,换个品类重开;数据越来越难抓,平台反爬一轮比一轮严,全靠人工截图了。
VOC's 旧版文章指路:
9000字落地实操:AI做用户购后评论洞察分析
Reddit VOC调研太慢?搭一个AI专家团队半小时洞察任何品类|以猫用饮水机为例
所以进化成 3.0 就是来解决这些问题的。上周轮到我给圈子直播,正好讲了这个内容。
配上我的至尊海报
被催上播,我已急哭
直播结束后甚至有圈友说把我蒸馏了哈哈哈。
接下来给大家复盘下我是怎么做的。
01
跑完 4185 条评论,最终交付长这样
先了解下品类。
犬用安神咬胶,是给狗吃的安神软零食,让狗在烟花、雷暴、独处这些高压场景下镇定下来。
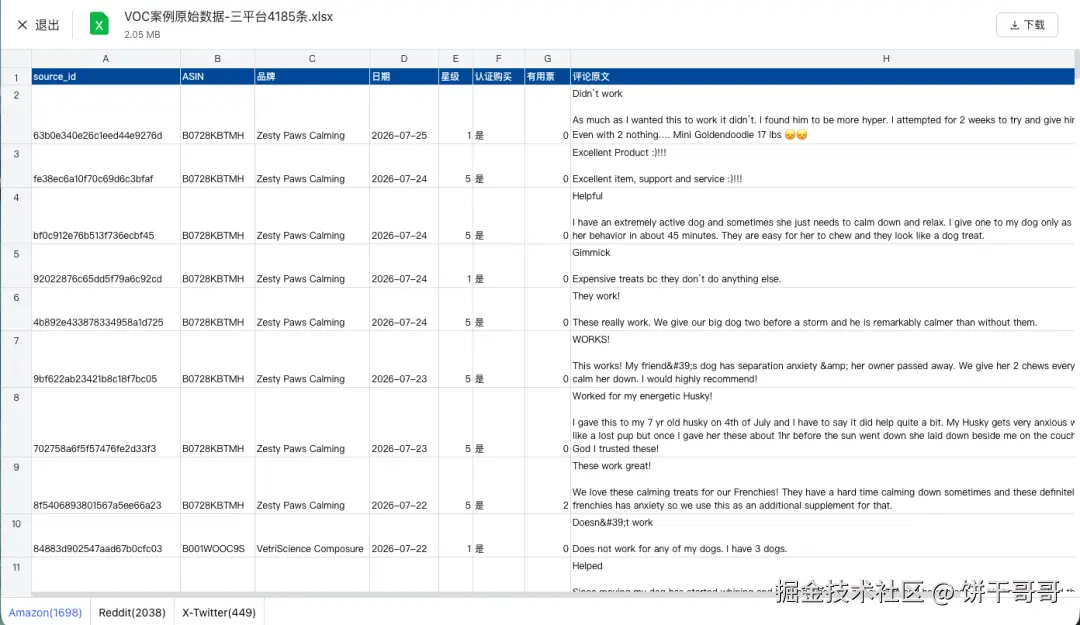
我选了三个品牌、五个 ASIN、Amazon、Reddit、X 三个平台让 Codex 一起抓。
开始前,把下面这段提示词丢给 Codex:
Plain Text
为【产品/品类】做 VOC 数据采集,目标市场【美区】。 已安装 bggg-data-amazon / bggg-data-reddit / bggg-data-x 三个 skill,按各 SKILL.md 执行: 1. Amazon:ASIN 清单【3-8 个】,重点款 full 模式,逐次留档 + 失败重试 2. Reddit:核心关键词搜索 + 高赞帖完整评论树,病毒帖按母帖 ≤50 封顶 3. X:关键词搜索,只读渲染页面,滚动到量即停 统一格式:source_id / 日期 / 原文 / 星级或互动 / 来源 URL 红线:不绕验证码、不越权、不伪造
最终抓回来原始数据 4185 条。剔掉跑题的、纯推广的,剩 3688 条进入分析。Reddit 病毒帖封顶处理完,最后拿来做统计的是 3174 条。
跑完最终交付出来一份 HTML 报告。
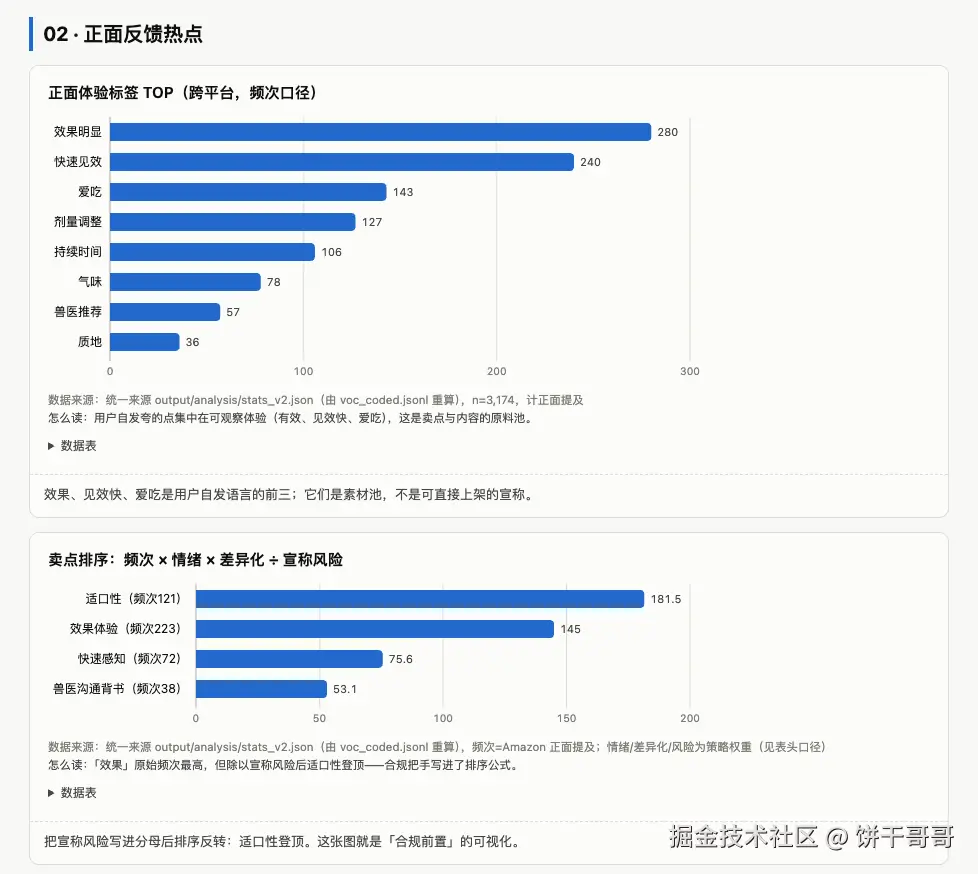
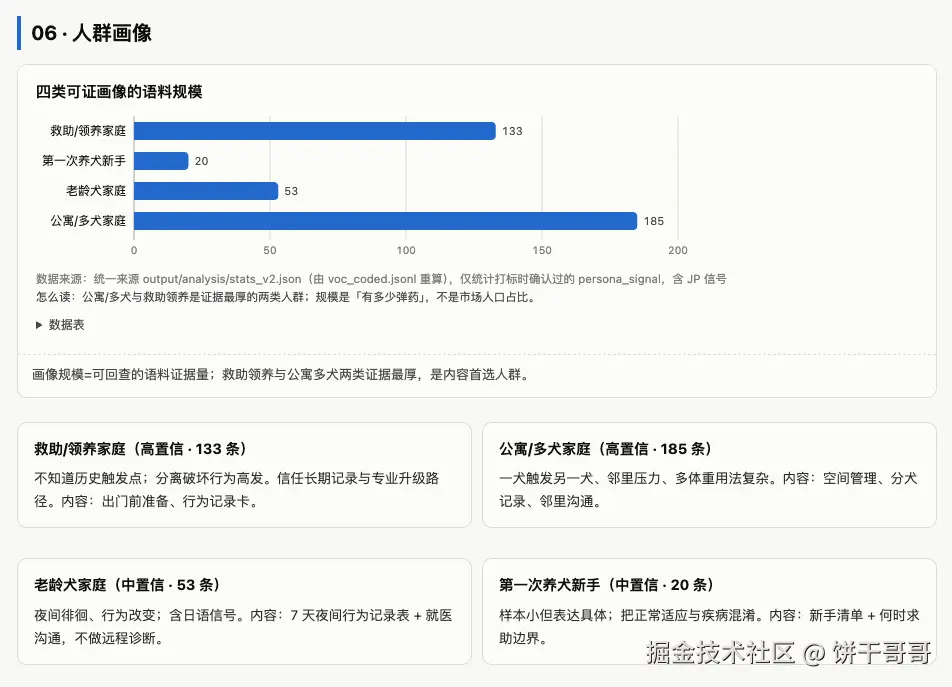
完整报告包含:
-
一页纸总览
-
数据说明
-
正面热点与痛点排序
-
异常信号卡
-
用户画像
-
证据链
-
可视化图表
并且所有结论都能用 source_id 回查到原始评论。
那这条工作流是怎么搭的呢。
02
一条完整的 VOC 生产线,怎么搭?
先看整体框架。
整条线一共七步:评论抓取 → 数据清洗 → 打标签 → 跑统计 → 场景分析 → 出报告 → 落决策。
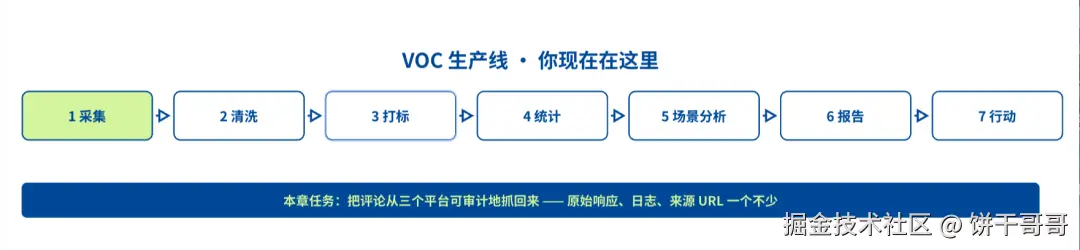
一般人做 VOC 不规范的流程是这样的:评论抓完后直接全丢给 AI。(看看是不是你「狗头」)
但 AI 是有幻觉的,出来的东西看似颇有道理,实则错漏百出:数字是不是真的?出现了多少次?是哪个品牌的?原文在哪条?明天再跑一遍结论还一样吗?全都经不起问。
所以 VOC 真正要做的事不是让 AI「看评论」,是把评论变成可以计算的东西,所以这里需要打标签。
那标签怎么设计?
我用的是四大用户价值层级,一级标签固定四个:
人群场景:谁、在什么时候、被什么触发 ?
功能价值:有没有效果、多快、多久 ?
保障价值:安不安全、稳不稳定、有没有专业背书 ?
体验价值:好不好用、值不值、情绪上感受怎么样 ?
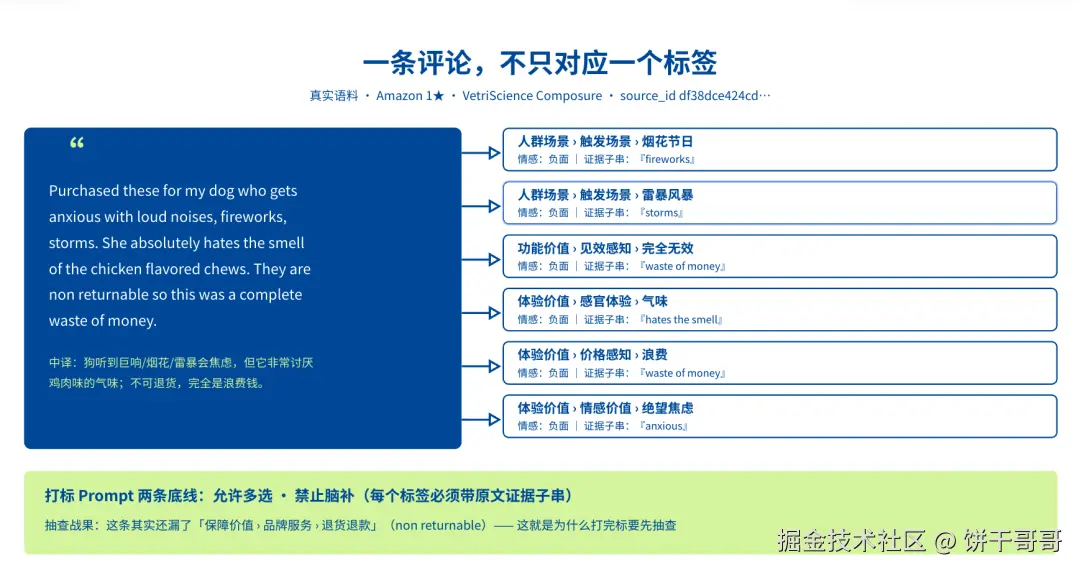
一级固定,二三级根据实际评论生成。
整个标签体系的生成规则放这里,直接改品类名就行:
Plain Text
你是资深 VOC 分析师。读取评论样本 150 条。 为「你的品类」构建三级标签体系: 1. 一级标签固定四个:人群场景 / 功能价值 / 保障价值 / 体验价值 2. 二级是关注领域,三级是可统计的具体表达,名称 ≤5 个汉字 3. 标签客观不含情感词(「气味」可以,「难闻气味」不行) 4. 每个三级标签附一句判定说明 5. 输出 JSON 6. 生成后停下来等人工校准,不要直接打标
03
用 AI 做 VOC 自动化的几个 Tips
整个 VOC 流程我还做了一份文档给圈友,这里单独拎几个Tips说一下。
Tip 1 - 数据抓取
现在评论越来越难抓,讲几个要点。
反爬太严格?用 Computer Use,AI 操作真实浏览器,像人一样滚动翻页。
爬太慢? 两个办法:一个是多线程并发;一个是用子 Agent,Codex 可以同时开 6 个。
Reddit 抓不到?走 Old Reddit , 帖子 URL 后面加 .json 直接拿结构化数据。
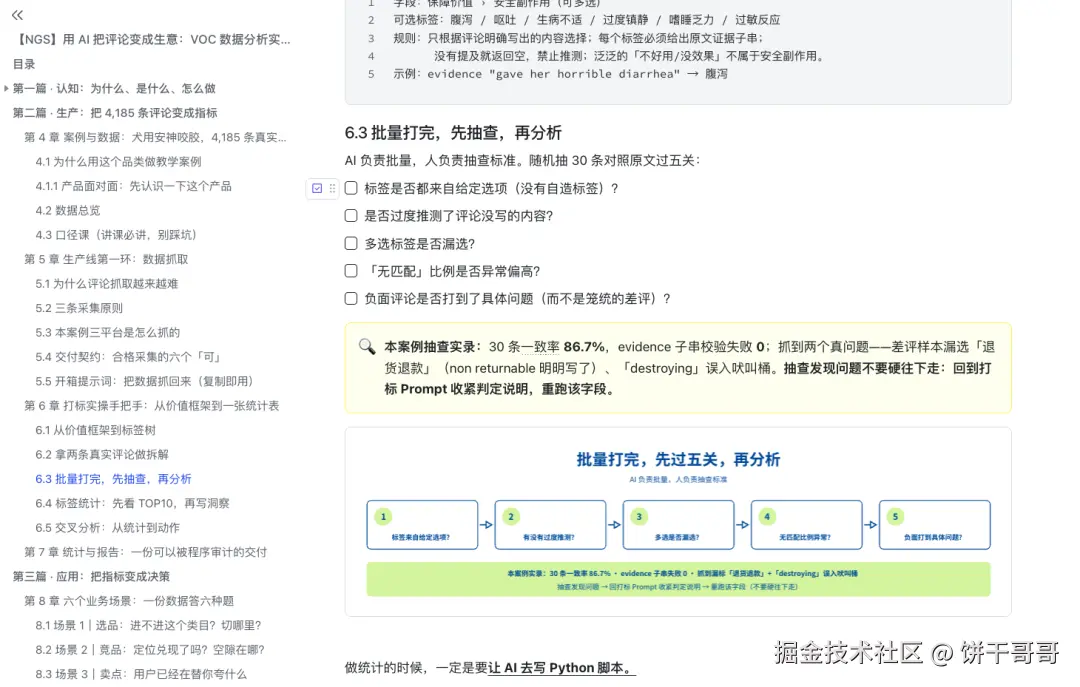
Tip 2 - 打标需要抽查
AI 打标不能直接信。
我们抽了 30 条复核,发现「destroying」拆家被打进了「日常吠叫」;还有差评明明写了 "non returnable",但「退货退款」标签漏选了。
Tip 3 - 统计必须用 Python 脚本
我测过,让 AI 直接读表格做统计,出来的数字全是错的。让它写脚本跑准:
Plain Text
基于打标数据,用 Python 写脚本: 1. 三级标签频次 × 情感,输出 TOP20 2. 品牌 × 二级标签 × 情感交叉表 3. 低星子集的缺陷提及排序 4. 每张表带口径说明与 n
Tip 4 - 结论要有证据链
每个标签打的时候就挂上原文和 source_id。
比如报告里写「气味提及 126 次」,我也能一条一条翻回去确认看看。
04
工具会一直变,核心方法论不变。
从VOC 1.0 到 3.0,核心就一件事没变过:文本变标签,标签变指标,指标变决策。
变的只是它跑得更稳、更快、更自动。
而且这套东西也不只是做 VOC 才能用。舆情监控、客服工单、面试记录等等,只要你面前是一堆非结构化的文本,都是同一套逻辑。
后面还能怎么进化?
把决策后的真实结果再回收:哪些标签判断准了,哪些指标没有价值,再继续调整标签体系、指标权重和判断规则
跑一轮、校准一轮,就会越来越贴近真实业务。
当然,如果你手上也有类似的 Skill,可以直接用我的「饕餮.skill 」,把这 4 个 VOC Skill 吃了。
指路:我开发了一个「吃掉」别人Skill来升级的饕餮.Skill,现在免费开源
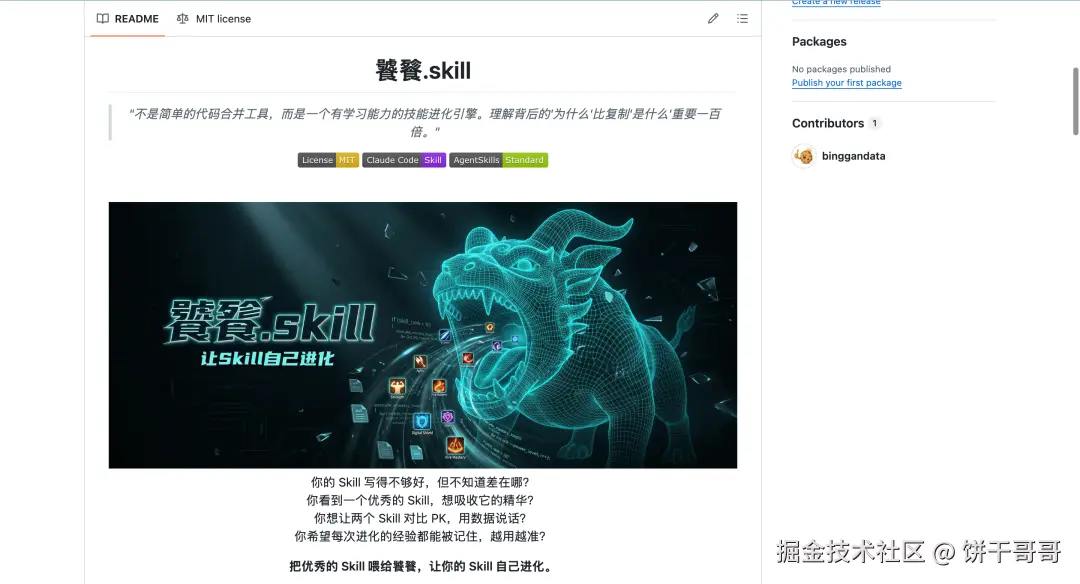
至于怎么吃得更香、消化得更好......可能就是下一期「饕餮.skill 2.0」了。
好的 skill 从来都迭代出来的!!