一、承接上篇:能力跑通后,真正的难题才开始
上篇我们立下了"本地可控"的 Flag,核心转换能力也跑通了。但真正把 PDF 转 Word 交给用户时,才发现"转得出来"和"转得准"之间,隔着一条巨大的鸿沟。
PDF↔Word 互转最难的,从来不是"转出来",而是"转得准"------版式错乱、表格和图片丢失,改出来的文档没法直接用;而 Office 转 PDF 又强依赖本机是否装了 Word/Excel,环境一变就崩,让人防不胜防。
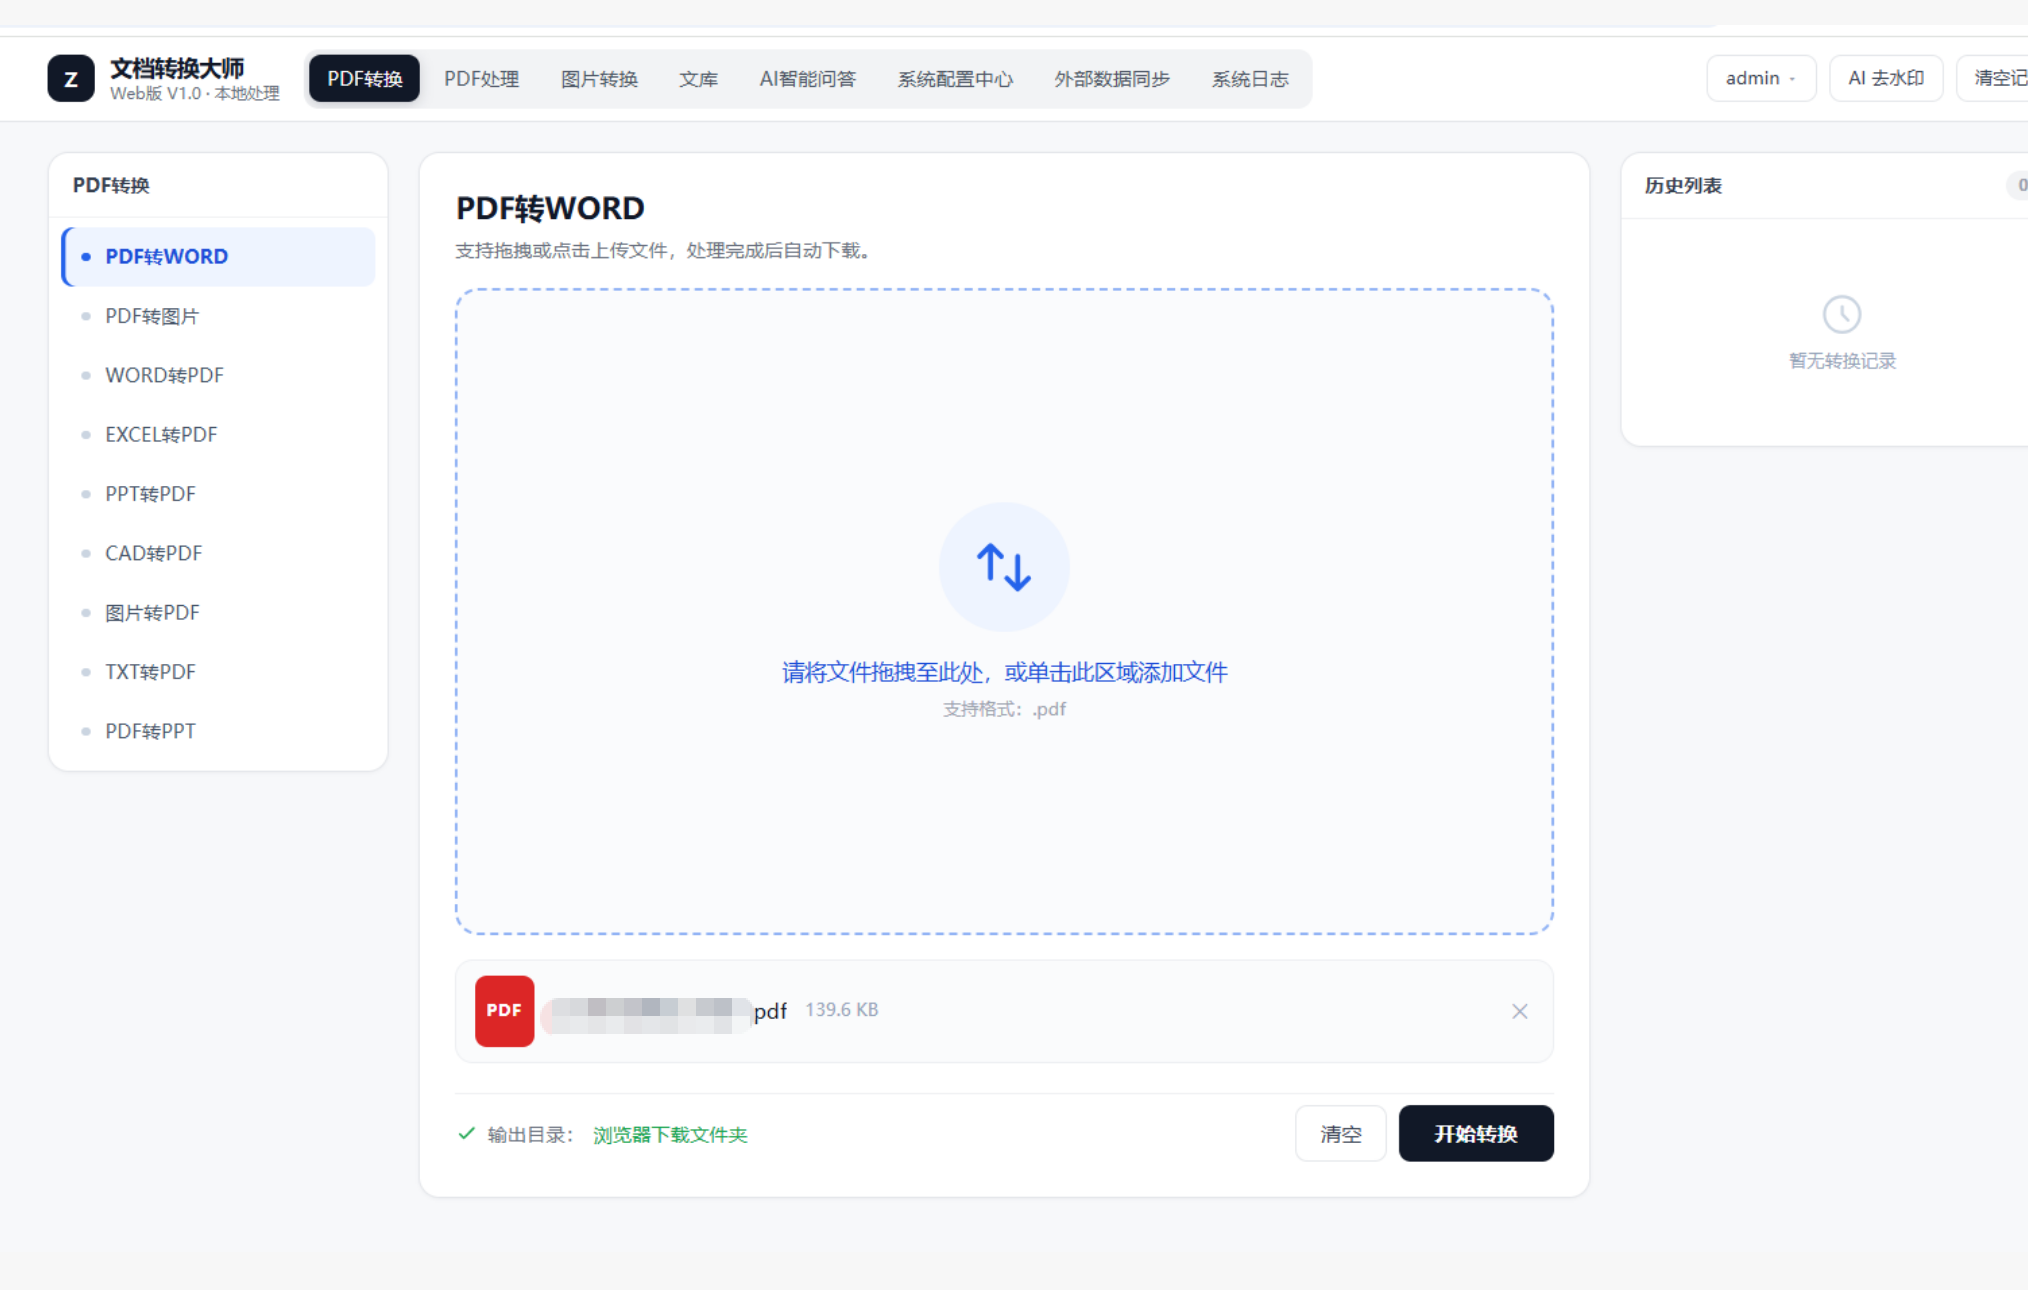
二、统一接口矩阵:18+ 转换能力
我们没有为每个格式写一个散落脚本,而是收敛成一套统一接口矩阵,覆盖日常绝大多数场景:pdf2word / pdf2image / pdf2pptx / word2pdf / excel2pdf / ppt2pdf / cad2pdf / image2pdf / txt2pdf / pdfmerge / pdfsplit / pdfcompress / pdfdecrypt / pdfdelete 等 18+ 接口。
背后的工程哲学是按格式选引擎、按环境做降级:
Office → PDF:Windows 上优先用 Word/Excel/PPT 的 COM 组件(保真度最高),一旦 COM 不可用就自动降级为文本 PDF,保证"至少能出"。
CAD(DXF)→ PDF:用 ezdxf 解析;DWG 则需本机安装 QCAD / LibreCAD 桥接。
PDF 拆分 / 合并 / 压缩 / 解密:全部基于 PyMuPDF,稳定且无需 Office 环境。
引擎选型一图看清:
转换需求 主引擎 降级 / 兜底 说明
Office → PDF Word/Excel/PPT COM 文本 PDF 保真优先
PDF → Word pdf2docx python-docx 重存 修兼容性
CAD → PDF ezdxf(DXF) QCAD/LibreCAD(DWG) 需本机软件
PDF 拆/合/压/解密 PyMuPDF --- 纯 Python
转换路由(示意):优先保真引擎,失败降级
def office_to_pdf(path):
if has_com(): # Windows + 装了 Office
return word_com_export(path) # 高保真
return text_pdf_fallback(path) # 降级:至少能出
三、踩坑实录:三个最典型的"假象"与修复
坑 1:pdf2docx 生成的 DOCX,Microsoft Word 打不开。 定位后发现是底层写入的 OOXML 结构不被桌面版 Word 兼容。修复方式是用 python-docx 重新打开并保存一次,做一次"标准化重存",问题消失。
坑 2:TXT → PDF 中文乱码。 根因是用了 .ttc 字体集合注册失败。改成注册 NotoSansSC / SimHei 这类独立 TTF 字体后,中文正常渲染。
坑 3:改了代码,修复却"未生效"。 排查半天才发现是旧的 Uvicorn 进程还驻留在内存里,新代码根本没被加载。我们因此补了一个一键重启脚本,确保每次改动都从干净进程启动。
工程取舍:为什么按格式选引擎
不同格式的内部结构差异巨大:PDF 是版式描述语言,Office 是打包的 XML,CAD 是矢量图元,没有哪种单一库能通吃且保真。因此我们坚持"按格式挑最成熟的库"------PyMuPDF 管 PDF 底层、pdf2docx 做版式还原、python-pptx 处理演示文稿、ezdxf 解析 CAD。与其赌一个万能转换器,不如把每个格式交给它最擅长的引擎。
Office 转 PDF 一律 Windows COM 优先,是因为装了 Office 时,Word/Excel/PPT 自己导出的保真度最高;COM 不可用才降级为文本 PDF,保证"至少能出"。CAD 的 DXF 用 ezdxf 即可,DWG 则需本机 QCAD / LibreCAD 桥接------这类强依赖本机软件的格式,我们明确标注前置条件,而不是假装全自动。
对制造企业、检测机构和法务部门来说,转不准就等于白转。质检单转完表格错位,还得人工重排;合同转完图片丢失,连法律效力都受质疑。所以保真不是锦上添花,而是能不能上线的底线。这也解释了为什么我们宁可把引擎按格式拆开维护,也不凑一个粗糙的万能转换。再往深里说,本地离线跑还有一个隐性好处:批量任务不必担心云端限速,哪怕几百份合同,一个晚上也能安静转完,文件还始终留在自己机器上。
等转换稳定了,后面的电子签章、去水印、智能问答才有可靠的原材料可用;没有这一步打底,上层功能再花哨也是空中楼阁。这也是本系列把格式互转放在第一篇的原因:它决定了文档能不能被后续环节放心消费。对使用者而言,最直观的感受是------丢进去一份排版复杂的合同,出来的 Word 还能直接改、表格不散、图片不丢,这才叫真的转准了。我们在内部对比过,同样的百页技术手册,云端工具要么限速要么丢图,本地引擎一次性跑完且版式完整,这种确定性是企业敢把文档交过来的前提。
本阶段使用建议
批量转 Office 前,确认本机已安装对应 Office 组件,COM 路径最稳;
遇到 pdf2docx 产出的 DOCX 在 Word 打不开,用 python-docx 重存一次即可修复;
TXT 转 PDF 务必注册 NotoSansSC / SimHei 这类独立 TTF,避开 .ttc 集合字体坑;
改完代码若"修复未生效",先跑一键重启脚本清掉驻留的旧 Uvicorn 进程;
PDF 的拆分 / 合并 / 压缩 / 解密走 PyMuPDF,无需 Office 环境,最省心。
四、小结
格式互转的保真度,决定了一个文档工具能不能被企业真正用起来。统一接口 + 引擎择优 + 自动降级,让我们在不依赖"云"的前提下,把转换成功率拉到了可用水平。
下期预告:格式转准了,企业还有个高频刚需------盖章。质检中心每天要盖 500--600 个章,全靠人工找位置、对页码、落章、检查,耗时长还易错。下一篇讲电子签章与批量盖章。
标签:#PDF转Word #PyMuPDF #LibreOffice #格式转换 #文档处理