传统文生视频模型推理动辄几十秒,Hao AI Lab 开源 FastVideo 框架,搭配 VSA 稀疏注意力、QAD 量化蒸馏,消费显卡也能实现 1.8 秒快速出片。
当下主流 Wan 等视频模型普遍存在推理速度慢、显存占用极高的痛点,720P 短视频单卡常需一两分钟生成,只能依赖昂贵 H200 服务器部署,普通创作者难以落地。
Hao AI Lab 推出开源统一加速框架 FastVideo,该框架产出 FastWan 系列模型,分 1.3B、5B、14B 多规格,早期版本单 H200 仅 5 秒产出 5 秒 480P 视频;升级 FastWan-QAD 后适配 RTX5090,采用 NVFP4 4bit 量化训练,端到生成缩短至 1.8 秒。框架原生支持 Wan2.1/Wan2.2 全系列,提供 LoRA 微调、多卡分布式训练方案,兼容 Windows、Mac、Linux,配套 ComfyUI 可视化工作流,代码、模型权重全部开源,采用宽松 Apache2.0 协议,兼顾科研复现与商业短视频、虚拟人素材生产需求。
相关链接
-
GitHub 开源仓库:https://github.com/hao-ai-lab/FastVideo
-
HuggingFace 模型库:https://huggingface.co/FastVideo
-
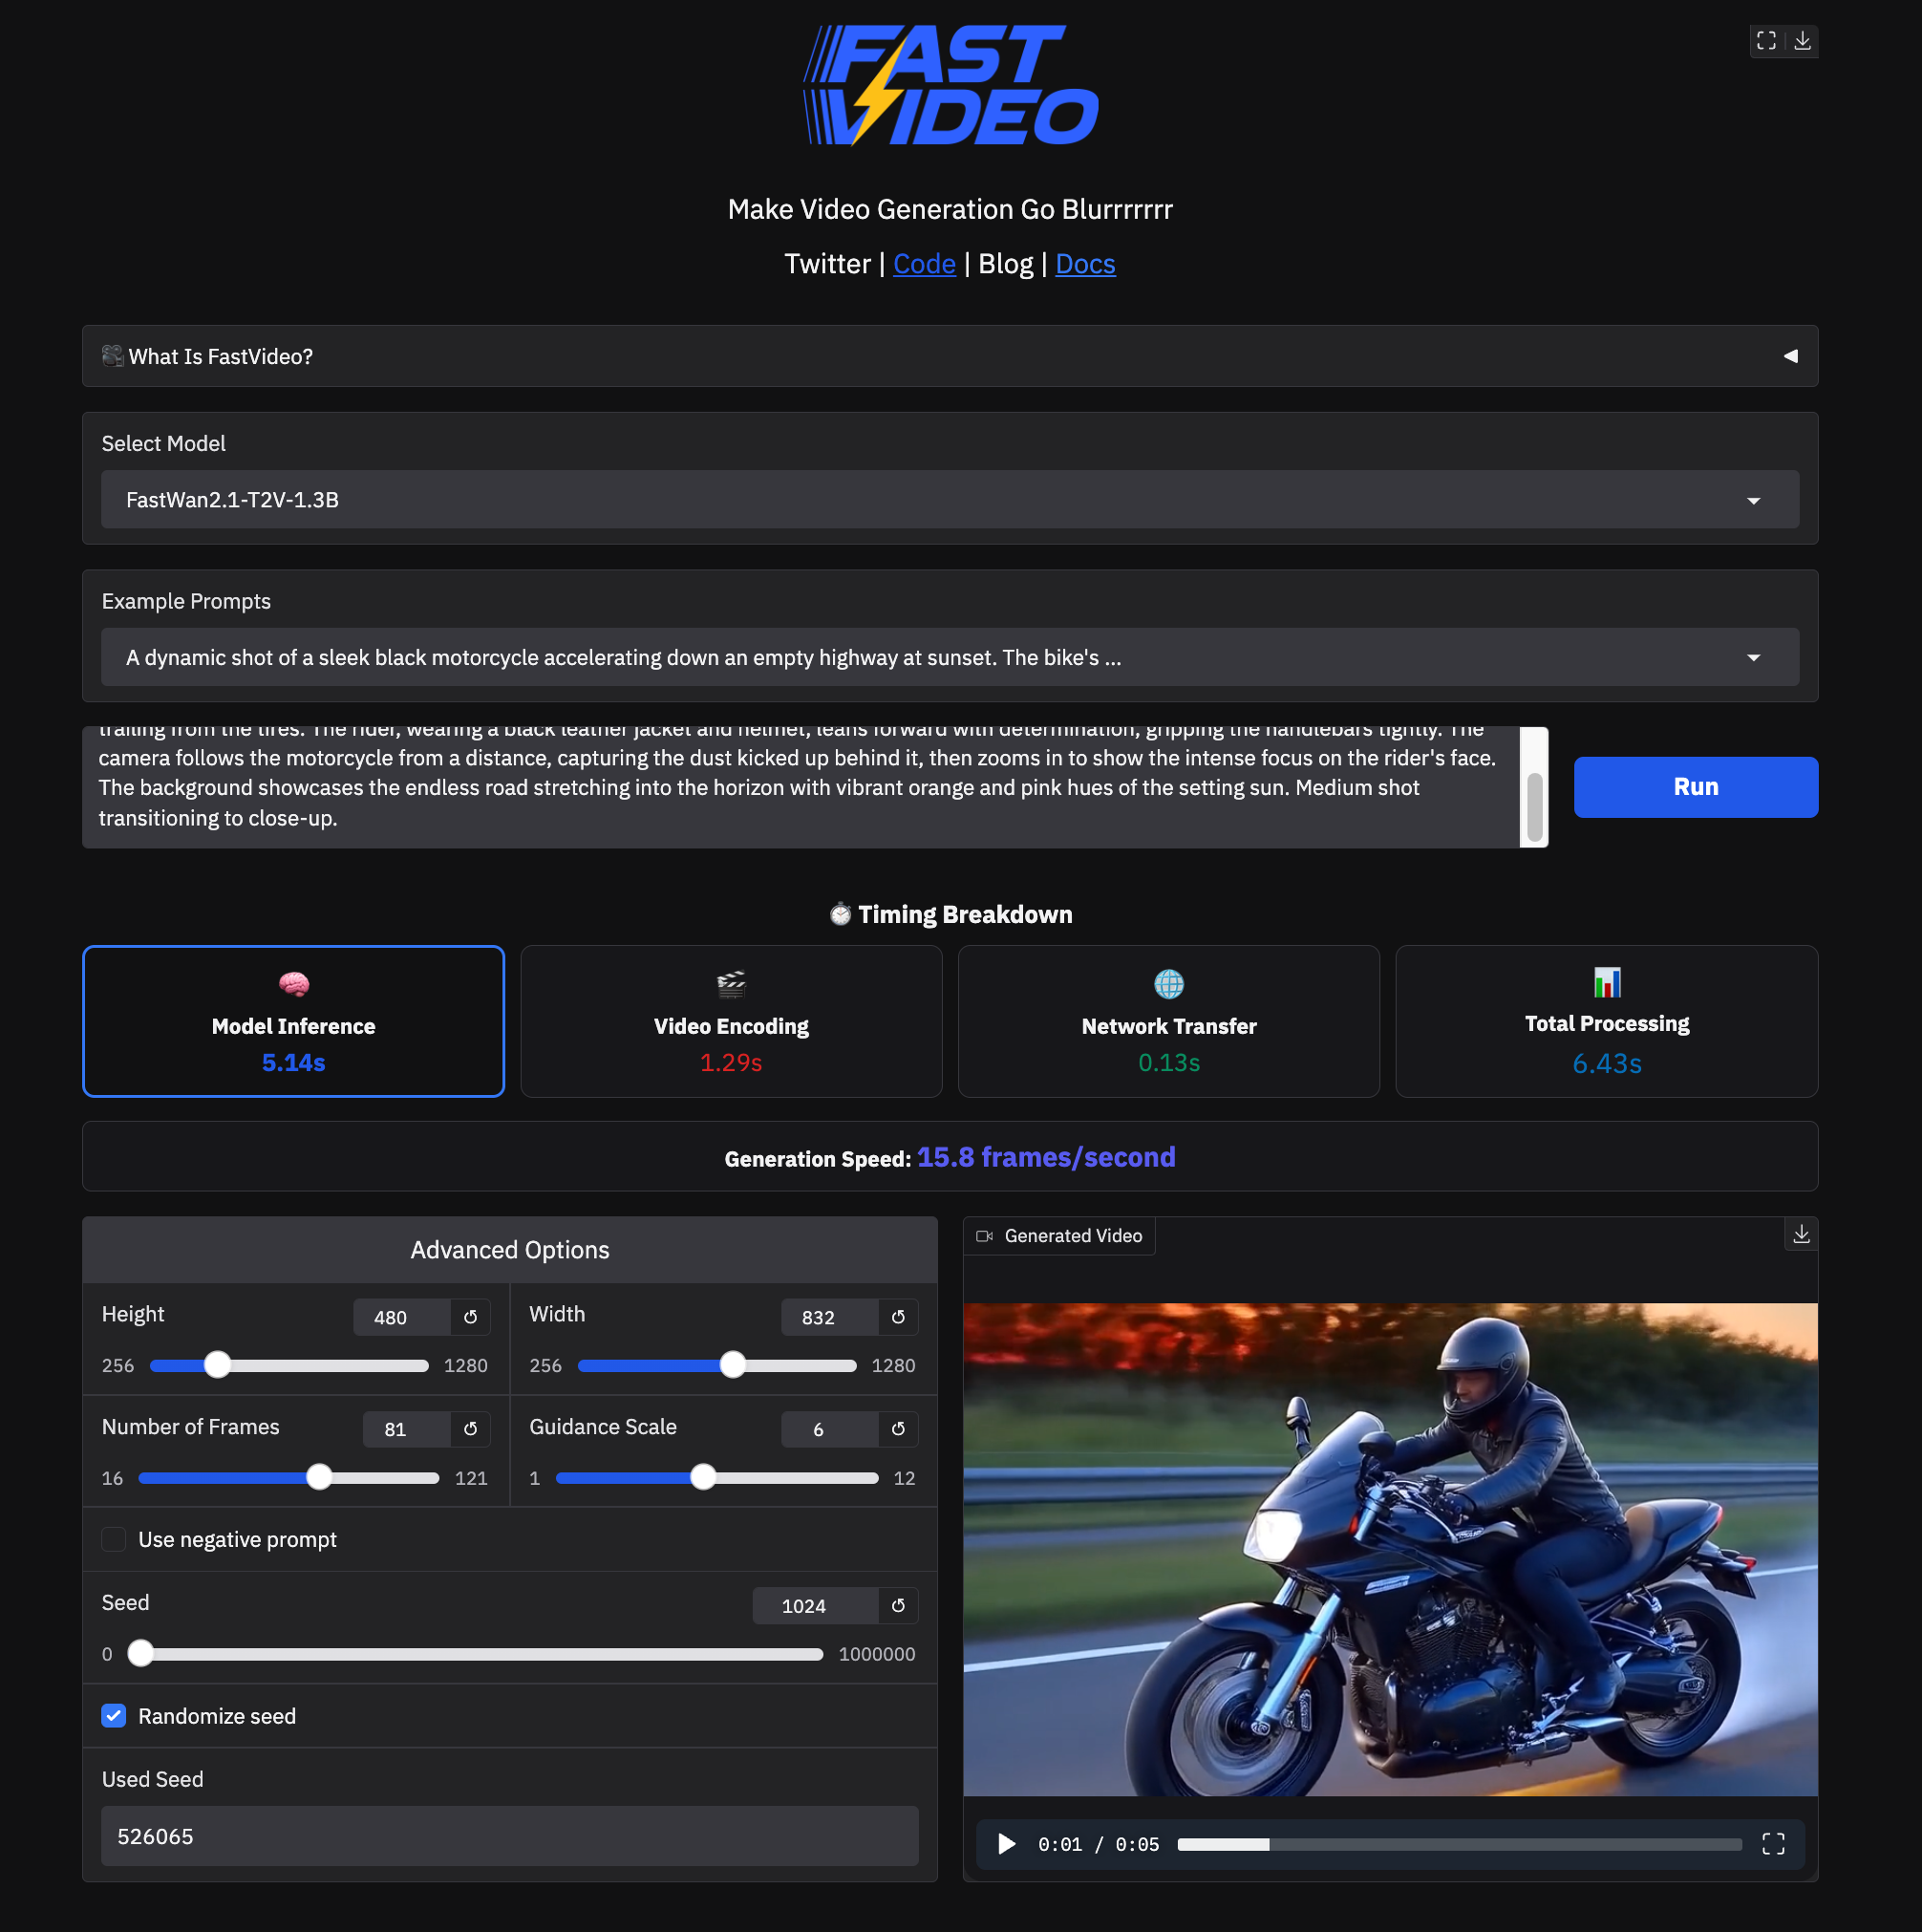
在线演示:https://fastwan.fastvideo.org
论文介绍
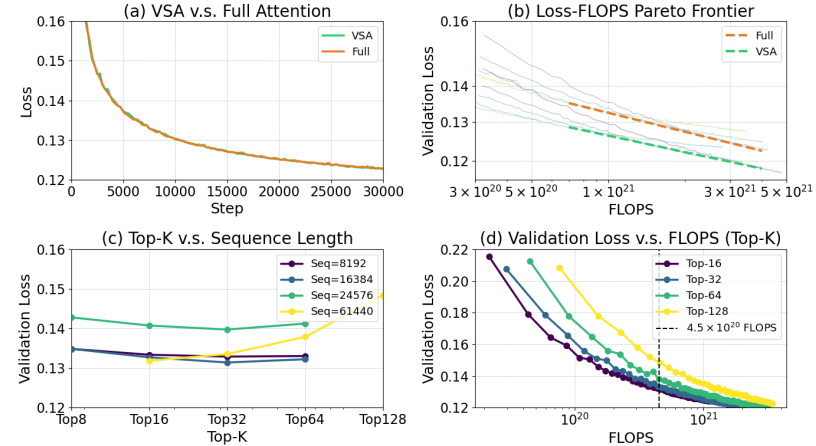
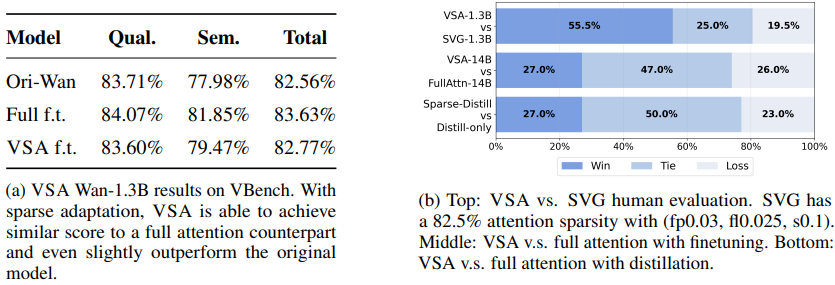
FastVideo 是面向视频扩散 DiT 的一体化加速开源框架,打通数据预处理、多卡训练、LoRA 微调、极速推理完整流程,集成业界主流注意力与蒸馏优化方案。核心创新 VSA 可训练稀疏注意力,解决传统稀疏方案在少步蒸馏下画质崩塌问题;配套稀疏蒸馏范式,联合优化注意力与去噪步数,最高实现百倍推理提速。后续迭代 QAD 量化感知蒸馏,训练阶段直接适配 4bit 低精度,规避传统后量化画面抖动、细节丢失缺陷。
基于框架衍生 FastWan 全系文生视频模型,提供自研高质量合成训练数据集,支持单卡消费级 GPU 与 64 卡超算集群两种部署模式,开放完整训练脚本、推理示例,生态覆盖 Gradio 网页、ComfyUI 插件,是目前落地门槛最低的高速视频生成开源工具栈。
FastWAN 的速度有多快?
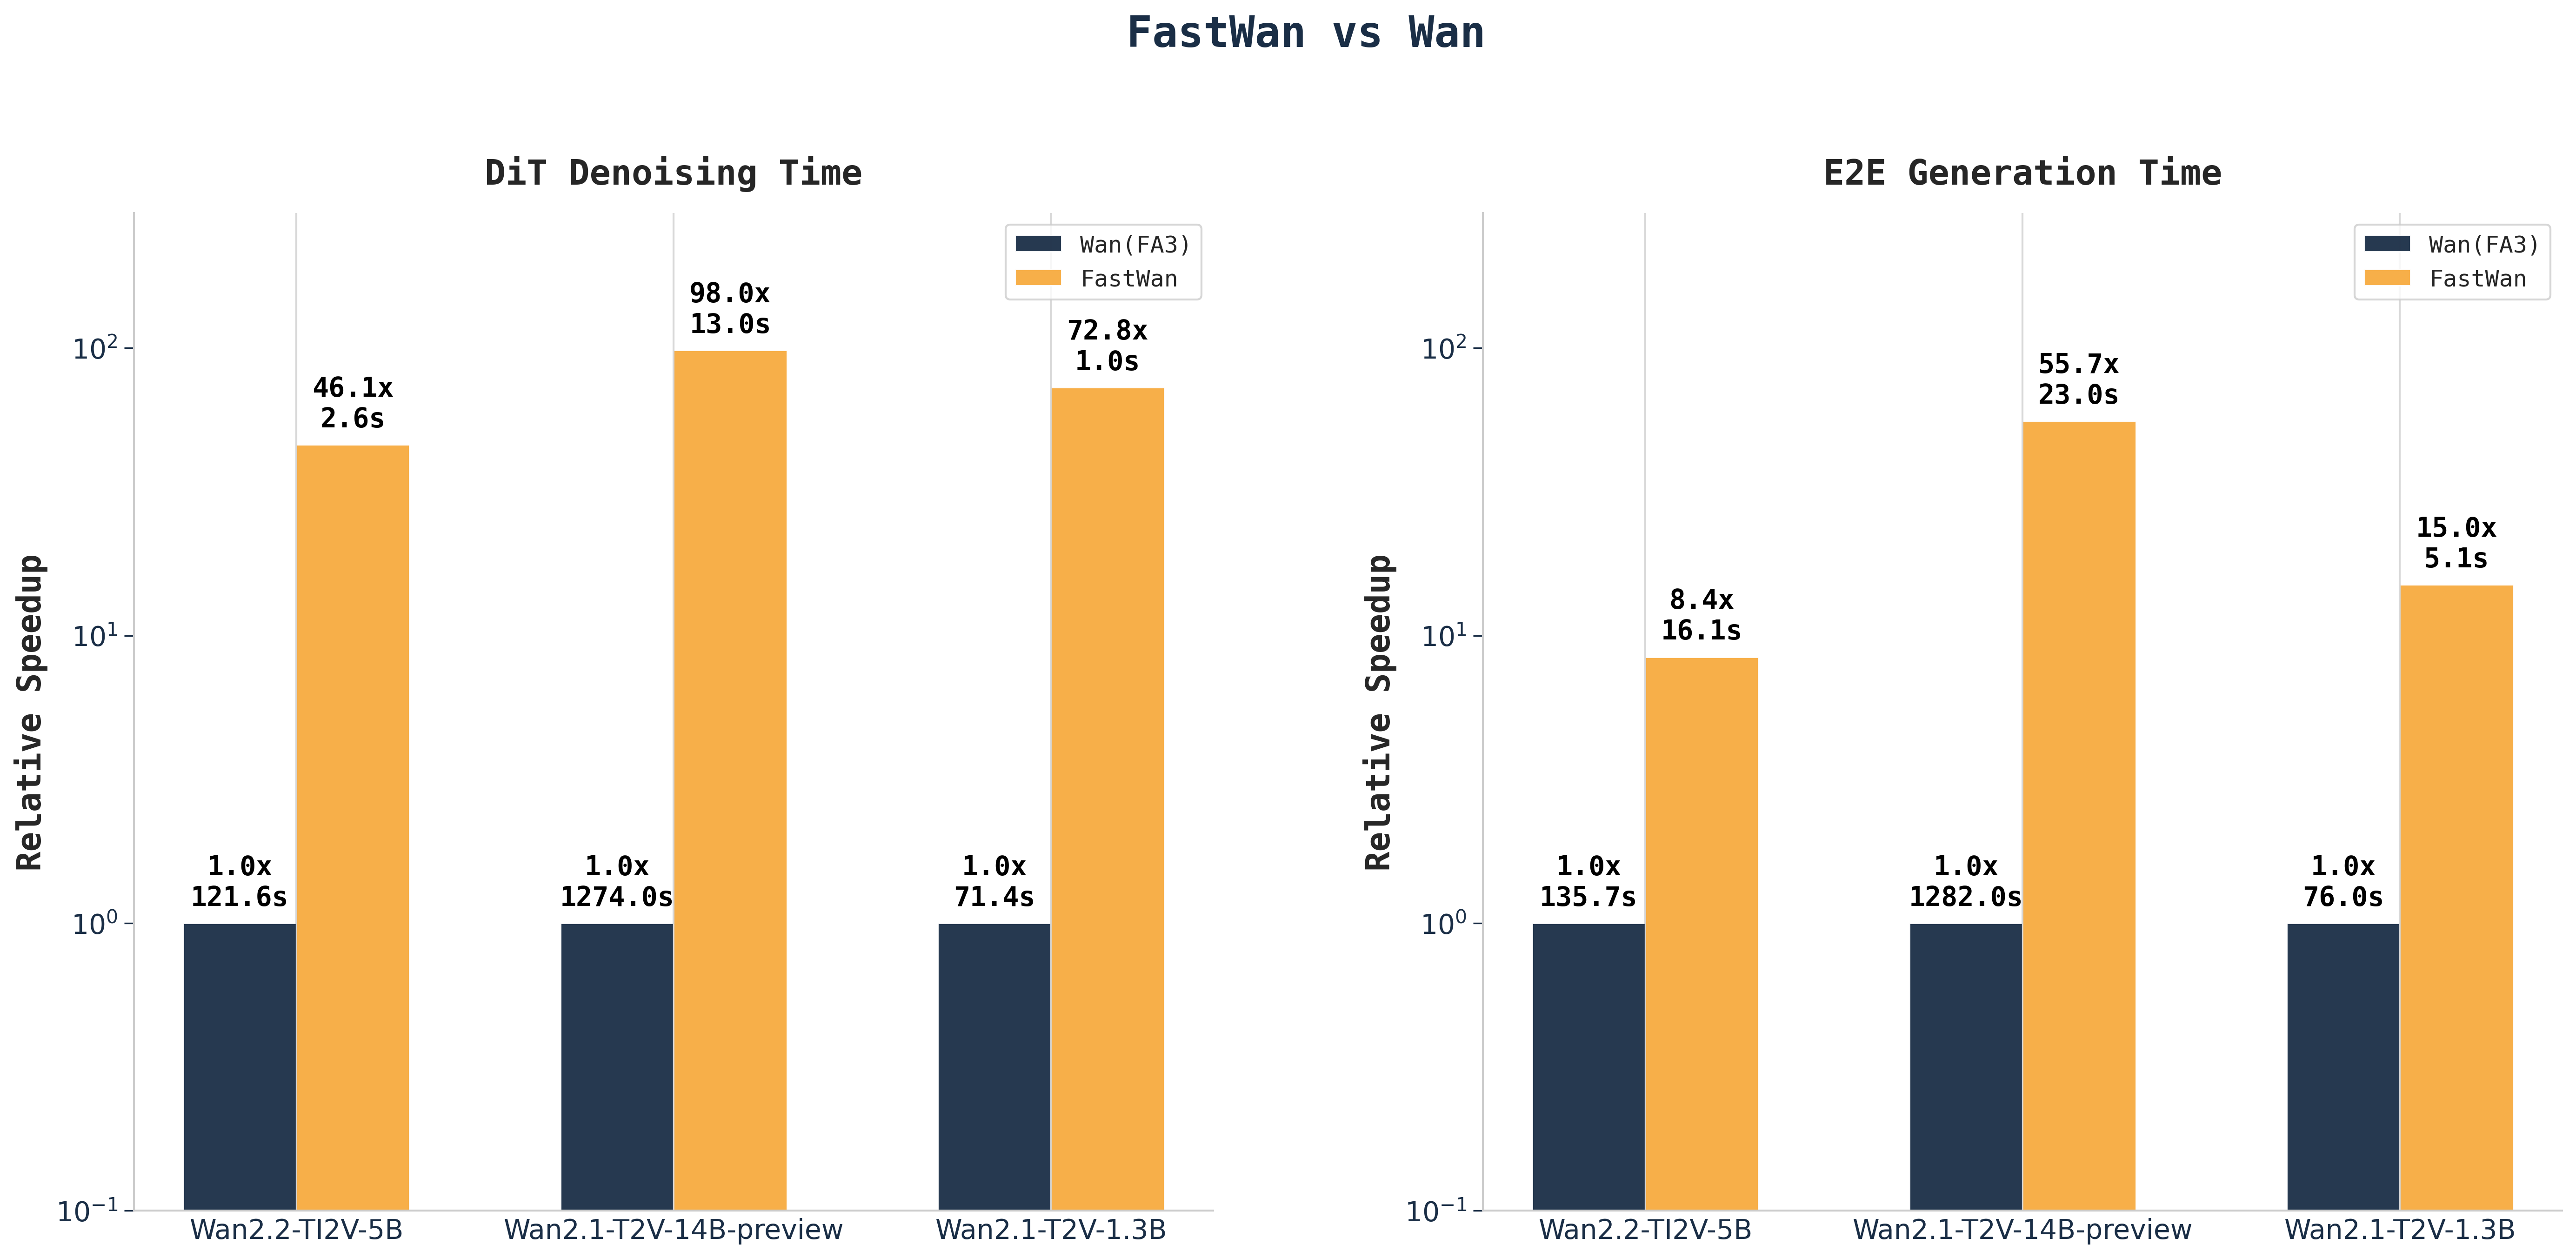
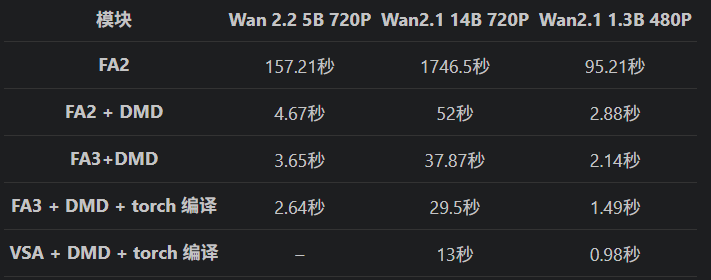
下面演示的是每个模块如何在单个 H200 GPU 上加速 DiT 去噪时间(不使用文本编码器和 vae)。
方法概述
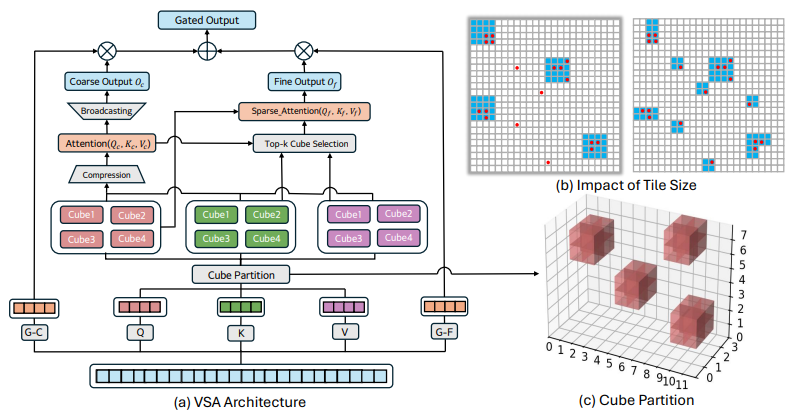
底层多重推理加速组件
-
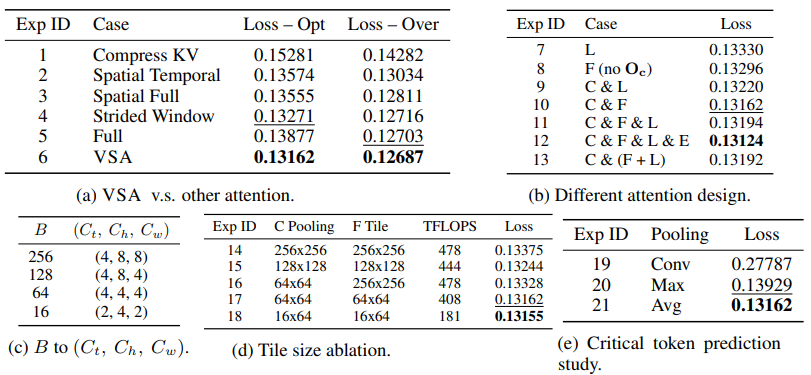
VSA 可训练稀疏注意力:区别固定启发式稀疏,训练阶段动态筛选关键时序 token,大幅削减注意力计算量,兼容 3-8 步极限蒸馏不崩画质;
-
DMD 分步蒸馏:将原生 50 步去噪压缩至 3 步,师生模型分布对齐,兼顾速度与画面连贯;
-
TeaCache 时序缓存:复用相邻时间步近似特征,重复计算直接跳过;
-
QAD 量化感知蒸馏(新版核心):训练全程引入 NVFP4 4bit 量化噪声,让模型原生适配低精度硬件,显存减半、算力提升 2-3 倍。
统一训练生态
支持全参数微调、LoRA 轻量化微调,采用 FSDP2 分片 + 序列并行技术,最多线性扩展至 64 张 GPU;内置选择性激活重计算,大幅降低长视频训练显存开销,配套 60 万 + 自研高清合成视频数据集用于蒸馏训练。
稀疏蒸馏 (Sparse Distillation)
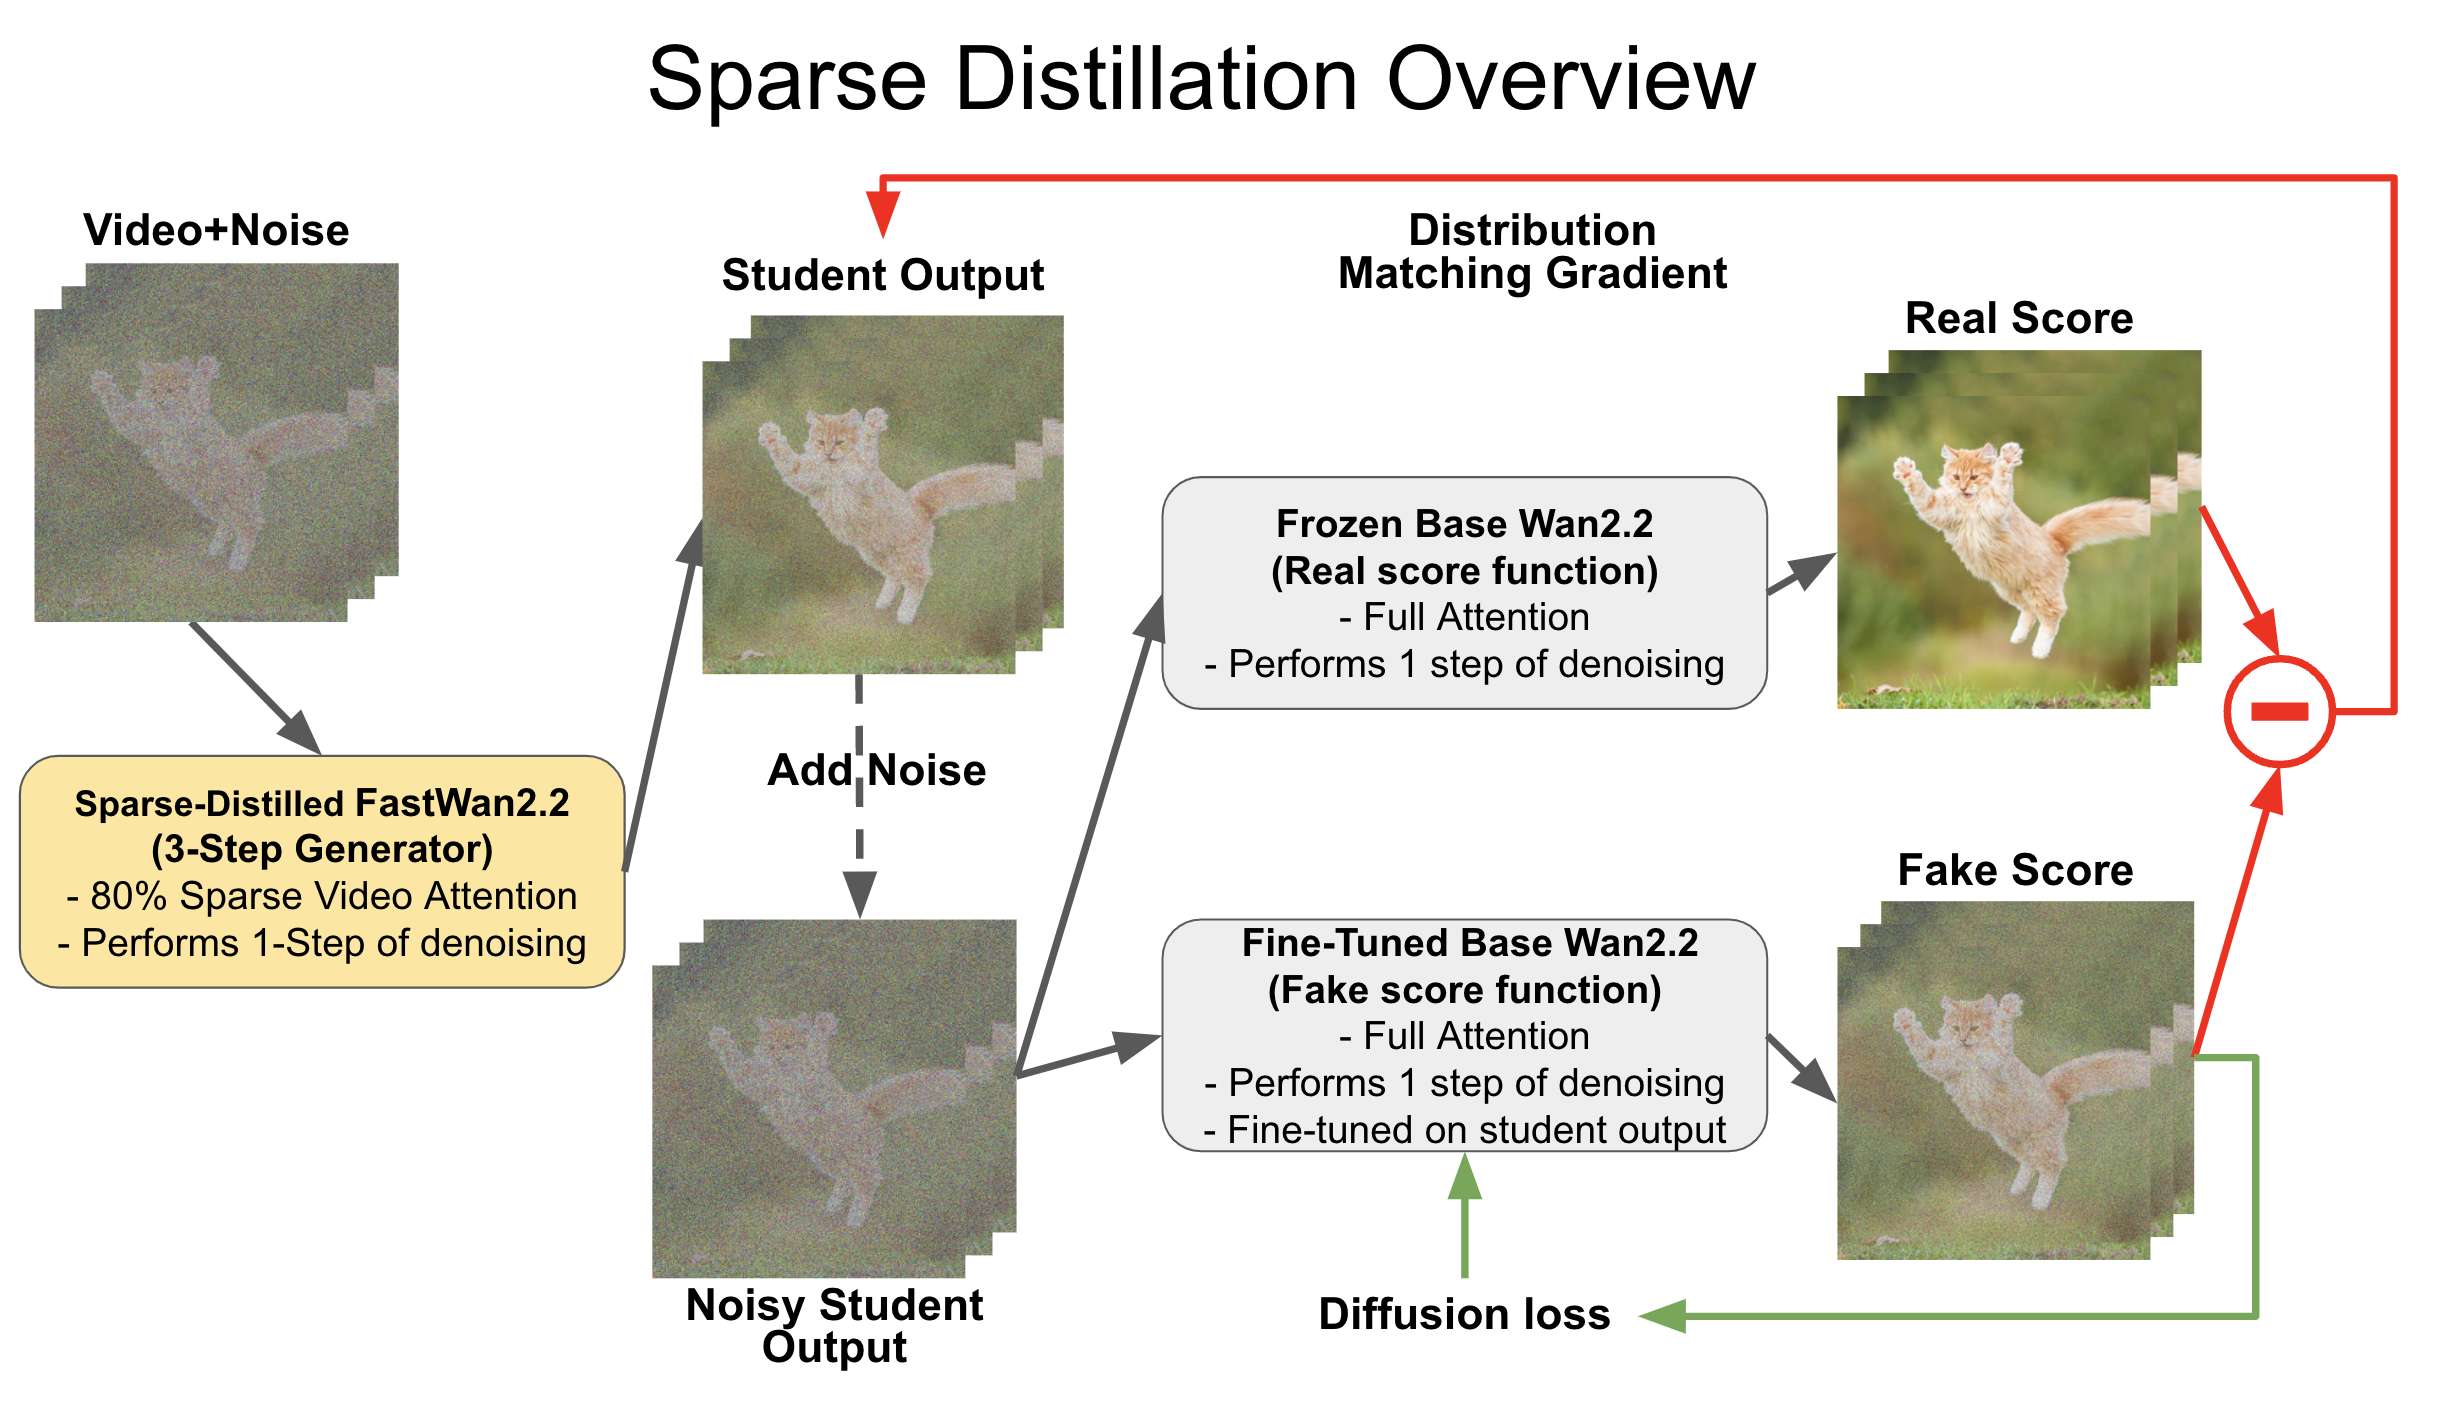
视频 DiT 面临两大瓶颈:多步去噪耗时极长,且长序列注意力计算呈二次方增长。FastVideo 首次提出了稀疏蒸馏技术,将视频稀疏注意力(VSA) 与分布匹配蒸馏(DMD) 在统一框架内联合训练。 其核心思想是:让学生模型(采用稀疏注意力、仅需极少步数)去匹配教师模型(采用全注意力、全步数)的输出分布。通过这种"少步数+稀疏注意力"的联合蒸馏,FastVideo 成功实现了超过 50 倍的去噪加速,同时完美保留了生成质量。
多版本 FastWan 模型矩阵
-
FastWan2.1-1.3B:轻量 480P,H200 约 5 秒、RTX5090 (QAD) 1.8 秒出片;
-
FastWan2.2-5B:720P 高清,适合商业精细画面;
-
FastWan2.1-14B:高画质预览版,适配专业影视级素材生成。
多端兼容部署方案
原生支持 NVIDIA 全系列显卡、Apple Silicon;提供 Python 极简推理 API、ComfyUI 可视化节点、Gradio 在线演示,Windows WSL 环境可一键部署。
三、实验实测效果
-
推理提速对比:原生 Wan2.1 14B 基线 1746 秒 / 段,叠加 VSA+DMD + 编译优化后仅 13 秒,提速超 130 倍;
-
消费卡性能:RTX5090 运行 FastWan-QAD,5 秒 480P 视频仅 1.8 秒生成,硬件成本大幅下降;
-
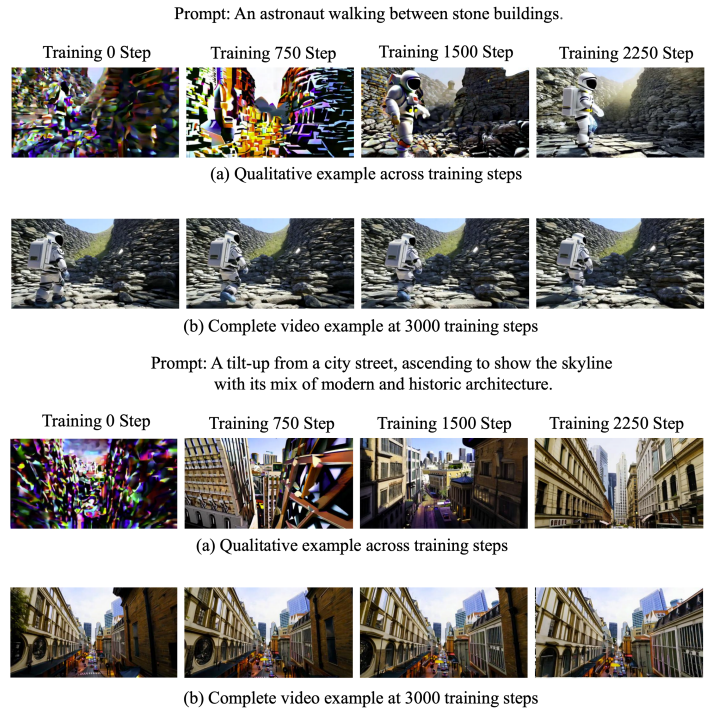
画质表现:QAD 量化模型无明显闪烁、物体畸变,人物、环境细节保留完整;
-
训练效率:64 卡 H200 集群稀疏蒸馏 4k 步即可完成模型收敛,训练成本可控;
-
落地适配:短视频带货、虚拟主播、动画分镜等场景均可批量高速生成素材。