自注意力是 Transformer 的核心模块 ,作用是让序列里面每一个token(词/字符),都可以直接关注序列里其它所有token,计算相互之间的关联权重,捕捉长距离依赖关系。
对比RNN:RNN串行逐个处理,长距离信息会衰减;自注意力一步直接看到整个序列全部位置。
核心思想
输入一组向量,分别映射出三组向量:
- Q Query 查询:我要找什么
- K Key 键:我有什么
- V Value 值:我实际携带的信息
-
拿每个 Q 和全部 K 做点积,算出相似度分数
-
除以

缩放,防止维度大分数爆炸
-
Softmax,把分数变成0~1的权重,权重总和为1
-
用权重对 V 加权求和,得到该位置输出
公式:
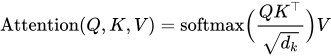
通俗例子
句子:动物 不 喜欢 吃 冰冷 的 食物
处理"吃"这个词:
- Q来自"吃";和所有词的K计算相似度
- 模型算出:和"动物"、"食物"权重高,和"的"权重低
- 输出向量就更多融合"动物、食物"的信息,理解:谁在吃,吃什么。
自注意力可以直接捕捉相隔很远的词的关系。
多头自注意力 Multi‑Head Attention
把 Q/K/V 切分成多组,每组独立跑一套自注意力,最后拼接再做线性变换。
- 单头:只能学到一种关联模式
- 多头:不同头捕捉不同关系,比如一头关注语法,一头关注指代,一头关注语义。
掩码自注意力 Masked Self‑Attention(解码器)
生成场景(GPT)用,加掩码,屏蔽未来位置 。
预测第 i 个词的时候,看不到 i 之后的token,防止偷看还没生成的内容。
自注意力优缺点
✅优点
- 全局建模,长距离依赖能力强
- 完全并行计算,相比RNN可以GPU加速
- 权重动态:不同上下文同一个词,注意力分布不一样
❌缺点
-
时间复杂度

,序列长n很大时计算显存爆炸
-
长文本成本高,衍生出:稀疏注意力、滑动窗口注意力、KV缓存等优化。
简单区分
- 自注意力 Self‑Attention :Q、K、V来自同一组输入,比如BERT编码器。
- 交叉注意力 Cross‑Attention:Q来自A序列,K、V来自B序列,用于翻译(编码器-解码器)。