极大似然估计、EM算法.ipynb
极大似然
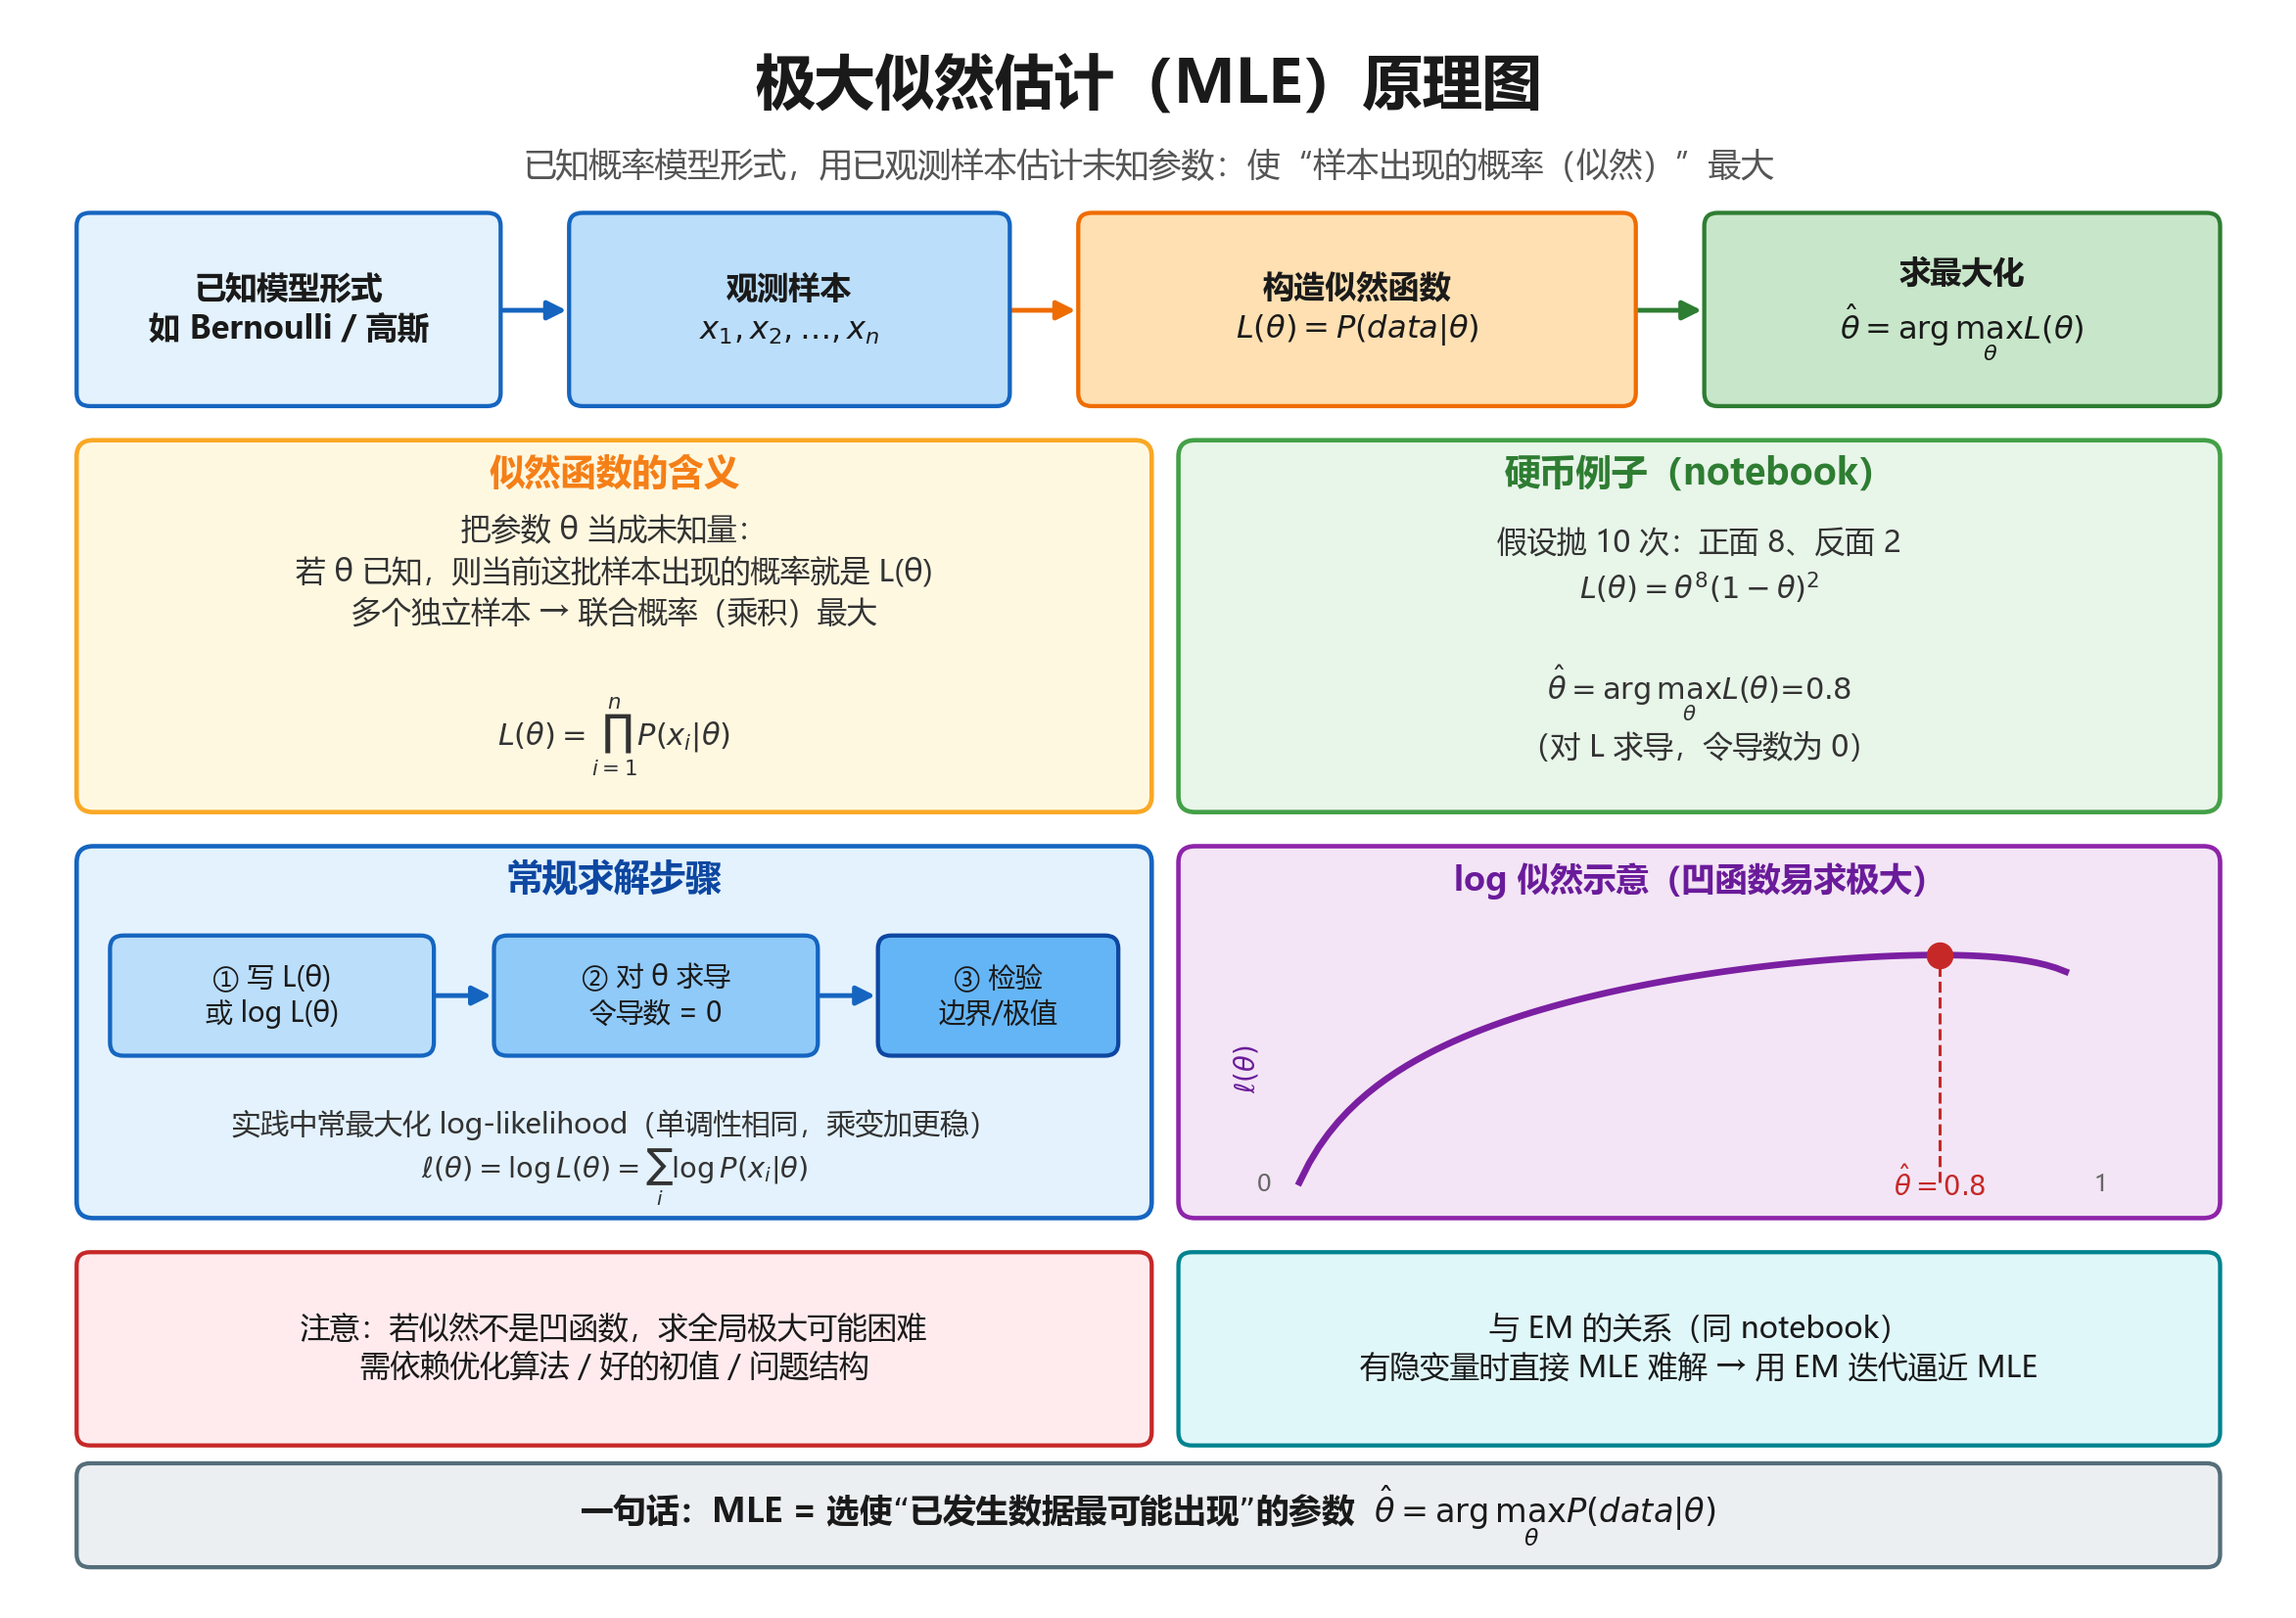
极大似然(Maximum Likelihood)估计为用于已知模型的参数估计的统计学方法。
也就是求使得似然函数最大的代估参数的值。而似然函数就是如果参数已知则已出现样本出现的概率。
比如,我们想了解抛硬币是正面(head)的概率分布θ;那么可以通过最大似然估计方法求得:
\\hat{θ} =argmax_x l(θ)=argmax_x θ\^8 (1−θ)\^2
其中,l(θ)为观测变量序列的似然函数。
所以最大似然方法估计参数,就是先假设参数已知,然后用参数,求出样本出现的概率。如果是多个样本,就是多个样本的联合概率最大
求解使似然函数最大的代估参数,常规的做法就是对似然函数求导,求使导数为0的自变量的值,以及左右边界线的值。
例如:
对l(θ)求偏导
\\frac{∂l(θ)}{∂θ} =θ\^7 (1−θ)(8−10θ)⇒\\hat{θ} =0.8
但是如果似然函数不是凹函数(concave),求解极大值困难。
一般地,使用与之具有相同单调性的log-likelihood,如图所示也就是将似然函数求log。
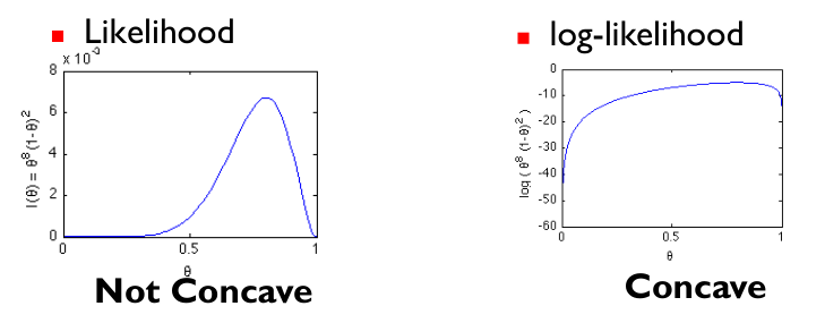
所谓的凹函数和凸函数,凹函数斜率逐渐减小,凸函数斜率逐渐增大。
所以凹函数"容易"求解极大值(极值为0时),凸函数"容易"求解极小值(极值为0时)。
常见场景:
- 概率模型参数估计:Bernoulli/抛硬币、二项分布、泊松、指数分布等
- 监督学习里的概率模型:逻辑回归、Softmax、线性回归(高斯噪声下等价最小二乘)
- 生成模型参数:朴素贝叶斯里各类别的均值/方差/先验
- 时间序列 / 计量:ARMA 等参数拟合
- 深度学习训练目标:交叉熵、负对数似然,本质上常是 MLE(或带正则的 MAP)
- 一句话: 只要能写出 Pdata∣θ
 ,且没有"看不见的变量",优先直接 MLE。
EM算法
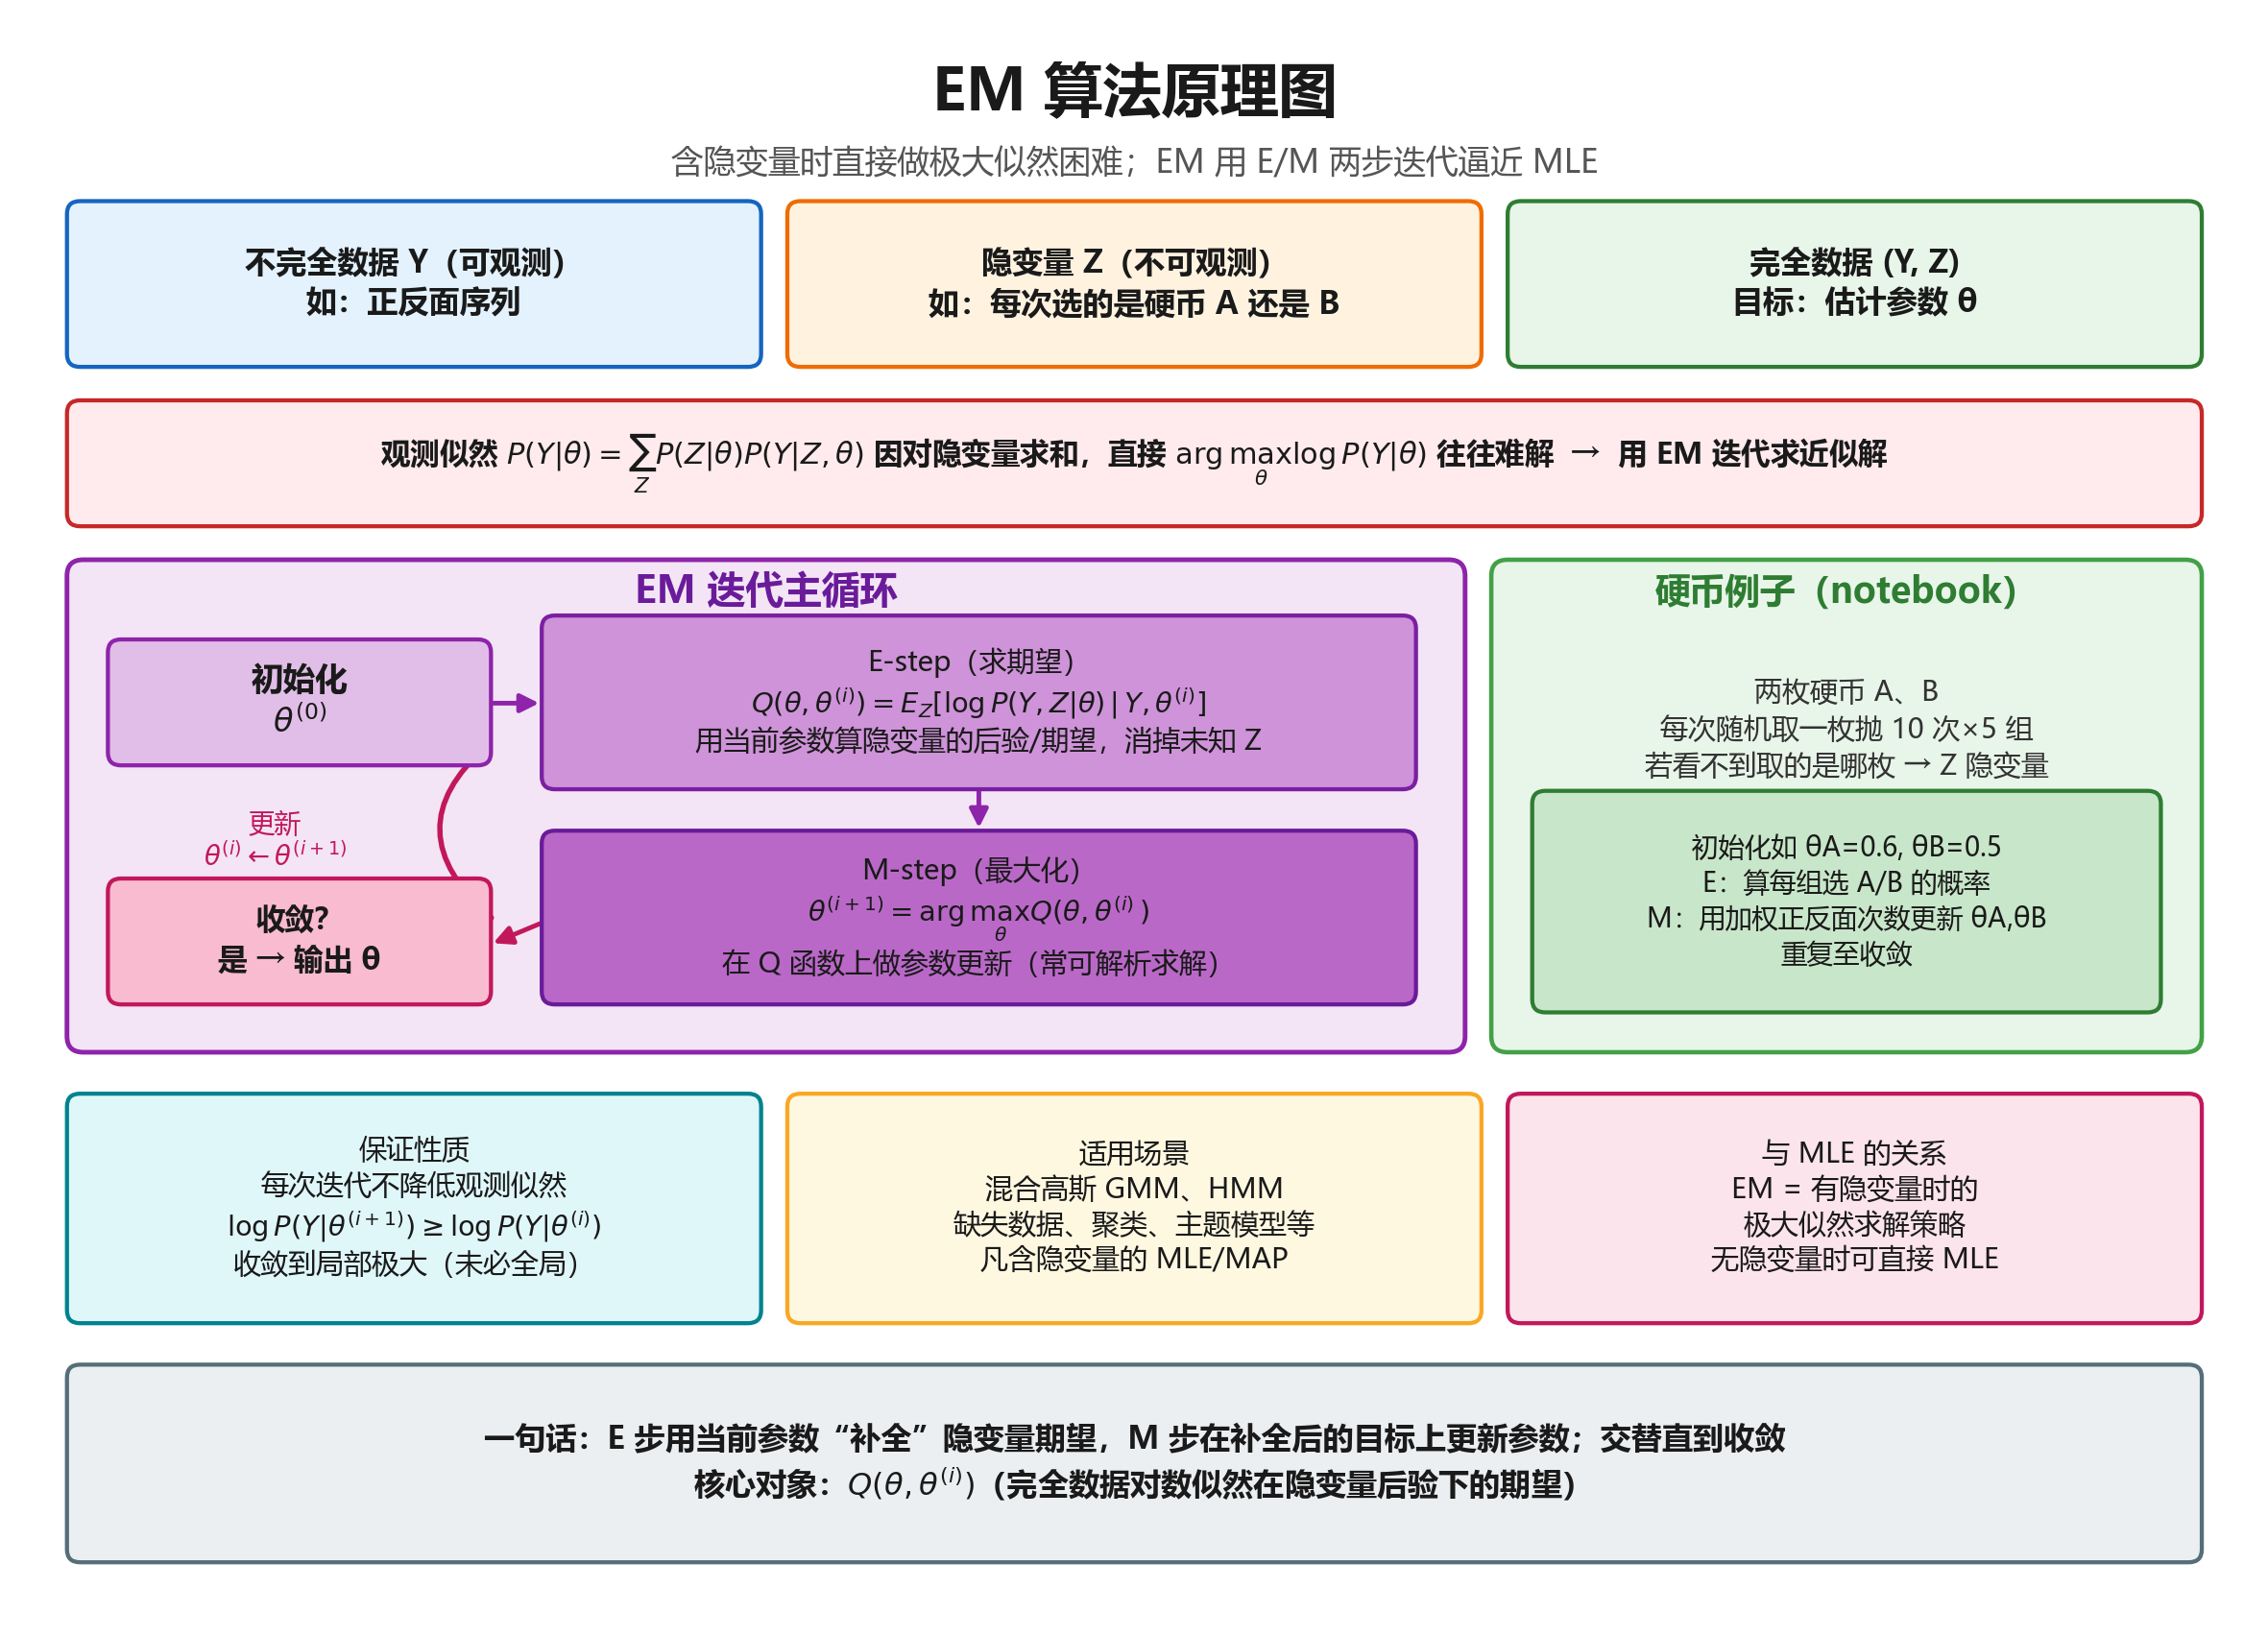
EM算法(Expectation Maximization)是在含有隐变量(latent variable)的模型下计算最大似然的一种算法。
所谓隐变量,是指我们没有办法观测到的变量。
比如,有两枚硬币A、B,每一次随机取一枚进行抛掷,我们只能观测到硬币的正面与反面,而不能观测到每一次取的硬币是否为A;则称每一次的选择抛掷硬币为隐变量。
用Y表示观测数据,Z表示隐变量;
Y和Z连在一起称为完全数据( complete-data ),观测数据Y又称为不完全数据(incomplete-data)。
观测数据的似然函数:
P(Y\|θ)=∑ _z P(Z\|θ)P(Y\|Z,θ)
求模型参数的极大似然估计:
\\hat{θ} =argmax_{θ} logP(Y\|θ)
因为含有隐变量,此问题无法求解。因此,Dempster等人提出EM算法用于迭代求解近似解。
所以EM算法是一种特殊情况下的最大似然求解方法。
EM算法比较简单,分为两个步骤:
- E步(E-step),以当前参数θ\^{(i)} 计算Z的期望值。因为期望值中不再包含未知的隐含变量Z,所以是可以计算的。
Q(θ,θ\^{(i)} )=E_Z \[logP(Y,X\|θ)\|Y,θ\^{(i)} \]
- M步(M-step),求使Q(θ,θ\^{(i)})极大化的θ,确定第i+1次迭代的参数的估计值θ\^{(i+1)}
θ\^{(i+1)} =argmax_θ Q(θ,θ\^{(i)} )
如此迭代直至算法收敛。
常见场景:
| 领域 | 例子 |
|---|---|
| 聚类 | 高斯混合模型 GMM("属于哪一类"是隐变量) |
| 序列标注 / 语音 | HMM 的 Baum-Welch(状态序列不可见) |
| 缺失数据 | 部分特征缺失时的参数估计 |
| 主题模型 | 早期 pLSA 等(文档主题为隐变量) |
| 推荐 / 协同 | 部分矩阵分解、混合成员模型 |
| 医学 / 生物 | 潜在亚型、不完全观测实验数据 |
| notebook 硬币例 | 不知道每次拿的是 A 还是 B |
一句话: 数据"不完整"(有 Z 看不见),又想做似然意义下的参数估计时,用 EM。
案例
如图所示,有两枚硬币A、B,每一个实验随机取一枚抛掷10次,共5个实验,我们可以观测到每一次所取的硬币,估计参数A、B为正面的概率θ=(θ_A ,θ_B ) ,根据极大似然估计求解。
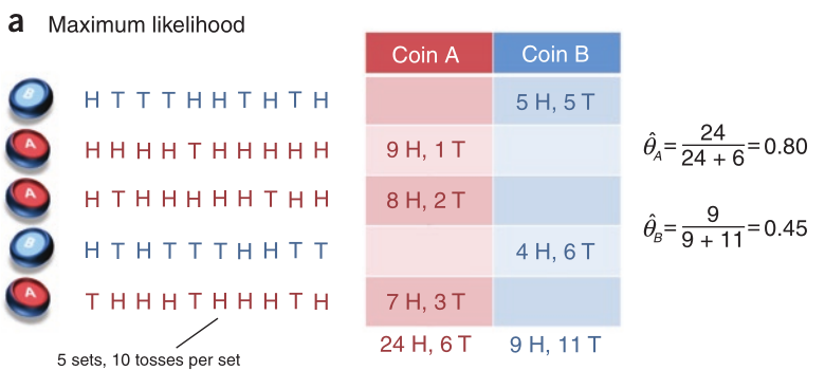
如果我们不能观测到每一次所取的硬币,只能用EM算法估计模型参数,算法流程如图所示:
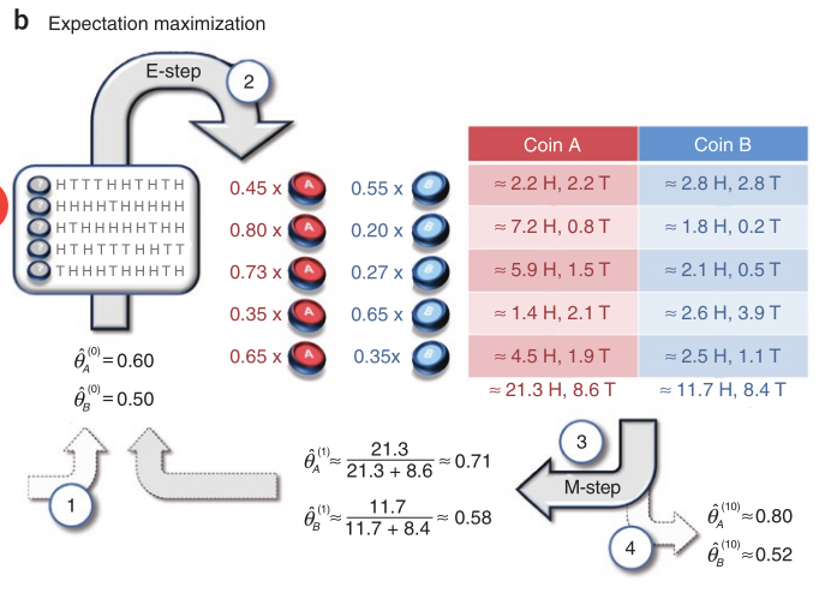
隐变量Z为每次实验中选择A或B的概率,并初始化A为正面的概率为0.6,B为正面的概率为0.5。
实验进行了5次。每次都要进行一遍EM操作。每次都要计算隐含变量。取A的概率,和取B的概率。
然后更新代估参数θ_A(A为正面的概率)和θ_B(B为正面的概率)的值。
在初始化θ_A=0.6和θ_B=0.5后第一次实验后计算隐含变量(选择A的概率)为
P(z_1 =A\|y_1 ,θ\^0)=\\frac{z_1为A的话,样本结果出现的概率}{z_1为任何可取值的话,样本结果出现的概率}=\\frac{P(z_1 =A\|y_1 ,θ\^0)} { P(z_1 =A\|y_1 ,θ\^0)+P(z_1 =B\|y_1 ,θ\^0) }=\\frac{0.6\^5 ∗0.4\^5}{0.6\^5 ∗0.4\^5 +0.5\^{10}} =0.45
按照上面的计算方法可依次求出其他隐含变量Z,然后计算极大化的θ\^{(i)}。
经过10次迭代,最终收敛。
K均值聚类和EM算法
K均值聚类是无监督的聚类算法。
关于k均值聚类不了解的可以参考:https://blog.csdn.net/luanpeng825485697/article/details/78993977
k均值聚类的目的就是为了使下面的损失函数最小
J(c,u)=\\sum_{i=1}\^m\|\|x_i-u_{c_i}\|\|
其中m为样本个数,x_i表示第i个样本,c_i表示第i个样本所属的聚类,u_{c_i}表示第i个样本所属的聚类的质心。
假设当前J没有达到最小值,那么首先可以固定每个类的质心u_j,调整每个样例的所属的类别c_j来让J函数减少,同样,固定c_j,调整每个类的质心u_j也可以使J减小。
这两个过程就是内循环中使J单调递减的过程。当J递减到最小时,u和c也同时收敛。
K-means 与 EM 的关系
首先回到初始问题,我们目的是将样本分成K个类,其实说白了就是求一个样本的隐含类别y,然后利用隐含类别将x归类。
由于我们事先不知道类别y,那么我们首先可以对每个样例假定一个y吧,但是怎么知道假定的对不对呢?怎样评价假定的好不好呢?
我们使用样本的极大似然估计来度量,这里就是x和y的联合分布P(x,y)了。
如果找到的y能够使P(x,y)最大,那么我们找到的y就是样例x的最佳类别了,x顺手就聚类了。
但是我们第一次指定的y不一定会让P(x,y)最大,而且P(x,y)还依赖于其他未知参数,当然在给定y的情况下,我们可以调整其他参数让P(x,y)最大。
但是调整完参数后,我们发现有更好的y可以指定,那么我们重新指定y,然后再计算P(x,y)最大时的参数,反复迭代直至没有更好的y可以指定。
这个过程有几个难点:
│ 第一怎么假定y?是每个样例硬指派一个y还是不同的y有不同的概率,概率如何度量。(kmean中是硬指定,距离哪个聚类近就属于哪个聚类)
│ 第二如何估计P(x,y),P(x,y)还可能依赖很多其他参数,如何调整里面的参数让P(x,y)最大。(J函数最小来代替P(x,y)最大,我们可以将这些参数写成θ,更简单的理解θ就是k个质心的选择)
按照 EM 算法思想 : E步就是估计隐含类别y的期望值,M步调整其他参数使得在给定类别y的情况下,极大似然估计P(x,y)能够达到极大值。然后在其他参数确定的情况下,重新估计y,周而复始,直至收敛。
E步(E-step),以当前参数θ计算Z的期望值。也就是确定隐含类别变量c,样本所属的分类。我们固定每个类的中心,通过对每一个样本选择最近的分类,以此优化目标函数。
M步(M-step),以当前Z的值计算使P(x,y)最大的θ。求使J函数最小的u,也就是求每个聚类的质心。重新更新每个类的中心点,该步骤可以通过对目标函数求导实现求解θ,最终可得新的类中心就是类中样本的均值。
这里的隐含类别变量指定方法比较特殊,属于硬指定,从k个类别中硬选出一个给样例(距离哪个聚类近就属于哪个聚类),而不是对每个类别赋予不同的概率。