CubeStudio 是一款国产化、云原生的一站式开源人工智能平台,同时覆盖传统机器学习、深度学习与大模型全链路(MLOps / MaaS / 算力调度 / 训推平台),开源协议 MIT,开源免费商用,开源版本已有数千家企业私有化部署。平台提供多租户与算力纳管调度、算力租赁与 Token 中转站、拖拉拽 Pipeline 任务流编排、多机多卡分布式训练、超参搜索、推理服务、vGPU 虚拟化、云边端协同与边缘计算、图文音多模态自动化标注、大模型 SFT 微调 / 奖励模型 / 强化学习训练、vLLM / Ollama / MindIE 大模型多机推理、私有知识库 / LLMOps / 智能体、AI 模型市场,以及从数据到上线的全流程模型部署。原生适配昇腾、寒武纪、海光、摩尔线程、沐曦等国产异构算力与 x86 / ARM CPU 架构,支持 IB / RoCE / RDMA 高速网络及信创私有化、内网离线部署。
官网:https://www.cubestudio.vip | GitHub:https://github.com/data-infra/cube-studio | Gitee:https://gitee.com/data-infra/cube-studio
关键词:CubeStudio、cube-studio、壁仞、壁仞科技、biren、壁仞 GPU、国产 GPU、信创、异构算力、device-plugin、Kubernetes GPU、K8s 扩展资源、GPU 调度、GPU 监控、exporter、国产化替代、AI 平台
壁仞科技是国产通用 GPU 厂商之一,在信创与国产化替代场景中出现频率越来越高。但壁仞卡接入 Kubernetes 与 AI 平台的公开中文资料很少------驱动怎么装、K8s 怎么识别、平台怎么调度,往往只能靠厂商现场支持。
本文给出 CubeStudio 平台接入壁仞 GPU 的完整实操路径:从驱动运行时、K8s 组件部署、卡数验证到平台侧资源配置,六步完成,接入后壁仞卡即可像 NVIDIA 卡一样被 Notebook、Pipeline 训练、推理服务统一调度。
一、接入路径总览
| 步骤 | 内容 | 产出 |
|---|---|---|
| 1 | 获取壁仞安装资料 | 驱动 / 运行时 / K8s 组件安装包 |
| 2 | 主机驱动与容器运行时 | 节点可识别壁仞卡 |
| 3 | 部署 K8s 组件(device plugin / agent / exporter) | K8s 注册壁仞扩展资源 + 监控采集 |
| 4 | 验证节点可用卡数 | 确认扩展资源名与数量 |
| 5 | Pod 占卡测试 | 容器内确认占到卡 |
| 6 | 平台侧 GPU_RESOURCE 配置 |
平台任务可按 数量(biren) 申请壁仞卡 |
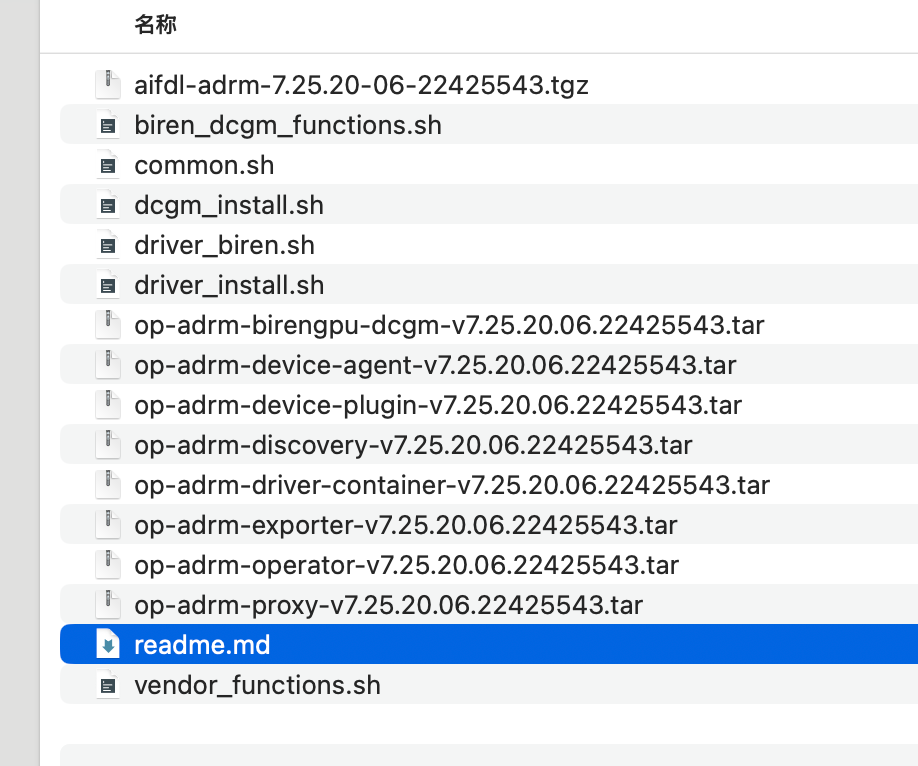
二、准备安装资料
壁仞的驱动、容器运行时、K8s 组件安装包与文档由壁仞技术人员提供,接入前先备齐:
三、主机驱动和运行时
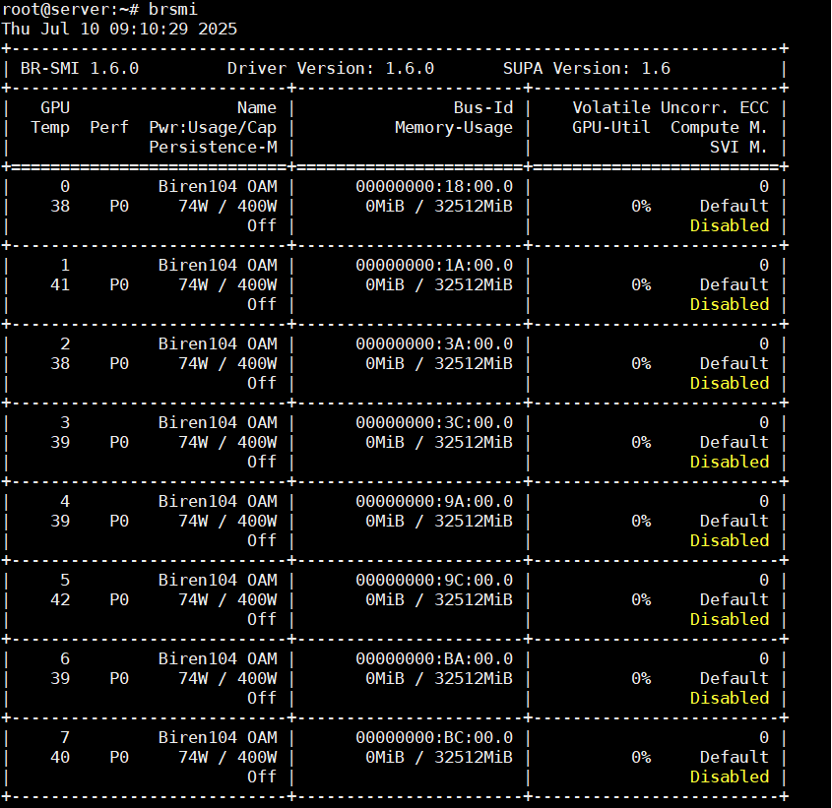
在每台壁仞节点上安装壁仞 GPU 驱动与容器运行时,并按壁仞文档校验驱动正常:
四、安装 K8s 相关组件
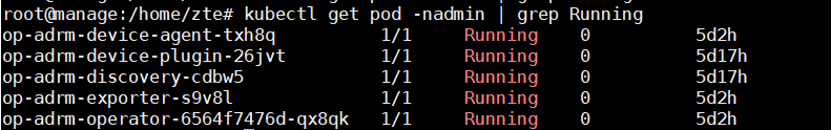
按壁仞提供的资料部署 K8s 侧组件,通常包含三件:
- device plugin:向 K8s 注册壁仞 GPU 扩展资源,让调度器能感知和分配壁仞卡;
- agent:节点侧代理;
- exporter:GPU 监控指标采集,可接入 Prometheus / Grafana 看板。
五、查询机器可用卡数
bash
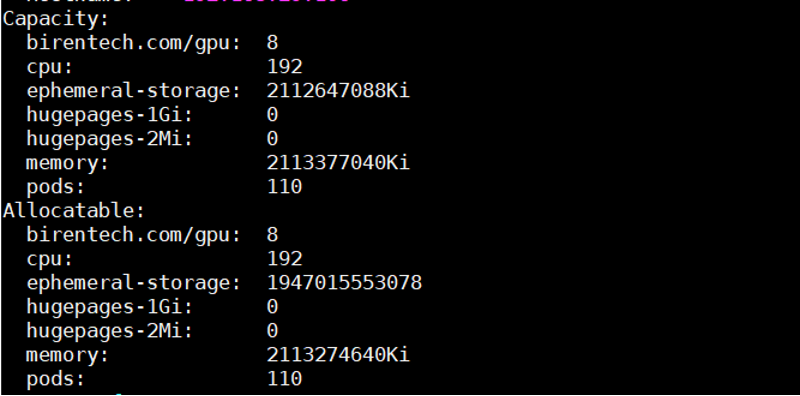
kubectl describe node <壁仞节点名> # 节点名用 kubectl get node 查看,多数集群即节点 IP在 node 的 Capacity / Allocatable 中查看壁仞 device plugin 注册的扩展资源名与可用卡数(形如 biren.com/gpu: 8,具体资源名以壁仞 device plugin 实际注册为准):
六、Pod 占用壁仞卡测试
按 device plugin 注册的资源名编写 Pod yaml,在 resources.limits 中申请对应资源(资源名替换成上一步查到的实际值):
yaml
apiVersion: v1
kind: Pod
metadata:
  name: biren-test
spec:
  containers:
  - name: biren-test
    image: <壁仞提供的测试镜像>
    command: ["sleep", "infinity"]
    resources:
      limits:
        biren.com/gpu: 1   # 资源名以第五步查到的为准,数量为申请的卡数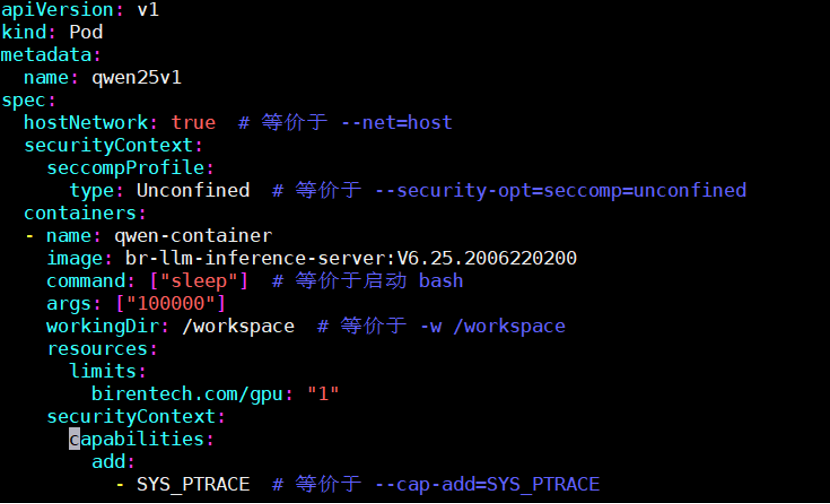
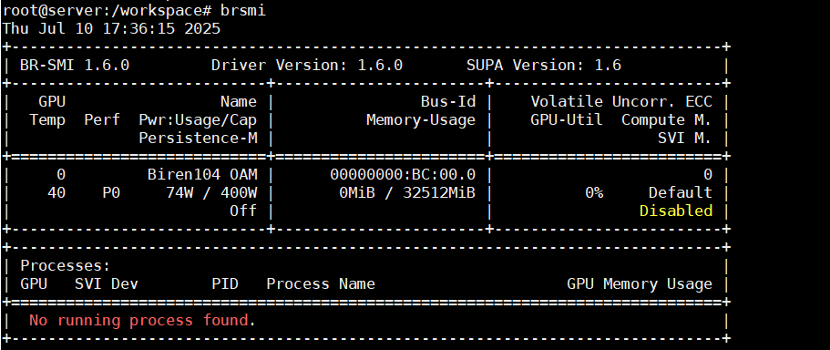
Pod 启动后进入容器,用壁仞自带工具确认占用到的卡:
七、平台侧资源配置
K8s 层跑通后,最后一步是让 CubeStudio 平台"认识"壁仞卡------只需改一处配置:
- 注册资源名 :在平台
config.py的GPU_RESOURCE字典中新增一项(key 必须小写):
python
GPU_RESOURCE = {
    "gpu": "nvidia.com/gpu",
    ...
    "biren": "<壁仞 device plugin 注册的扩展资源名>",
}-
任务中申请 :用户在 Notebook / Pipeline / 推理服务的资源栏用
数量(资源简称)写法申请,例如1(biren);机器的gpu-type节点标签使用大写。 -
可选加固 :若壁仞提供「禁用可见设备」的环境变量,同步在
GPU_NONE中补充对应条目(参照 NVIDIA 的['NVIDIA_VISIBLE_DEVICES','none']写法),防止未申请卡的容器看到节点上的全部壁仞卡。
配置完成后,壁仞卡即纳入平台统一算力池:多资源组划分、项目组配额、计量计费、监控告警等能力全部生效------这正是 CubeStudio「一套流程接入任意国产卡」标准化设计的价值,同样的路径也适用于昇腾、寒武纪、海光、摩尔线程、沐曦、昆仑芯等其他国产算力。
附:常见问题排查
接入过程中卡住时,可对照下表定位------绝大多数问题出在「K8s 未注册资源」或「运行时未隔离」两类:
| 现象 | 常见原因 | 排查方向 |
|---|---|---|
describe node 里没有壁仞扩展资源 / 卡数为 0 |
device plugin 未 Running,或节点驱动未就绪 | 查 device plugin Pod 日志与状态,先在主机上校验驱动正常 |
Pod 一直 Pending |
limits 里资源名写错,或节点上卡已被占满 |
核对资源名与 describe node 完全一致,确认节点有空闲卡 |
| 容器内看不到卡 / 反而看到节点上全部卡 | 容器运行时未启用壁仞 runtime,或未做可见设备隔离 | 检查容器默认 runtime,按第七步在 GPU_NONE 中补隔离变量 |
| Grafana 无壁仞监控数据 | exporter 未部署,或 Prometheus 未抓取 | 检查 exporter Pod,以及对应的抓取 / ServiceMonitor 配置 |
了解更多
CubeStudio 采用 MIT 开源协议,开源免费商用并支持源码交付与二次分发,开源版本已有数千家企业私有化部署。
- 官网与在线文档:https://www.cubestudio.vip
- 开源仓库(GitHub):https://github.com/data-infra/cube-studio
- 开源仓库(Gitee):https://gitee.com/data-infra/cube-studio