NVIDIA KAI Scheduler深度解析------Kubernetes原生AI调度器的架构、原理与实践
一、引言:Kubernetes调度器的AI之痛
Kubernetes默认调度器(kube-scheduler)是为无状态微服务设计的------它把GPU当成CPU核一样调度,每个Pod独占整张GPU,没有Gang Scheduling(成组调度),没有团队公平性,没有拓扑感知。
在AI训练场景下,这种设计带来了三个致命问题:
- 资源死锁:分布式训练需要多个Pod同时启动,但kube-scheduler逐个调度,可能出现部分Pod被调度占着GPU等待,其他Pod永远等不到资源
- 资源碎片:GPU只能整卡分配,无法共享,大量算力和显存被浪费
- 缺乏公平性:多团队共享集群时,没有层级配额和公平调度机制
这正是NVIDIA KAI Scheduler要解决的问题。
二、KAI Scheduler是什么
KAI Scheduler是NVIDIA开源的Kubernetes原生AI工作负载调度器。它的前身是Run:ai的调度引擎------NVIDIA于2024年底收购Run:ai后,在2025年4月以Apache 2.0协议 将其开源。2026年3月,KAI Scheduler正式成为CNCF Sandbox项目。
KAI Scheduler旨在管理包含数千个节点的大规模GPU集群 ,支持高吞吐量的AI工作负载调度。它可以与默认的kube-scheduler并行运行------任何设置schedulerName: kai-scheduler的Pod由KAI处理,其他Pod走默认流程。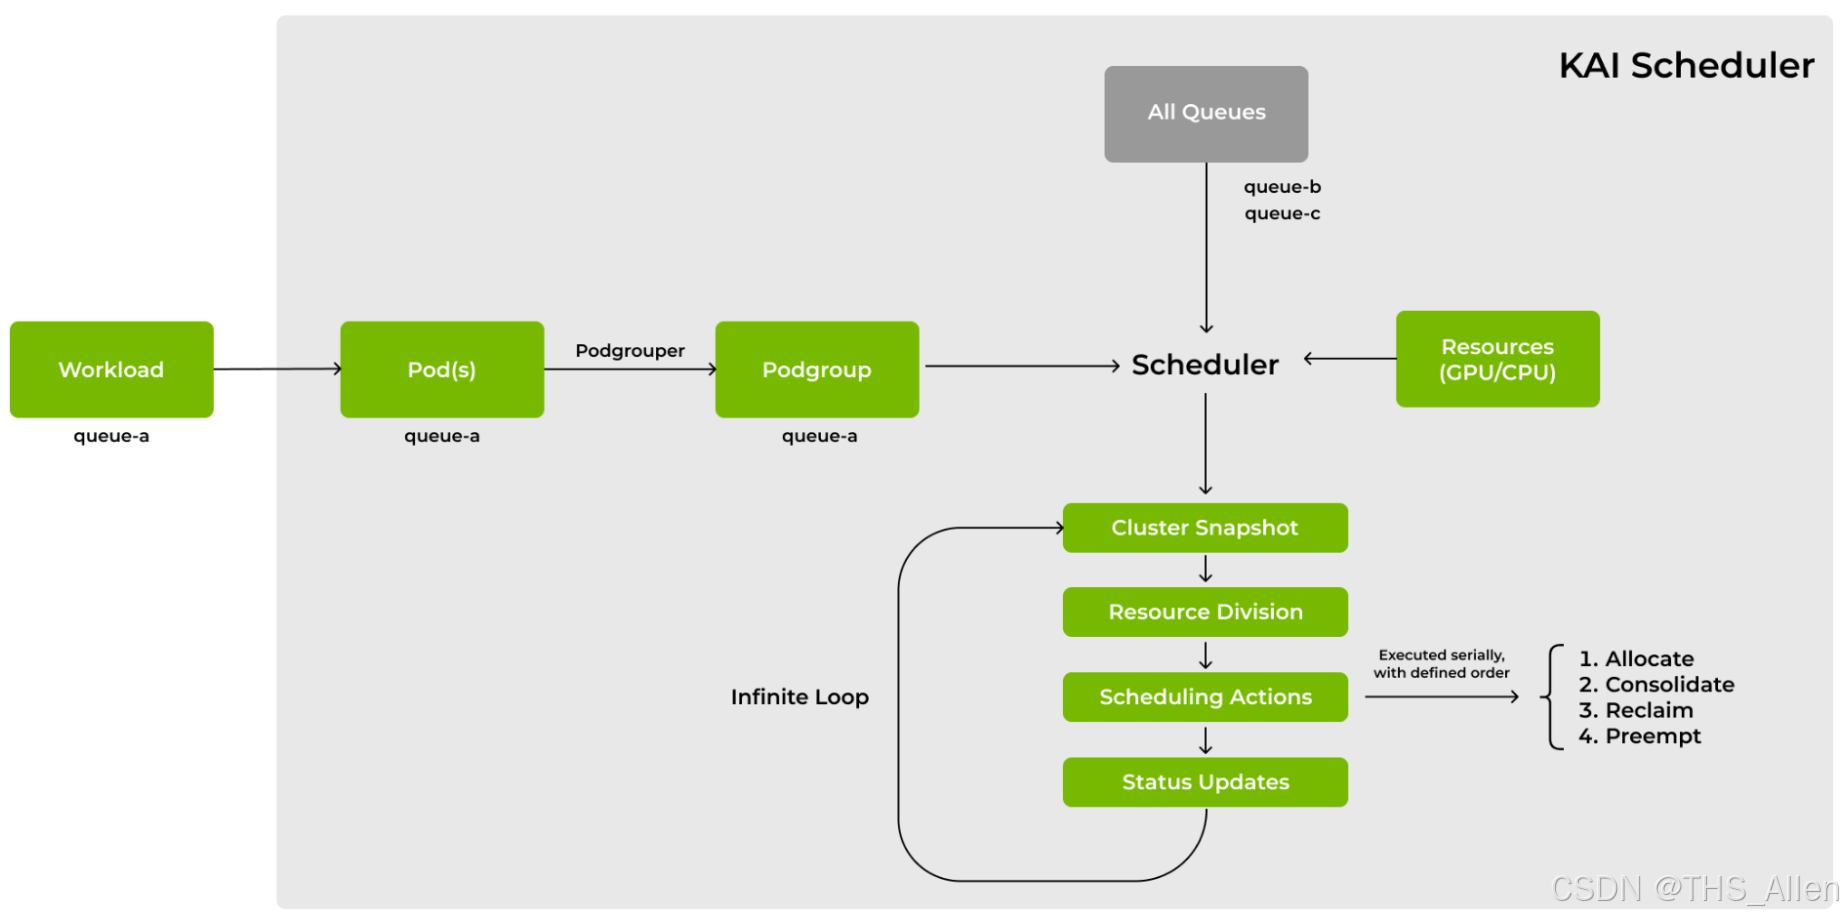
三、架构原理:基于kube-batch的批处理调度引擎
3.1 架构渊源
理解KAI Scheduler的架构,需要先了解kube-batch------Kubernetes社区早期孵化的批处理调度器。kube-batch是Kubernetes生态中首个引入PodGroup概念的调度器,旨在解决AI/HPC场景下"All-or-Nothing"的调度需求。
KAI Scheduler继承并发扬了kube-batch的核心设计理念:
- 领域模型复用:沿用Queue(队列)、PodGroup(任务组)等批处理原语,支持多租户环境下的资源配额管理
- 架构扩展:在保留kube-batch插件化接口(Session-Plugin-Action)的基础上,深度扩展了对异构硬件的感知能力、拓扑感知调度(TAS)以及更复杂的抢占与公平性算法
值得注意的是 :KAI Scheduler构建于kube-batch架构体系之上,而非基于Kubernetes上游的Scheduling Framework(即kube-scheduler的插件化架构)。这种架构选择使其能够采用Session(会话)模式与Action(动作)驱动机制,在全局视图下进行复杂的资源预留和回填(Backfill)。
3.2 核心组件交互
在运行态,KAI Scheduler与Kubernetes集群组件保持着紧密的交互:
数据摄入(Ingestion) :通过Kubernetes原生的List-Watch机制,实时监听Pod、Node、PodGroup、Queue等资源对象的变更事件
本地缓存(Local Cache) :KAI Scheduler维护了一个高度优化的本地内存视图 ,所有监听到的事件首先更新本地缓存。这种设计大幅降低了API Server的负载,允许调度器在微秒级完成成千上万次模拟调度计算
决策输出(Binding) :一旦调度周期完成并产出决策,KAI Scheduler通过异步客户端向API Server发送Bind请求,将Pod绑定到选定的Node
3.3 调度周期:从事件驱动到周期驱动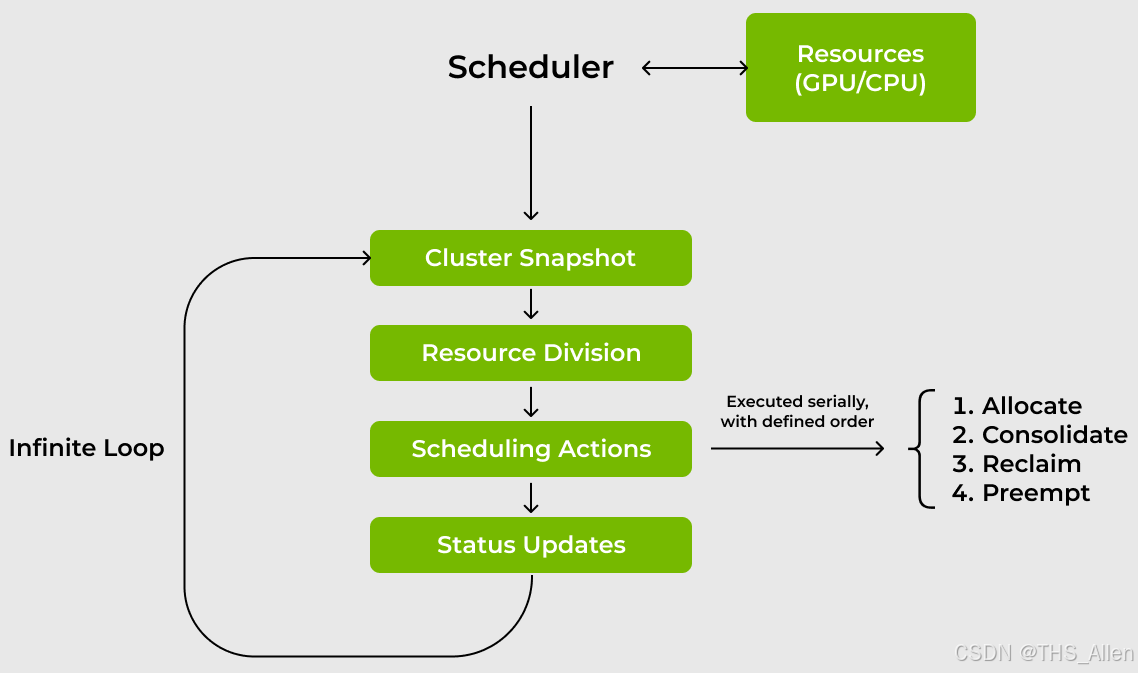
不同于原生Kubernetes调度器的事件驱动模型,KAI Scheduler采用了周期性调度(Cycle-based Scheduling) 模式。调度器在每个调度周期内:
- 从本地缓存读取集群当前状态
- 对所有待调度的PodGroup进行全局最优计算
- 批量产出调度决策并执行绑定
这种设计更契合批处理场景对全局最优解的需求 ,而非逐个Pod的局部最优。调度器的核心是持续捕获集群状态、计算最优资源分配并应用有针对性的调度操作。
四、核心特性详解
4.1 PodGroup与Gang Scheduling
PodGroup是KAI Scheduler调度的原子单元,表示必须作为单个单元执行的一个或多个相互依赖的Pod。
每个PodGroup有三个关键属性:
- minMember(最低成员数) :指定必须一起调度的Pod最低数量。如果资源不足,整个PodGroup保持Pending状态
- 队列关联:每个PodGroup与特定调度队列关联
- 优先级类:确定调度顺序
KAI Scheduler内置了PodGrouper,可自动检测并分组来自Kubeflow、Ray、Argo等框架的工作负载,无需手动创建PodGroup CRD。例如,一个PyTorchJob的多个Worker Pod会被PodGrouper自动识别为一个PodGroup。
4.2 层级队列与公平调度
Queue(队列) 是实现资源公平性的基础实体。KAI Scheduler支持多级层级队列(n-levels of hierarchical queues),允许组织按部门/团队分配GPU配额。
队列的核心机制:
- Guarantee(保障) :为队列预留的最小GPU资源,不可被抢占
- Weight(权重) :当队列超出保障时,按权重比例分配剩余资源
- Maximum(上限) :队列可使用的资源硬上限
动态公平份额:KAI Scheduler持续重新计算公平份额值,实时调整配额和限制,自动匹配当前工作负载需求。这解决了传统静态配额导致资源浪费的问题。
4.3 Fractional GPU(GPU分片共享)
KAI Scheduler支持多个工作负载共享同一张GPU,按比例或按显存大小分配。用户只需在Pod Annotation中声明所需的GPU份额。
工作原理:KAI Scheduler内部将GPU份额转换为两位小数的GPU分数,乘以GPU总显存得到强制上限。
4.4 拓扑感知调度(Topology-Aware Scheduling, TAS)
KAI Scheduler深度感知AI任务特性------GPU需求、拓扑偏好、通信模式等。它能够:
- 感知GPU间的NVLink连接、PCIe拓扑、NUMA亲和性
- 将紧耦合的训练任务放在同一节点或同一NVLink域内
- 支持required(必须) 和preferred(优先) 两种拓扑约束
对于Dynamo/Grove等解耦式推理架构,TAS能够优化多组件工作负载的跨节点 placement。
4.5 Bin-Packing与Spread调度
KAI Scheduler提供两种互补的节点优化策略:
- Bin-Packing(装箱) :将小任务打包到已部分使用的GPU和CPU上,消除资源碎片
- Spread(扩散) :在节点间均匀分布工作负载,提高 resiliency 和负载均衡
4.6 弹性工作负载(Elastic Workloads)
KAI Scheduler支持工作负载在最小和最大Pod数之间弹性伸缩,随集群负载动态调整。离线批处理推理等任务可以在资源可用时扩容,需求下降时缩容。
4.7 优先级与抢占(Priority & Preemption)
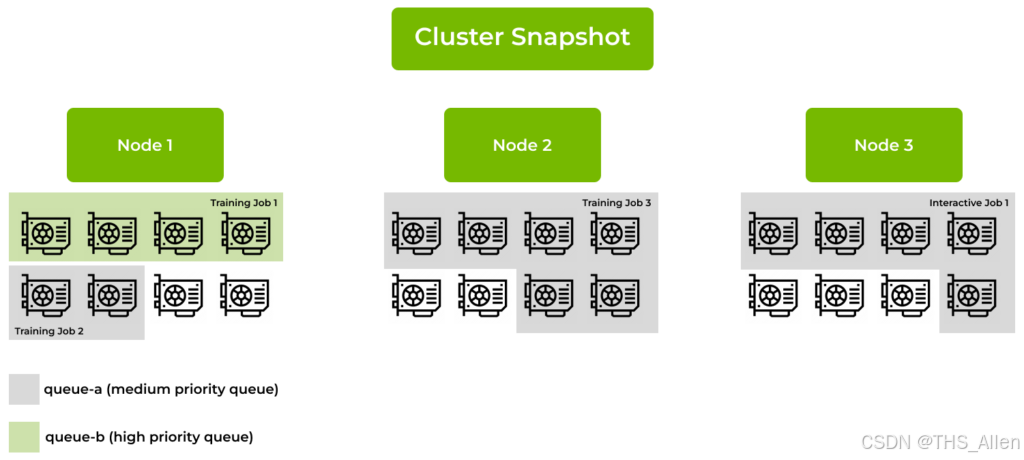
高优先级工作负载(如在线推理)可以自动抢占 低优先级工作负载(如离线训练),确保关键任务即使在集群满载时也能运行。
五、GPU硬隔离:HAMi-core集成
5.1 从"软共享"到"硬隔离"
KAI Scheduler的GPU分片共享功能有一个关键限制:它是"协作式"的 ------调度器确保请求的显存份额加起来不超过GPU总量,但不物理阻止某个工作负载超额使用显存 。一个请求2000MiB显存的容器,仍然可以通过nvidia-smi看到并使用完整GPU显存。
这在开发测试环境可以接受,但在生产环境的多租户场景下是致命短板。
5.2 HAMi-core集成方案
2026年6月,HAMi-core的GPU显存硬隔离能力 作为内置特性随KAI Scheduler v0.16.4正式发布。
集成采用松耦合设计:
调度层 :KAI Scheduler负责调度Pod,通过Admission组件向每个请求共享GPU显存的容器注入CUDA_DEVICE_MEMORY_LIMIT环境变量
隔离层 :kai-resource-isolator组件以DaemonSet形式将HAMi-core库部署到每个GPU节点,通过MutatingWebhook注入库和ld.so.preload配置
运行时 :libvgpu.so拦截CUDA内存分配调用,强制执行上限。容器内执行nvidia-smi只显示分配的显存切片,而非整张GPU
定位区分:KAI Scheduler = 决定"谁在什么时候用什么GPU"(调度层);HAMi-core = 确保"用了就只有这么多"(隔离层)
六、使用场景
6.1 大规模分布式训练
KAI Scheduler通过Gang Scheduling确保PyTorch、TensorFlow等分布式训练任务的所有Worker同时启动,避免部分Pod占着GPU等待的死锁。Kubeflow Trainer已原生集成KAI Scheduler。
6.2 多团队共享GPU集群
通过层级队列 和公平调度 ,不同部门可以分配到各自的GPU配额,同时支持借用和回收。配合vCluster ,可为每个团队提供隔离的Kubernetes控制平面,共享底层GPU节点。
6.3 推理与训练混合部署
高优先级的推理任务可以自动抢占 低优先级的训练任务,确保生产推理的响应性。KAI Scheduler已与KubeRay原生集成,支持Ray集群的Gang Scheduling和工作负载优先级。
6.4 GPU资源共享与成本优化
通过Fractional GPU ,多个小规模工作负载(如开发测试、Notebook)可以共享同一张GPU。配合Bin-Packing,最大化GPU利用率。
七、与其他方案的对比
| 特性 | kube-scheduler | Volcano | KAI Scheduler |
|---|---|---|---|
| Gang Scheduling | ❌ | ✅(需手动PodGroup) | ✅(自动PodGrouper) |
| GPU分片共享 | ❌ | ❌ | ✅ |
| 层级队列 | ❌ | ✅ | ✅ |
| 拓扑感知 | ❌ | ❌ | ✅ |
| GPU硬隔离 | ❌ | ❌ | ✅(v0.16.4+) |
| 抢占调度 | ✅(基础) | ✅ | ✅(AI优化) |
| CNCF状态 | 毕业 | 孵化 | Sandbox |
Volcano已成为分布式训练的主流选择,但KAI Scheduler的独特优势在于轻量级、深度GPU集成和自动化的PodGroup识别。
八、实践指南
8.1 安装部署(启用GPU共享与硬隔离)
bash
# 安装KAI Scheduler v0.16.4+,启用GPU共享和HAMi-core
helm install kai-scheduler oci://ghcr.io/nvidia/kai-scheduler \
  --version v0.16.4 \
  --set global.gpuSharing=true \
  --set binder.plugins.hamicore.enabled=true \
  --namespace kai-scheduler --create-namespace

# 部署kai-resource-isolator(节点侧组件)
helm install kai-resource-isolator \
  oci://docker.io/projecthami/kai-resource-isolator \
  --namespace kai-resource-isolator --create-namespace \
  --version 1.0.0-chart
8.2 提交GPU共享工作负载
yaml
apiVersion: v1
kind: Pod
metadata:
  name: gpu-shared-pod
  annotations:
    kai.scheduler/queue: "team-a"          # 指定队列
    kai.scheduler/gpu-fraction: "0.5"      # 请求50% GPU
spec:
  schedulerName: kai-scheduler
  containers:
  - name: main
    image: nvidia/cuda:12.0-base
    resources:
      limits:
        nvidia.com/gpu: 1                   # 共享1张GPU的50%
8.3 与Kubeflow集成
在TrainingRuntime中设置schedulerName: kai-scheduler即可启用:
yaml
apiVersion: kubeflow.org/v1
kind: TrainingRuntime
spec:
  schedulerName: kai-scheduler
  # ...
九、总结
KAI Scheduler是Kubernetes从"通用容器编排平台"向"AI操作系统"演进的关键组件之一。从技术角度看:
- 架构层面:继承kube-batch的批处理调度理念,采用Session-Action驱动和本地缓存优化,实现了全局最优的调度决策
- 功能层面:Gang Scheduling、层级队列、GPU分片、拓扑感知、抢占调度五大核心能力,覆盖了AI工作负载调度的全场景需求
- 生态层面:与Kubeflow、KubeRay、vCluster等生态深度集成,已被CNCF接纳为Sandbox项目
对于正在Kubernetes上运行或计划运行AI工作负载的团队,KAI Scheduler提供了一个生产级、开源、Kubernetes原生的调度解决方案。尤其是v0.16.4引入的HAMi-core硬隔离能力,使其在多租户生产环境中的可用性大幅提升。