1 项目需求
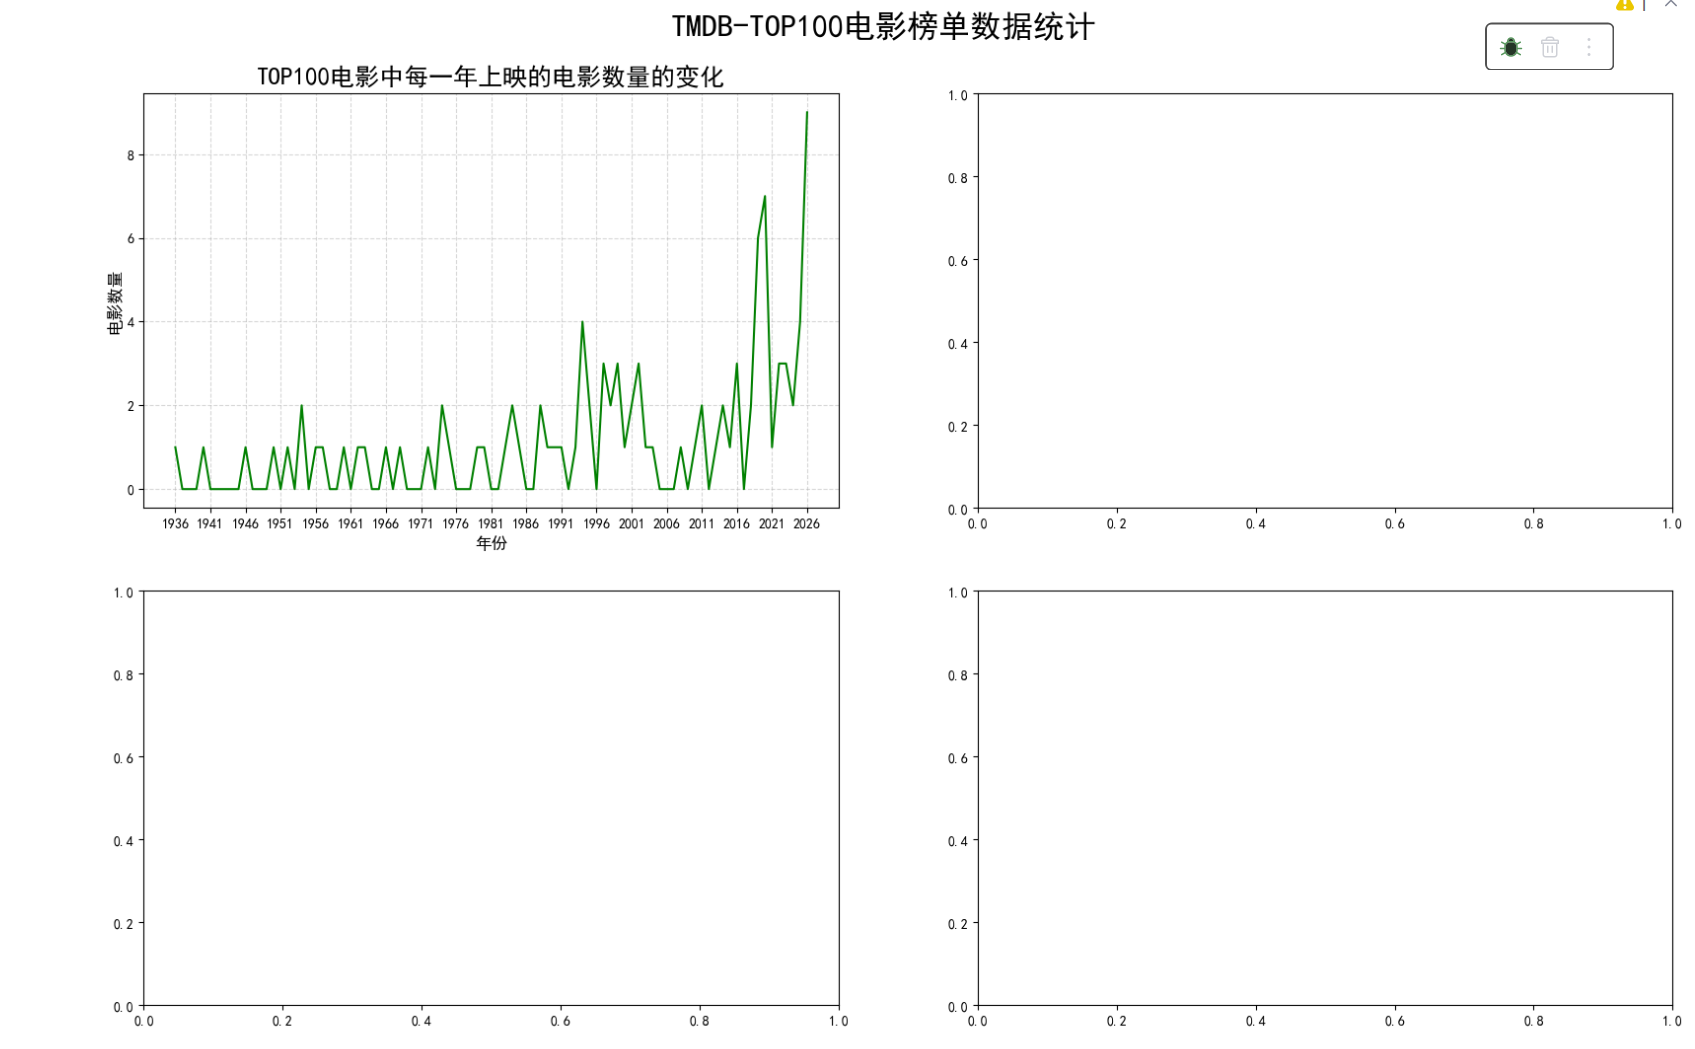
- 需求 1:统计 TOP300 的电影中,每一年上映的电影数量的变化。(折线图)
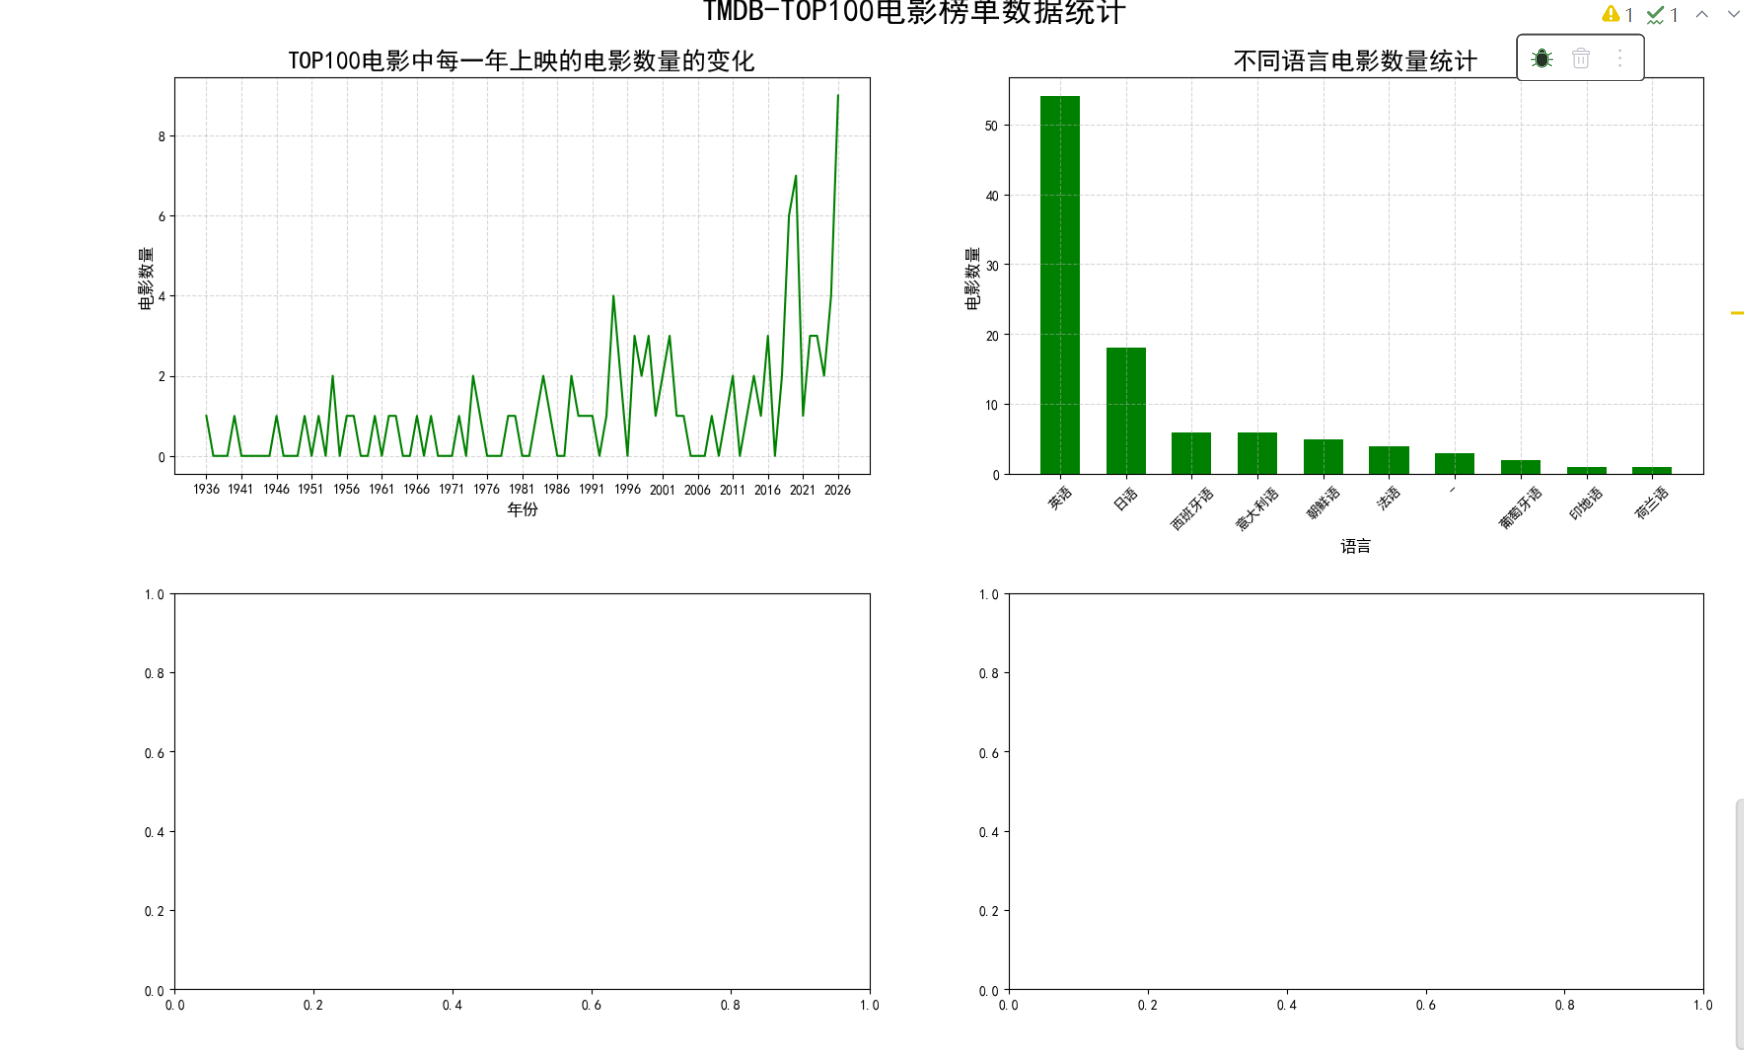
- 需求 2:统计对比不同语言电影数量。(柱状图)
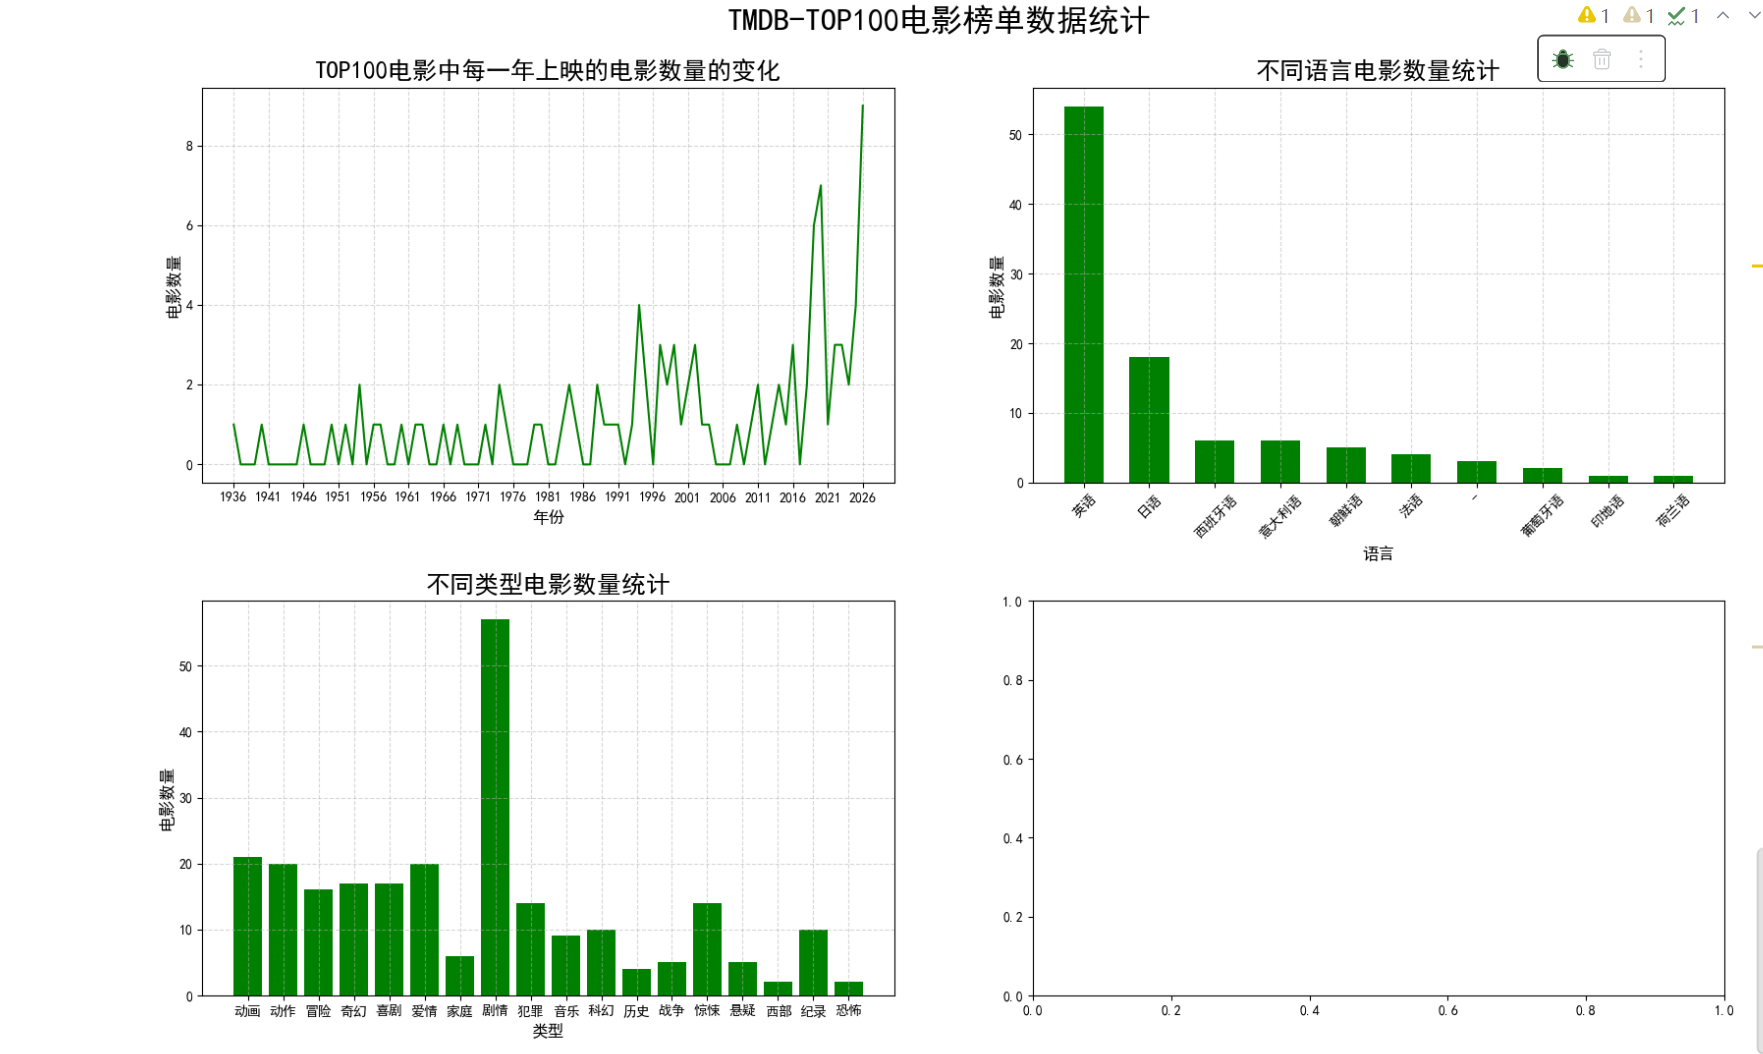
- 需求 3:统计对比不同类型电影数量。(柱状图)
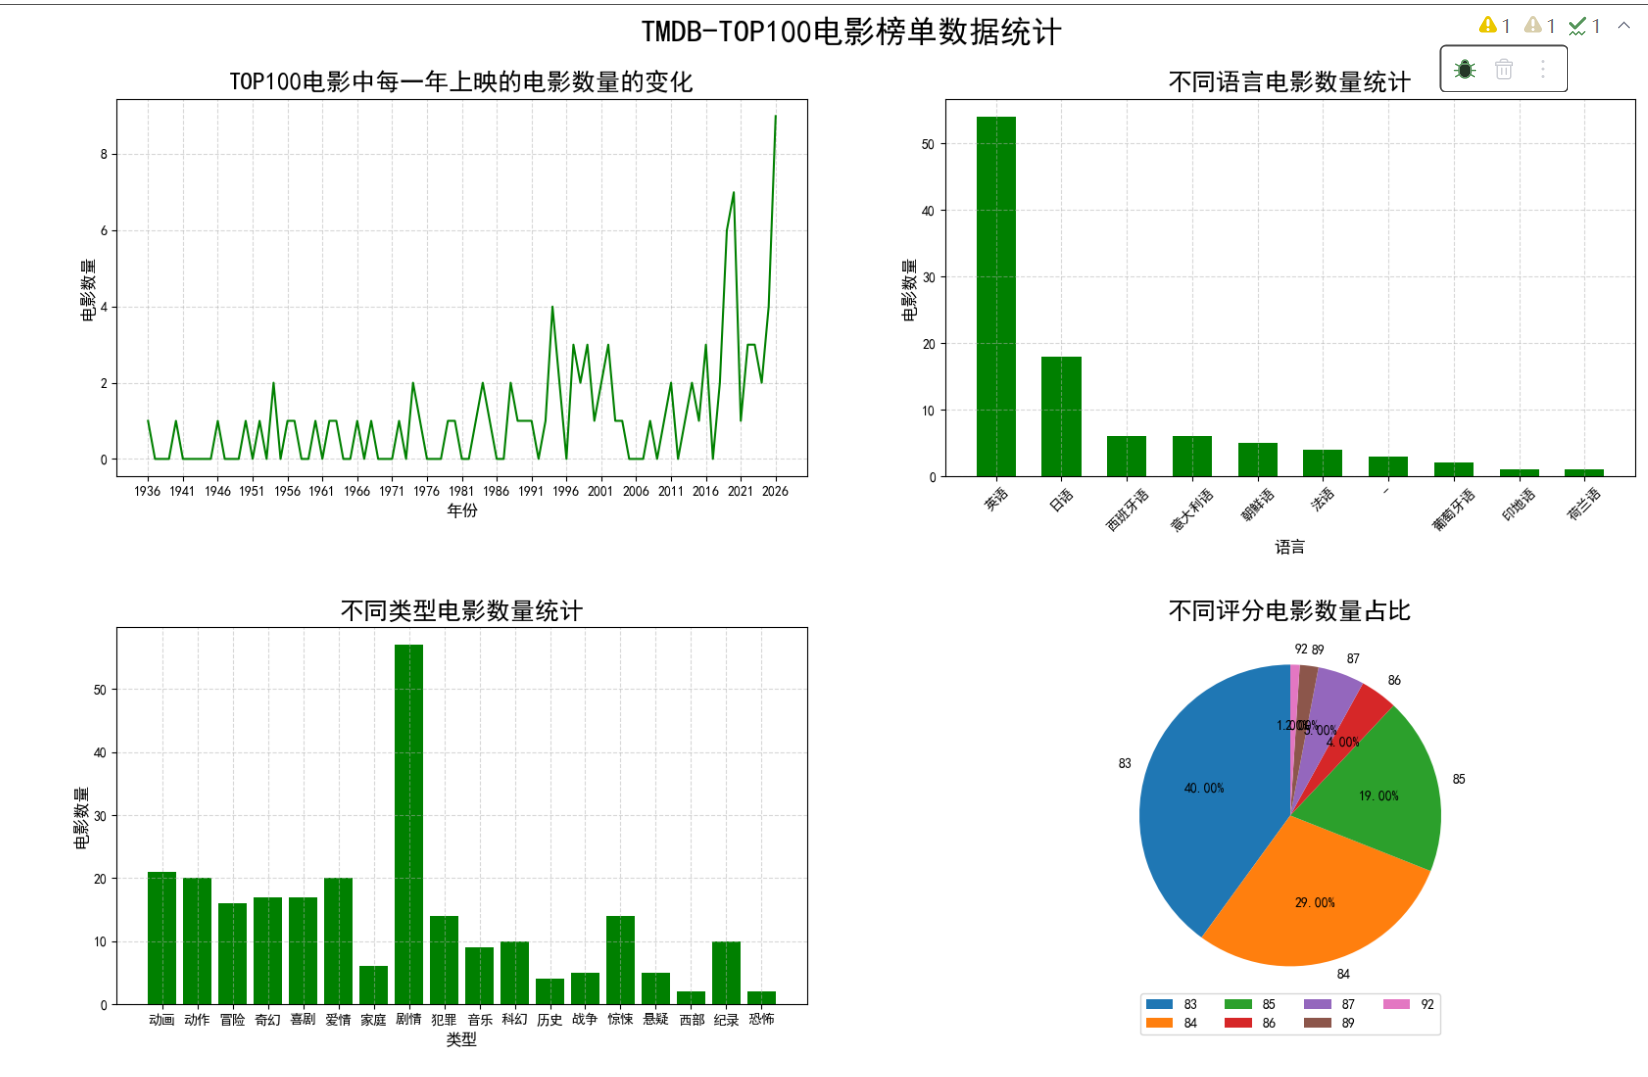
- 需求 4:统计对比各个电影评分的比例。(饼状图)
2 项目流程
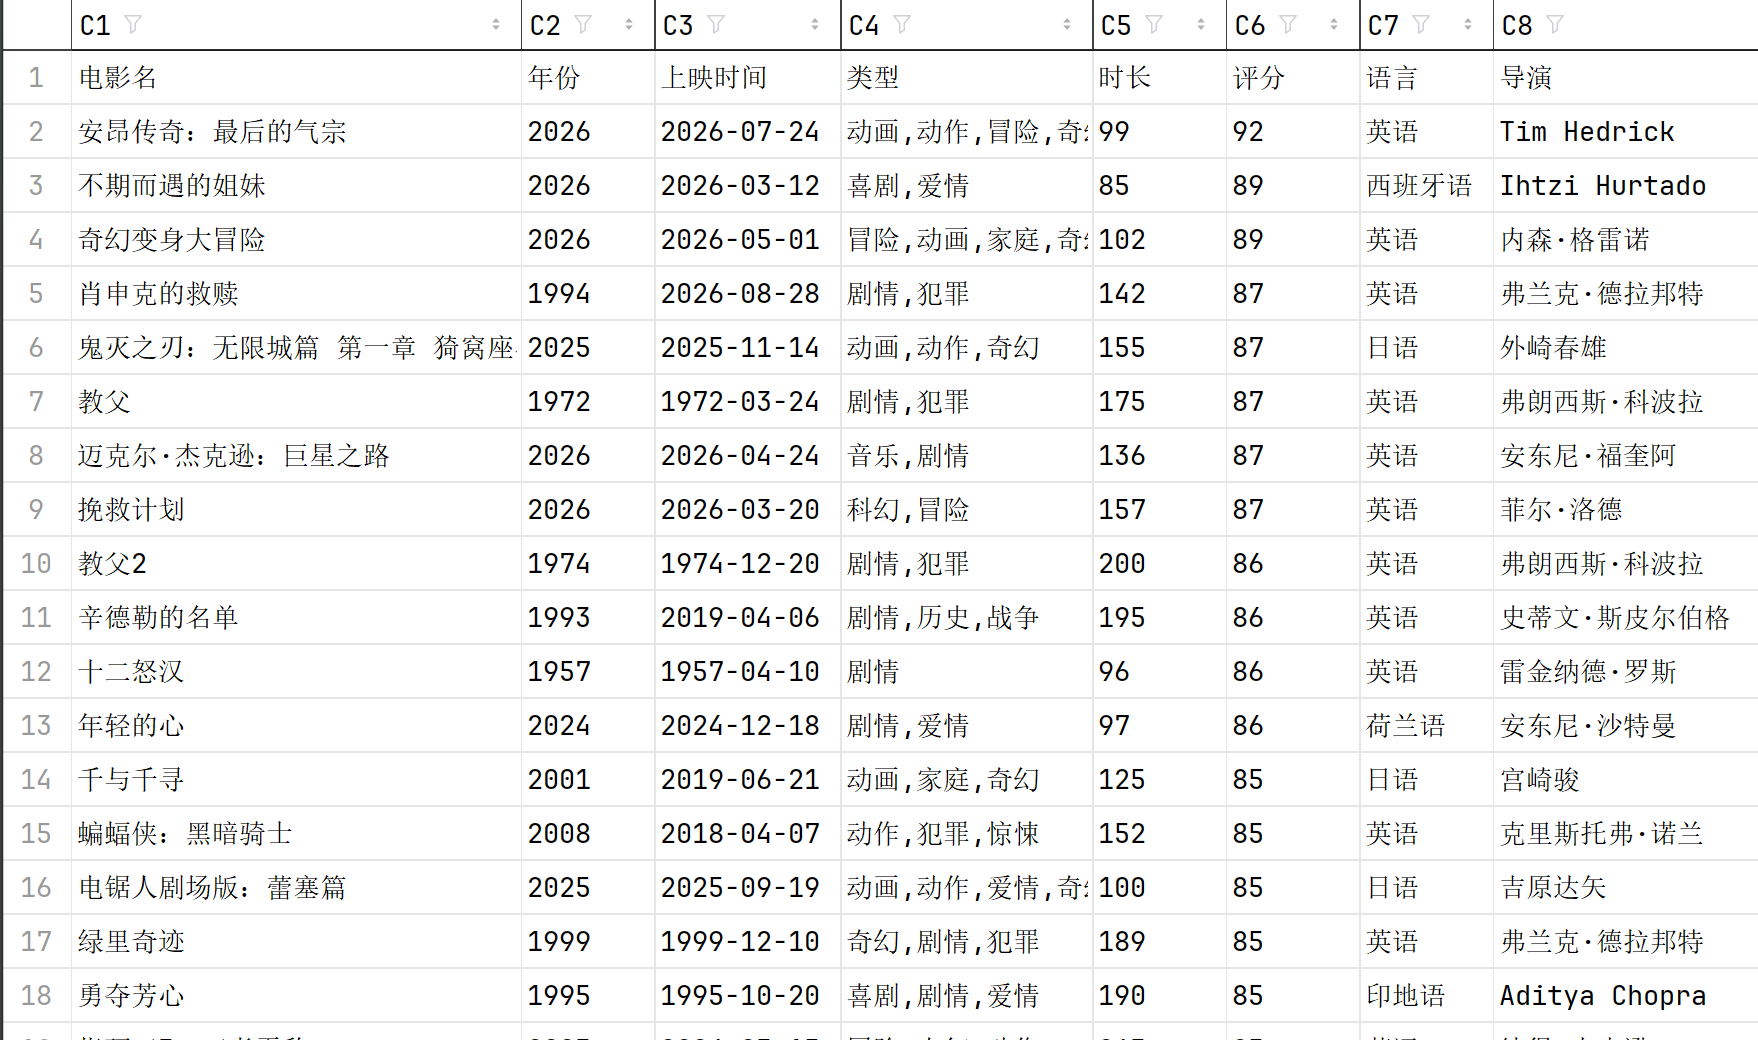
- 准备工作:导入依赖库、配置运行时参数、创建子图完成基本布局、加载数据
- 统计 TOP100 的电影中,每一年上映的电影数量的变化(折线图)
- 统计对比不同语言电影数量(柱状图)
- 统计对比不同类型电影数量(柱状图)
- 统计对比各个电影评分的比例(饼状图)
2.1 准备工作
导入依赖库、配置运行时参数、创建子图完成基本布局、加载数据.
相关代码操作如下:
from matplotlib.axes import Axes
import pandas as pd
import matplotlib.pyplot as plt

#展示中文
plt.rcParams['font.sans-serif'] = ['SimHei']

#创建子图
fig,ax = plt.subplots(nrows=2, ncols=2, figsize=(20, 12), dpi=100)
fig.suptitle('TMDB-TOP100电影榜单数据统计', x=0.5, y=0.95, fontsize=23) #添加画布标题 x:X轴位置;y:Y轴位置

#获取子图
ax1: Axes = ax[0,0]
ax2: Axes = ax[0,1]
ax3: Axes = ax[1,0]
ax4: Axes = ax[1,1]

#加载数据
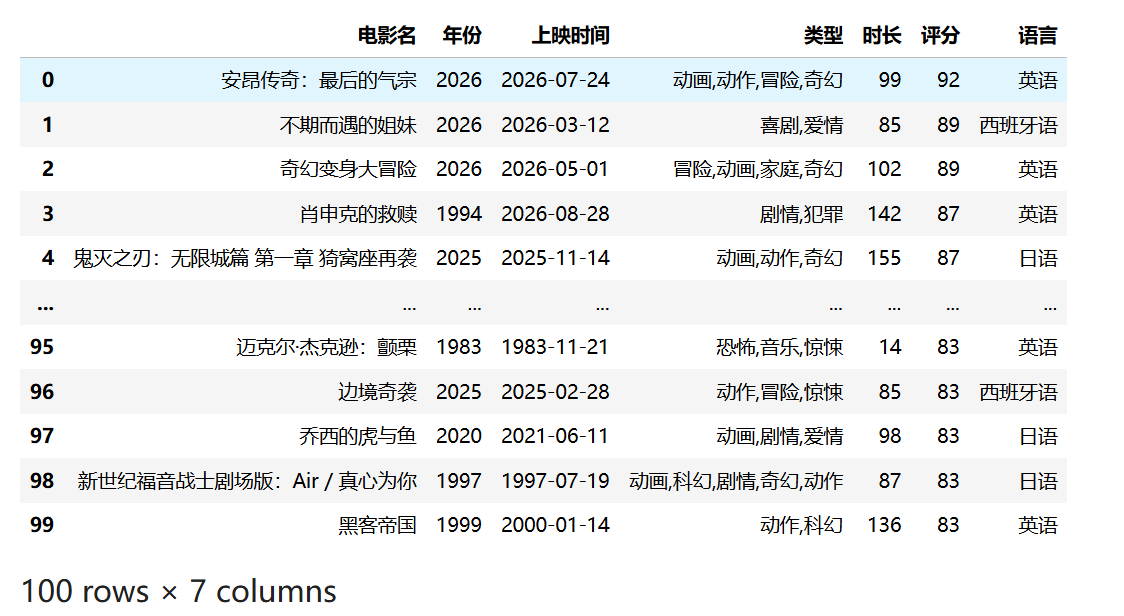
data = pd.read_csv('../Data/movie_list3.csv', usecols=['电影名', '年份', '上映时间', '类型', '时长', '评分', '语言'], dtype={'年份': 'Int64'})
data
输出结果如下:
2.2 统计 TOP100 的电影中,每一年上映的电影数量的变化
相关操作代码如下:
from matplotlib.axes import Axes
import pandas as pd
import matplotlib.pyplot as plt

#展示中文
plt.rcParams['font.sans-serif'] = ['SimHei']

#创建子图
fig,ax = plt.subplots(nrows=2, ncols=2, figsize=(20, 12), dpi=100)
fig.suptitle('TMDB-TOP100电影榜单数据统计', x=0.5, y=0.95, fontsize=23) #添加画布标题 x:X轴位置;y:Y轴位置

#获取子图
ax1: Axes = ax[0,0]
ax2: Axes = ax[0,1]
ax3: Axes = ax[1,0]
ax4: Axes = ax[1,1]

#加载数据
data = pd.read_csv('../Data/movie_list3.csv', usecols=['电影名', '年份', '上映时间', '类型', '时长', '评分', '语言'])

#1.统计TOP100电影中每一年上映的电影数量的变化

#1.1 缺失值,异常值查询与处理
data.isnull().sum()   #查询缺失值
data[data['年份']>2027] #查询异常值

#1.2 分组统计
year_count = data.groupby('年份')['年份'].count()

#1.3 组装数据
#x轴数据
min_year = year_count.index.min()
max_year = year_count.index.max()
x = [i for i in range(min_year, max_year+1)]

#y轴数据
y = [int(year_count.get(i, 0)) for i in x] #get(i,0):获取i对应的值,如果不存在则返回0

#1.4 绘制折线图
ax1.plot(x, y, color='g')
ax1.set_title('TOP100电影中每一年上映的电影数量的变化', fontsize=18)
ax1.set_xlabel('年份', fontsize=12)
ax1.set_ylabel('电影数量', fontsize=12)
ax1.set_xticks(x[::5]) #设置x轴刻度
y_ticks = [i for i in range(0,10,2)]
ax1.set_yticks(y_ticks) #设置y轴刻度
ax1.grid(linestyle='--', alpha=0.5) #添加网格线
最终输出结果如下:
2.3 统计对比不同语言电影数量
相关操作代码如下:
from matplotlib.axes import Axes
import pandas as pd
import matplotlib.pyplot as plt

#展示中文
plt.rcParams['font.sans-serif'] = ['SimHei']

#创建子图
fig,ax = plt.subplots(nrows=2, ncols=2, figsize=(20, 12), dpi=100)
fig.subplots_adjust(hspace=0.3, wspace=0.2) #调整子图间距,hspace:控制垂直间距;wspace:控制水平间距
fig.suptitle('TMDB-TOP100电影榜单数据统计', x=0.5, y=0.95, fontsize=23) #添加画布标题 x:X轴位置;y:Y轴位置

#获取子图
ax1: Axes = ax[0,0]
ax2: Axes = ax[0,1]
ax3: Axes = ax[1,0]
ax4: Axes = ax[1,1]

#加载数据
data = pd.read_csv('../Data/movie_list3.csv', usecols=['电影名', '年份', '上映时间', '类型', '时长', '评分', '语言'])

#1.统计TOP100电影中每一年上映的电影数量的变化(折线图)

#1.1 缺失值,异常值查询与处理
data.isnull().sum()   #查询缺失值
data[data['年份']>2027] #查询异常值

#1.2 分组统计
year_count = data.groupby('年份')['年份'].count()

#1.3 组装数据
#x轴数据
min_year = year_count.index.min()
max_year = year_count.index.max()
x = [i for i in range(min_year, max_year+1)]

#y轴数据
y = [int(year_count.get(i, 0)) for i in x] #get(i,0):获取i对应的值,如果不存在则返回0

#1.4 绘制折线图
ax1.plot(x, y, color='g')
ax1.set_title('TOP100电影中每一年上映的电影数量的变化', fontsize=18)
ax1.set_xlabel('年份', fontsize=12)
ax1.set_ylabel('电影数量', fontsize=12)
ax1.set_xticks(x[::5]) #设置x轴刻度
y_ticks = [i for i in range(0,10,2)]
ax1.set_yticks(y_ticks) #设置y轴刻度
ax1.grid(linestyle='--', alpha=0.5) #添加网格线

#2.不同语言电影数量统计(柱状图)

#2.1 获取不同语言对应的电影数量
language_count = data.groupby('语言')['语言'].count().sort_values(ascending=False)

#2.2 组装数据
x = language_count.index.tolist()
y = language_count.values.tolist()

#2.3 绘制柱状图
ax2.bar(x, y, color='g', width=0.6)
ax2.set_title('不同语言电影数量统计', fontsize=18) #添加子图标题
ax2.set_xlabel('语言', fontsize=12) #添加x轴标签
ax2.set_ylabel('电影数量', fontsize=12) #添加y轴标签
ax2.grid(linestyle='--', alpha=0.5) #添加网格线

ax2.tick_params(axis='x', rotation=45) #旋转x轴刻度标签
最终输出结果如下:
2.4 统计对比不同类型电影数量
相关操作代码如下:
from matplotlib.axes import Axes
import pandas as pd
import matplotlib.pyplot as plt

#展示中文
plt.rcParams['font.sans-serif'] = ['SimHei']

#创建子图
fig,ax = plt.subplots(nrows=2, ncols=2, figsize=(20, 12), dpi=100)
fig.subplots_adjust(hspace=0.3, wspace=0.2) #调整子图间距,hspace:控制垂直间距;wspace:控制水平间距
fig.suptitle('TMDB-TOP100电影榜单数据统计', x=0.5, y=0.95, fontsize=23) #添加画布标题 x:X轴位置;y:Y轴位置

#获取子图
ax1: Axes = ax[0,0]
ax2: Axes = ax[0,1]
ax3: Axes = ax[1,0]
ax4: Axes = ax[1,1]

#加载数据
data = pd.read_csv('../Data/movie_list3.csv', usecols=['电影名', '年份', '上映时间', '类型', '时长', '评分', '语言'])

#1.统计TOP100电影中每一年上映的电影数量的变化(折线图)

#1.1 缺失值,异常值查询与处理
data.isnull().sum()   #查询缺失值
data[data['年份']>2027] #查询异常值

#1.2 分组统计
year_count = data.groupby('年份')['年份'].count()

#1.3 组装数据
#x轴数据
min_year = year_count.index.min()
max_year = year_count.index.max()
x = [i for i in range(min_year, max_year+1)]

#y轴数据
y = [int(year_count.get(i, 0)) for i in x] #get(i,0):获取i对应的值,如果不存在则返回0

#1.4 绘制折线图
ax1.plot(x, y, color='g')
ax1.set_title('TOP100电影中每一年上映的电影数量的变化', fontsize=18)
ax1.set_xlabel('年份', fontsize=12)
ax1.set_ylabel('电影数量', fontsize=12)
ax1.set_xticks(x[::5]) #设置x轴刻度
y_ticks = [i for i in range(0,10,2)]
ax1.set_yticks(y_ticks) #设置y轴刻度
ax1.grid(linestyle='--', alpha=0.5) #添加网格线

#2.不同语言电影数量统计(柱状图)

#2.1 获取不同语言对应的电影数量
language_count = data.groupby('语言')['语言'].count().sort_values(ascending=False)

#2.2 组装数据
x = language_count.index.tolist()
y = language_count.values.tolist()

#2.3 绘制柱状图
ax2.bar(x, y, color='g', width=0.6)
ax2.set_title('不同语言电影数量统计', fontsize=18) #添加子图标题
ax2.set_xlabel('语言', fontsize=12) #添加x轴标签
ax2.set_ylabel('电影数量', fontsize=12) #添加y轴标签
ax2.grid(linestyle='--', alpha=0.5) #添加网格线
ax2.tick_params(axis='x', rotation=45) #旋转x轴刻度标签

#3.统计对比不同类型电影数量(柱状图)

#3.1 获取不同类型对应的电影数量
type_count = {} #{'类型1':数量, '类型2':数量, ...}
for types in data['类型'].str.split(','):
    for type in types:
        if type in type_count:
            type_count[type] += 1
        else:
            type_count[type] = 1

#3.2 组装数据
x = list(type_count.keys())
y = list(type_count.values())

#3.3 绘制柱状图
ax3.bar(x, y, color='g', width=0.8)
ax3.set_title('不同类型电影数量统计', fontsize=18)
ax3.set_xlabel('类型', fontsize=12)
ax3.set_ylabel('电影数量', fontsize=12)
ax3.grid(linestyle='--', alpha=0.5)
最终输出结果如下:
2.5 统计对比各个电影评分的比例
相关操作代码如下:
from matplotlib.axes import Axes
import pandas as pd
import matplotlib.pyplot as plt

#展示中文
plt.rcParams['font.sans-serif'] = ['SimHei']

#创建子图
fig,ax = plt.subplots(nrows=2, ncols=2, figsize=(20, 12), dpi=100)
fig.subplots_adjust(hspace=0.4, wspace=0.2) #调整子图间距,hspace:控制垂直间距;wspace:控制水平间距
fig.suptitle('TMDB-TOP100电影榜单数据统计', x=0.5, y=0.95, fontsize=23) #添加画布标题 x:X轴位置;y:Y轴位置

#获取子图
ax1: Axes = ax[0,0]
ax2: Axes = ax[0,1]
ax3: Axes = ax[1,0]
ax4: Axes = ax[1,1]

#加载数据
data = pd.read_csv('../Data/movie_list3.csv', usecols=['电影名', '年份', '上映时间', '类型', '时长', '评分', '语言'])

#1.统计TOP100电影中每一年上映的电影数量的变化(折线图)

#1.1 缺失值,异常值查询与处理
data.isnull().sum()   #查询缺失值
data[data['年份']>2027] #查询异常值

#1.2 分组统计
year_count = data.groupby('年份')['年份'].count()

#1.3 组装数据
#x轴数据
min_year = year_count.index.min()
max_year = year_count.index.max()
x = [i for i in range(min_year, max_year+1)]

#y轴数据
y = [int(year_count.get(i, 0)) for i in x] #get(i,0):获取i对应的值,如果不存在则返回0

#1.4 绘制折线图
ax1.plot(x, y, color='g')
ax1.set_title('TOP100电影中每一年上映的电影数量的变化', fontsize=18)
ax1.set_xlabel('年份', fontsize=12)
ax1.set_ylabel('电影数量', fontsize=12)
ax1.set_xticks(x[::5]) #设置x轴刻度
y_ticks = [i for i in range(0,10,2)]
ax1.set_yticks(y_ticks) #设置y轴刻度
ax1.grid(linestyle='--', alpha=0.5) #添加网格线

#2.不同语言电影数量统计(柱状图)

#2.1 获取不同语言对应的电影数量
language_count = data.groupby('语言')['语言'].count().sort_values(ascending=False)

#2.2 组装数据
x = language_count.index.tolist()
y = language_count.values.tolist()

#2.3 绘制柱状图
ax2.bar(x, y, color='g', width=0.6)
ax2.set_title('不同语言电影数量统计', fontsize=18) #添加子图标题
ax2.set_xlabel('语言', fontsize=12) #添加x轴标签
ax2.set_ylabel('电影数量', fontsize=12) #添加y轴标签
ax2.grid(linestyle='--', alpha=0.5) #添加网格线
ax2.tick_params(axis='x', rotation=45) #旋转x轴刻度标签

#3.统计对比不同类型电影数量(柱状图)

#3.1 获取不同类型对应的电影数量
type_count = {} #{'类型1':数量, '类型2':数量, ...}
for types in data['类型'].str.split(','):
    for type in types:
        if type in type_count:
            type_count[type] += 1
        else:
            type_count[type] = 1

#3.2 组装数据
x = list(type_count.keys())
y = list(type_count.values())

#3.3 绘制柱状图
ax3.bar(x, y, color='g', width=0.8)
ax3.set_title('不同类型电影数量统计', fontsize=18)
ax3.set_xlabel('类型', fontsize=12)
ax3.set_ylabel('电影数量', fontsize=12)
ax3.grid(linestyle='--', alpha=0.5)

#4.统计不同评分电影数量占比

#4.1 获取不同评分对应的电影数量
rating_count = data.groupby('评分')['评分'].count()

#4.2 组装数据
ratings = rating_count.index.tolist() #评分列表
rating_values = rating_count.values.tolist()

#4.2 绘制饼状图
ax4.pie(rating_values, labels=ratings, autopct='%1.2f%%', startangle=90) #startangle:起始角度
ax4.set_title('不同评分电影数量占比', fontsize=18) #添加子图标题
ax4.legend(loc='lower center', ncol=4, fontsize=10, bbox_to_anchor=(0.5, -0.1))
最终输出结果如下:
3 饼状图优化
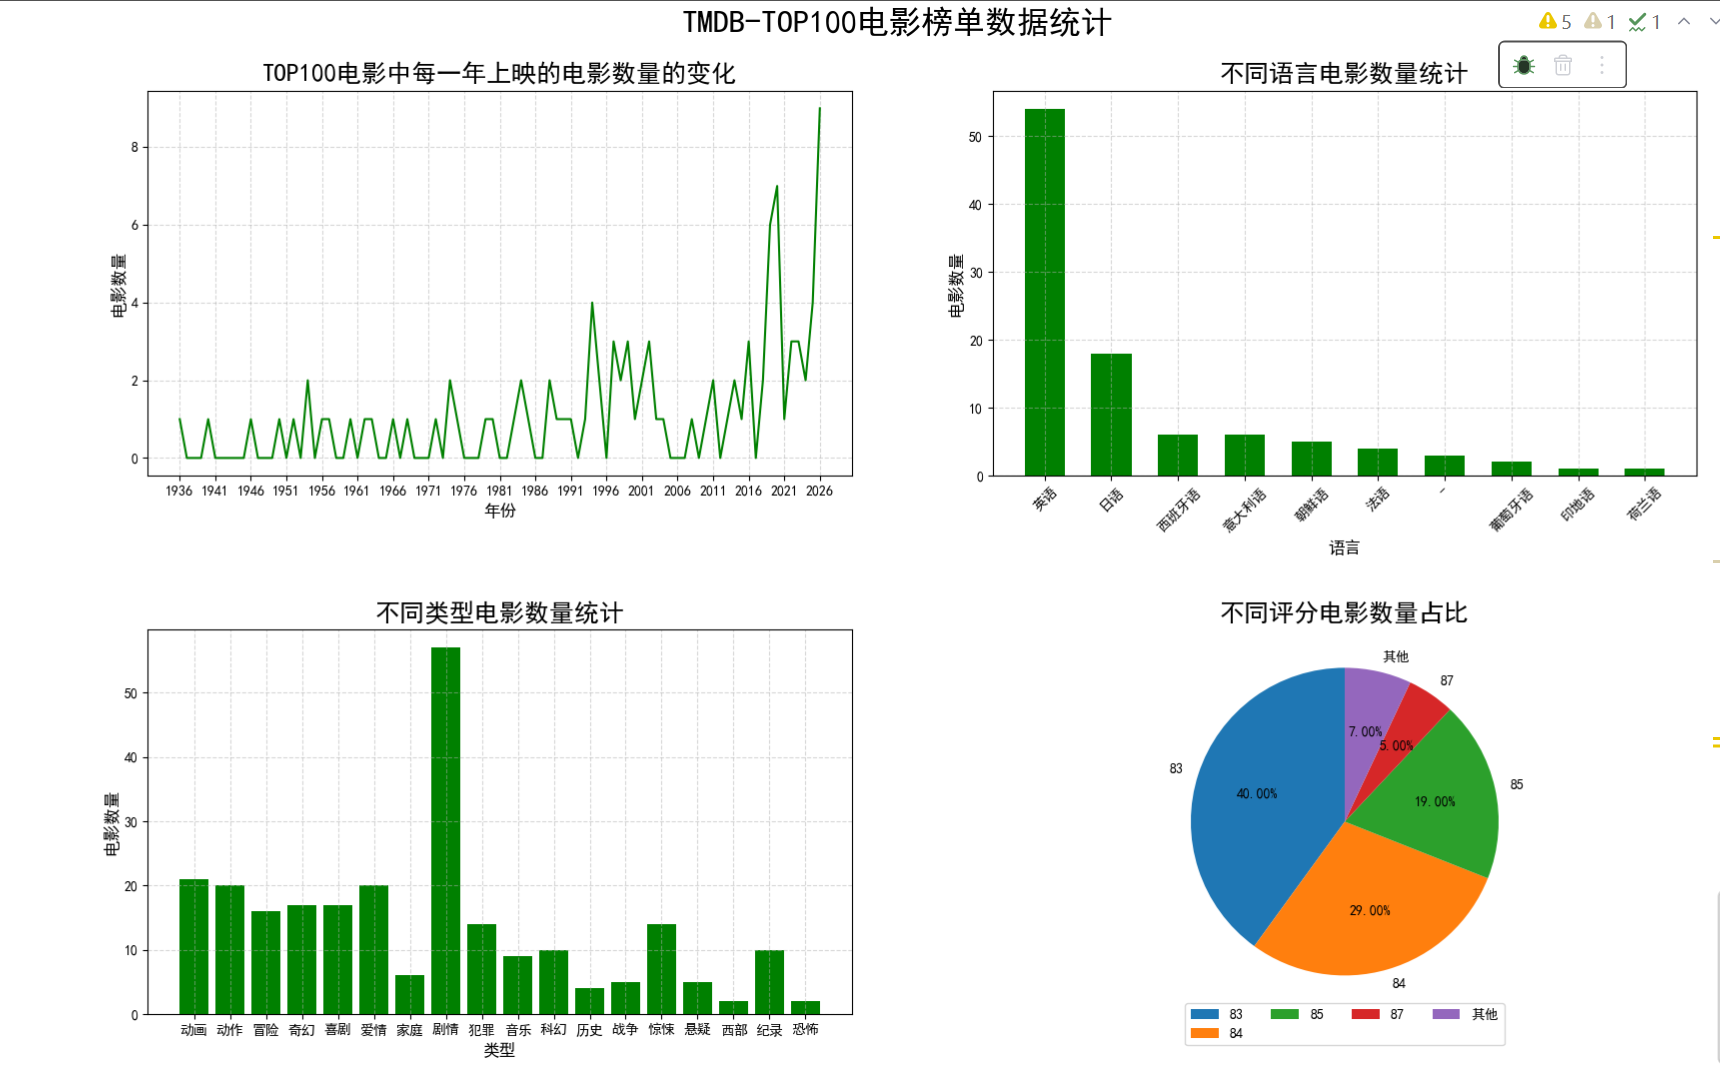
由最终输出结果可以直观看出第 4 张饼状图部分数据展示过于密集而造成展示不清晰,本节将对该问题进行优化。
核心思路是:将小数据(比例小于5%)进行合并
from matplotlib.axes import Axes
import pandas as pd
import matplotlib.pyplot as plt

#展示中文
plt.rcParams['font.sans-serif'] = ['SimHei']

#创建子图
fig,ax = plt.subplots(nrows=2, ncols=2, figsize=(20, 12), dpi=100)
fig.subplots_adjust(hspace=0.4, wspace=0.2) #调整子图间距,hspace:控制垂直间距;wspace:控制水平间距
fig.suptitle('TMDB-TOP100电影榜单数据统计', x=0.5, y=0.95, fontsize=23) #添加画布标题 x:X轴位置;y:Y轴位置

#获取子图
ax1: Axes = ax[0,0]
ax2: Axes = ax[0,1]
ax3: Axes = ax[1,0]
ax4: Axes = ax[1,1]

#加载数据
data = pd.read_csv('../Data/movie_list3.csv', usecols=['电影名', '年份', '上映时间', '类型', '时长', '评分', '语言'])

#1.统计TOP100电影中每一年上映的电影数量的变化(折线图)

#1.1 缺失值,异常值查询与处理
data.isnull().sum()   #查询缺失值
data[data['年份']>2027] #查询异常值

#1.2 分组统计
year_count = data.groupby('年份')['年份'].count()

#1.3 组装数据
#x轴数据
min_year = year_count.index.min()
max_year = year_count.index.max()
x = [i for i in range(min_year, max_year+1)]

#y轴数据
y = [int(year_count.get(i, 0)) for i in x] #get(i,0):获取i对应的值,如果不存在则返回0

#1.4 绘制折线图
ax1.plot(x, y, color='g')
ax1.set_title('TOP100电影中每一年上映的电影数量的变化', fontsize=18)
ax1.set_xlabel('年份', fontsize=12)
ax1.set_ylabel('电影数量', fontsize=12)
ax1.set_xticks(x[::5]) #设置x轴刻度
y_ticks = [i for i in range(0,10,2)]
ax1.set_yticks(y_ticks) #设置y轴刻度
ax1.grid(linestyle='--', alpha=0.5) #添加网格线

#2.不同语言电影数量统计(柱状图)

#2.1 获取不同语言对应的电影数量
language_count = data.groupby('语言')['语言'].count().sort_values(ascending=False)

#2.2 组装数据
x = language_count.index.tolist()
y = language_count.values.tolist()

#2.3 绘制柱状图
ax2.bar(x, y, color='g', width=0.6)
ax2.set_title('不同语言电影数量统计', fontsize=18) #添加子图标题
ax2.set_xlabel('语言', fontsize=12) #添加x轴标签
ax2.set_ylabel('电影数量', fontsize=12) #添加y轴标签
ax2.grid(linestyle='--', alpha=0.5) #添加网格线
ax2.tick_params(axis='x', rotation=45) #旋转x轴刻度标签

#3.统计对比不同类型电影数量(柱状图)

#3.1 获取不同类型对应的电影数量
type_count = {} #{'类型1':数量, '类型2':数量, ...}
for types in data['类型'].str.split(','):
    for type in types:
        if type in type_count:
            type_count[type] += 1
        else:
            type_count[type] = 1

#3.2 组装数据
x = list(type_count.keys())
y = list(type_count.values())

#3.3 绘制柱状图
ax3.bar(x, y, color='g', width=0.8)
ax3.set_title('不同类型电影数量统计', fontsize=18)
ax3.set_xlabel('类型', fontsize=12)
ax3.set_ylabel('电影数量', fontsize=12)
ax3.grid(linestyle='--', alpha=0.5)

#4.统计不同评分电影数量占比

#4.1 获取不同评分对应的电影数量
rating_count = data.groupby('评分')['评分'].count()

#4.2 合并小数据(比例小于5%的数据进行合并)
threshold = 0.05
total = rating_count.sum()
large_rating_count = rating_count.loc[rating_count >= total * threshold]  #大数据,比例 >= 5%
small_rating_count = rating_count.loc[rating_count < total * threshold]  #小数据,比例 < 5%

if small_rating_count.shape[0] > 0:
    large_rating_count['其他'] = small_rating_count.sum()

#4.3 组装数据
ratings = large_rating_count.index.tolist() #评分列表
rating_values = large_rating_count.values.tolist()

#4.4 绘制饼状图
ax4.pie(rating_values, labels=ratings, autopct='%1.2f%%', startangle=90) #startangle:起始角度
ax4.set_title('不同评分电影数量占比', fontsize=18) #添加子图标题
ax4.legend(loc='lower center', ncol=4, fontsize=10, bbox_to_anchor=(0.5, -0.1))

#5.保存图片
plt.savefig('../Data/02.png')
最终输出结果如下:
4.🎇更多干货
🥰关注我 学习更多AI知识~
🥰支持我,请 点赞 + 好评 + 收藏 三连,带来更多文章~
🥰有需要完整源码的同学可以留言、后台私信我