前一阵,我一直在 TRAE Code 里使用 DeepSeek Flash。
原因也很现实:真的便宜。
虽然最近价格高了一点,但和其他一些模型相比,整体成本仍然不算高。日常改代码、整理项目、生成简单页面时,可以比较放心地多跑几轮,不用每次都惦记调用成本。
但它也有一个很明显的短板:没有 Vision 能力。
写普通代码时,这个问题不算突出。但一旦做网页复刻,它看不到原始设计图,也看不到浏览器最终渲染出来的页面,只能根据文字描述和代码推测效果。
代码可以运行,页面也能打开,可最终长成什么样,它自己并不知道。
所以 deepseek-v4-flash-vision-exp 出来后,我很快在 TRAE Code 里接入了它,重新做了一次之前的网页复刻 Demo。
任务很简单。
1比1复刻图片中的网页,直接采用html+css,不需要受限于任何框架,充分发挥你的设计能力,保证设计效果一致。 图片如果可以截取就截取,如果不方便,直接采用展位图片Lorem Picsum
设计图如下,我尝试了全图,效果还不是很好,为了更好地对比,案例只截取了一部分。
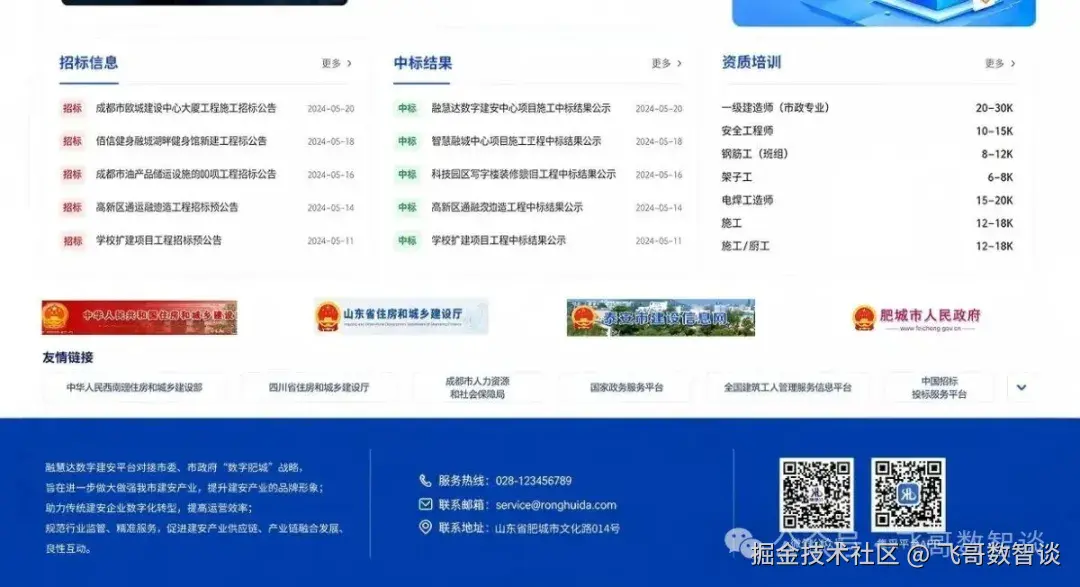
第一次生成速度挺快,代码可以正常运行,页面的大体结构也出来了。
顶部的招标信息、中标结果、资质培训三栏,中间的合作单位和友情链接,以及底部的蓝色页脚,基本都识别到了。
如果只是看"网页有没有做出来",这次任务已经算完成。
但真正把生成结果和原图放在一起,问题还是很明显。
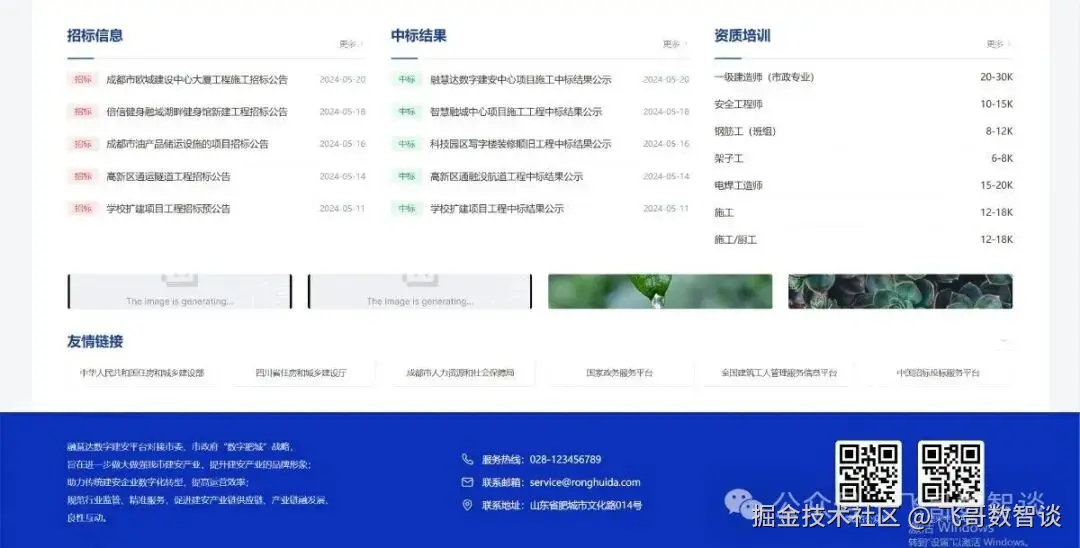
中间四张单位横幅,前两张还停留在 The image is generating...,后两张直接变成了无关的植物图片。
友情链接右侧的展开箭头,本来应该和按钮在同一行,结果跑到了标题旁边。
列表中多出了明显的虚线分隔,页脚三个区块之间应该有的竖线却没有了。
页面能运行,结构也差不多,但离"复刻"还是有一段距离。
第一轮只是看懂,第二轮开始反馈
接下来,我没有逐项告诉它应该怎么改,只把第一次生成后的页面截图重新传了进去,并补了一句:
附件是生成的网页,仔细对比原图和生成网页,一个个修复不一样的地方,如果是因为缺少图片资源,可以采用占位图
这一次,Vision 的作用就明显了。
它先对比原图和生成结果,主动找出了几个差异:
-
政府单位横幅图片不对;
-
友情链接箭头位置不对;
-
列表中多出了分隔线;
-
页脚缺少竖向分隔。
然后,它根据这些问题重新修改代码。
第二次生成后,前两张一直加载失败的图片被换成了红色和蓝色的文字横幅,后两张无关的植物图片也被重新处理;友情链接箭头回到了按钮行右侧;列表中的多余虚线被去掉;页脚三个区块之间也增加了竖线。
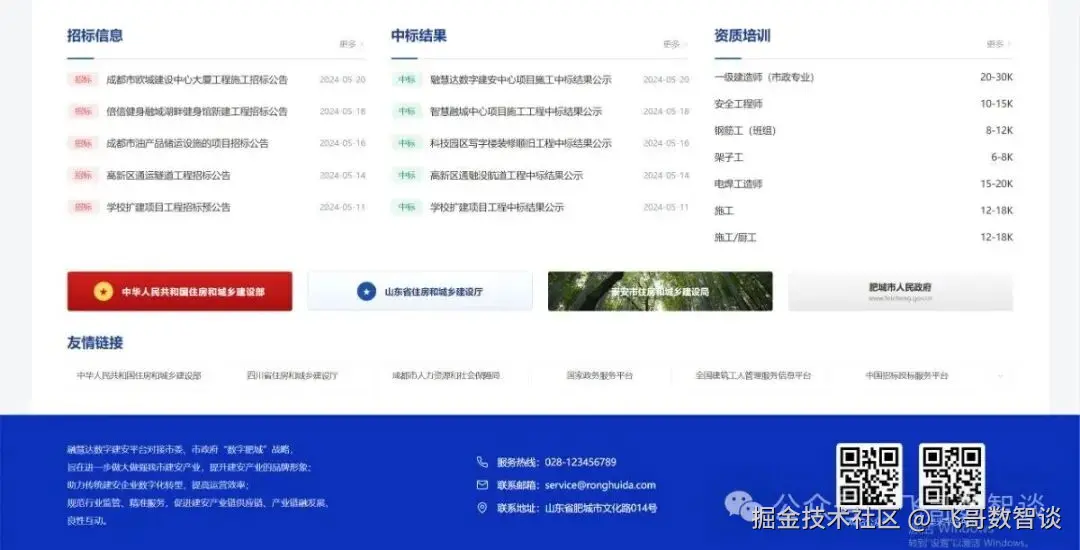
当然,最终效果还不能算真正的 1 比 1。
缺失的图片资源只能通过文字横幅和占位图模拟,一些字号、比例和留白也还有继续调整的空间。
但第二次结果明显比第一次更接近原图。
而且真正让我在意的,并不是它一次识别出了几个问题,而是它开始能够看到自己刚刚做出来的东西,再根据结果修改代码。
Vision 的价值,不只是让模型会看图
如果只看第一轮,Vision 的作用好像只是让 DeepSeek 能够理解一张设计图,然后根据图片生成代码。
这当然有用,但其他很多 Code Agent 早就具备类似能力了。
真正让我感觉不一样的,是第二轮。
第一次生成的网页截图,又变成了下一次任务的输入。模型看到的已经不只是原始需求,还包括自己执行后的真实结果。
以前没有 Vision 时,整个过程更像是:
理解需求 → 生成代码 → 页面运行 → 结束
接入 Vision 后,页面效果本身也成了调试信息:
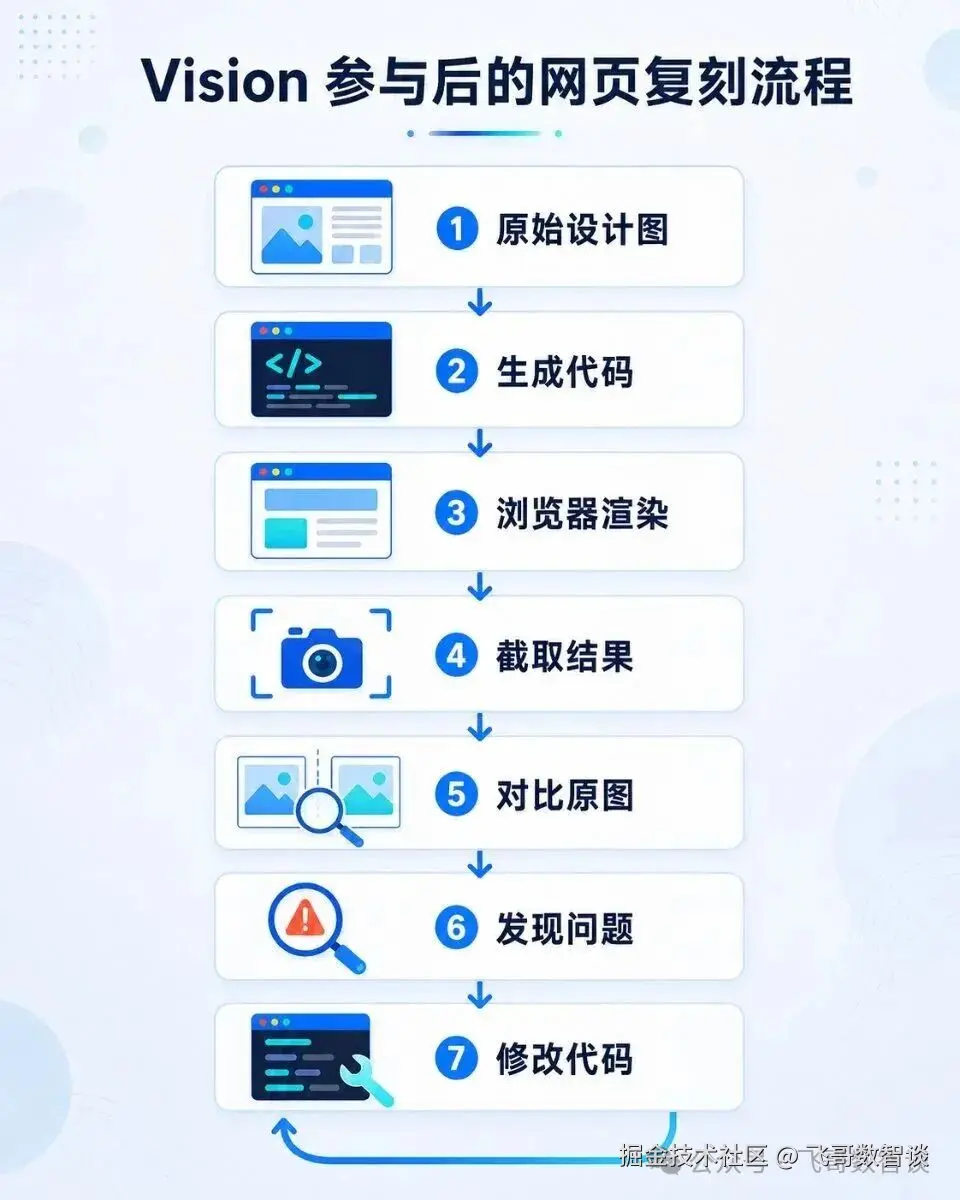
对于前端开发来说,这个变化挺重要。
因为最终交付的不是一份可以运行的代码,而是浏览器里真正呈现出来的页面。
模块有没有对齐、间距是否合理、图片是否正确、视觉层级是否接近目标,这些问题只看代码很难判断。
Vision 补上的,正是结果反馈这一环。
没有反馈的 Loop,只是在重复生成
Loop Engineering 大家估计都已经耳熟能详了。
最开始接触的时候我觉得,所谓 Loop 无非就是让 Agent 多执行几轮。
后来感觉不太对。
如果每一轮都没有获得新的环境信息,那么:
生成 → 再生成 → 继续生成
本质上只是重复调用模型。
真正有效的 Loop,应该是:
执行 → 观察结果 → 发现问题 → 调整 → 再次执行
这和人类干活的过程其实差不多。
写完文章会回头读,做完设计会打开预览,写完前端会刷新浏览器。我们很少只根据自己的操作过程判断结果,而是会不断观察最终效果。
Agent 也一样。
只有它能知道"我刚才做成了什么样",后续优化才有依据。
这也是这次 Demo 里,第二轮修改比第一轮生成更值得关注的地方。
第一轮证明模型可以看懂图片并生成代码。
第二轮则说明,图片可以成为 Agent 的环境反馈。
再把 Harness 接进来,Loop 才能真正转起来
目前这次测试还没有实现完整自动化。
第一次页面生成后,是我手动打开页面、截取效果图,再把截图传给 Vision。也就是说,观察环境和启动下一轮任务,仍然需要人参与。
但如果再结合 Harness,后面的过程就有可能变成:
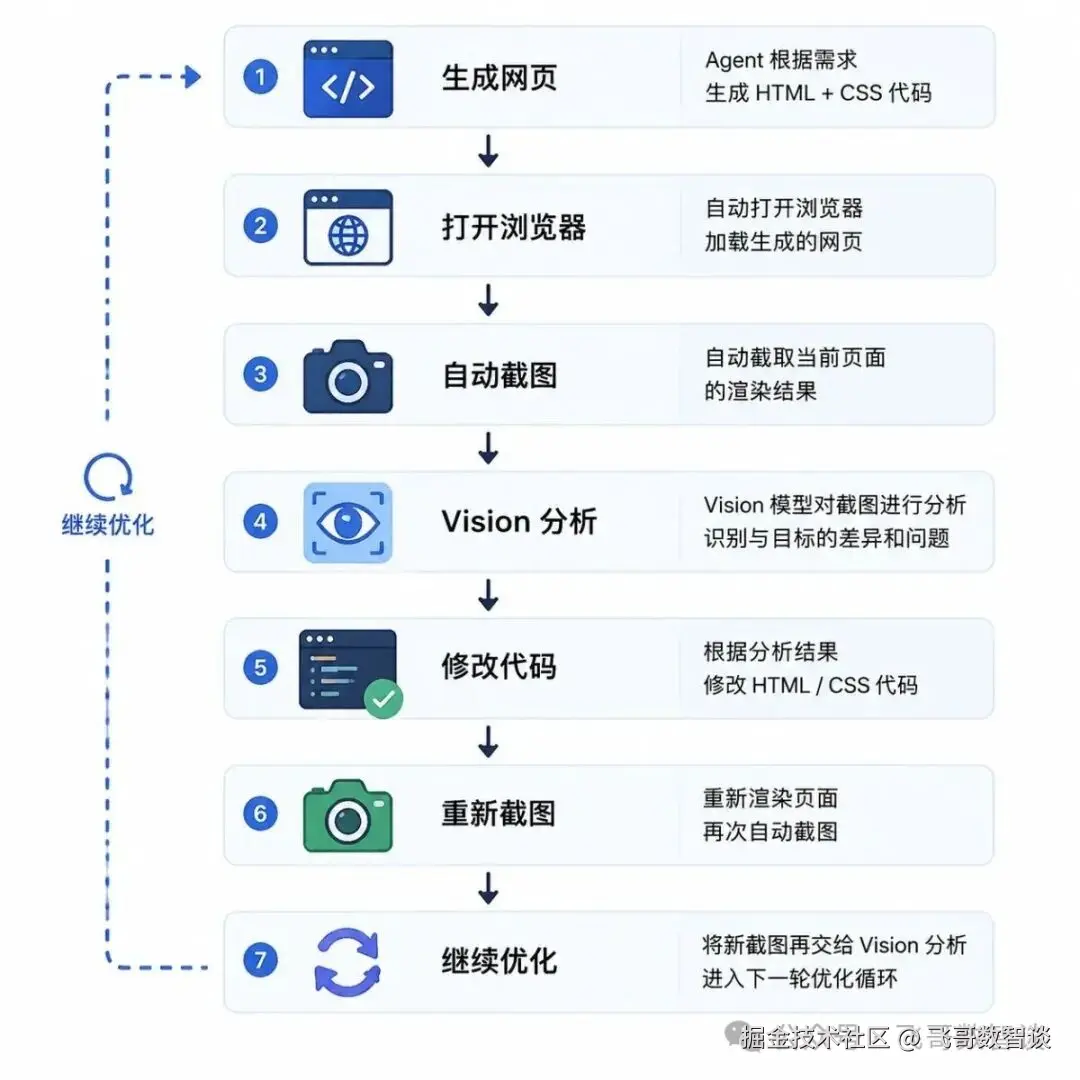
其中,Harness 提供文件系统、浏览器、截图和代码执行环境;Vision 负责感知执行结果;Loop 负责让整个优化过程持续运行。
到了这一步,Agent 才不只是根据需求生成一份代码,而是在真实环境中不断执行、观察和修正。
便宜,可能决定了 Vision 能不能真正进入 Loop
说回最开始为什么一直在用 DeepSeek。
还是成本。
图片问答通常只需要调用一次,但 Agent 的环境反馈可能要反复发生。页面每修改一轮,就需要重新渲染、重新截图、重新分析。
生成一次,看一次;修改一次,再看一次。
如果一次视觉调用就很贵,那这个 Loop 跑不了几轮,可能就舍不得继续了。
DeepSeek 最近虽然涨过价,但横向来看仍然相对便宜。这个特点放到普通对话里,可能只是少花点钱;放到 Agent 的循环执行里,意义就不太一样了。
它让模型可以更频繁地观察环境。
这样一来,DeepSeek Vision 的应用空间也不只是图片问答和识图,而可能进入网页开发、界面测试、桌面操作、文档排版等需要反复查看结果的任务。
这次测试只是一个很小的网页复刻 Demo,也不能据此说明它已经可以稳定完成复杂前端开发。
但至少从这两次截图中,我看到了一种更有意思的变化:
Vision 对 DeepSeek 最大的价值,不是让它看懂一张图片,而是让它开始看见自己执行后的结果。
而相对可控的成本,才有可能让这种"反复看、反复改",真正成为 Agent 的日常工作方式。