做 AI Agent 或者 RAG 知识库项目,你一定会遇到这样的场景:用户上传一个 PDF,后端要把它解析成 Markdown,然后分片写入向量数据库 (比如 Milvus)做语义检索,同时还要存进 ElasticSearch 做全文检索。
问题来了:解析接口需要同步等着向量化和 ES 写入都完成,才给用户返回吗?
显然没必要。这两件事既慢又互不依赖,完全可以丢到后台异步去做。而后端做异步处理最经典的方案,就是消息队列(MQ),其中 RabbitMQ 是最常用、最适合入门的一个。
这篇文章我会带你从零把 RabbitMQ 用起来:先讲清楚它的架构和几个核心概念,再用 Node.js 把 direct、fanout、topic、headers 四种交换机逐一跑一遍(代码都带详细中文注释,直接抄就能用),最后补上生产环境绕不开的可靠性话题------手动 ack、消息持久化、QoS、死信队列、失败重试,以及"什么时候该用 Kafka"。
面向的是有 Node.js 基础、会用 Docker,但还没系统用过消息队列的同学。读完你应该能独立搭起 RabbitMQ、写出生产者和消费者,并知道在自己的 Agent 项目里怎么落地。
一、为什么 Agent 场景离不开消息队列
先看 RAG 里最典型的一条链路。一个文档从上传到"可被检索",要经过这么几步:
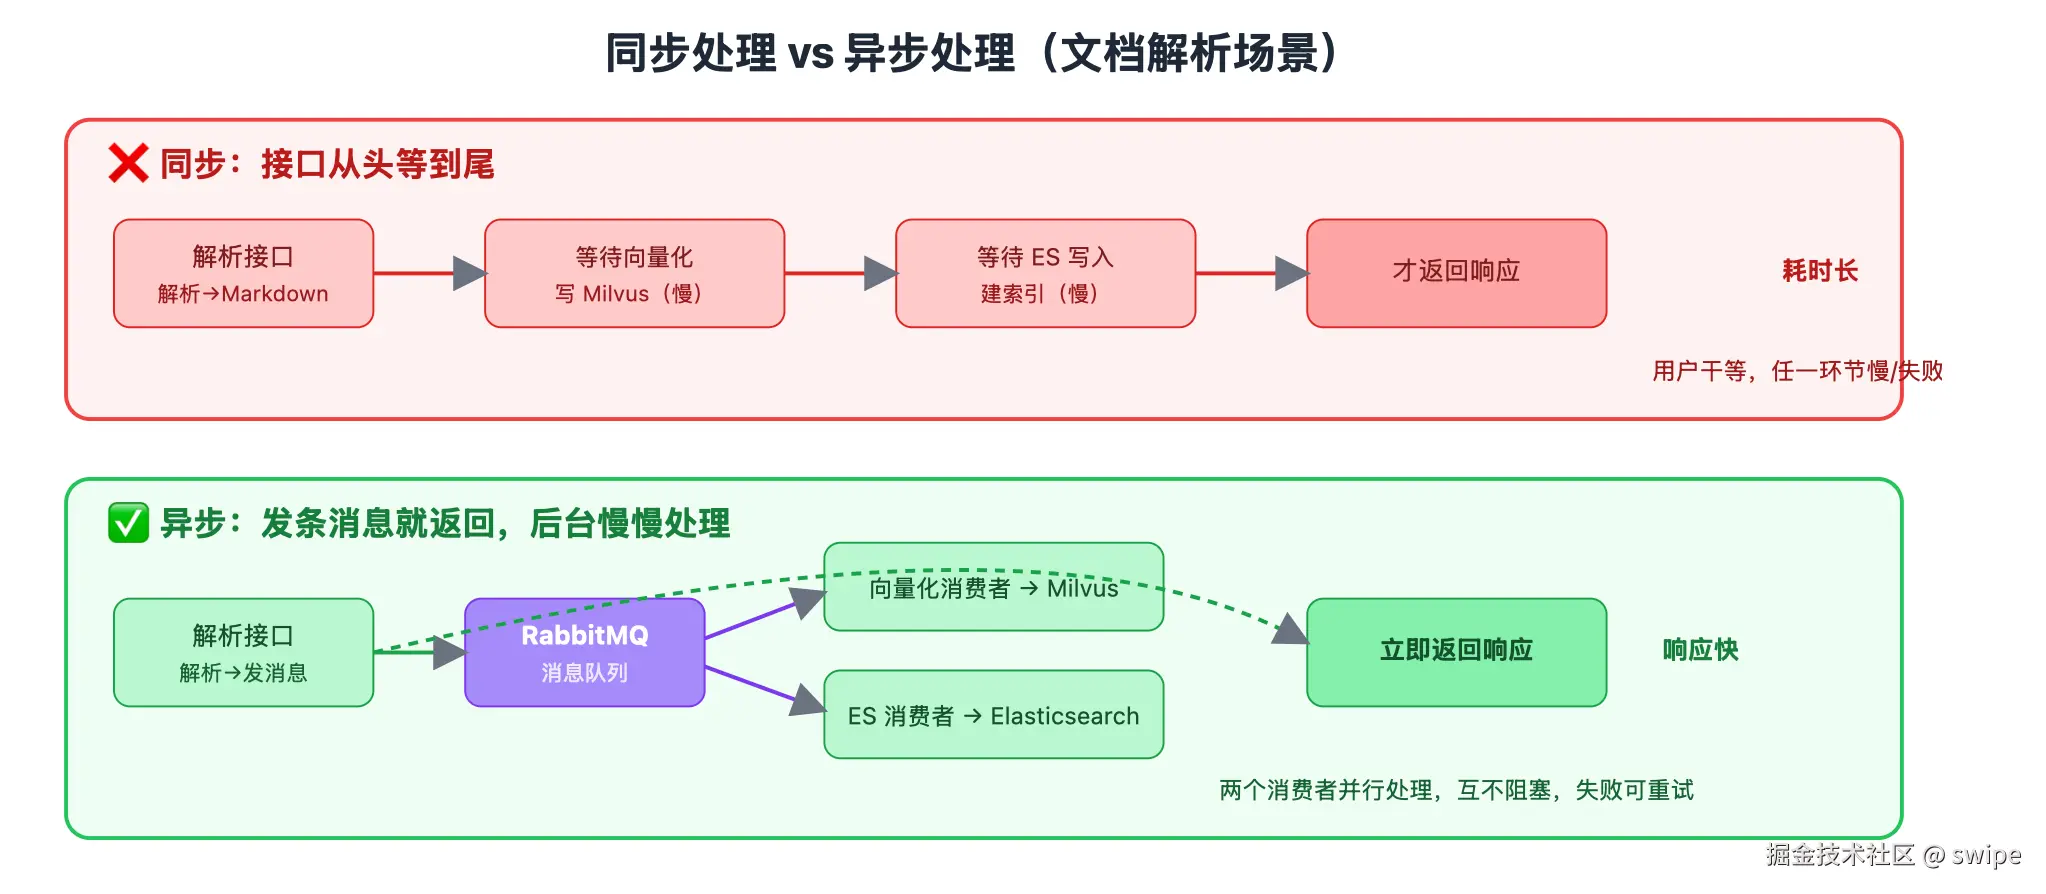 如果用同步方式串起来,解析接口的耗时是"解析 + 向量化 + ES 写入"三段之和。向量化要调用 embedding 模型、ES 建索引也要时间,用户就得一直干等着转圈。更糟的是,只要其中任何一个环节慢一点或者报错,整个请求就被拖垮甚至失败。
换成异步 就清爽多了:解析接口拿到 Markdown 之后,只往消息队列里发一条消息 ,然后立刻给用户返回"已收到,正在处理"。至于向量化和 ES 写入,由后台的消费者自己慢慢做。两个消费者还能并行跑,互不阻塞;哪个失败了也能单独重试,不影响另一个。
这就是消息队列的价值:把耗时的、可以延后的、彼此独立的任务从主流程里剥离出去,用"发消息"这个极快的动作替代"同步等待"。 生产者(发消息的)和消费者(处理消息的)之间彻底解耦,谁也不用等谁。
整个 RAG 的异步流程串起来是这样的:
一条消息,两个消费者各收一份、各干各的------这正是后面要讲的 fanout 广播模式。别急,我们先把 RabbitMQ 的地基打好。
二、RabbitMQ 的架构和核心概念
要用好 RabbitMQ,得先认识它的几个角色。下面这张图把它们的关系画全了:
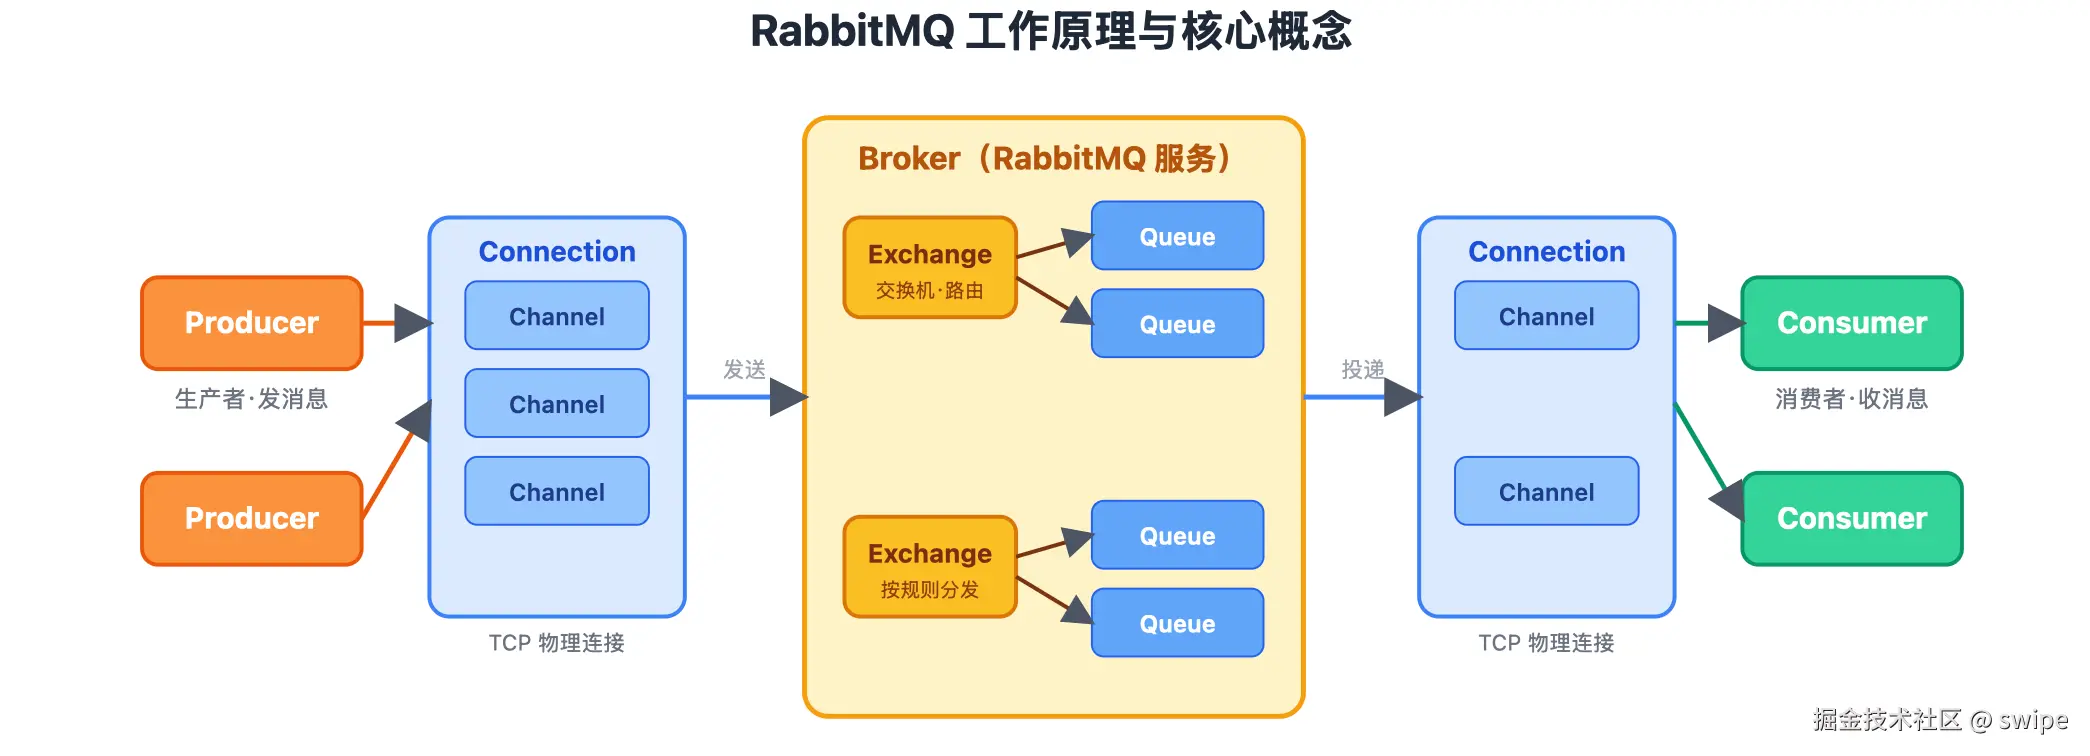
逐个拆解:
- Producer(生产者):发送消息的一方,比如那个解析文档的接口。
- Consumer(消费者):接收并处理消息的一方,比如向量化任务、ES 写入任务。
- Connection :客户端与 RabbitMQ 服务之间的一条 TCP 物理连接。建立 TCP 连接的开销不小,所以我们不会每收发一条消息就新建一个连接。
- Channel(通道) :在一条 Connection 内部 划分出的多条逻辑通道。真正的收发消息、声明队列和交换机,都是在 Channel 上进行的。这样多个生产者/消费者可以共享同一条 TCP 连接,而在逻辑上彼此隔离,既省资源又互不干扰。
- Queue(队列) :真正存放消息的容器。消息最终都待在某个队列里,排队等待消费者来取。
- Exchange(交换机) :负责路由的组件。生产者从不直接把消息写进队列,而是发给交换机,由交换机按照规则决定把消息投递到哪些队列。这是 RabbitMQ 最精髓的设计。
- Broker:承载消息接收、路由、转发的整套 RabbitMQ 服务实例,统称为 Broker。
这里要特别强调一个新手最容易搞混的点:生产者发消息,发的是"交换机",不是"队列" 。消息先到交换机,交换机再根据自己的类型和绑定规则,决定分发给哪些队列。队列和交换机之间通过 binding(绑定) 建立关系。理解了"交换机负责路由"这一层,后面四种交换机的区别就水到渠成了。
那为什么非要多一层交换机,不让生产者直接往队列里写呢?这正是 RabbitMQ 设计得比"一个简单队列"更强大的地方。如果生产者直接写死某个队列,那生产者就必须知道下游有几个队列、每个队列是谁在消费------生产者和消费者又耦合到一起了。而有了交换机这层"路由中枢",生产者只管把消息发给交换机、附带一个 routing key 或 headers,至于这条消息最终进哪些队列、有几个消费者在处理,生产者一概不用关心。下游想加一个消费者,只需新建队列并绑定到交换机,生产者代码完全不动。这种"发布者不感知订阅者"的解耦,正是消息中间件的精髓。
再理一遍消息的完整流转路径,加深印象:生产者 → Channel → 交换机(Exchange)→ 按绑定规则路由 → 队列(Queue)→ Channel → 消费者。整条链路里,交换机和队列都在 Broker 内部,生产者和消费者则通过各自的 Connection/Channel 接入。记住这条路径,你就能看懂任何一段 RabbitMQ 代码在做什么。
三、环境准备:用 Docker 把 RabbitMQ 跑起来
先建项目、装依赖:
bash
mkdir rabbitmq-test
cd rabbitmq-test
npm init -y
pnpm install amqplib
amqplib 是 Node.js 连接 RabbitMQ 最常用的库。
然后用 docker-compose.yml 把 RabbitMQ 服务拉起来:
yaml
services:
  rabbitmq:
    # 带 management 后缀的镜像自带 Web 管理台
    image: rabbitmq:3.13-management
    container_name: rabbitmq
    restart: always
    ports:
      - "5672:5672"   # AMQP 协议端口,程序连接用
      - "15672:15672" # Web 管理台端口,浏览器访问用
    environment:
      RABBITMQ_DEFAULT_USER: admin           # 默认账号
      RABBITMQ_DEFAULT_PASS: Admin@123456     # 默认密码
      RABBITMQ_DEFAULT_VHOST: /               # 默认虚拟主机
    volumes:
      # 把数据挂到本地,容器重建也不丢队列和消息
      - ./rabbitmq_data:/var/lib/rabbitmq
启动:
bash
docker compose up -d启动后访问 http://localhost:15672,用 admin / Admin@123456 登录,就能看到 RabbitMQ 的 Web 管理台。后面我们发的每一条消息、创建的每一个队列,都能在这里直观地看到。
📸 图片占位:RabbitMQ 管理台登录后的 Overview 首页。
3.1 封装连接:Connection 与 Channel
四种交换机的代码都要连接 RabbitMQ,所以先把连接逻辑抽出来放到 src/config.js:
javascript
import amqp from 'amqplib';

/**
 * RabbitMQ 连接串格式:amqp://用户名:密码@主机:端口/vhost
 *
 * 注意:密码里的特殊字符必须做 URL 编码。
 * 这里默认密码是 Admin@123456,其中 @ 要写成 %40,
 * 否则解析器会把「@123456@localhost」误判成用户名/主机分隔。
 *
 * docker-compose 里默认账号:admin / Admin@123456,端口 5672
 */
export const RABBITMQ_URL =
  process.env.RABBITMQ_URL ||
  'amqp://admin:Admin%40123456@localhost:5672';

/**
 * 建立与 Broker 的连接,并在其上创建 Channel。
 *
 * Connection:客户端与 RabbitMQ 之间的 TCP 物理连接,创建开销较大,通常复用。
 * Channel:Connection 上的逻辑通道。真正收发消息、声明交换机/队列都走 Channel,
 *          这样多个生产者/消费者可以共享一条 TCP 连接,而逻辑上彼此隔离。
 */
export async function connect() {
  // 1. 创建 TCP 连接(对应架构图里的 Connection)
  const connection = await amqp.connect(RABBITMQ_URL);

  // 2. 在连接上开一条逻辑通道(对应架构图里的 Channel)
  const channel = await connection.createChannel();

  return { connection, channel };
}这里有个新手常踩的坑值得单独提醒:连接串里密码带 @ 等特殊字符时,必须做 URL 编码 。Admin@123456 要写成 Admin%40123456,否则 URL 解析会在错误的位置断开用户名和主机,导致连接失败。
另外,因为代码用的是 ESM 的 import 语法,记得在 package.json 里加上 "type": "module",否则 Node.js 会有告警甚至报错。
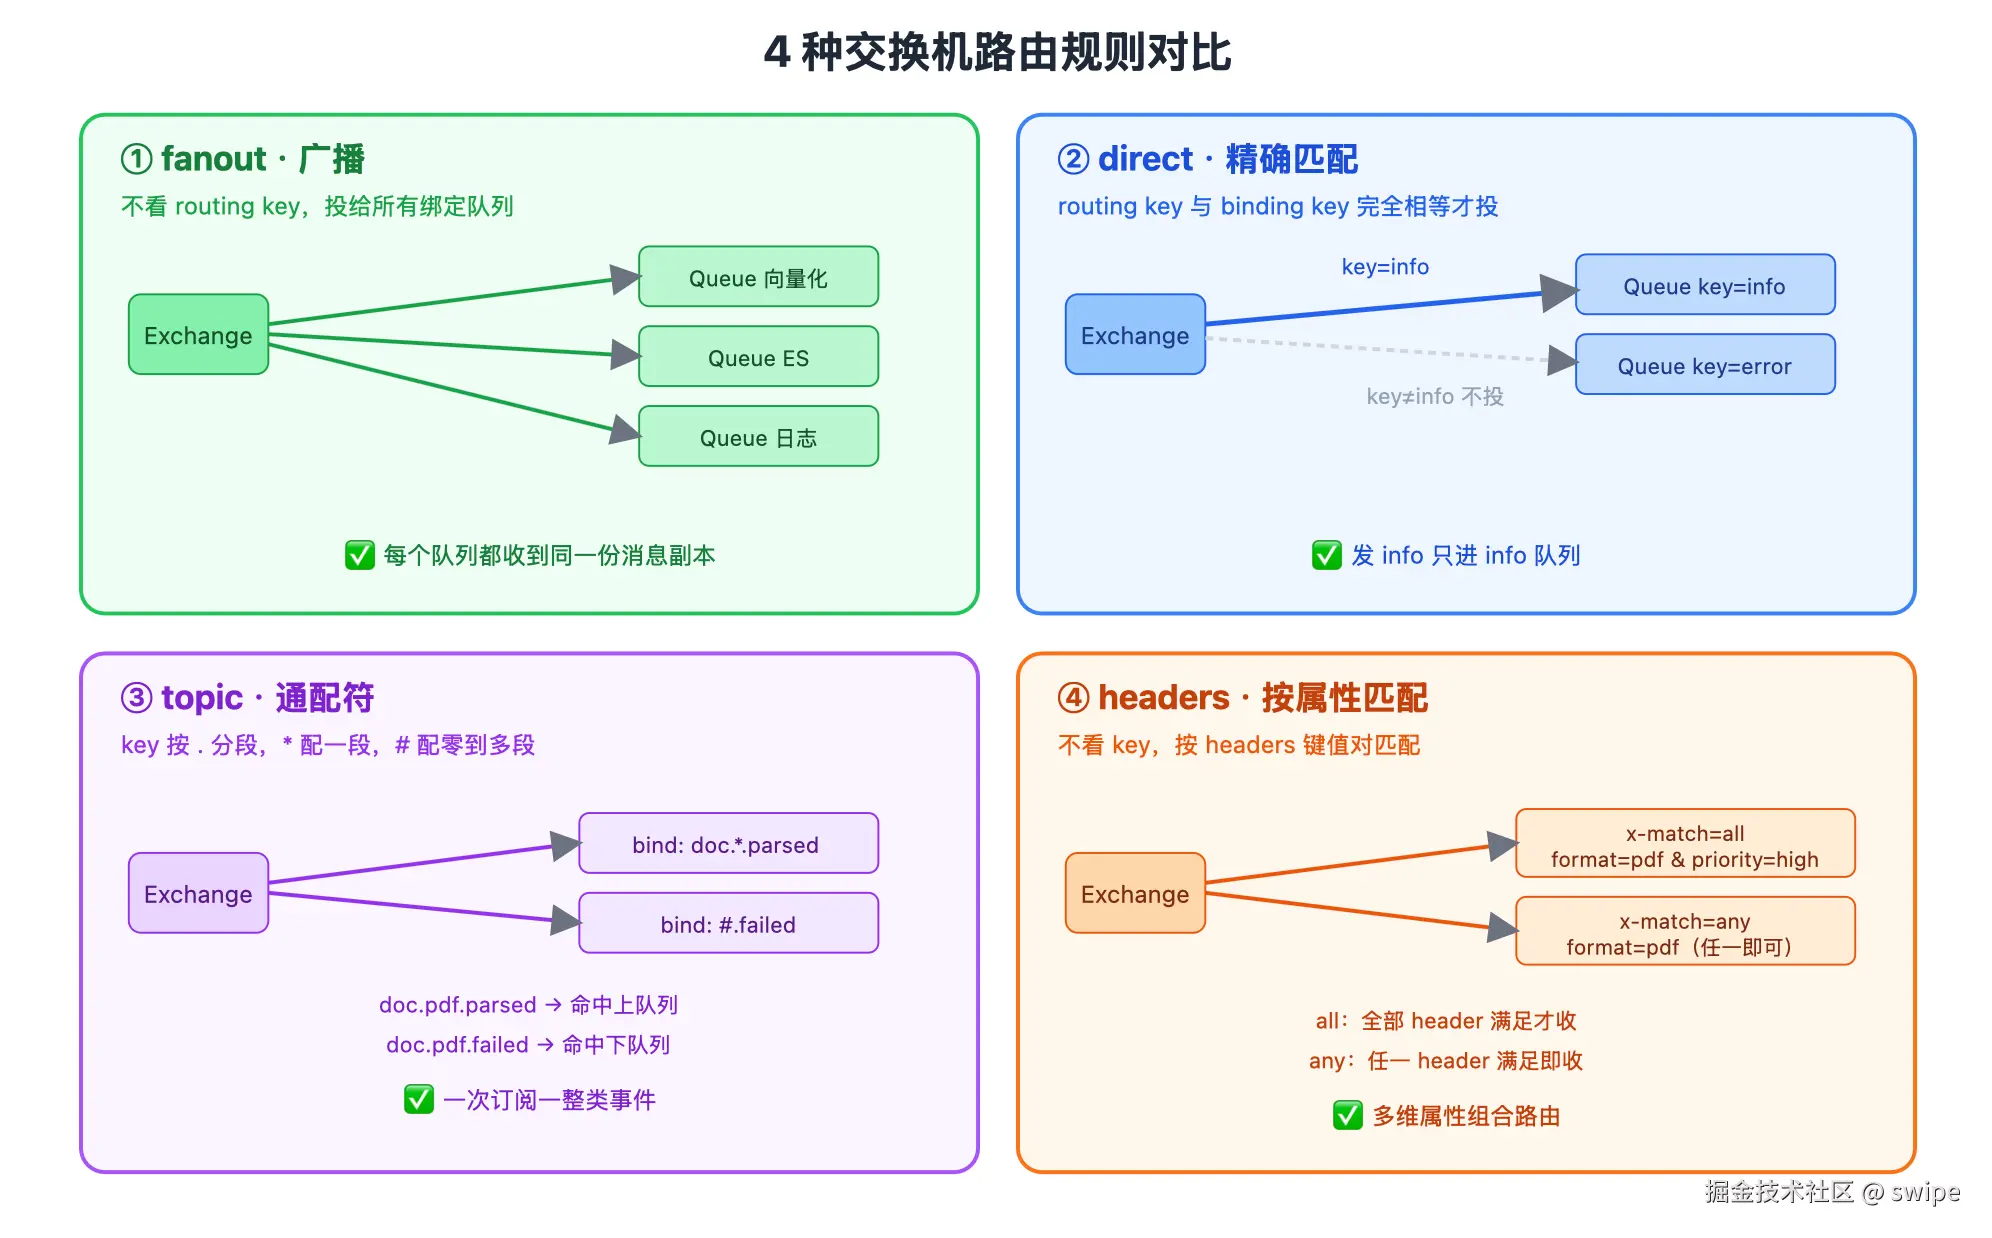
打好地基,下面正式开始过四种交换机。RabbitMQ 的交换机主要有四种类型:
- fanout :把消息放到绑定这个交换机的所有队列(广播)。
- direct :把消息放到交换机上指定 key 精确匹配的队列。
- topic :把消息放到交换机上指定 key 的队列,支持通配符模糊匹配。
- headers :把消息放到满足某些 header 条件的队列。
下面这张对比图先给你一个整体印象,后面逐一实操:
四、direct 交换机:按 routing key 精确投递
先从最好理解的 direct 开始。它的规则是:消息的 routing key 必须和队列绑定时的 binding key 完全相等,才会被投递到该队列。
用一个"文档任务通知"的场景来演示:解析过程中会产生 info(正常)、warning(警告)、error(错误)三种级别的通知,我们希望不同级别进不同的队列。
4.1 生产者
src/direct/producer.js:
javascript
import { connect } from "../config.js"

const EXCHANGE = "doc.task.direct"

/**
 * ========== direct 交换机 ==========
 *
 * 行为:消息的 routing key 必须与队列绑定时的 binding key「完全相等」才会投递。
 *       一对多也可以:多个队列绑同一个 key,会同时收到(类似按 key 分组的广播)。
 *
 * 对比 fanout:
 *   - fanout:所有绑定队列都收,不看 key
 *   - direct:只有 key 对得上的队列才收
 *
 * 本示例:用 info / warning / error 三条路由,模拟不同级别的文档任务通知。
 */
async function main() {
  const { connection, channel } = await connect()

  // 声明一个 direct 类型交换机;durable:true 表示交换机定义持久化
  await channel.assertExchange(EXCHANGE, "direct", { durable: true })

  const tasks = [
    { routingKey: "info", body: { level: "info", text: "文档解析完成" } },
    {
      routingKey: "warning",
      body: { level: "warning", text: "文档页数过多,耗时较长" },
    },
    { routingKey: "error", body: { level: "error", text: "OCR 识别失败" } },
  ]

  for (const task of tasks) {
    /**
     * 第二个参数就是 routing key。
     * Exchange 会拿它去和各队列的 binding key 做精确匹配,决定投递到哪些 Queue。
     */
    channel.publish(
      EXCHANGE,
      task.routingKey,
      Buffer.from(JSON.stringify(task.body)),
      { persistent: true, contentType: "application/json" }
    )
    console.log(
      `[direct producer] 发送 routingKey=${task.routingKey}:`,
      task.body
    )
  }

  // 给底层缓冲一点时间把消息刷出去,再关连接(演示脚本写法)
  setTimeout(async () => {
    await channel.close()
    await connection.close()
  }, 500)
}

main().catch(console.error)
4.2 消费者
src/direct/consumer.js 通过命令行参数指定自己要监听的 routing key:
javascript
import { connect } from '../config.js';

const EXCHANGE = 'doc.task.direct';

/** 通过命令行参数指定要绑定的 routing key,不传时默认 info。 */
const routingKey = process.argv[2] || 'info';

/** 队列名按 key 区分,方便在管理台一眼看出各自在听什么 */
const QUEUE = `doc.task.${routingKey}`;

/**
 * direct 消费者:只接收 binding key === 消息 routing key 的消息。
 *
 * 绑定关系示意:
 *   Queue(doc.task.info)    --bind key=info-->    Exchange(direct)
 *   Queue(doc.task.error)   --bind key=error-->   Exchange(direct)
 *
 * 发 routingKey=info 的消息 → 只进 doc.task.info
 * 发 routingKey=error 的消息 → 只进 doc.task.error
 */
async function main() {
  const { channel } = await connect();

  await channel.assertExchange(EXCHANGE, 'direct', { durable: true });
  await channel.assertQueue(QUEUE, { durable: true });

  /**
   * 第三个参数 binding key:direct 模式下必须与发布时的 routing key 完全一致。
   * 「info」绑「info」能收到;绑「error」则永远收不到 info 消息。
   */
  await channel.bindQueue(QUEUE, EXCHANGE, routingKey);

  console.log(`[direct] 消费者监听队列=${QUEUE}, routingKey=${routingKey}`);

  channel.consume(QUEUE, (msg) => {
    if (!msg) return;

    const data = JSON.parse(msg.content.toString());
    console.log(`[direct/${routingKey}] 收到:`, data);
    channel.ack(msg); // 处理完手动确认
  });
}

main().catch(console.error);
4.3 跑起来看效果
开三个终端,分别启动监听不同 key 的消费者,再运行生产者:
bash
# 三个消费者
node src/direct/consumer.js info
node src/direct/consumer.js warning
node src/direct/consumer.js error
# 生产者
node src/direct/producer.js
实际运行结果(我在本地实测的输出):
text
# info 队列
[direct/info] 收到: { level: 'info', text: '文档解析完成' }
# warning 队列
[direct/warning] 收到: { level: 'warning', text: '文档页数过多,耗时较长' }
# error 队列
[direct/error] 收到: { level: 'error', text: 'OCR 识别失败' }
可以看到:发 info 的消息只进了 info 队列,error 只进了 error 队列,互不串台 。这就是 direct 的"精确匹配"。如果让多个队列都绑定同一个 key(比如都绑 error),那它们会同时收到 error 消息------这是 direct 支持的"按 key 分组广播"。
五、fanout 交换机:广播给所有队列(RAG 双写主场景)
fanout 是四种里最简单粗暴的:完全不看 routing key,把消息广播给所有绑定到该交换机的队列。 每个队列都会收到一份完整的消息副本。
这恰好就是开篇那个 RAG 场景的解法:文档解析完成后,发一条消息到 fanout 交换机,向量化消费者 和 ES 消费者各自绑定自己的队列,都能收到同一份 Markdown,然后并行去做各自的事。
5.1 生产者
src/fanout/producer.js:
javascript
import { connect } from '../config.js';

/** 交换机名称。Producer 只往 Exchange 发消息,从不直接写某个 Queue。 */
const EXCHANGE = 'doc.parse.fanout';

/**
 * ========== fanout 交换机 ==========
 *
 * 行为:把消息广播到所有绑定了该交换机的 Queue,完全忽略 routing key。
 *
 * 典型场景(RAG):
 *   文档解析完成后得到 Markdown → 发一条消息到 fanout
 *   → 向量化消费者、ES 消费者各自绑定自己的队列,都能收到同一份消息副本
 *   → 两边异步并行处理,解析接口不必同步等待
 */
async function main() {
  const { connection, channel } = await connect();

  /**
   * assertExchange:交换机不存在则创建,已存在则校验类型是否一致。
   * - type: 'fanout' 广播模式
   * - durable: true  Broker 重启后交换机定义仍保留(消息是否持久另看消息属性)
   */
  await channel.assertExchange(EXCHANGE, 'fanout', { durable: true });

  // 模拟「解析接口」产出的业务载荷
  const message = {
    docId: `doc-${Date.now()}`,
    markdown: '# Hello RAG\n\n这是解析后的 Markdown 内容。',
    source: 'report.pdf',
  };

  /**
   * publish(exchange, routingKey, content, options)
   *
   * fanout 下第二个参数 routingKey 会被忽略,习惯上传 ''。
   * persistent: true  标记消息为持久化,配合 durable 队列,Broker 重启后尽量不丢
   *                   (严格不丢还要配合镜像/仲裁队列、发布确认等,这里先演示基本用法)
   */
  channel.publish(EXCHANGE, '', Buffer.from(JSON.stringify(message)), {
    persistent: true,
    contentType: 'application/json',
  });

  console.log('[fanout producer] 已发送:', message);

  // 给底层缓冲一点时间把消息刷出去,再关连接(演示脚本写法)
  setTimeout(async () => {
    await channel.close();
    await connection.close();
  }, 500);
}

main().catch(console.error);
5.2 两个消费者:向量化 + ES
关键点在于:两个消费者用各自独立的队列,再分别绑定到同一个 fanout 交换机。 这样交换机广播时,每个队列都会拿到一份副本,互不影响消费进度。
向量化消费者 src/fanout/consumer-vector.js:
javascript
import { connect } from '../config.js';

const EXCHANGE = 'doc.parse.fanout';
/** 本消费者专属队列:只负责「分片 + 写入向量库」 */
const QUEUE = 'doc.vectorize';

/**
 * fanout 消费者 A:模拟向量化写入 Milvus。
 *
 * 要点:
 *   - 每个处理环节用自己的 Queue,再 bind 到同一个 fanout Exchange
 *   - Exchange 广播时,每条消息都会「复制」进每个绑定队列
 *   - 所以 vector 队列和 es 队列会各自收到完整消息,互不影响消费进度
 */
async function main() {
  const { channel } = await connect();

  // 消费者侧也要 assertExchange:保证交换机存在,且类型与生产者一致
  await channel.assertExchange(EXCHANGE, 'fanout', { durable: true });

  /**
   * assertQueue:声明真正存消息的容器。
   * durable: true → 队列元数据持久化;消息本身还要配合 persistent 才能落盘。
   */
  await channel.assertQueue(QUEUE, { durable: true });

  /**
   * bindQueue(queue, exchange, routingKey)
   * fanout 不看 routing key,第三个参数传空字符串即可。
   * 绑定成功后:发到该 Exchange 的消息都会进入本队列。
   */
  await channel.bindQueue(QUEUE, EXCHANGE, '');

  console.log(`[fanout] 向量化消费者监听队列: ${QUEUE}`);

  /**
   * consume:从队列拉取消息并处理。
   * 默认需要手动 ack(见下方 channel.ack),处理成功再确认,
   * 这样进程崩溃时未 ack 的消息会重新投递,避免丢任务。
   */
  channel.consume(QUEUE, (msg) => {
    // 取消订阅时可能收到 null,直接返回
    if (!msg) return;

    const data = JSON.parse(msg.content.toString());
    console.log('[vector] 收到消息,开始分片并写入 Milvus:', data.docId, data.source);

    // 实际项目里这里会做:切 chunk → embedding → upsert Milvus
    // 处理成功后再 ack;若失败可 nack / reject 决定是否重入队
    channel.ack(msg);
  });
}

main().catch(console.error);
ES 消费者 src/fanout/consumer-es.js 结构几乎一样,只是换了个队列名和处理逻辑:
javascript
import { connect } from '../config.js';

const EXCHANGE = 'doc.parse.fanout';
/** 本消费者专属队列:只负责「全文检索写入 ElasticSearch」 */
const QUEUE = 'doc.elasticsearch';

/**
 * fanout 消费者 B:模拟写入 ElasticSearch。
 *
 * 与 consumer-vector.js 绑定同一 Exchange、不同 Queue。
 * 生产者只发一次;两个队列各收一份,天然实现「一份 Markdown → 两路异步落地」。
 */
async function main() {
  const { channel } = await connect();

  await channel.assertExchange(EXCHANGE, 'fanout', { durable: true });
  await channel.assertQueue(QUEUE, { durable: true });

  // 同样绑定到 fanout;routing key 仍可传空
  await channel.bindQueue(QUEUE, EXCHANGE, '');

  console.log(`[fanout] ES 消费者监听队列: ${QUEUE}`);

  channel.consume(QUEUE, (msg) => {
    if (!msg) return;

    const data = JSON.parse(msg.content.toString());
    console.log('[es] 收到消息,写入 ElasticSearch:', data.docId, data.source);

    // 实际项目里这里会做:解析 Markdown → 建索引文档 → bulk 写入 ES
    channel.ack(msg);
  });
}

main().catch(console.error);
5.3 跑起来看效果
bash
# 两个消费者
node src/fanout/consumer-vector.js
node src/fanout/consumer-es.js
# 只发一条消息
node src/fanout/producer.js
实测输出:
text
# 生产者
[fanout producer] 已发送: { docId: 'doc-1787465853283', markdown: '...', source: 'report.pdf' }
# 向量化消费者
[vector] 收到消息,开始分片并写入 Milvus: doc-1787465853283 report.pdf
# ES 消费者
[es] 收到消息,写入 ElasticSearch: doc-1787465853283 report.pdf
生产者只发了一次,两个消费者都收到了同一个 docId。 这就是 fanout 广播的威力,也是 RAG 里"一份 Markdown → 向量库 + ES 两路异步落地"的标准实现。将来如果还要加一路(比如再存一份到数据仓库),只需要新起一个消费者、绑定同一个交换机即可,生产者代码一行都不用改------这就是解耦带来的扩展性。
六、topic 交换机:通配符模糊匹配
direct 要求 routing key 完全相等,有时候太死板。比如我想"订阅所有解析成功的事件",不管它是 pdf 还是 docx------这时候就该用 topic。
topic 的规则是:routing key 用 . 分成若干段,绑定时可以用通配符做模式匹配:
*恰好匹配一个段(不能跨段)#匹配零个或多个段(可跨段)
我们设计这样的 routing key 结构:业务域.文档格式.事件类型,例如 doc.pdf.parsed。
6.1 生产者
src/topic/producer.js 发出四条不同 routing key 的消息:
javascript
import { connect } from '../config.js';

const EXCHANGE = 'doc.event.topic';

/**
 * ========== topic 交换机 ==========
 *
 * 行为:routing key 按「.」分成若干单词,绑定端可用通配符做模式匹配。
 *
 * 通配符规则:
 *   *  → 恰好匹配一个单词(不能跨段)
 *   #  → 匹配零个或多个单词(可跨段)
 *
 * 示例 routing key:
 *   doc.pdf.parsed
 *   │   │    └── 事件类型
 *   │   └─────── 文档格式
 *   └─────────── 业务域
 *
 * 对比 direct:
 *   - direct:必须整串完全相等
 *   - topic:可以用模式一次订阅一类消息(如所有 *.parsed)
 */
async function main() {
  const { connection, channel } = await connect();

  await channel.assertExchange(EXCHANGE, 'topic', { durable: true });

  const events = [
    { routingKey: 'doc.pdf.parsed', body: { type: 'parsed', format: 'pdf' } },
    { routingKey: 'doc.docx.parsed', body: { type: 'parsed', format: 'docx' } },
    { routingKey: 'doc.pptx.failed', body: { type: 'failed', format: 'pptx' } },
    { routingKey: 'doc.pdf.failed', body: { type: 'failed', format: 'pdf' } },
  ];

  for (const event of events) {
    /**
     * 发布时写「具体」的 routing key(一般不用通配符)。
     * 通配符是给消费者 bindQueue 时用的。
     */
    channel.publish(
      EXCHANGE,
      event.routingKey,
      Buffer.from(JSON.stringify(event.body)),
      { persistent: true, contentType: 'application/json' },
    );
    console.log(`[topic producer] 发送 routingKey=${event.routingKey}:`, event.body);
  }

  setTimeout(async () => {
    await channel.close();
    await connection.close();
  }, 500);
}

main().catch(console.error);
6.2 消费者
src/topic/consumer.js 通过命令行参数接收"绑定模式":
javascript
import { connect } from '../config.js';

const EXCHANGE = 'doc.event.topic';

/**
 * 绑定模式(binding key)示例,对照 producer 发出的四条消息:
 *
 *   doc.*.parsed  → 收 doc.pdf.parsed、doc.docx.parsed
 *                   (中间一段任意,末尾必须是 parsed)
 *                   不收 *.failed
 *
 *   doc.pdf.#     → 收 doc.pdf.parsed、doc.pdf.failed
 *                   (pdf 后面无论还有几段都匹配)
 *
 *   doc.#         → 收全部 doc. 开头的事件
 *
 *   #.failed      → 收所有以 failed 结尾的事件
 */
const bindingKey = process.argv[2] || 'doc.*.parsed';

/** 队列名里把通配符换成下划线,避免特殊字符带来困扰 */
const QUEUE = `doc.topic.${bindingKey.replace(/[.#*]/g, '_')}`;

/**
 * topic 消费者:用「模式」订阅一类 routing key,而不是写死某一个。
 */
async function main() {
  const { channel } = await connect();

  await channel.assertExchange(EXCHANGE, 'topic', { durable: true });
  await channel.assertQueue(QUEUE, { durable: true });

  /**
   * 第三个参数这里是「模式」,不是精确字符串。
   * Broker 会用该模式去匹配每条消息的 routing key,命中才入队。
   */
  await channel.bindQueue(QUEUE, EXCHANGE, bindingKey);

  console.log(`[topic] 消费者监听队列=${QUEUE}, bindingKey=${bindingKey}`);

  channel.consume(QUEUE, (msg) => {
    if (!msg) return;

    const data = JSON.parse(msg.content.toString());
    // msg.fields.routingKey 是生产者实际发送时的 key,便于对照绑定模式是否符合预期
    console.log(
      `[topic] routingKey=${msg.fields.routingKey}, binding=${bindingKey}, 内容:`,
      data,
    );
    channel.ack(msg);
  });
}

main().catch(console.error);
6.3 跑起来看效果
分别用三种模式启动消费者,再发消息:
bash
node src/topic/consumer.js 'doc.*.parsed'
node src/topic/consumer.js 'doc.pdf.#'
node src/topic/consumer.js '#.failed'
node src/topic/producer.js
实测结果:
text
# doc.*.parsed ------ 只收「解析成功」的,不管什么格式
[topic] routingKey=doc.pdf.parsed,  binding=doc.*.parsed
[topic] routingKey=doc.docx.parsed, binding=doc.*.parsed

# doc.pdf.# ------ 只收 pdf 的,不管成功失败
[topic] routingKey=doc.pdf.parsed, binding=doc.pdf.#
[topic] routingKey=doc.pdf.failed, binding=doc.pdf.#

# #.failed ------ 只收「失败」的,不管什么格式
[topic] routingKey=doc.pptx.failed, binding=#.failed
[topic] routingKey=doc.pdf.failed, binding=#.failed结果和预期完全一致。doc.*.parsed 用 * 匹配了中间那一段(pdf/docx),但末尾必须是 parsed;doc.pdf.# 用 # 匹配了 pdf 后面的任意段;#.failed 则捞出了所有失败事件。一个模式订阅一整类消息,这是 topic 相比 direct 最大的灵活性。 实际项目里,topic 是用得最多的交换机类型,因为它兼顾了精确和灵活。
七、headers 交换机:按消息属性匹配
前面三种交换机路由都依赖 routing key(fanout 忽略它,direct/topic 用它)。但有时候路由条件是多个独立的属性------比如文档格式、优先级、租户、语言------很难压进一条 routing key 里。这时候就轮到 headers 出场。
headers 交换机不看 routing key ,而是看消息携带的 headers(一组键值对) 是否满足绑定条件。匹配模式由绑定参数 x-match 决定:
all:绑定里列出的 header 必须全部匹配(逻辑 AND)any:绑定里任一 header 匹配即可(逻辑 OR)
7.1 生产者
src/headers/producer.js:
javascript
import { connect } from '../config.js';

const EXCHANGE = 'doc.route.headers';

/**
 * ========== headers 交换机 ==========
 *
 * 行为:不看 routing key,而是看消息的 headers(一组键值对)是否满足绑定条件。
 *
 * 何时用 headers 而不是 topic/direct:
 *   - 路由条件是多个独立属性(格式、优先级、租户、语言...),很难压成一条 routing key
 *   - 需要「同时满足多个条件」或「满足任一条件」这类组合逻辑
 *
 * 匹配模式由绑定参数 x-match 决定(见 consumer):
 *   - all:绑定里列出的 header 必须全部匹配
 *   - any:绑定里任一 header 匹配即可
 */
async function main() {
  const { connection, channel } = await connect();

  await channel.assertExchange(EXCHANGE, 'headers', { durable: true });

  const messages = [
    {
      headers: { format: 'pdf', priority: 'high' },
      body: { docId: '1', note: '高优先级 PDF' },
    },
    {
      headers: { format: 'pdf', priority: 'low' },
      body: { docId: '2', note: '低优先级 PDF' },
    },
    {
      headers: { format: 'docx', priority: 'high' },
      body: { docId: '3', note: '高优先级 DOCX' },
    },
  ];

  for (const item of messages) {
    /**
     * headers 交换机下 routing key 通常传 ''(会被忽略)。
     * 真正参与路由的是 options.headers。
     */
    channel.publish(EXCHANGE, '', Buffer.from(JSON.stringify(item.body)), {
      persistent: true,
      contentType: 'application/json',
      headers: item.headers,
    });
    console.log('[headers producer] 发送 headers=', item.headers, 'body=', item.body);
  }

  setTimeout(async () => {
    await channel.close();
    await connection.close();
  }, 500);
}

main().catch(console.error);
7.2 消费者
src/headers/consumer.js 用绑定参数 arguments 描述"我关心哪些 header":
javascript
import { connect } from '../config.js';

const EXCHANGE = 'doc.route.headers';

/**
 * 命令行参数:
 *   argv[2]  matchMode  all | any
 *   argv[3]  format     如 pdf / docx
 *   argv[4]  priority   可选,如 high / low
 *
 * all + pdf + high → 要求 format、priority 都匹配,只收「高优先级 PDF」
 * any + pdf        → format 或 priority 任一命中即可(只传 format 时即收所有 pdf)
 */
const matchMode = process.argv[2] || 'all';
const format = process.argv[3] || 'pdf';
const priority = process.argv[4] || 'high';

const QUEUE = `doc.headers.${matchMode}.${format}${priority ? '.' + priority : ''}`;

/**
 * headers 消费者:用 bind 时的 arguments 描述「我关心哪些 header」。
 *
 * 注意:
 *   - bindQueue 的 routing key 传空即可
 *   - 真正的匹配条件放在第四个参数 arguments 里
 *   - x-match 本身不参与和消息 header 的值比较,只是告诉 Broker 用 all 还是 any
 */
async function main() {
  const { channel } = await connect();

  await channel.assertExchange(EXCHANGE, 'headers', { durable: true });
  await channel.assertQueue(QUEUE, { durable: true });

  /** 绑定参数:x-match + 若干业务 header */
  const bindArgs = {
    'x-match': matchMode, // 'all' 全部匹配;'any' 任一匹配
    format,
  };
  if (priority) {
    bindArgs.priority = priority;
  }

  /**
   * bindQueue(queue, exchange, routingKey, arguments)
   * headers 模式下第四个 arguments 才是路由规则本体。
   */
  await channel.bindQueue(QUEUE, EXCHANGE, '', bindArgs);

  console.log(`[headers] 消费者监听队列=${QUEUE}, 匹配条件=`, bindArgs);

  channel.consume(QUEUE, (msg) => {
    if (!msg) return;

    const data = JSON.parse(msg.content.toString());
    // 对照消息自带的 headers,验证是否符合本队列的绑定条件
    console.log('[headers] 收到 headers=', msg.properties.headers, 'body=', data);
    channel.ack(msg);
  });
}

main().catch(console.error);
7.3 跑起来看效果
bash
# all 模式:format=pdf 且 priority=high 都要满足
node src/headers/consumer.js all pdf high
# any 模式:只要 format=pdf 命中即可
node src/headers/consumer.js any pdf
node src/headers/producer.js
实测结果:
text
# all + format=pdf + priority=high ------ 只收「高优先级 PDF」
[headers] 收到 headers= { format: 'pdf', priority: 'high' } body= { docId: '1', note: '高优先级 PDF' }

# any + format=pdf ------ format 或 priority 任一命中即可,这里三条全命中
[headers] 收到 headers= { format: 'pdf', priority: 'high' } body= { docId: '1' }
[headers] 收到 headers= { format: 'pdf', priority: 'low' }  body= { docId: '2' }
[headers] 收到 headers= { format: 'docx', priority: 'high' } body= { docId: '3' }
all 模式下,只有 format 和 priority 都 对上的"高优先级 PDF"被收下;而 any 模式因为绑定里还带了默认的 priority=high,只要 format 或 priority 任一命中就收,所以三条消息都进来了。headers 适合那种"路由维度多、且需要 AND/OR 组合"的复杂场景,代价是配置比 routing key 繁琐,所以日常用得没有 topic 多。
到这里,四种交换机就都过了一遍。小结一下选型:
| 交换机 | 路由依据 | 匹配方式 | 典型场景 |
|---|---|---|---|
| fanout | 忽略 key | 广播所有绑定队列 | 一份数据多路处理(RAG 双写) |
| direct | routing key | 完全相等 | 按固定类别分发(日志级别) |
| topic | routing key | 通配符模糊匹配 | 按模式订阅一类事件(最常用) |
| headers | headers 键值对 | all / any 组合 | 多维属性组合路由 |
八、从"能跑"到"生产可用":可靠性保障
前面的代码能跑通,但离生产环境还差一层"可靠性"。想象一下这些情况:消费者刚拿到消息还没处理完就崩溃了、Broker 突然重启、某条消息永远处理失败......消息会不会丢?会不会把系统拖垮?这一节就来补齐这些短板。
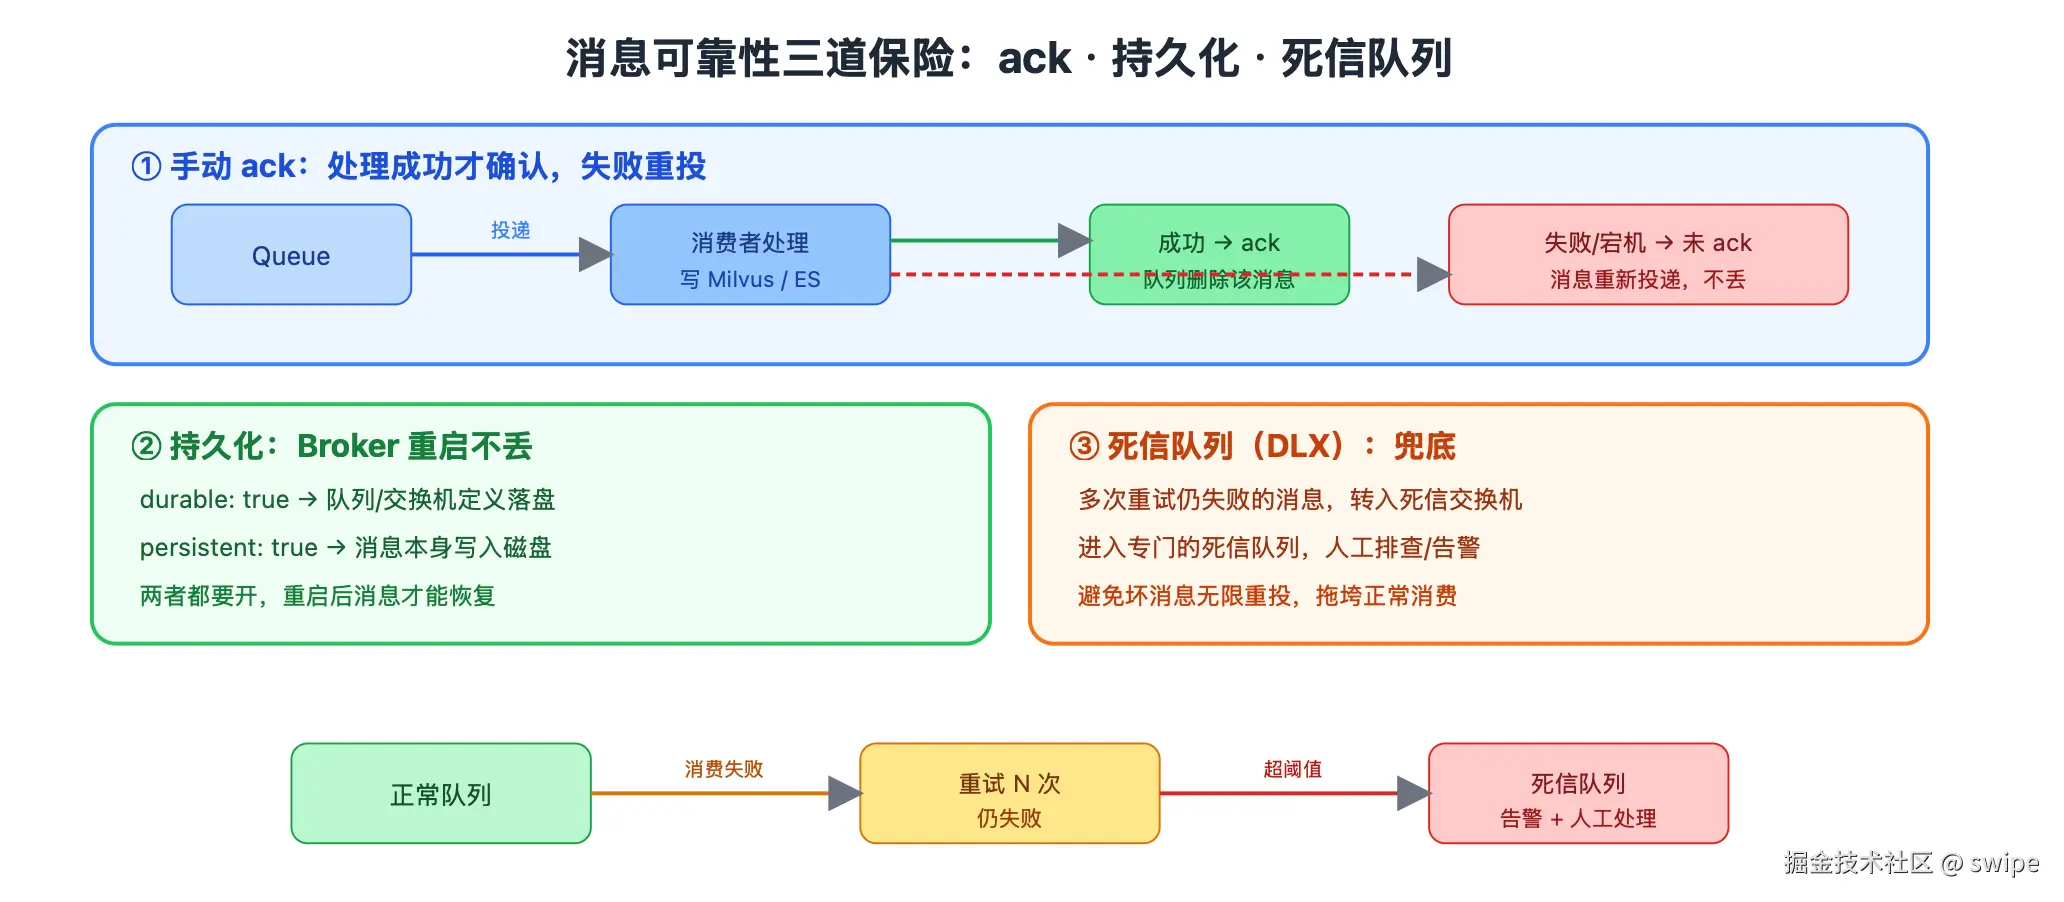
先看这张图,它把三道保险的关系画清楚了:
8.1 手动 ack:处理成功才确认
前面每个消费者最后都调了 channel.ack(msg),这不是可有可无的。RabbitMQ 的投递确认机制是这样的:
- 消费者拿到消息后,消息在队列里被标记为"未确认(unacked)",并不会立即删除。
- 只有当消费者调用
channel.ack(msg)明确确认后,队列才真正删除这条消息。 - 如果消费者在 ack 之前就崩溃(进程挂了、连接断了),RabbitMQ 会认为这条消息没处理成功 ,自动把它重新投递给其他消费者。
这就保证了"消息至少被成功处理一次",进程崩了也不丢任务。关键是别用自动 ack({ noAck: true })------那样消息一投出去就被删,消费者中途挂了消息就没了。
处理失败时,除了 ack,还有两个选择:
javascript
channel.consume(QUEUE, (msg) => {
  try {
    const data = JSON.parse(msg.content.toString());
    // ...处理逻辑,比如写 Milvus
    channel.ack(msg); // ✅ 成功:确认,队列删除消息
  } catch (err) {
    // ❌ 失败:第二个参数 requeue 决定是否重新入队
    // requeue=true → 放回队列重试;requeue=false → 丢弃或进死信队列
    channel.nack(msg, false, true);
  }
});
这正好回答了原文评论区那个问题:"ES 成功了但 Milvus 失败了怎么办?" 因为两个消费者用的是独立队列,ES 那条消息已经 ack 成功了,不受影响;而 Milvus 消费者处理失败时不 ack(或 nack requeue),这条消息会被重新投递,让 Milvus 消费者再消费一次即可。两路互不干扰,这就是 fanout + 独立队列 + 手动 ack 组合的好处。
8.2 持久化:Broker 重启不丢消息
光有 ack 还不够。如果整个 RabbitMQ Broker 重启了,内存里的东西会不会没?这要靠持久化,而且需要两个层面都开启:
- 队列/交换机持久化 :声明时传
durable: true。这样重启后队列和交换机的定义 还在。前面所有assertQueue、assertExchange都带了这个。 - 消息持久化 :发布时传
persistent: true。这样消息本身会被写入磁盘。前面publish时也都带了。
两者必须同时开:队列不持久化,重启后队列都没了,消息自然无处安放;消息不持久化,队列还在但消息只在内存,重启照样丢。
需要说明的是,持久化不等于 100% 不丢(比如消息刚写入还没落盘时宕机)。要追求更强的保证,还需要配合发布确认(publisher confirm) 和仲裁队列(quorum queue) 等机制,那属于更进阶的话题,入门阶段先把 durable + persistent 这对组合用对就够了。
8.3 QoS:别让一个消费者撑死
默认情况下,RabbitMQ 会把队列里的消息尽可能快地一次性推给消费者。如果消息很多、每条处理又慢(比如向量化很耗时),一个消费者会瞬间被塞进一大堆未处理消息,内存飙升,而其他空闲的消费者却拿不到活。
解决办法是设置 QoS(prefetch,预取数量):
javascript
// 告诉 RabbitMQ:每个消费者最多同时持有 1 条未 ack 的消息,
// 处理完(ack)之后再给下一条。
await channel.prefetch(1);
设了 prefetch(1) 之后,消费者手上只留一条正在处理的消息,处理完 ack 了才拿下一条。这样多个消费者之间就能按处理能力均衡分配------处理快的多拿,处理慢的少拿,而不是平均分配后有人累死有人闲死。这对于任务耗时不均的场景(文档有大有小)特别重要。
8.4 死信队列:坏消息的兜底
有一类消息无论重试多少次都会失败------比如内容本身就是坏的、格式无法解析。如果一直 requeue 重试,它会在队列里反复横跳,不仅自己处理不了,还占着消费者资源拖累正常消息。
死信队列(Dead Letter Exchange,DLX) 就是给这类消息兜底的。它的思路是:给正常队列配置一个"死信交换机",当消息满足以下条件时,自动转发到死信交换机,进而进入专门的死信队列:
- 消息被
nack/reject且requeue=false - 消息在队列里存活超过了 TTL(存活时间)
- 队列达到了最大长度限制
javascript
// 声明正常队列时,通过 arguments 指定它的死信交换机
await channel.assertQueue('doc.vectorize', {
  durable: true,
  arguments: {
    // 处理失败的消息转发到这个死信交换机
    'x-dead-letter-exchange': 'doc.dlx',
    // (可选)重新指定死信的 routing key
    'x-dead-letter-routing-key': 'vectorize.failed',
  },
});
配合一个绑定到 doc.dlx 的死信队列,失败消息就会汇集到那里。你可以对死信队列做告警监控 + 人工排查,或者写一个补偿程序定时处理。这样既不丢坏消息(留着以后分析),又不让它阻塞正常流程。
实际项目里,常见的组合是:正常队列消费失败 → 重试有限次数 → 仍失败则进死信队列 → 告警通知人工介入。这套机制能覆盖绝大多数异常场景。
九、RabbitMQ vs Kafka:什么时候用哪个
原文评论区还有个高频问题:"什么时候用 Kafka,什么时候用 RabbitMQ?" 这里简单说清楚。
两者都是消息中间件,但定位不同:
| 对比项 | RabbitMQ | Kafka |
|---|---|---|
| 定位 | 传统消息队列,强在灵活路由 | 分布式日志流 平台,强在高吞吐 |
| 路由能力 | 四种交换机,路由灵活精细 | 基于 topic/partition,路由简单 |
| 吞吐量 | 万级~十万级/秒 | 百万级/秒 |
| 消息模型 | 消费后即删除 | 消息持久保留,可重复消费 |
| 典型场景 | 业务解耦、异步任务、复杂路由 | 日志采集、大数据管道、流处理、事件溯源 |
| 上手难度 | 相对简单 | 概念和运维更重 |
一句话经验:
- 业务异步、任务解耦、需要灵活路由 (比如我们这个 RAG 文档处理、订单流转、通知分发)------选 RabbitMQ,轻量、路由强、够用。
- 超大吞吐量的数据流、日志/埋点采集、需要消息回放 ------选 Kafka。
对于绝大多数 Agent 应用的异步场景,RabbitMQ 都是更顺手的选择。等到数据量真的涨到 Kafka 才扛得住的量级,你自然会知道该换了。
另外原文评论里还有人问:"不同语言/不同进程之间的协同用它怎么样?" 答案是完全可以------RabbitMQ 基于标准的 AMQP 协议,几乎所有主流语言都有客户端。Python 发消息、Node.js 消费,或者反过来,都没问题。这也是消息队列做跨语言、跨服务解耦的天然优势。
十、总结
这篇文章我们把 RabbitMQ 从概念到实战、再到生产要点,完整走了一遍:
- 为什么用:Agent/RAG 场景里,向量化、ES 写入这类耗时且独立的任务,用消息队列异步化,把"同步等待"变成"发条消息就返回",解耦生产者和消费者。
- 架构概念:Producer、Consumer、Connection(TCP 物理连接)、Channel(逻辑通道)、Queue(消息容器)、Exchange(路由交换机)、Broker(服务实例)。核心是"生产者发给交换机,交换机路由到队列"。
- 四种交换机:fanout 广播、direct 精确匹配、topic 通配符、headers 属性匹配。其中 fanout 是 RAG 双写的主场景,topic 是日常最常用的类型。
- 生产可靠性:手动 ack 保证不丢任务、durable + persistent 双持久化扛重启、QoS prefetch 均衡负载、死信队列给坏消息兜底。
- 选型:业务异步解耦用 RabbitMQ,超大吞吐数据流用 Kafka。
后端的异步任务基本都是通过 MQ 来做:生产者往队列存消息,消费者取出来处理,整个过程异步、解耦、可扩展。后面 Agent 应用里凡是涉及异步的场景,你都可以用 RabbitMQ 来实现。
动手把 rabbitmq-test 这四种交换机都跑一遍,过程中打开 http://localhost:15672 管理台,你能实时看到交换机、队列、绑定关系和消息堆积情况,对照代码理解会更直观。跑通之后,再试着给消费者加上 prefetch 和死信队列,你就真正掌握了这个 Agent 开发里的标配工具。
💡 本文所有代码均基于
amqplib,并在本地rabbitmq:3.13-management上实测跑通。四种交换机的路由行为(direct 精确、fanout 广播、topic 通配、headers 组合匹配)输出均与文中一致。