摘要:foreachRDD 是 Spark Streaming 里最常用、也最容易写挂的输出算子。这篇讲清它和 transform 的区别------foreachRDD 在 Driver 端拿到 RDD、真正执行在 Executor 端,以及由此带来的一个高频坑:连接到底该建在哪。用三种连接方式的性能对比和一段完整的写 MySQL 代码,把 foreachRDD 的正确姿势讲透。
关键词:Spark Streaming, foreachRDD, foreachPartition, 连接管理, 事务, exactly-once
一、foreachRDD 是什么,先分清它和 transform
DStream 的算子分两类:转换操作 (返回新 DStream)和输出操作 (不返回,触发计算)。foreachRDD 属于后者,是 output 操作。
它和 transform 长得像,本质区别就一条:
scala
// transform:拿到 RDD,返回新 RDD,继续流式计算
val newDs = ds.transform(rdd => rdd.map(...))

// foreachRDD:拿到 RDD,做输出,到此为止(无返回值)
ds.foreachRDD(rdd => { /* 写外部存储 */ })
foreachRDD 是 Action 语义------一旦调用,前面所有 DStream 转换才会真正执行。所以一个流里如果没有 foreachRDD(或 print、saveAsTextFiles 这类 output 操作),整个流是不会动的。
二、最核心的坑:连接建在哪
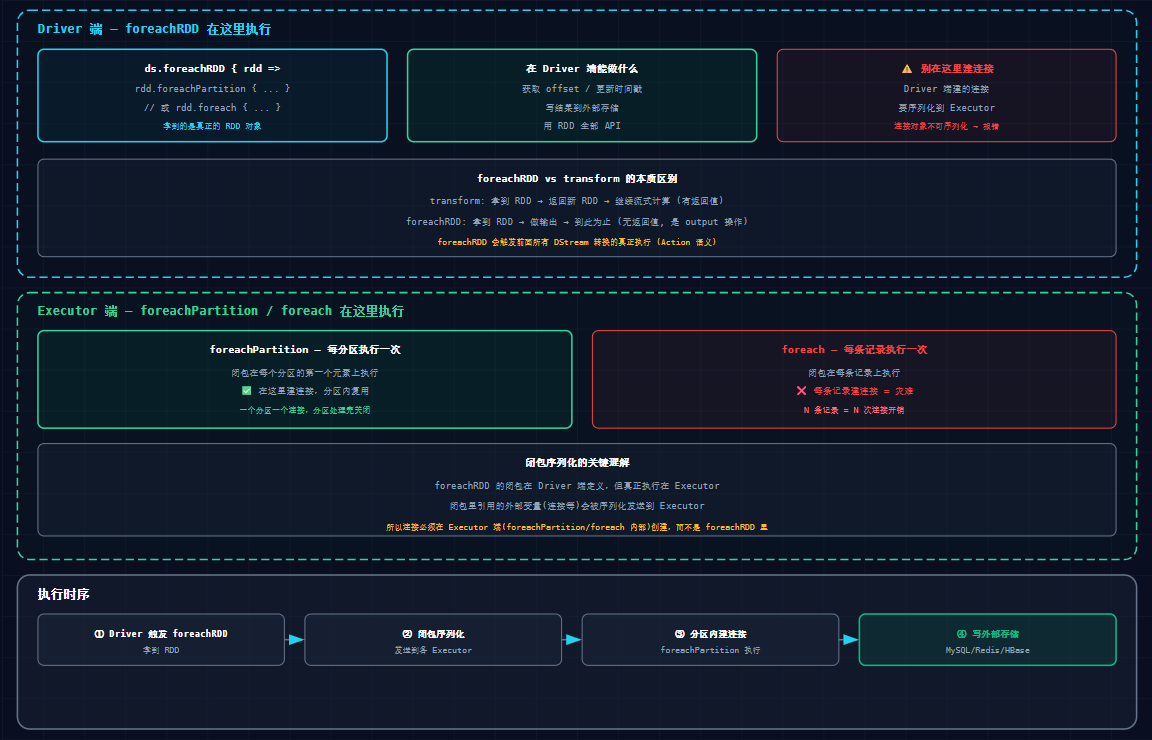
这是 foreachRDD 用法的分水岭。关键要理解执行位置:
foreachRDD的闭包在 Driver 端定义、在 Driver 端拿到 RDD;- 但它内部的
foreachPartition/foreach真正跑在 Executor 端。
而闭包里引用的外部变量,会被序列化发送到 Executor。连接对象(Connection)不可序列化,所以在 foreachRDD 这一层建连接,要么报 NotSerializableException,要么每个 Driver 只建一个连接却要发给所有 Executor,完全不对。
结论一句话:连接必须在 Executor 端创建,也就是放进 foreachPartition 或 foreach 里面,而不是 foreachRDD 这一层。
三、三种连接方式,性能差三个数量级
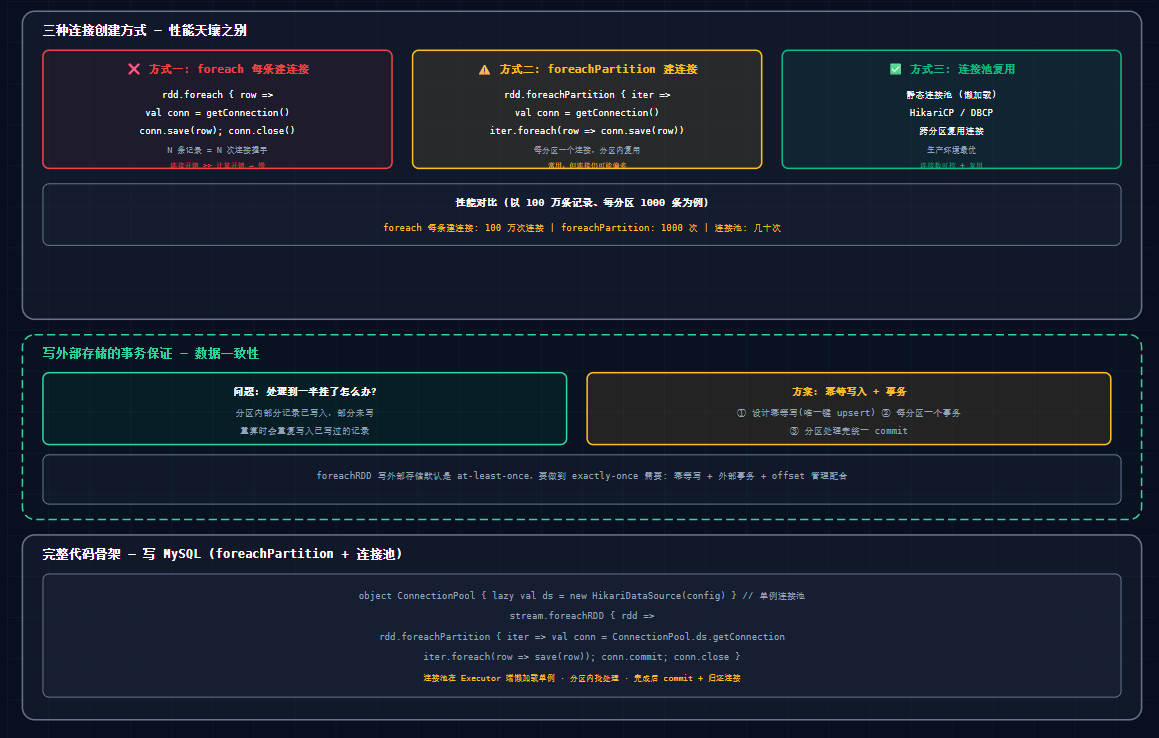
假设要写 100 万条记录到 MySQL,看三种写法的差别。
方式一:foreach 每条建连接(反模式)
scala
rdd.foreach { row =>
  val conn = DriverManager.getConnection(url, user, pwd)
  save(conn, row)
  conn.close()
}
100 万条记录 = 100 万次 TCP 握手 + 认证 + 建连接。连接开销远大于写入本身,吞吐直接崩。这是最常见的新手错误,要极力避免。
方式二:foreachPartition 每分区建连接(常用)
scala
rdd.foreachPartition { iter =>
  val conn = DriverManager.getConnection(url, user, pwd)
  try {
    iter.foreach(row => save(conn, row))
  } finally {
    conn.close()
  }
}
foreachPartition 的闭包在每个分区的第一条记录上执行一次,所以一个分区只建一个连接,分区内所有记录复用。假设每分区 1000 条,连接次数就从 100 万降到 1000。这是大多数场景够用的写法。
注意 finally 里关连接,防止中途异常导致连接泄漏。
方式三:连接池(生产最优)
方式二的问题在于连接数 = 分区数,分区一多连接就多。生产上用连接池跨分区复用:
scala
// Executor 端懒加载单例连接池
object ConnectionPool {
  lazy val ds: HikariDataSource = {
    val cfg = new HikariConfig()
    cfg.setJdbcUrl(url); cfg.setUsername(user); cfg.setPassword(pwd)
    cfg.setMaximumPoolSize(10)
    new HikariDataSource(cfg)
  }
}

rdd.foreachPartition { iter =>
  val conn = ConnectionPool.ds.getConnection
  try { iter.foreach(row => save(conn, row)) } finally { conn.close() }
}
连接池用 lazy val 单例 + 静态对象保证每个 Executor 只初始化一次,池子里的连接跨分区复用,连接数可控。
四、写外部存储的事务问题
foreachRDD 写外部存储,默认是 at-least-once 语义:处理到一半 Executor 挂了,重算时会重复写入已经写过的记录。
要往 exactly-once 靠,需要三件事配合:
- 幂等写:给记录设计唯一键,用 upsert 替代 insert,重复写同一行结果不变。
- 每分区一个事务:一个分区的写入放在一个事务里,全部成功才 commit,失败整体回滚。
- offset 与结果绑定:只有写入成功才提交 offset(这在 Direct 模式下天然支持,offset 自管理)。
纯靠 foreachRDD 单算子做不到 exactly-once,它只能做到"配合外部系统幂等 + 事务"之后的效果。这点别被网上"foreachRDD 保证 exactly-once"的说法误导。
五、完整示例:写 MySQL
scala
import org.apache.spark.streaming.{Seconds, StreamingContext}
import com.zaxxer.hikari.{HikariConfig, HikariDataSource}

object StreamingToMySQL {
  // Executor 端懒加载连接池单例
  object ConnectionPool {
    lazy val ds: HikariDataSource = {
      val cfg = new HikariConfig()
      cfg.setJdbcUrl("jdbc:mysql://host:3306/db")
      cfg.setUsername("root")
      cfg.setPassword("password")
      cfg.setMaximumPoolSize(10)
      new HikariDataSource(cfg)
    }
  }

  def main(args: Array[String]): Unit = {
    val ssc = new StreamingContext("local[2]", "stream-to-mysql", Seconds(2))
    val lines = ssc.socketTextStream("localhost", 9999)

    lines.foreachRDD { rdd =>
      if (!rdd.isEmpty) {
        rdd.foreachPartition { iter =>
          val conn = ConnectionPool.ds.getConnection
          conn.setAutoCommit(false)
          try {
            val ps = conn.prepareStatement(
              "INSERT INTO result(word, cnt) VALUES(?, 1) ON DUPLICATE KEY UPDATE cnt = cnt + 1")
            iter.foreach { word =>
              ps.setString(1, word)
              ps.addBatch()
            }
            ps.executeBatch()
            conn.commit()       // 分区内一个事务,成功才提交
          } catch {
            case e: Exception => conn.rollback(); throw e
          } finally {
            conn.close()        // 归还连接池
          }
        }
      }
    }

    ssc.start(); ssc.awaitTermination()
  }
}
这段代码把前四节的点都串起来了:连接池单例、分区级连接、批处理 + 幂等 upsert、事务 commit/rollback。
六、总结
- foreachRDD 是 output 操作,Driver 端拿 RDD、Executor 端执行,和 transform 的区别是"有无返回值"。
- 连接必须建在 Executor 端(foreachPartition/foreach 内),foreachRDD 这层建连接会踩序列化坑。
- 连接方式从差到好:foreach 每条建连接 → foreachPartition 每分区建连接 → 连接池复用。
- 默认 at-least-once,要 exactly-once 得靠幂等写 + 分区事务 + offset 绑定三件套。
作者 :大数据技术实践者
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践